
3萬塊的RTX Spark電腦,首發體驗來了!
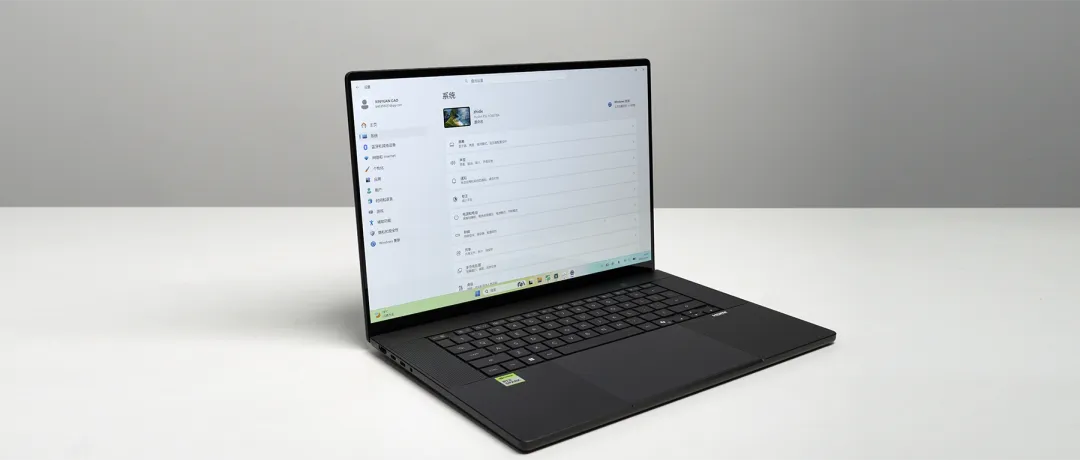
芯東西10月15日報導,明晚20點,Windows PC領域將迎來一個標誌性時刻——全球首批RTX Spark筆記型電腦全面開售。
輝達創始人兼CEO黃仁勳已經在一波華碩ProArt 創14 RTX Spark筆記型電腦上籤名,準備作為六城聯動首發派對的福利放送。
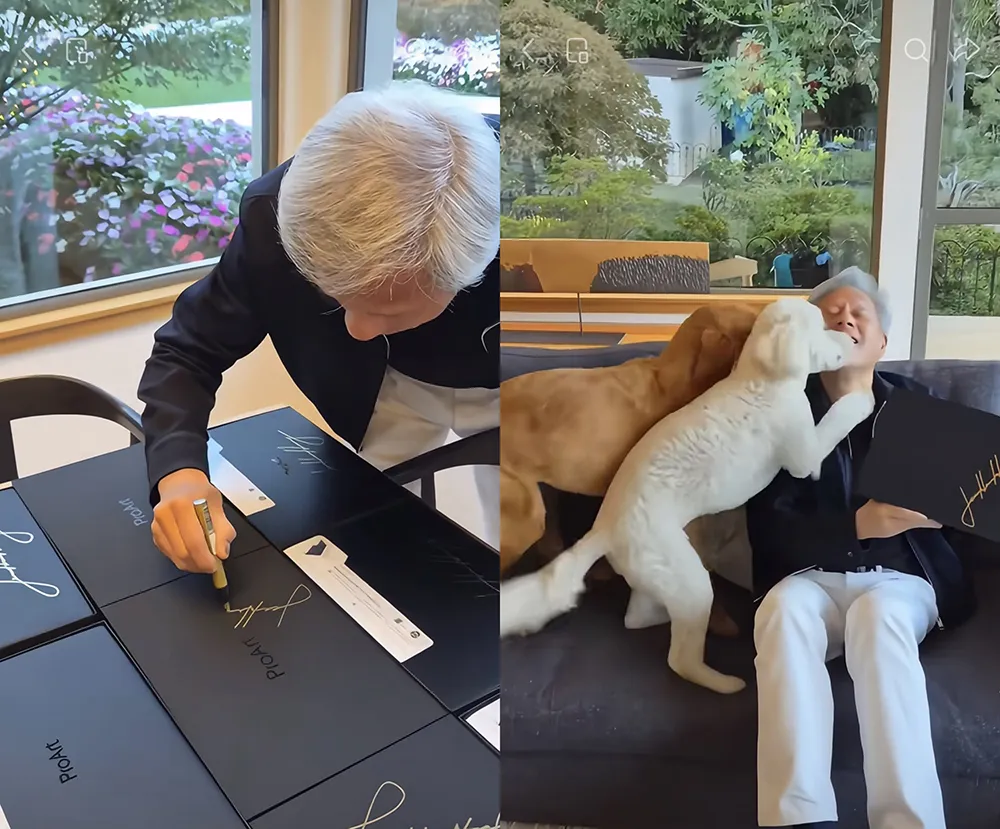
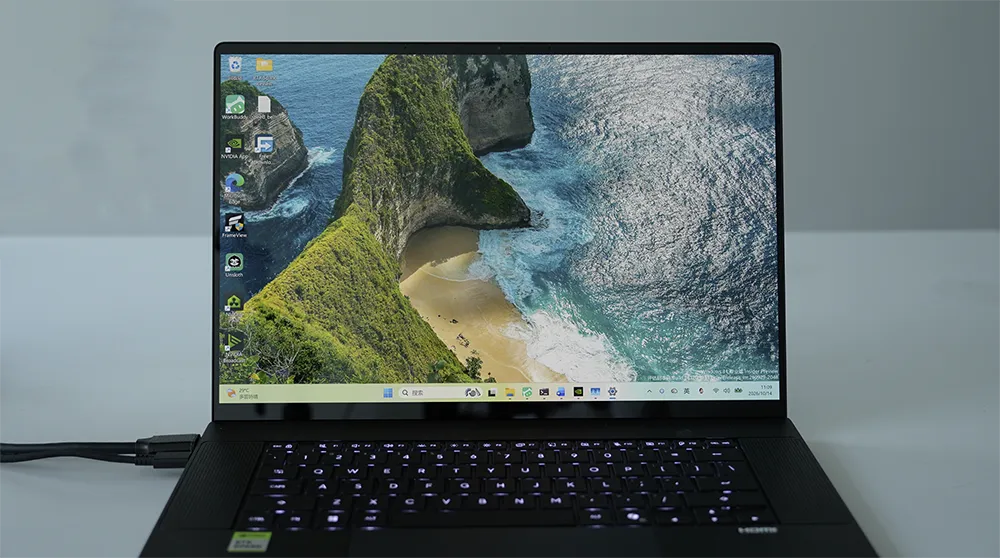
芯東西這幾天持續體驗的是老黃簽名同款的“Plus版”——16英吋華碩ProArt 創16 RTX Spark筆記型電腦。
這台電腦僅約1.79kg,厚度不到1.3cm,搭配3K 120Hz OLED觸控式螢幕,奈米黑機身經過特殊處理能防指紋,顏值很高,體感比15英吋MacBook Air稍重一點。
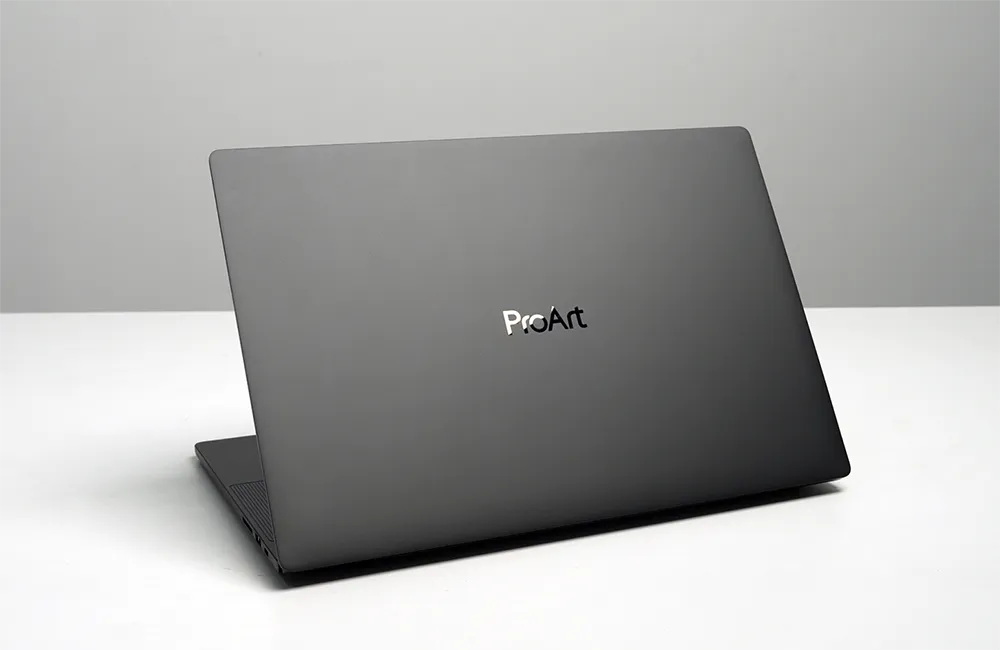
其介面配置涵蓋Type-C、USB3.2 Gen2 Type-A、HDMI2.1 FRL、SDExpress7.0讀卡器及音訊介面,能滿足大部分日常需求。
開蓋後,鍵盤左下角就是醒目的RTX Spark標識。
作為Windows PC新物種,RTX Spark被手畫K線的皮衣戰神黃仁勳冠以“重塑PC”的名號。
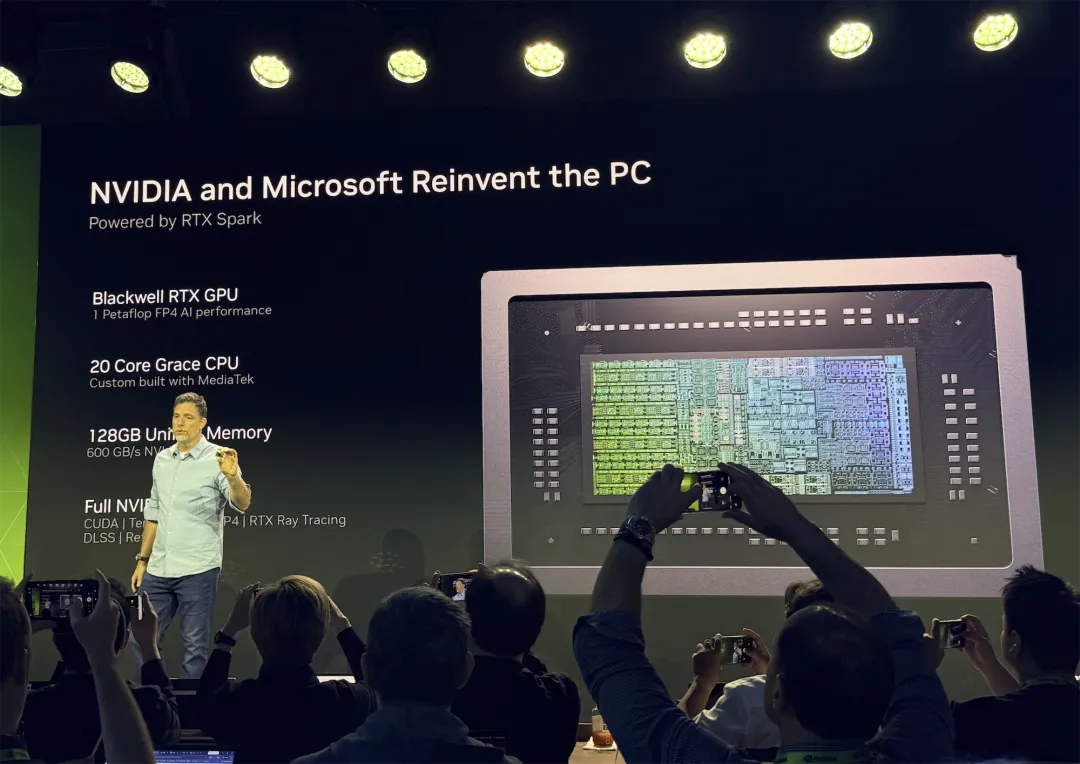
它宛如PC圈的全能ACE,實現「遊戲本+創意工作室+個人AI PC」三合一,跑得起本地模型,玩得轉多智能體,幹得了專業創作,也能打3A大作。
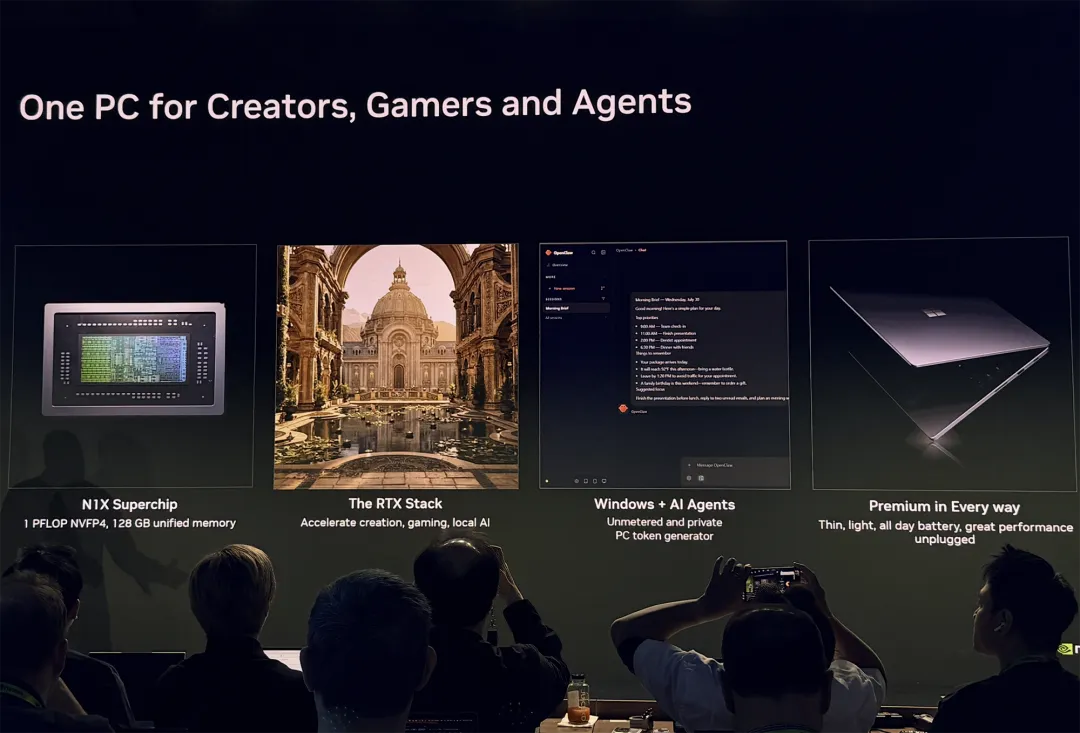
從日常辦公、遊戲娛樂到程式設計開發、4K視訊剪輯、3D建模與渲染、圖像和視訊生成,以前你在不同類型輝達RTX產品上做的事,這一台PC就能包辦。
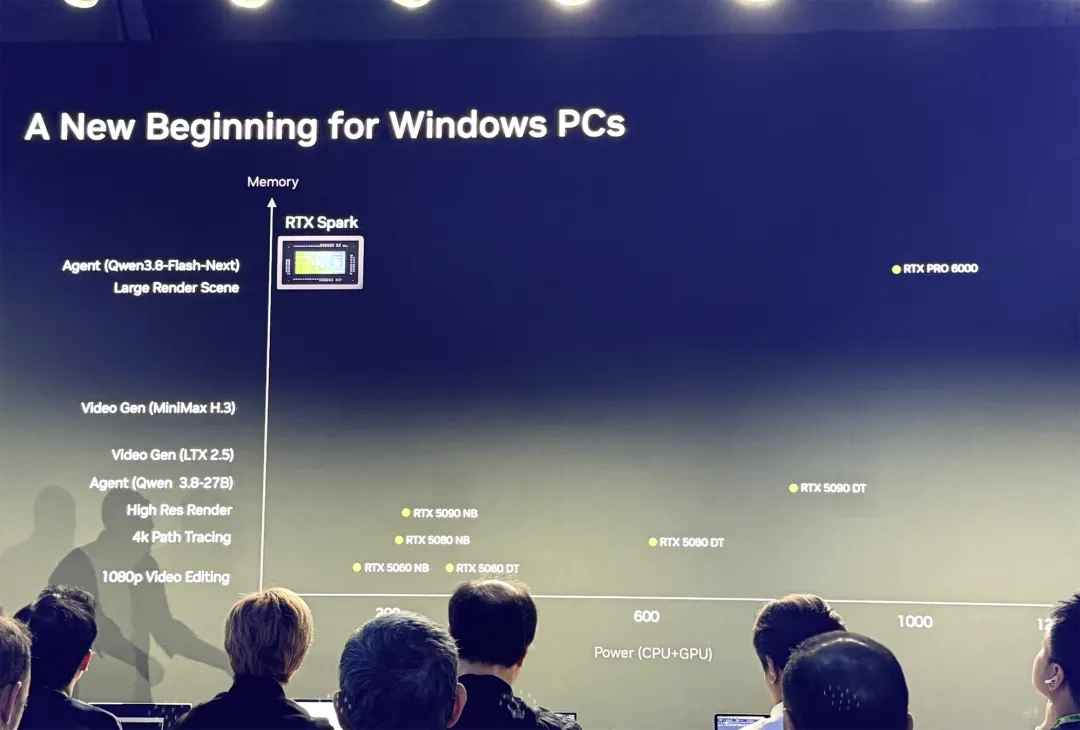
隨著RTX Spark發佈,數千款應用、遊戲和型號將同步向使用者推出。
本文將全面拆解RTX Spark的關鍵能力:
開發者、創作者、遊戲玩家分別能做什麼?
- 輝達RTX Spark N1X晶片的配置與架構細節。
- 最佳化智能體全流程,把PC變成個人Token工廠。
- 指揮智能體讀取和更改電腦設定。
- 智能體讀論文、整發票、輔助評測、程式設計開發。
- 微調專屬大模型,最佳化特定性能。
- 支撐家庭智能體,管夠全家PC算力。
- 實現混合智能:本地搞不定的,才分給雲端模型。
- 智能體搞定專業創作全流程,加速創意變現。
- 助力AI改造遊戲的渲染、玩法、開發。
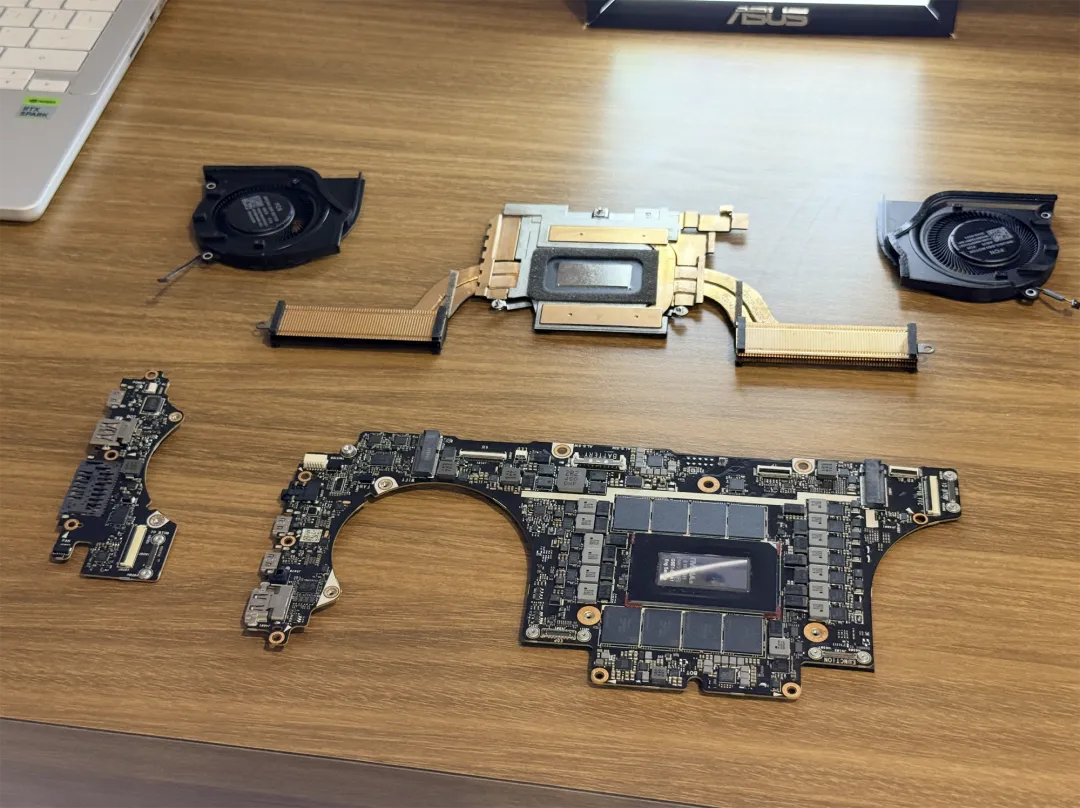
01.
開發、創作、遊戲三合一,
智能體推理性能與DGX Spark相當
RTX Spark把超算級AI性能塞進了一台輕薄、便攜、功耗低、價格可接受的裝置上。
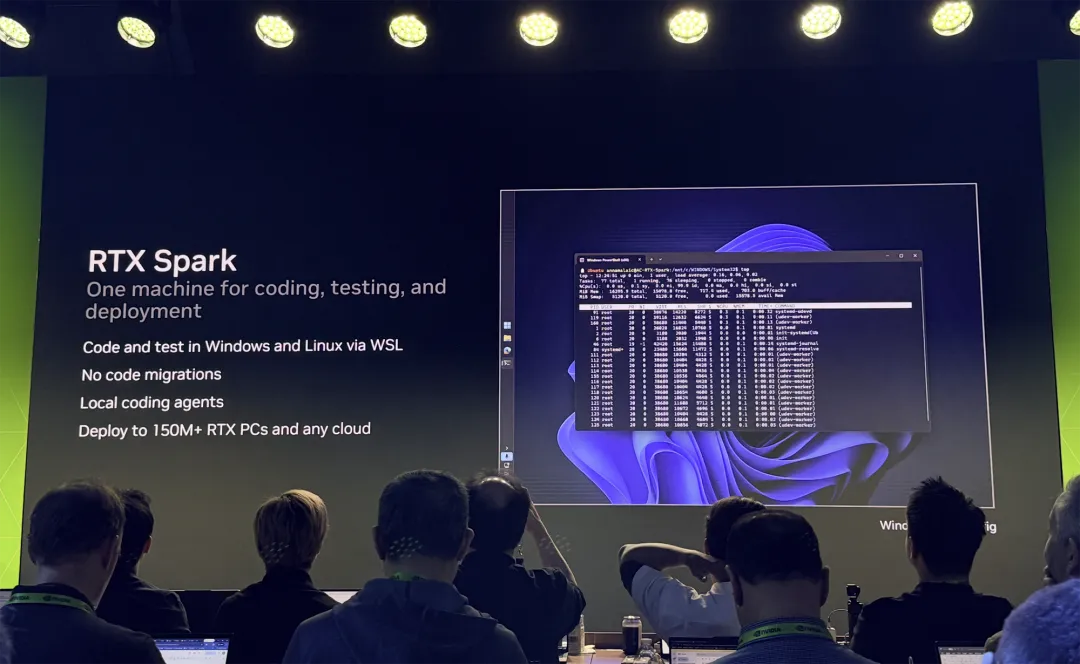
對於開發者來說,RTX Spark能顯著加速開發過程,同時運行多個本地智能體,跑本地模型來執行程式設計和複雜本地操作,對智能體利用本地硬體的能力做充分最佳化,還支援訪問龐大的輝達開發工具和軟體生態系統。一台機器搞定程式設計、測試和部署。
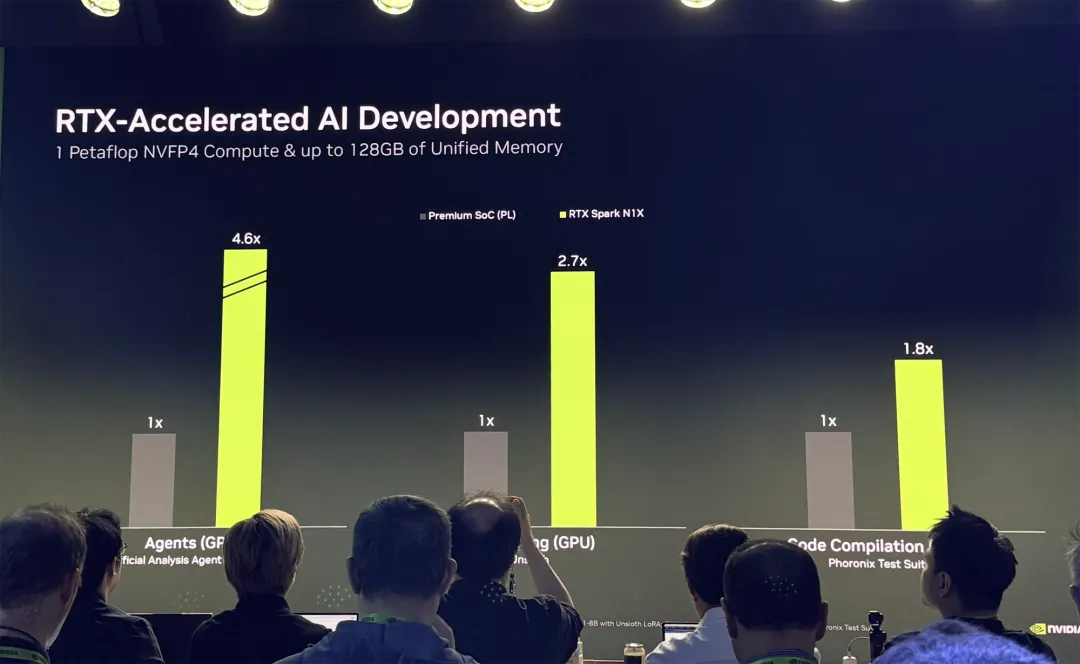
據輝達披露,與上一代產品相比,RTX Spark在本地AI模型運行方面獲得4.6倍的性能提升;模型微調性能提升大約達到2.7倍;在主要受CPU性能限制的工作負載中,也能獲得1.8倍的性能提升。
對於專業創作者來說,RTX Spark能在幾分鐘內生成4K、60fps視訊,即時預覽AI摳像降噪,渲染超過90GB的超大3D場景,加速12K 4:2:2視訊處理。
對於遊戲玩家來說,在DLSS、Reflex低延遲、Remix、G-SYNC同步、光線追蹤等RTX技術加持下,RTX Spark能以1440p、超100fps運行許多主流遊戲。
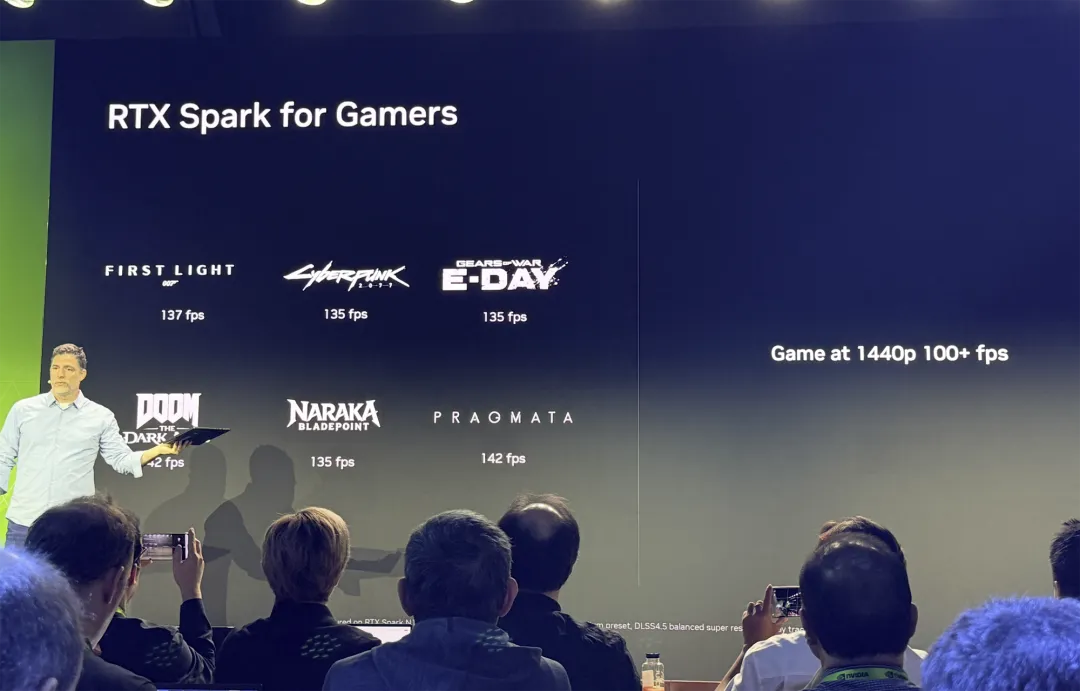
雖然Arm在PC遊戲生態上還有進步空間,但輝達的遊戲顯示卡霸主地位穩固。要不說輝達對Arm是真愛呢,沒收購成功也力扶Arm,一邊在資料中心領域為Arm CPU開疆拓土,一邊幫Arm敲開PC遊戲玩家的門。
RTX Spark有兩種產品形態:
RTX Spark筆記型電腦適用於想用一台裝置運行不同工作負載的使用者,提供24GB~128GB記憶體配置。
RTX Spark緊湊型桌面主機適合需要讓智能體7 x 24小時全天候運行的開發者,提供64GB和128GB記憶體配置,將從今年11月開始上市。
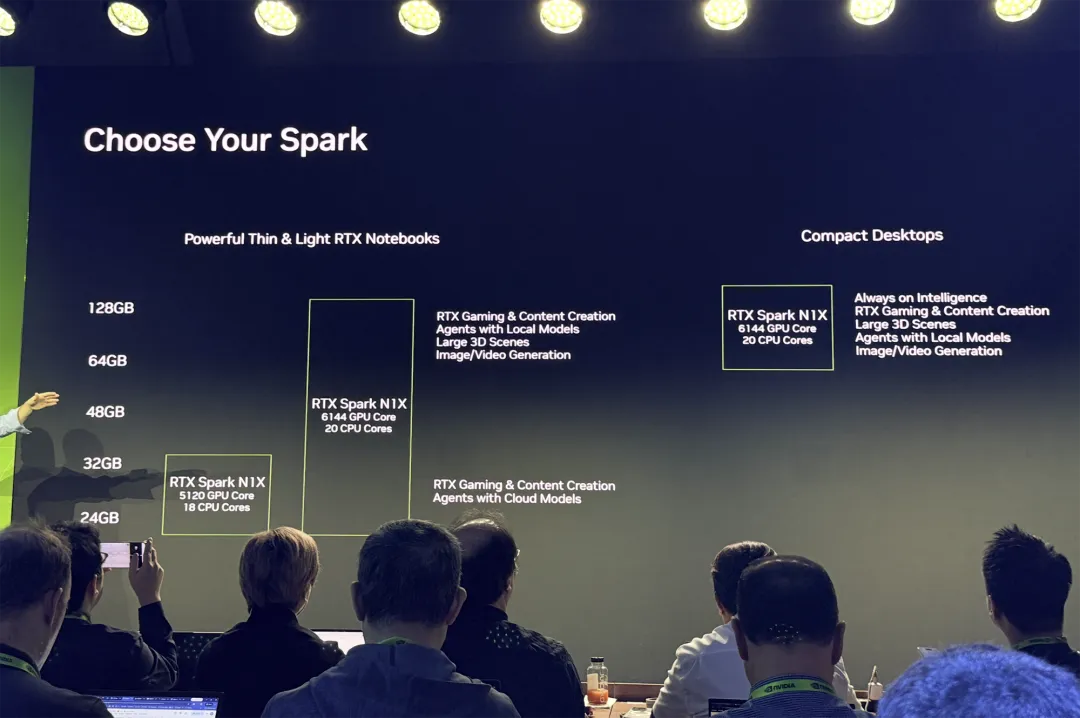
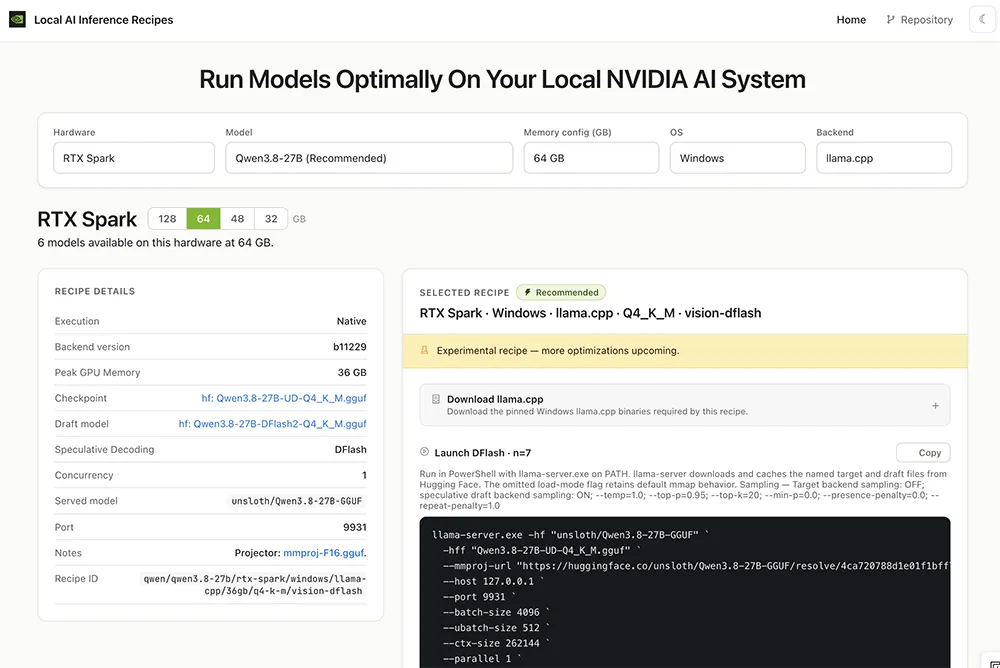
本地AI電腦的選擇,關鍵看記憶體。根據輝達推薦的配方,32GB記憶體最多能運行24GB模型,64GB記憶體能運行36GB的Qwen3.8-27B模型,128GB記憶體則能運行78GB的Qwen3.8-Flash-Next模型(1250億個參數)。
我們體驗的這台華碩ProArt 創16 RTX Spark筆記型電腦整合了20核Grace CPU、6144核Blackwell RTX GPU、板載64GB統一記憶體、1TB固態硬碟,原生支援CUDA生態,FP4精度下AI峰值算力高達1PFLOPS,運行Windows 11 Pro系統,國行價尚未公佈,美版售價換算成人民幣約2.94萬元。
與DGX產品線相比,RTX Spark與DGX Spark提供的AI性能相當,但運行的是Windows on Arm系統,DGX Spark則運行定製Linux系統。
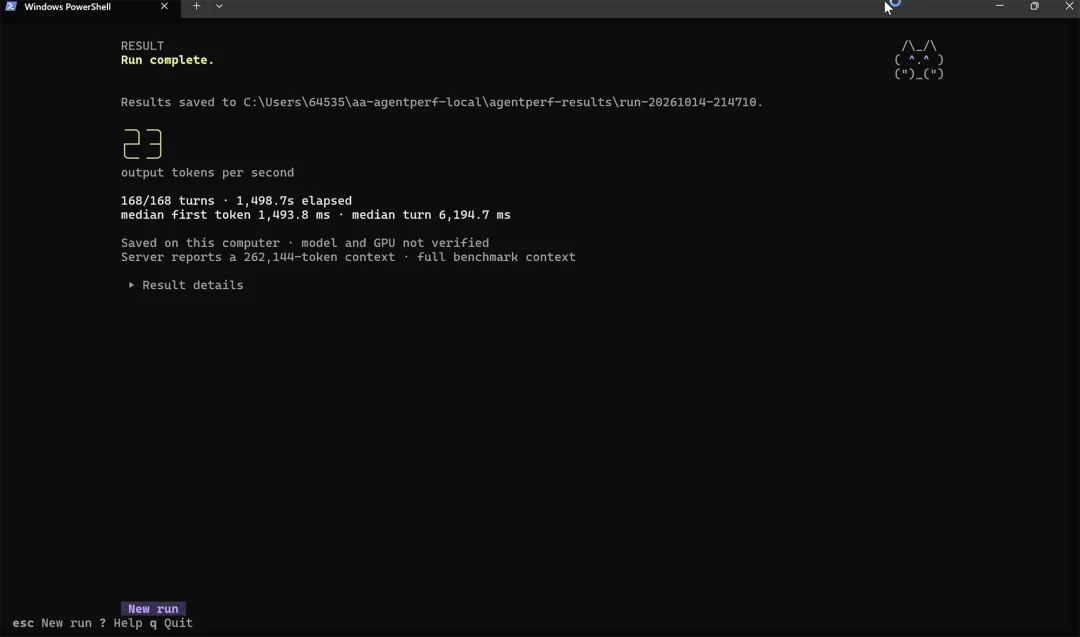
在AA-AgentPerf Local智能體基準測試中,我們這台RTX Spark跟DGX Spark的表現相近,使用Qwen3.8-27B本地模型跑完耗時25分09秒,吐詞速度是23Tokens/s,跟DGX Spark的表現差不多。
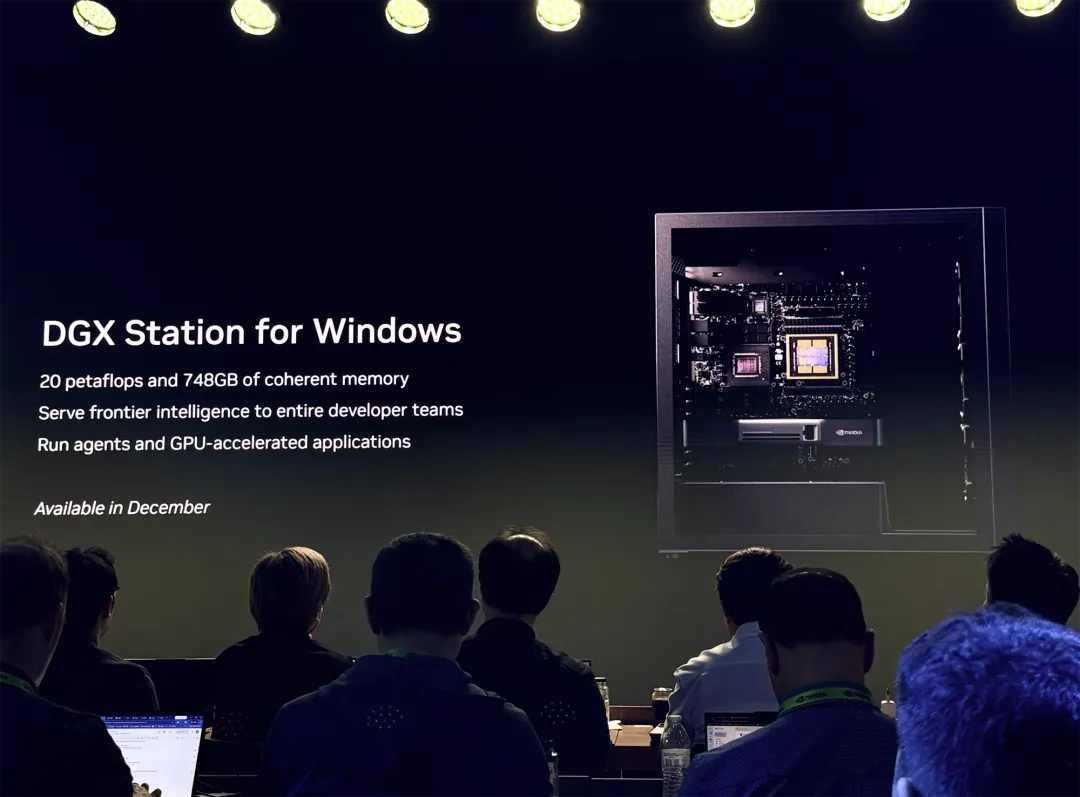
DGX Station桌面級AI超算也將支援Windows系統,可支援多人協作的開發團隊。
02.
兩種晶片配置,最高6144個CUDA核,
能效是對比方案的2倍
為什麼RTX Spark值得入手呢?
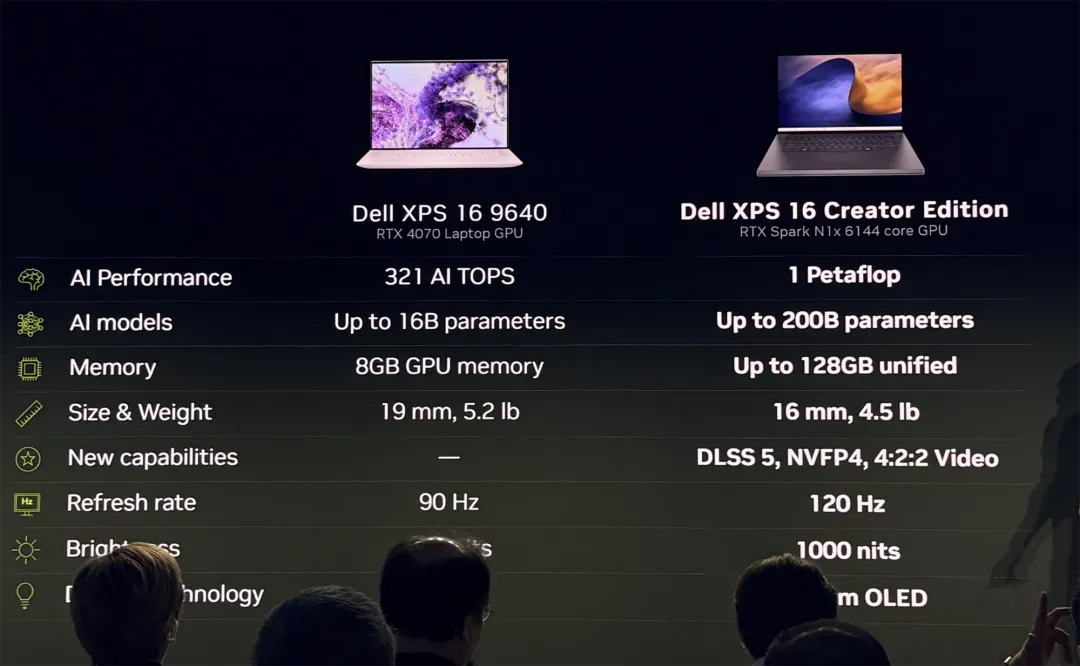
輝達以一款三年前的戴爾筆記型電腦為例:從它升級到RTX Spark電腦將獲得3倍的AI算力和16倍的記憶體,裝置還更輕薄。
下圖中,RTX Spark N1X超級晶片的性能可達到其他Windows PC SoC的3~5倍。
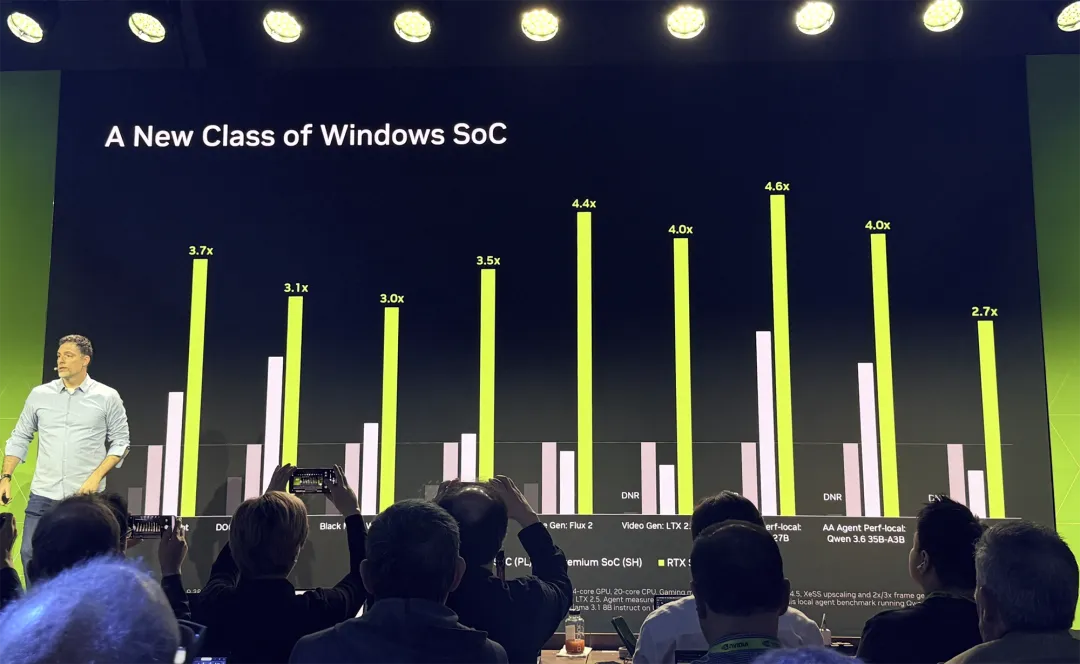
而RTX Spark N1X,正是所有RTX Spark電腦的靈魂。輝達CUDA計算平台和龐大的生態資源,也隨著這顆晶片一起,進入了Windows on Arm裝置。
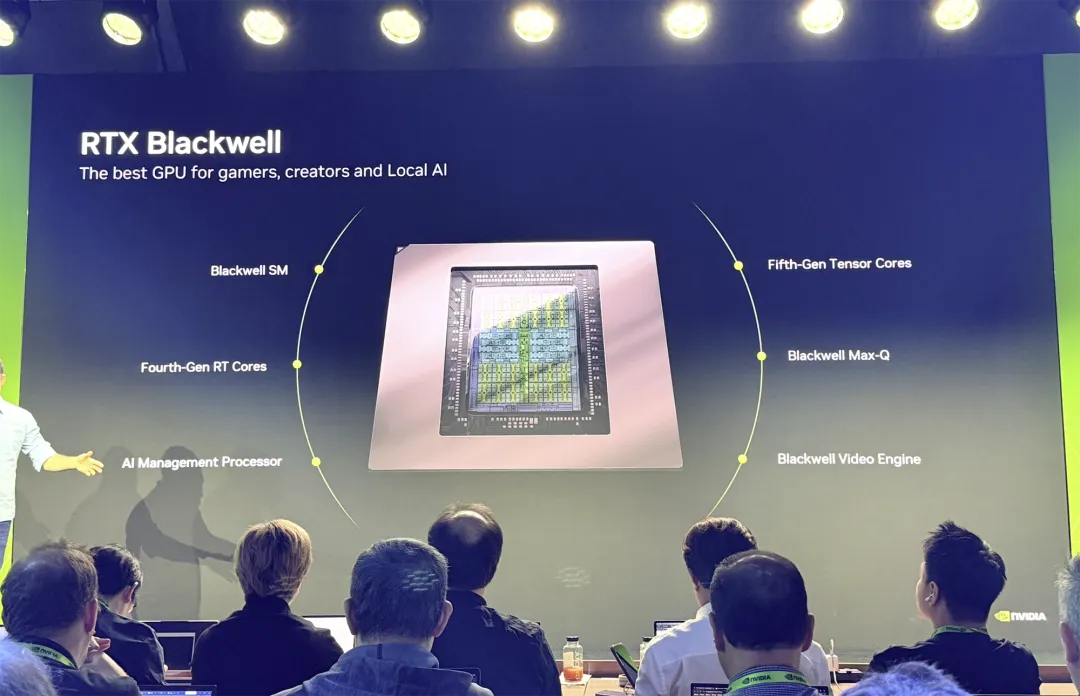
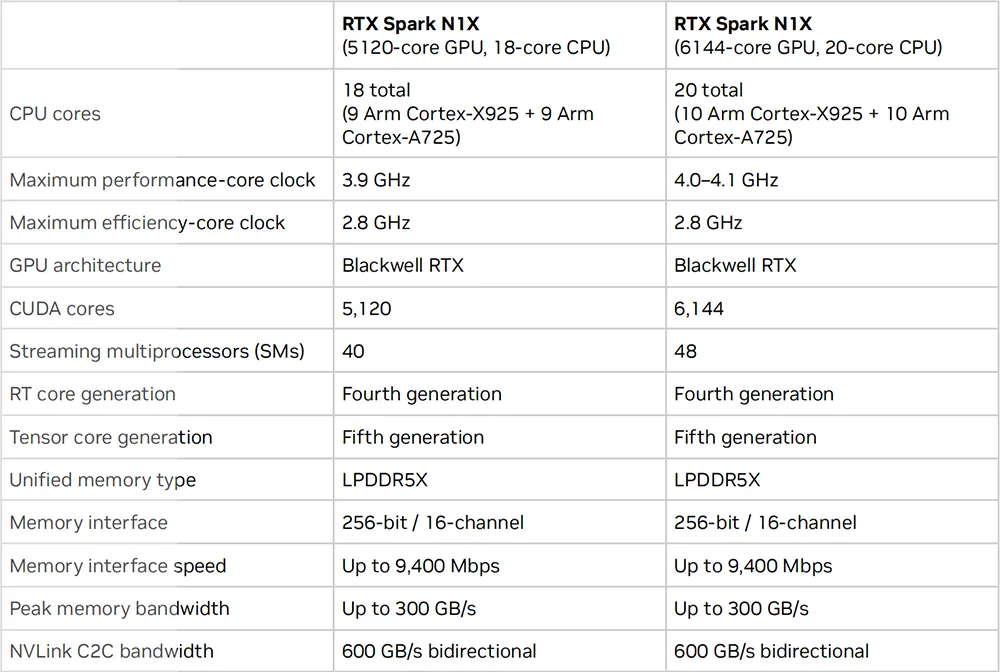
該晶片有兩種配置:
- 18核CPU,5120核GPU,24GB/32GB統一記憶體。
- 20核CPU,6144核GPU,24GB-128GB統一記憶體。
兩種SKU均可在45W~80W TDP範圍運行。
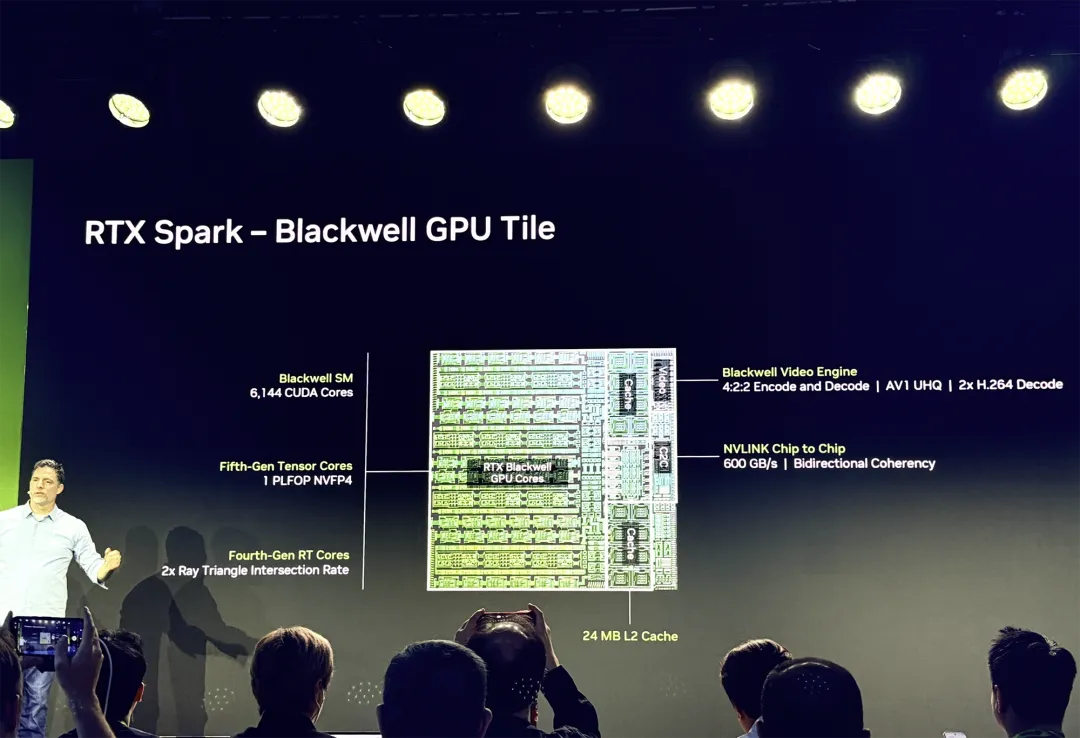
RTX Spark N1X超級晶片由兩個Tile組成。
(1)GPU Tile:採用Blackwell SM,擁有6144個CUDA Core;配備第五代Tensor Core,在NVFP4資料格式下AI算力可達到1PFLOPS;搭載第四代RT Core,三角形相交測試處理速率提高了1倍;整合Blackwell視訊編解碼引擎,可加速4:2:2視訊編碼和解碼。
(2)CPU、I/O和記憶體Tile:由輝達和聯發科共同定製開發,其中CPU共有20核,包括10個能效核和10個性能核,每個CPU簇均可訪問16MB L3快取;整合記憶體介面,記憶體通過256位16通道介面連接,最高資料傳輸速率達9400Mb/s,由此實現總計300GB/s的記憶體頻寬。
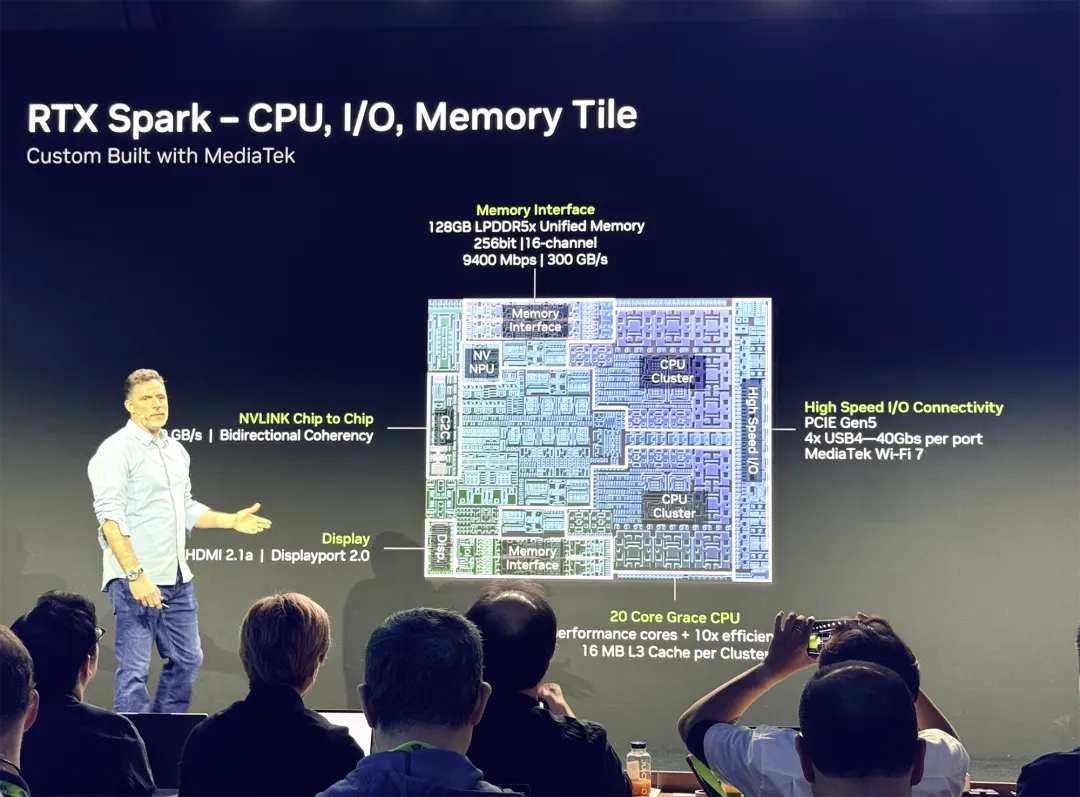
CPU與GPU通過NVLink-C2C互連,提供600GB/s雙向頻寬,資料傳輸能效是PCIe傳輸的25倍。
一個重要特性是雙向快取一致性,即CPU和GPU可同時處理相同的資料,並確保各自快取中的資料副本保持一致。這項技術能簡化應用開發,減少軟體快取管理操作帶來的額外開銷,讓CPU與GPU的通訊更高效。
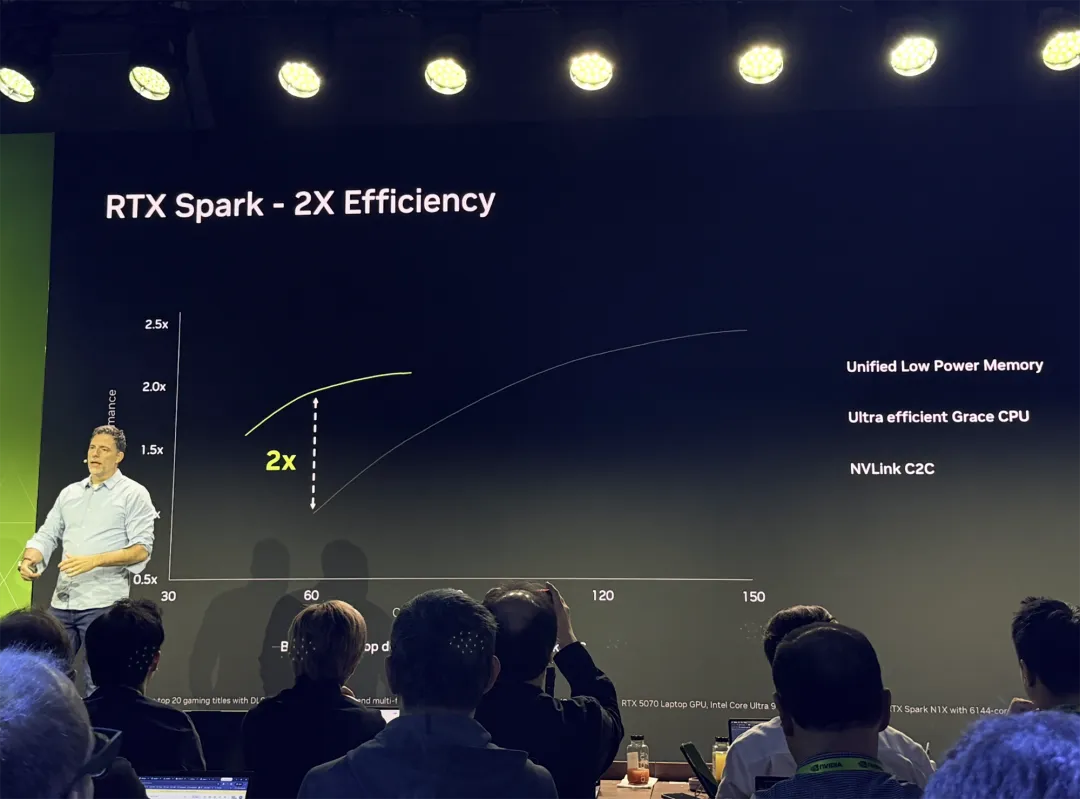
輝達將RTX Spark N1X與傳統的獨立GPU + CPU方案做了對比。對比方案採用的是RTX 5070 GPU。N1X的能效是對比方案能效的2倍。
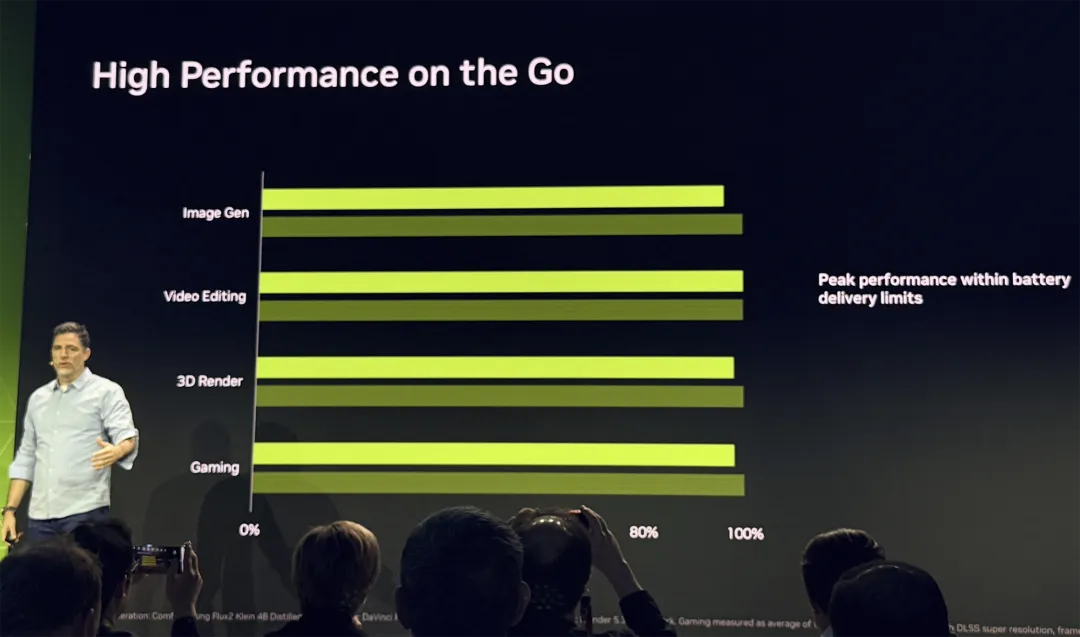
這樣一來,RTX Spark能在未接電的情況下,以接近滿負載的性能狀態運行,同時仍為電腦的其他元件供電。
03.
開箱推薦智能體應用,
把PC變成個人Token工廠
智能體正成為新的使用者介面,把PC從工具變成能與使用者協作的AI隊友。使用者只用說出目標,智能體就能自主完成任務,幫助使用者更好地生活、工作、創作和娛樂。
本地智能體的好處很多,包括將隱私資料留在本地,以及在處理複雜AI任務時能使用無限量的Token。
輝達做了一個簡單計算:
- 一台RTX Spark裝置全天候運行千問模型Qwen3.8-Flash-Next,每個月可生成大約6100萬個Token,相應電費約為20美元。
- 如果雲端使用Claude Sonnet 5.5 Medium模型,通過API生成同樣6100萬個Token,每個月大約需要支付1200美元。
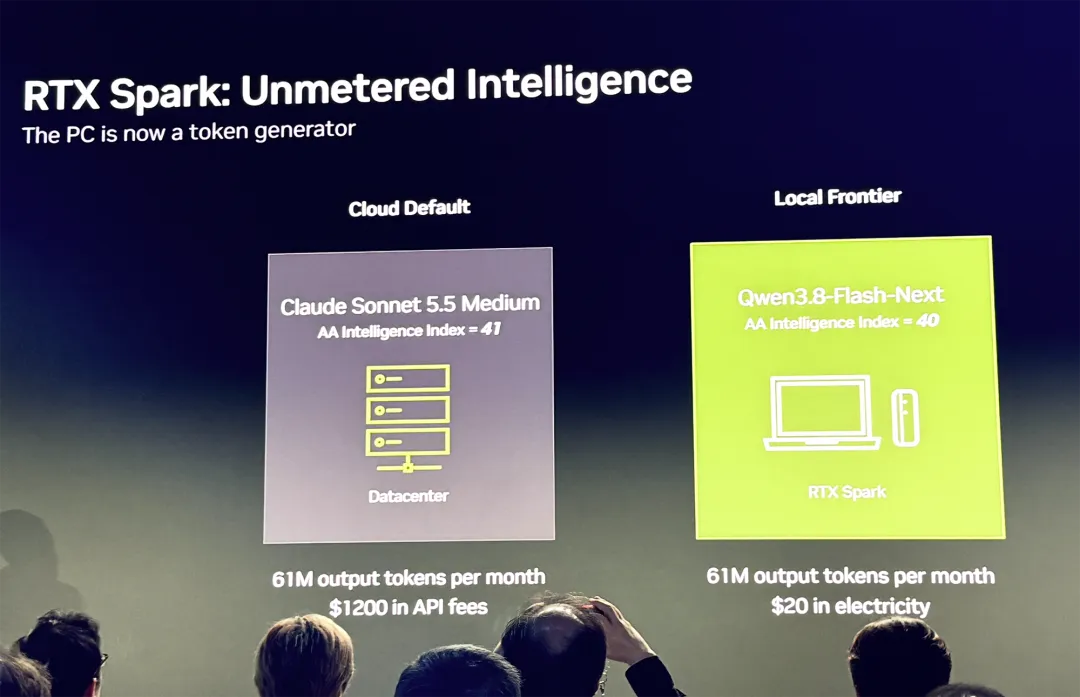
兩者的成本差距相當大。對於高強度使用智能體的使用者,這台裝置可能在短短幾個月內就能收回硬體成本。
因此,RTX Spark相當於一台能產生可量化經濟價值的Token生成器,你可以把它看成一座個人Token工廠。
RTX Spark帶來了一整套平台能力,包括AI模型、開發工具、安全機制及智能體應用,讓本地智能體能流暢運行,同時始終處於使用者的完全控制之下。
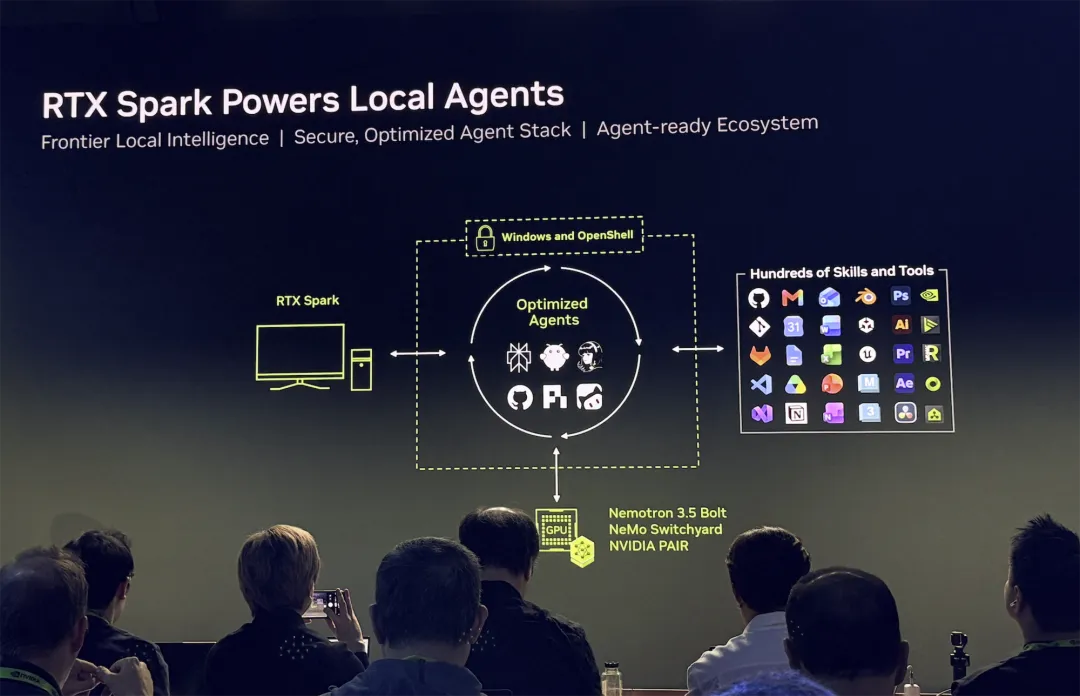
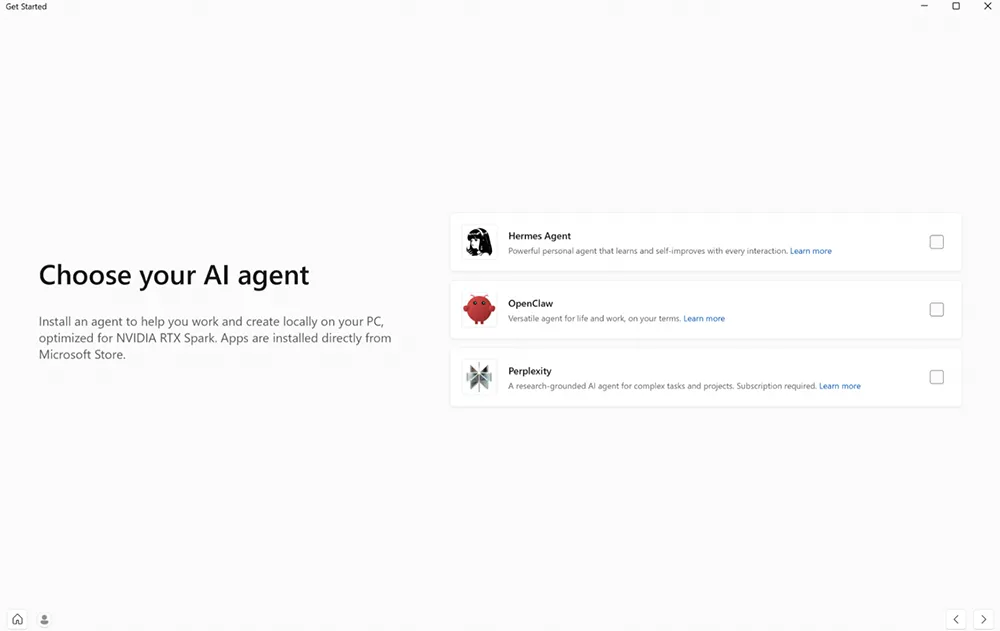
首次啟動時,入門指南會推薦3款智能體應用,引導使用者快速安裝和配置自己的個人智能體。
這些智能體配備全新安全沙盒技術:微軟MXC能在作業系統層面執行使用者對智能體設定的訪問限制,輝達OpenShell可簡化智能體對MXC的整合。
輝達推薦在6款應用中設定本地AI,分別是GitHub Copilot、Hermes Agent、Perplexity、OpenClaw、Pi和WorkBuddy。其中前3款支援混合提示詞路由,可在雲端與本地模型之間進行智能編排。
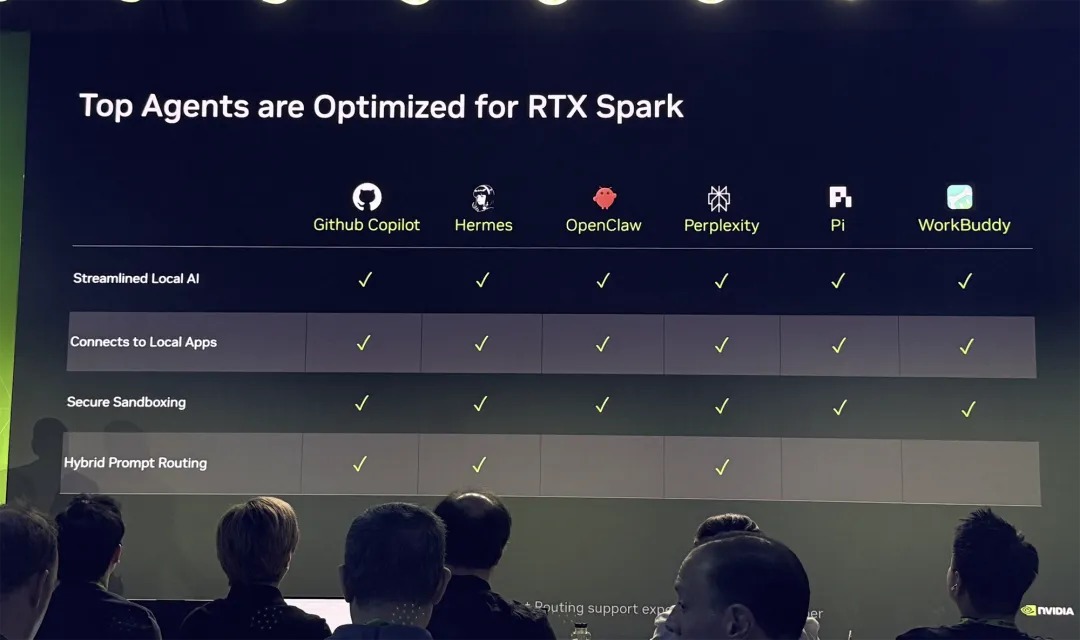
6款應用都簡化了本地配置流程。
輝達本地AI推理配方庫也提供了針對不同輝達硬體配置推薦的模型版本、推理後端和配置。(指路:github.com/NVIDIA/local-ai-inference-recipes)
04.
連接NVIDIA App本地助手,
讓智能體讀取和更改設定.
我們用的是國產智能體軟體WorkBuddy,安裝騰訊最佳化過的本地模型大小為15.2GB,需要至少32GB記憶體。點選幾下就完成了配置。
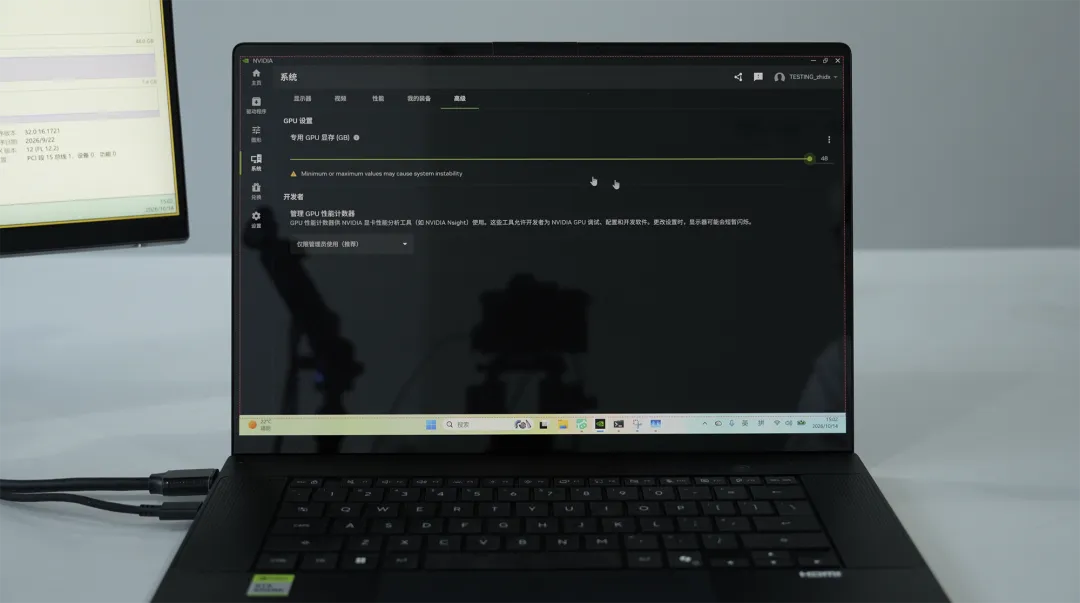
在NVIDIA App中可自行調整分配給GPU的記憶體容量,64GB記憶體配置下最多能分配48GB。
智能體可通過MCP庫和命令列介面(CLI)連接到主流的Windows應用,這一生態系統已覆蓋超過100款應用程式、工具和軟體庫。
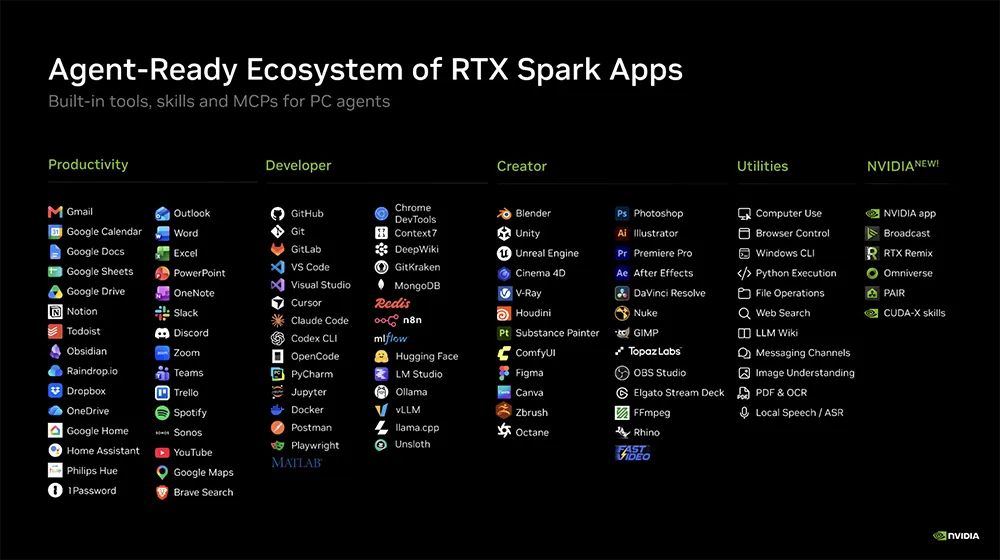
NVIDIA App、Broadcast、PAIR、Omniverse、RTX Remix等輝達應用也通過MCP介面向智能體開放。很多CUDA軟體庫能以Skill的形式供智能體呼叫。
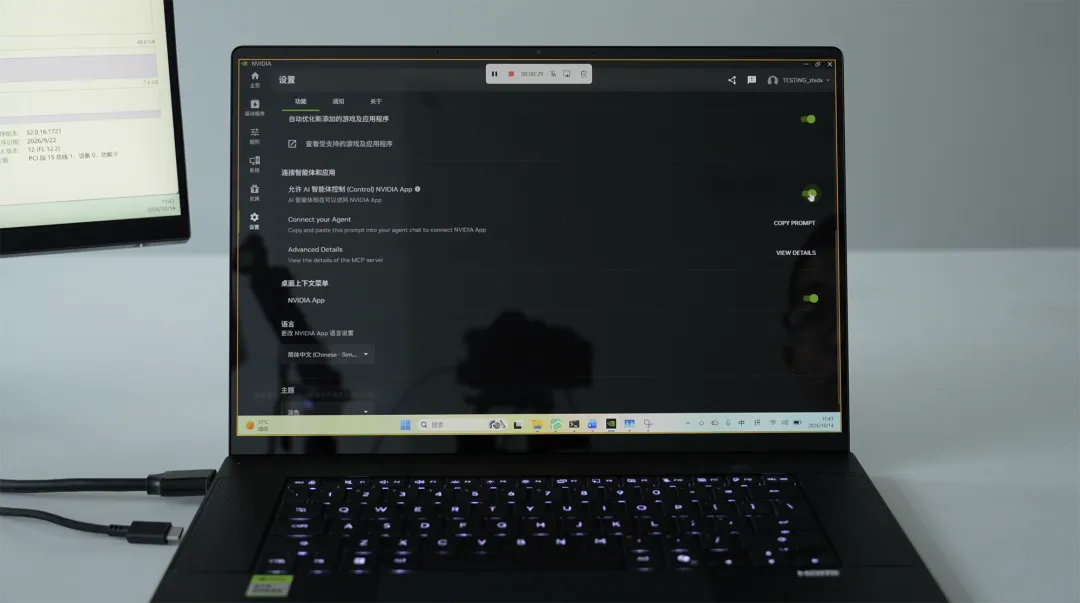
因此,在WorkBuddy裡連接NVIDIA App本地助手,就能實現用自然語言操作查驅動更新、啟動遊戲、更改設定等各種配置。
我讓智能體查看當前GPU和應用設定有那些能夠最佳化的,它給出了檢測結果和最佳化建議,更改配置也能直接在智能體中完成。
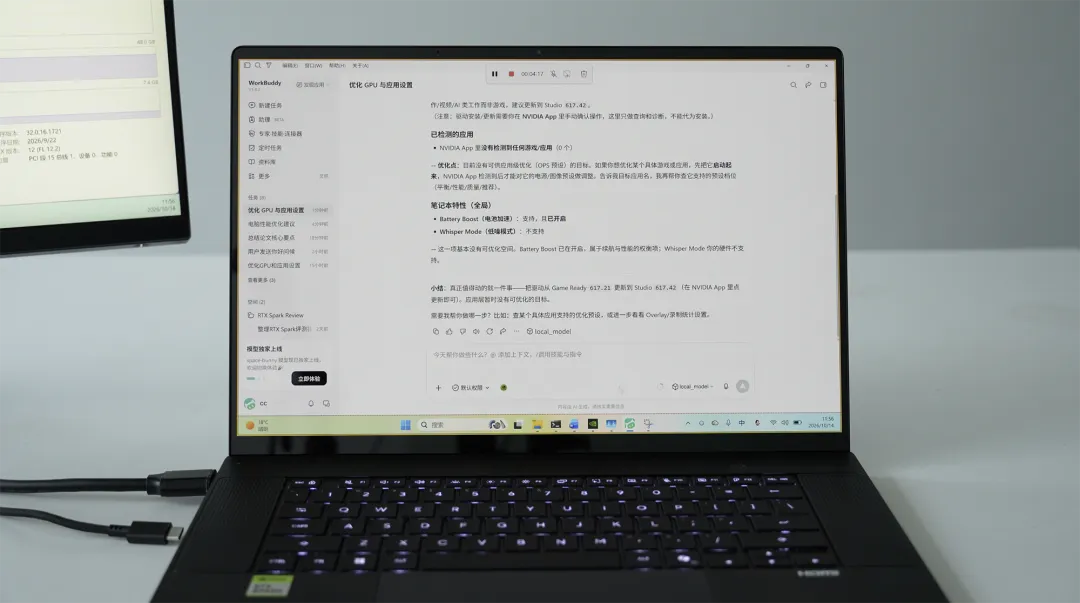
WorkBuddy裡還將設一個RTX Spark專區,可直接點選“驅動速查”、“應用最佳化”、“省電靜音”、“錄製螢幕擷圖”、“畫面增強”等選項。
05.
實測本地智能體替我做事:
讀論文、整發票、輔助評測、程式設計開發
拿頂配晶片來跑日常任務,多少有些大材小用。因此我們重點關注了它運行智能體任務的實際表現。
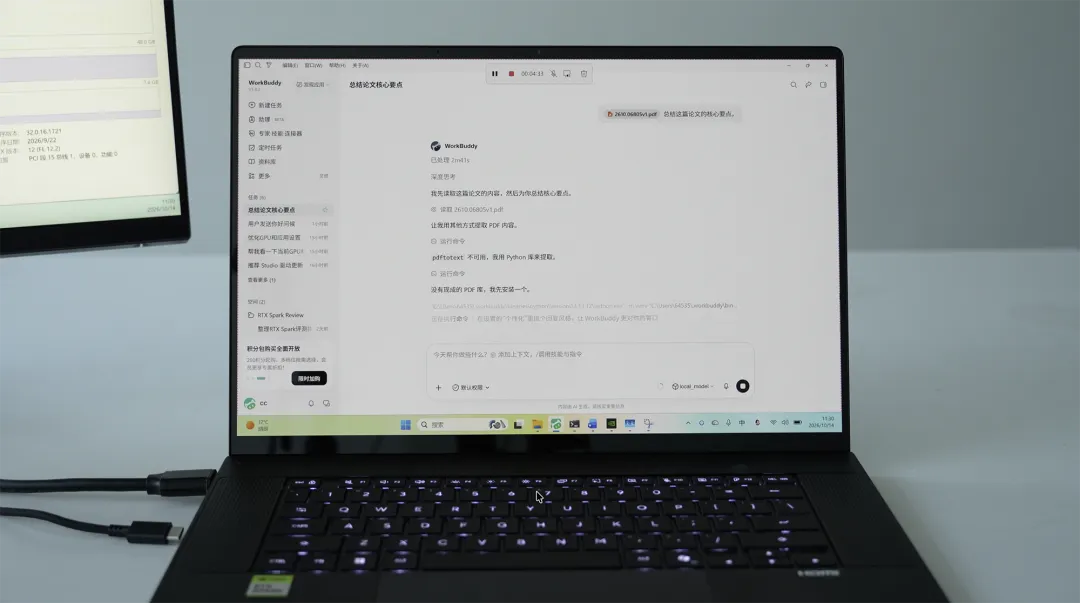
做論文字地解析和問答,非常輕鬆。這項能力適合在本地研究一些不能上傳雲端的保密檔案。
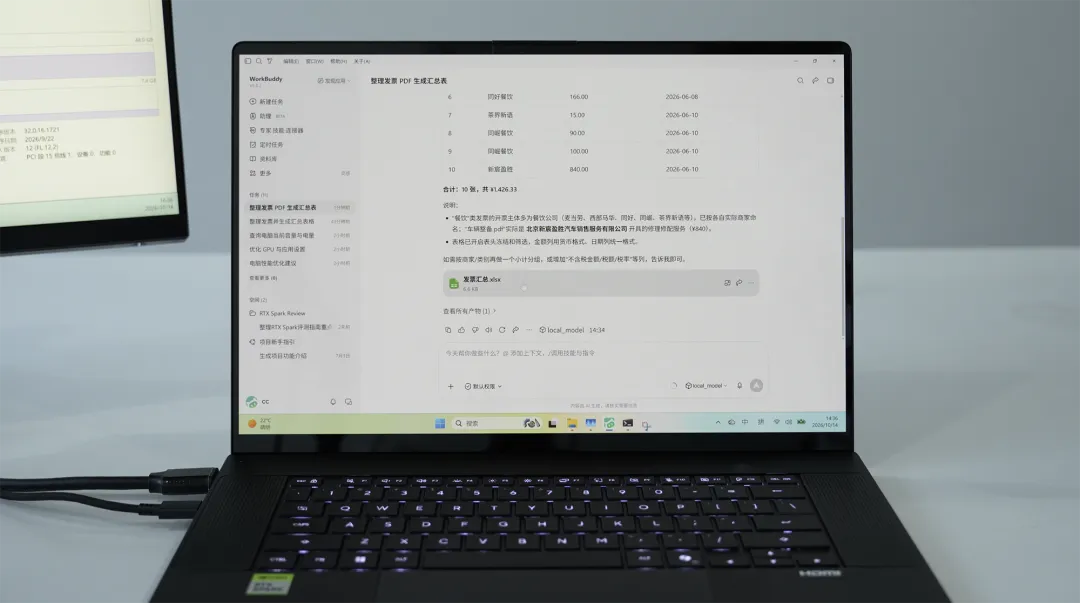
整理資料夾裡的發票資訊並生成彙總表,也能執行。不過增加發票數量後,WorkBuddy就出bug了。
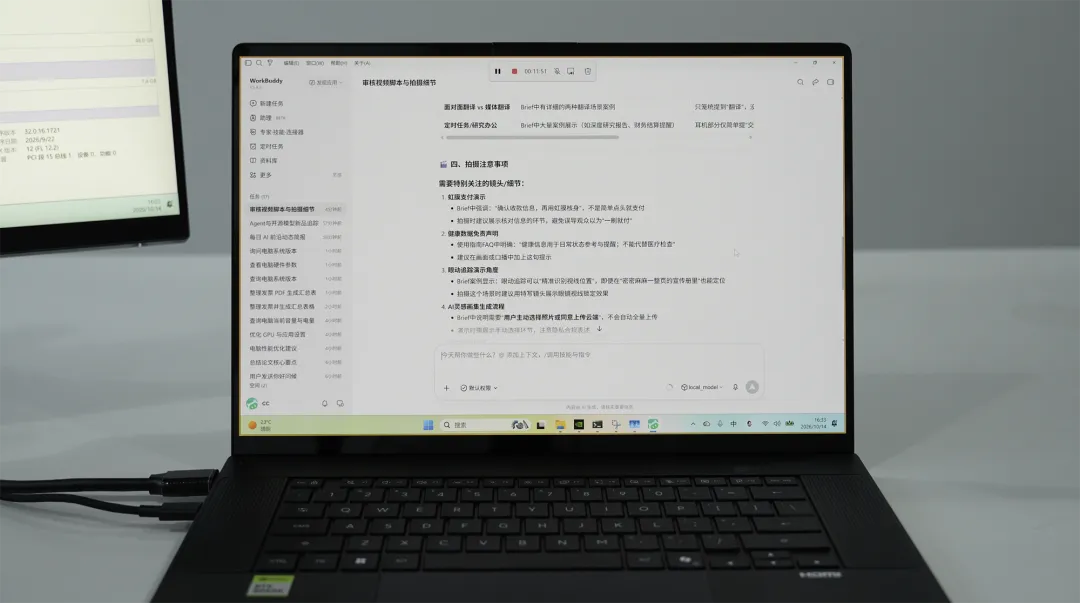
我們還讓智能體對照著評測指南,給一個項目的視訊指令碼提意見,這比我自己逐行對比檢查效率高得多。
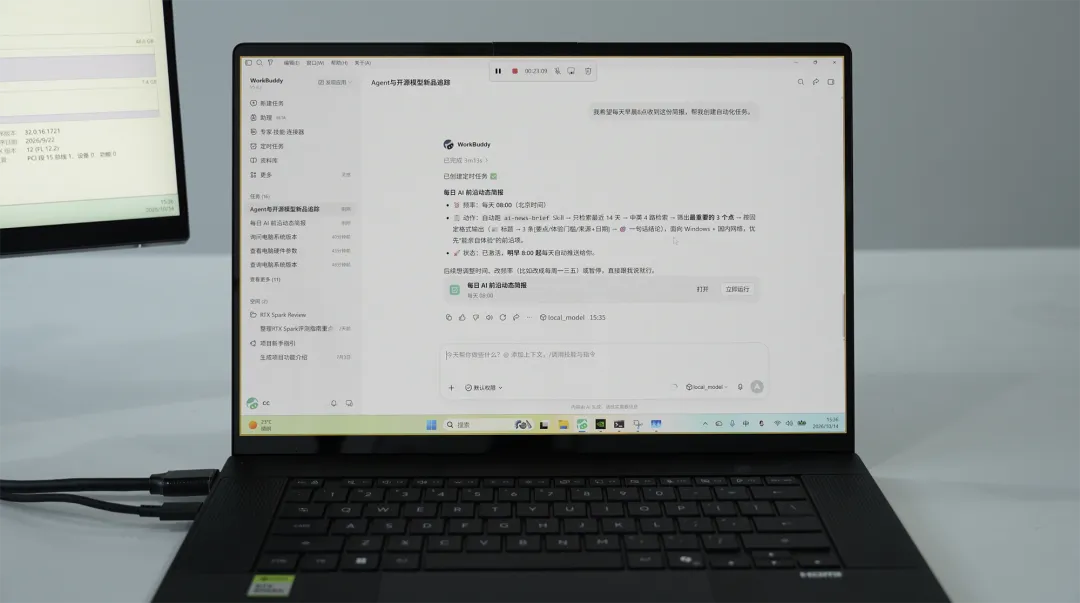
至於總結AI資訊、提煉要點、把流程做成Skill、設定定時自動化任務,WorkBuddy就更遊刃有餘了。
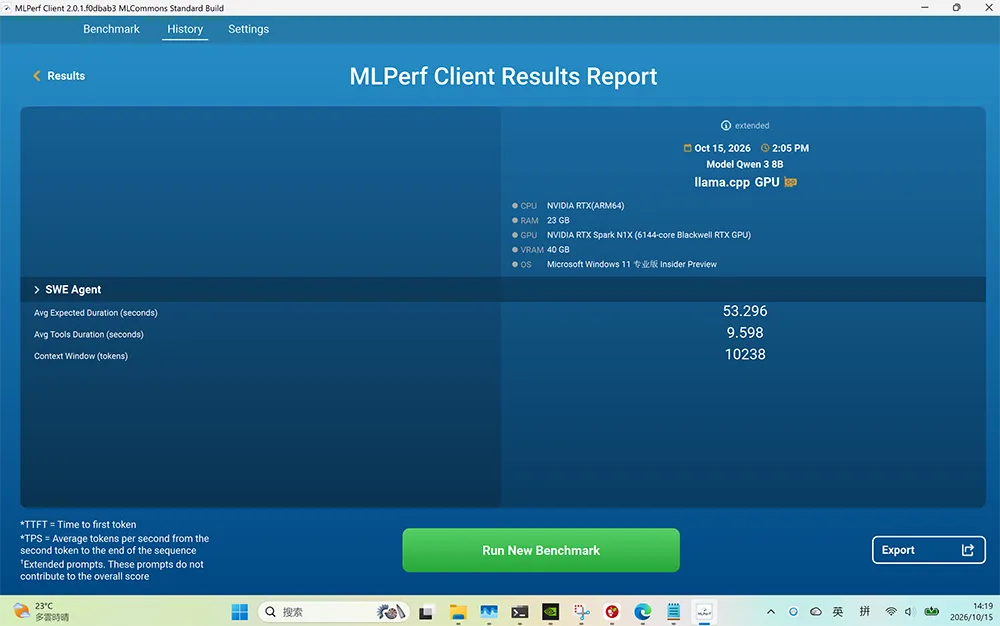
具體到AI性能上,在MLPerf Client測試中,測試軟體開發智能體,平均預期任務耗時53.296秒,平均工具執行耗時9.598秒。
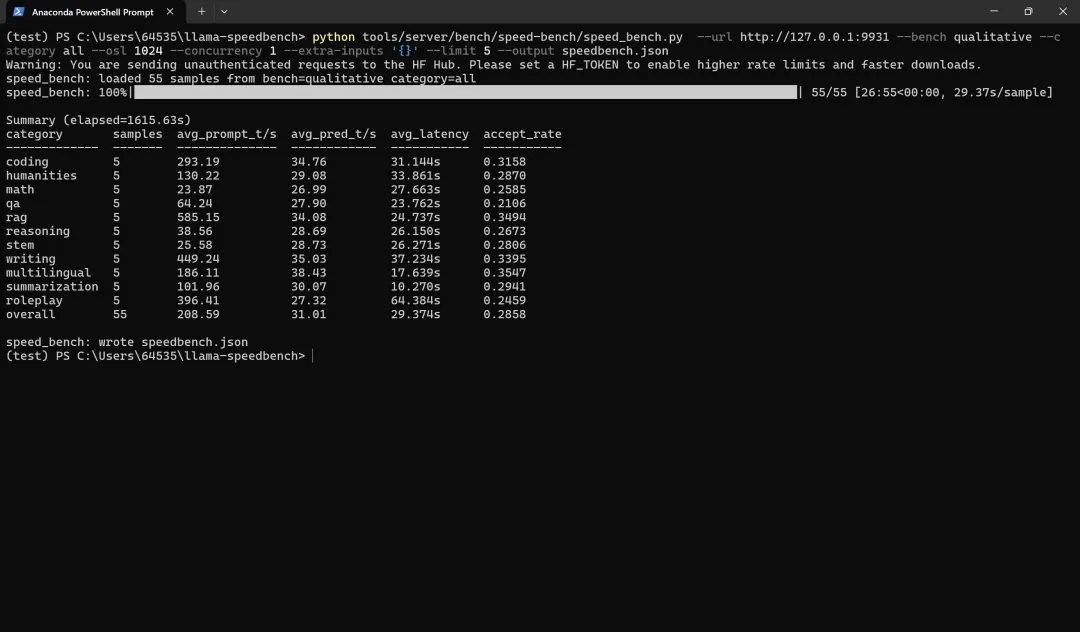
在更側重測試“速度”的SPEED-Bench中,跑11類任務,大模型平均輸入處理速度為208.59 tokens/s,平均輸出生成速度為31.01 tokens/s,總測試耗時26分56秒。
運行本地模型時,我們進行了瀏覽多個網頁、文件處理等多工平行操作,總體順滑,沒有遇到卡頓情況。
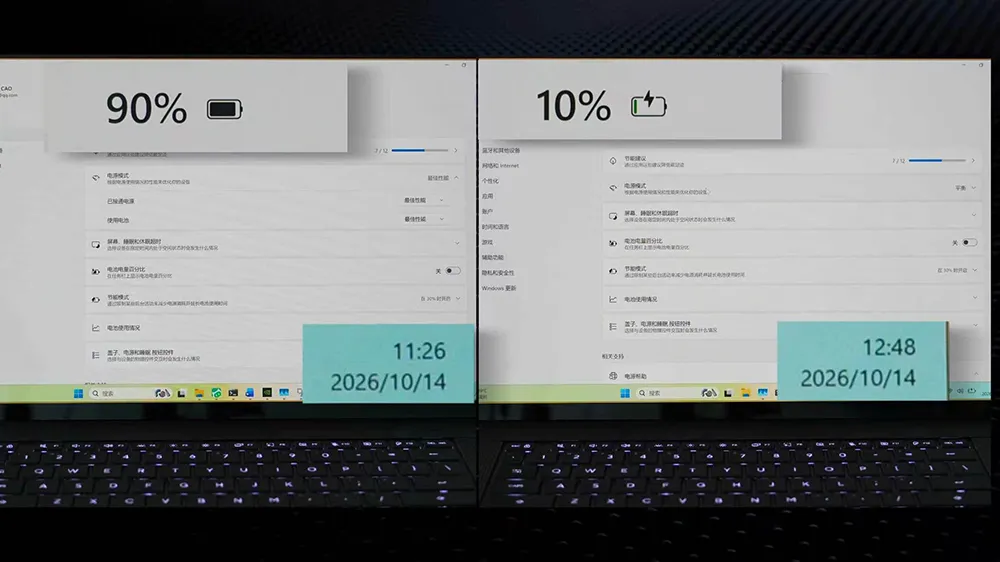
從續航來看,這款筆記型電腦內建99.9Wh大容量電池,官方標稱最長續航28小時,可支援移動辦公。但根據我們的測試,如果不插電,它並不適合做持續的高強度開發或遊戲任務:在性能模式下高負載運行AI評測時,電量從90%掉到10%,用時1小時22分。
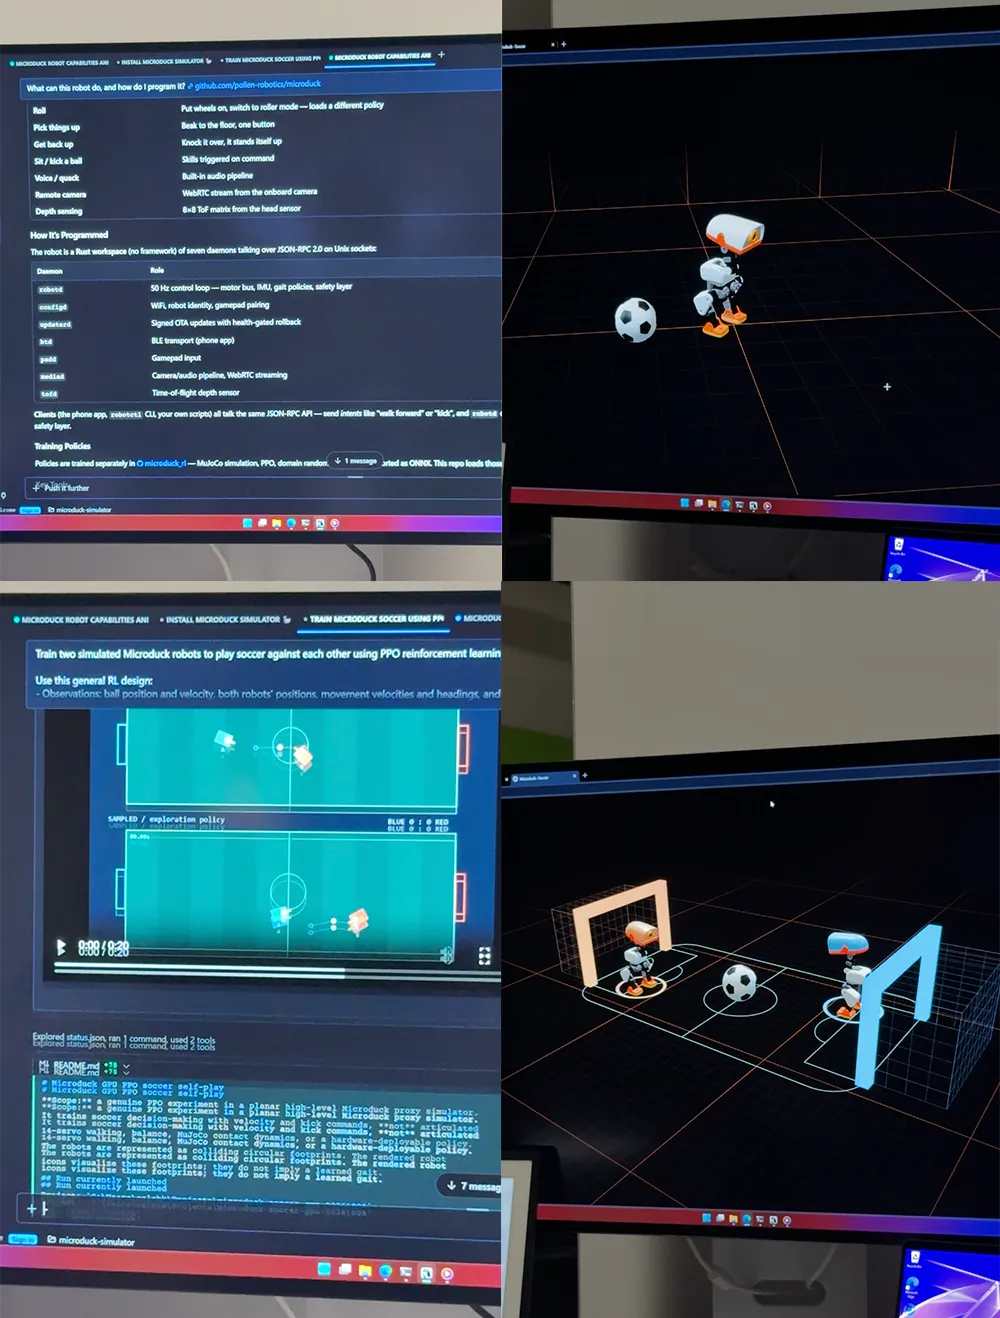
在舊金山RTX Spark培訓會上,我們還看到智能體自主開發模擬控制機器鴨執行動作和用強化學習訓練機器鴨踢足球的項目演示,這些開發過程都是在RTX Spark本地運行。
輝達推薦開發者用RTX Spark來跑目標導向程式設計和決策模型。
目標導向程式設計是直接設定目標和獎勵函數,讓智能體自己不斷迭代,使用本地硬體就不用擔心迭代太多輪而導致API呼叫費用飆升。
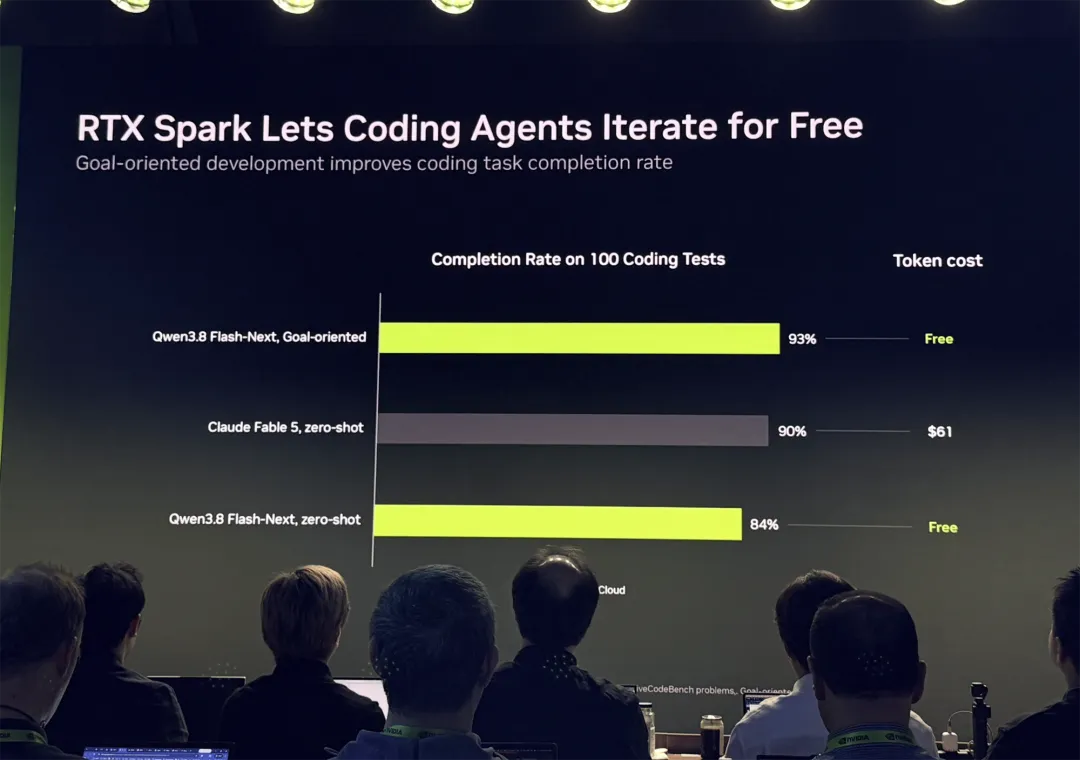
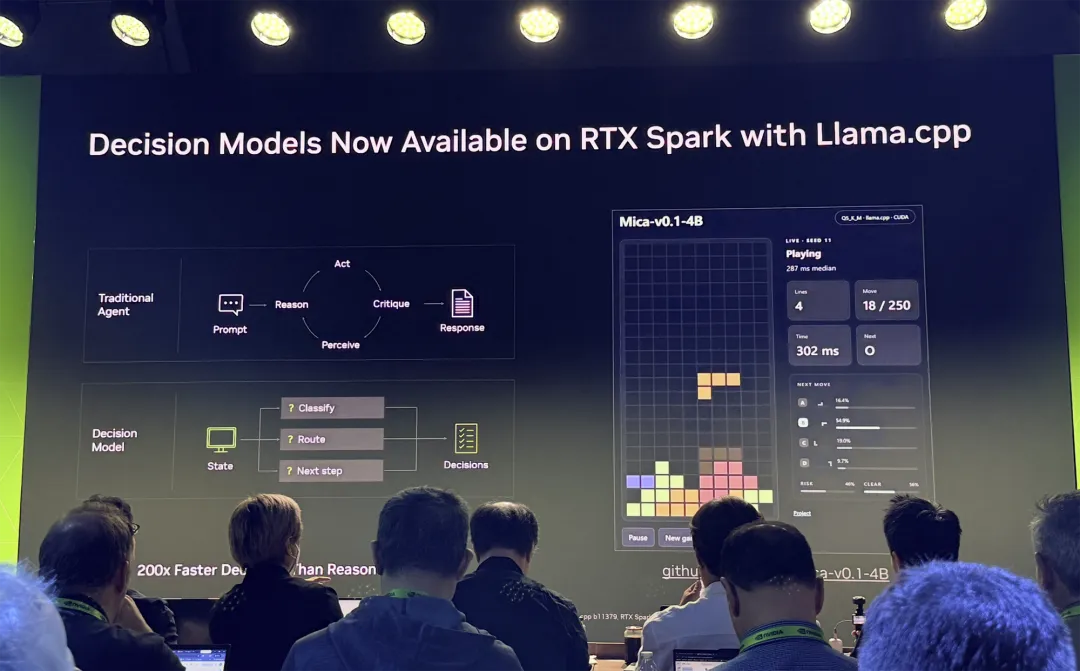
決策模型的速度可達到傳統智能體的200倍。llama.cpp和Unsloth在RTX Spark上均支援決策模型。
下圖是一個利用決策模型建構的項目,顯示有每一次決策所需的毫秒數,在頂部遊戲方塊完成渲染之前,模型就已經決定了應該將方塊放在那兒,並讓它落下。
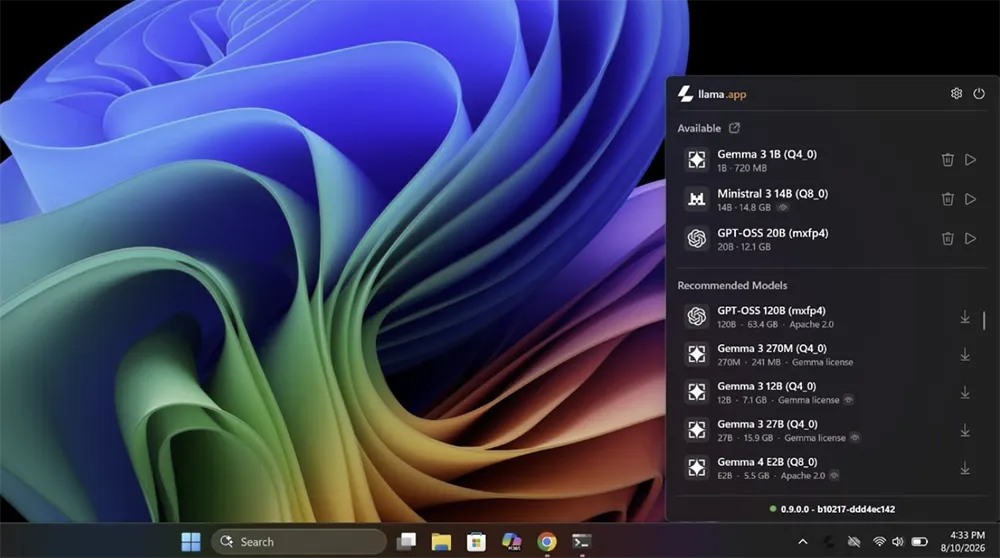
Llama.cpp還發佈了一個Llama Windows應用,無需進入命令列,點選一下就能在本地下載和運行模型。這款應用也針對RTX Spark做了最佳化。
06.
本地定製專屬大模型,
最佳化特定性能表現.
除了推理外,在RTX Spark上,你還能對基礎模型做微調,來進一步最佳化模型在特定任務上的表現。
微調能將模型調整成更適合特定任務、更符合需求的輸出結果。這個過程需要大量的GPU計算資源和記憶體,通常需要在工作站或雲端進行。
RTX Spark則使本地微調更加便捷。
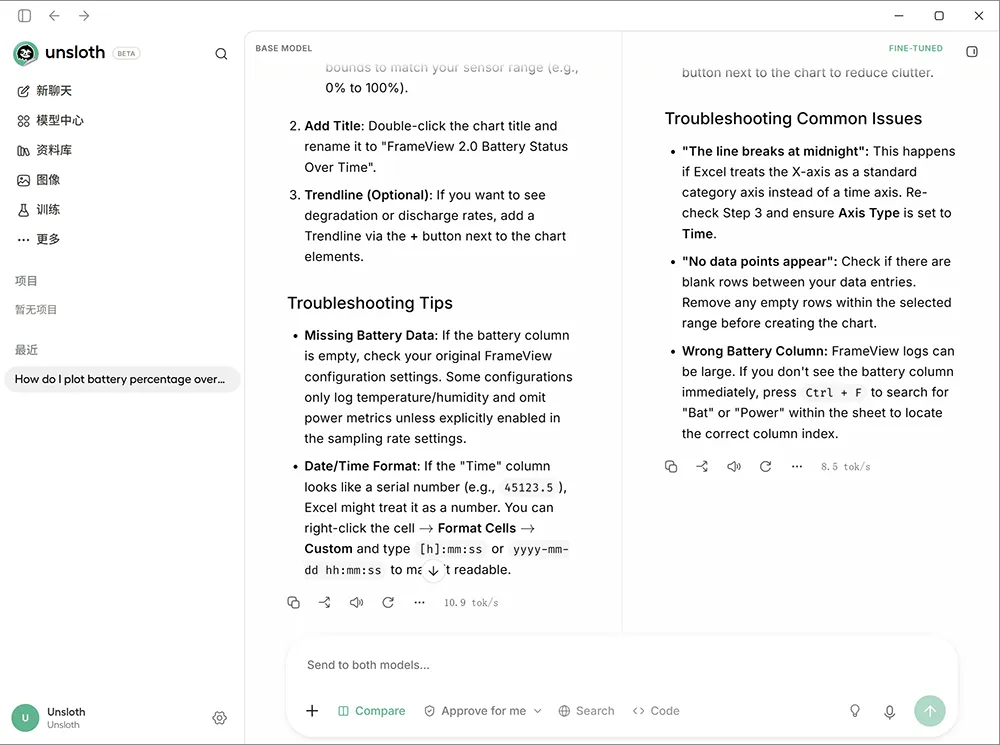
在Unsloth Studio上,選擇被訓練模型為Qwen3.5-9B,方案選LoRA,上傳輝達FrameView使用者指南的問答資料集來對模型進行微調,目標是生成簡短、直接的回答。
訓練完後,比較原基礎模型和微調模型針對同一個問題輸出的答案,可以看到微調模型的輸出更簡潔。
07.
運行家庭智能體,
一台PC管夠全家算力.
本地智能體不必只運行在一台PC上。
RTX Spark既能運行家庭智能體,又能利用空閒算力,為家庭成員的個人智能體提供共享算力。
以前智能家居要花很多時間來設定和配置各種規則。有了家庭智能體,你可以在一個自然語言互動介面裡操控所有智能家居裝置,還能利用本地AI監控家庭安全,記住生活細節,即時提醒全家的日程安排。
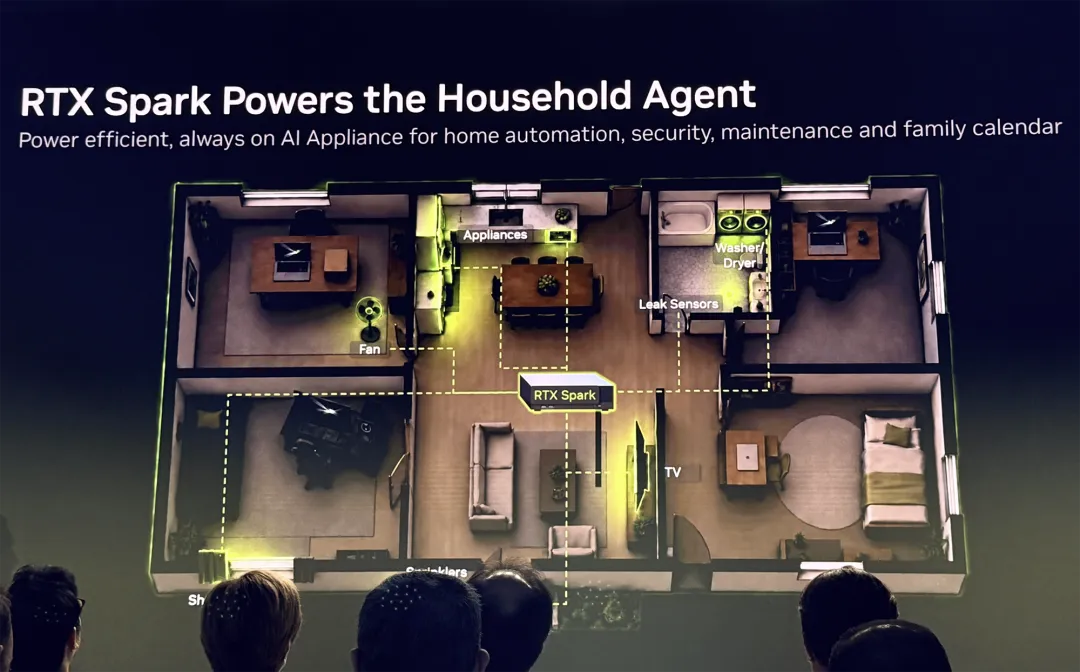
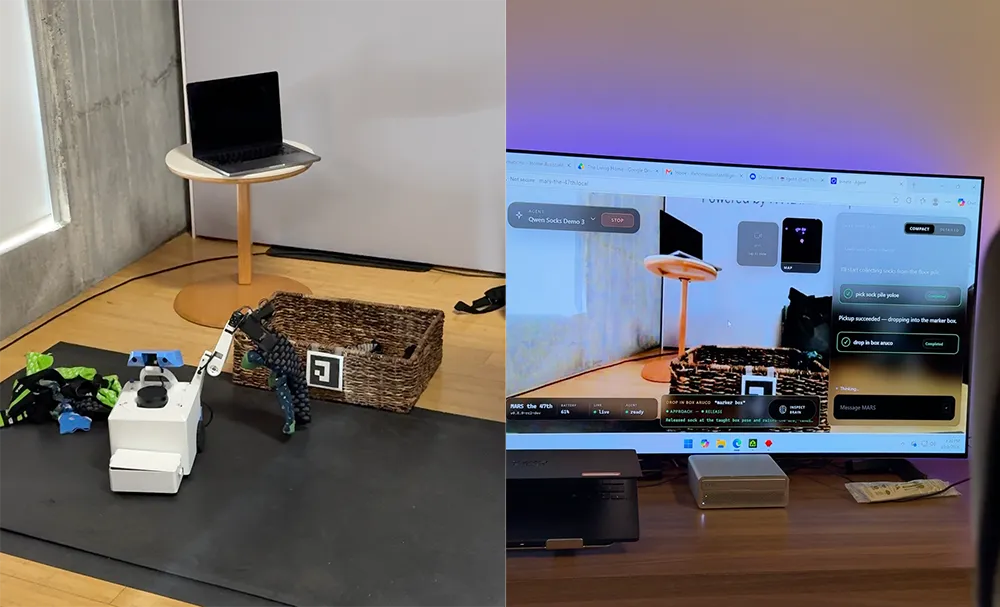
未來一個家庭裡可能會有機器人來幫助做家務。在舊金山RTX Spark活動上,一個演示是基於RTX Spark的本地算力為機器人建構和運行本地模型,通過自然語言發出指令,指揮機器人撿起襪子。從旁邊的螢幕上可以看到,機器人能即時感知周圍環境,根據當前情況做出決策。
家庭成員們也可將各自的PC連接到RTX Spark:跑一個智能體任務時,可以把相互獨立的推理任務拆分到不同裝置上平行處理;想在自己的PC上玩遊戲,就把正在執行的智能體任務轉移到RTX Spark上。
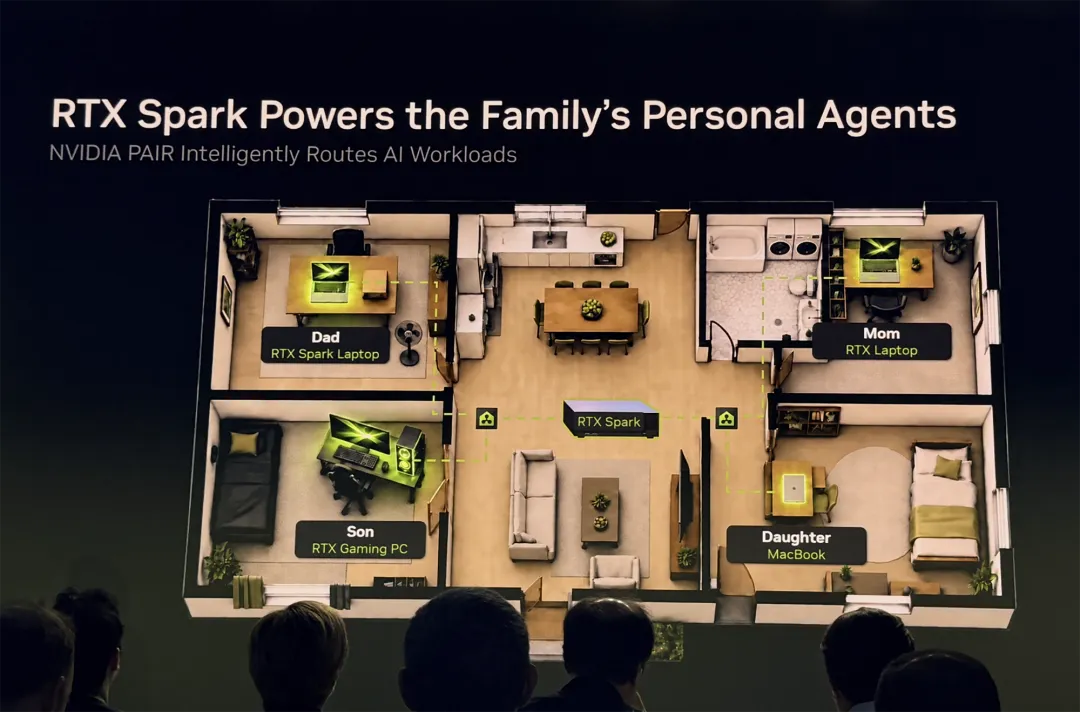
這些算力資源均由NVIDIA PAIR統一協調。
NVIDIA PAIR是輝達打造的一款開源個人AI算力路由軟體。該工具能自動發現並連接裝置,安裝模型和推理引擎,在區域網路內的不同裝置之間智能調度推理任務。通過智能路由,系統能充分利用你的所有計算資源。
08.
實現混合智能:
本地搞不定的,才分給雲端模型
很多使用者需要雲端和本地模型交叉使用,用雲端模型做需要頂級性能的任務,用本地模型做需要反覆迭代、很消耗Token的任務。
對此,輝達打造了一款開放原始碼的模型路由庫NVIDIA Switchyard,使智能體能在本地和雲端大模型之間智能路由查詢,幫助使用者最大限度地減少雲資源的使用,同時獲得與直接在雲端運行類似的結果。
智能體收到使用者提示詞後,會先將請求發給本地模型,同時Switchyard中的驗證器會發揮裁判作用,一旦發現某項任務無法在本地得到妥善處理、需要更強的推理能力,就將任務升級並轉交給雲端模型,實現混合智能。
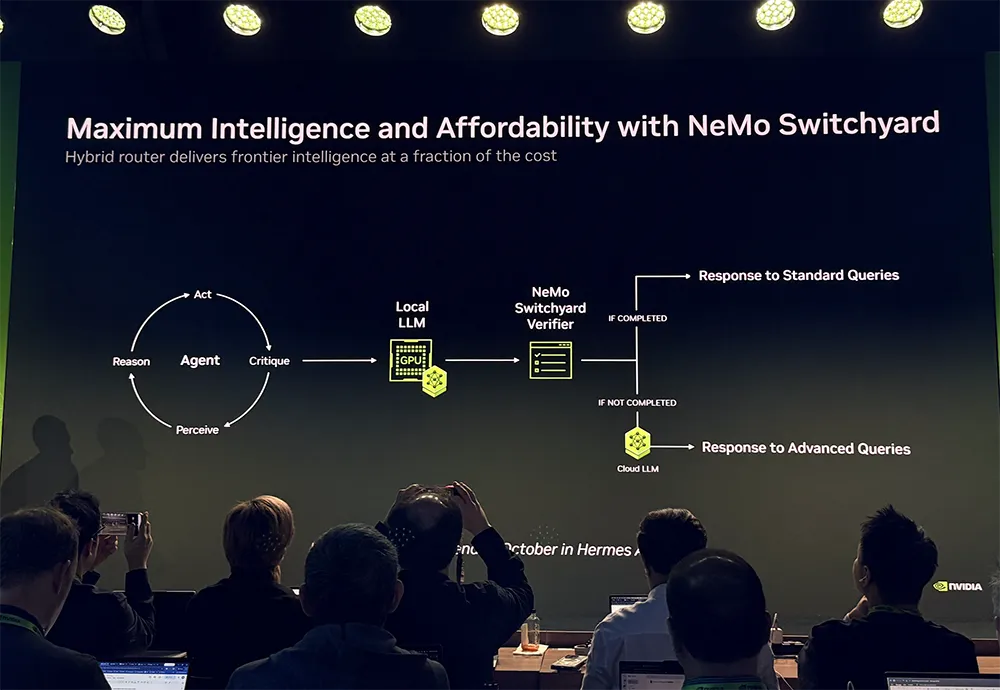
Hermes將在本月下旬整合Switchyard。
阿里千問Qwen系列模型已經非常優秀了,但運行125B模型仍需要用七八十GB的記憶體。
為此,輝達專為在RTX Spark上運行本地智能體而設計了一款Nemotron 3.5 Bolt混合專家模型,目標是在速度和智能之間實現最佳平衡。
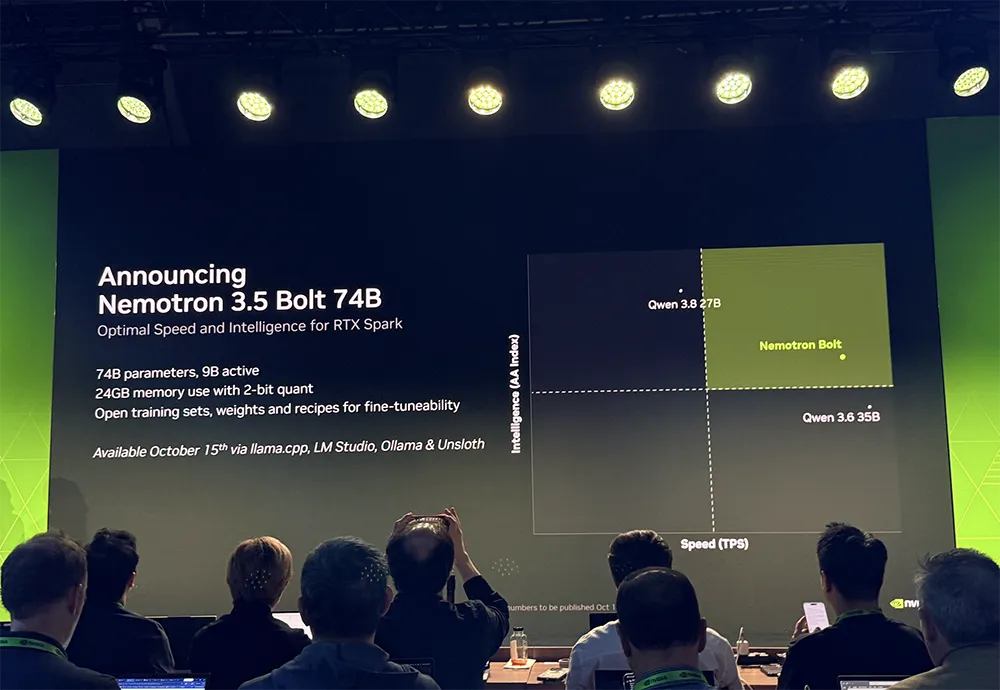
它擁有740億參數、90億啟動參數,採用2-bit量化,並結合先進的量化感知訓練技術來保持模型質量,最終將記憶體需求壓縮到24GB。
在記憶體佔用相近的情況下,它的速度比多數主流密集型模型更快,智能程度比多數主流MoE模型更高。
09.
智能體搞定專業創作全流程,
“AI抽卡”不限量、更省錢
一套複雜的創作流程,可能要用到很多專業工具。
比如先在Photoshop中完成概念設計,再在ZBrush中進行數字雕刻,到Substance中繪製材質,之後進行角色繫結,在Blender中製作動畫,然後使用Unreal Engine編輯器完成整個場景佈局,到Houdini中模擬大量特效,接著用V-Ray渲染所有內容,再把這些渲染圖層匯入Nuke,完成合成後用Pro Tools處理聲音,最後回到Premiere完成視訊剪輯、調色,發佈作品。
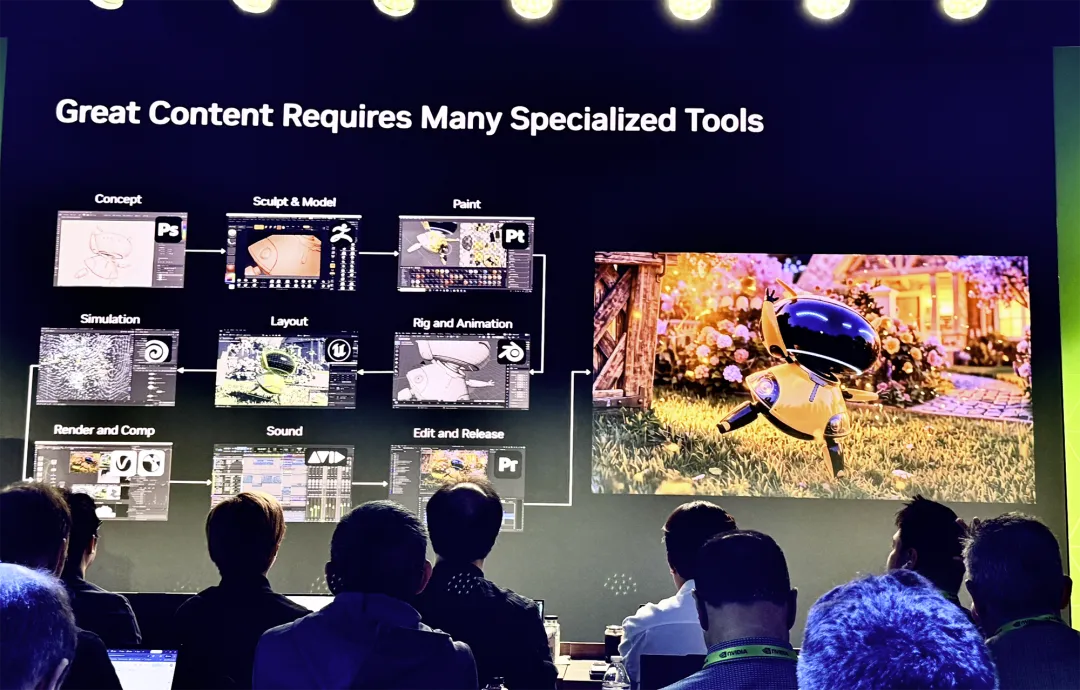
掌握其中的每款工具,都需要投入大量時間。而智能體可以替你操控不同的工具,這樣你不需要親自學習和操作不熟悉的軟體,從而大幅擴展能夠完成的工作範圍。
RTX Spark最新及即將推出的更新——首發時將支援數千款應用、遊戲和模型。其中許多應用已推出支援智能體連接的MCP伺服器。
Adobe的頂級應用將迎來最高2倍的性能提升。輝達和Adobe合作對Photoshop和Premiere進行了架構重構,以實現GPU加速的合成功能,可加快Photoshop的圖像編輯響應速度,並提升Premiere視訊編輯的播放、渲染、特效等性能。
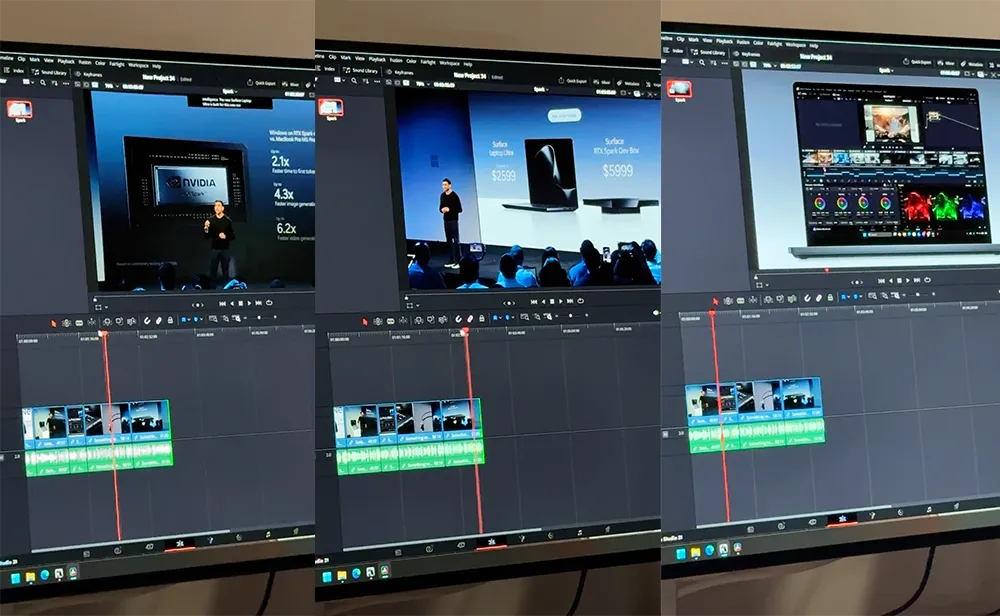
新AI模型在發佈之初就能獲得RTX加速。NVFP4可縮小模型體積,同時保持出色的生成質量,並實現約1.5倍的性能,從而顯著壓縮所需佔用的記憶體資源。
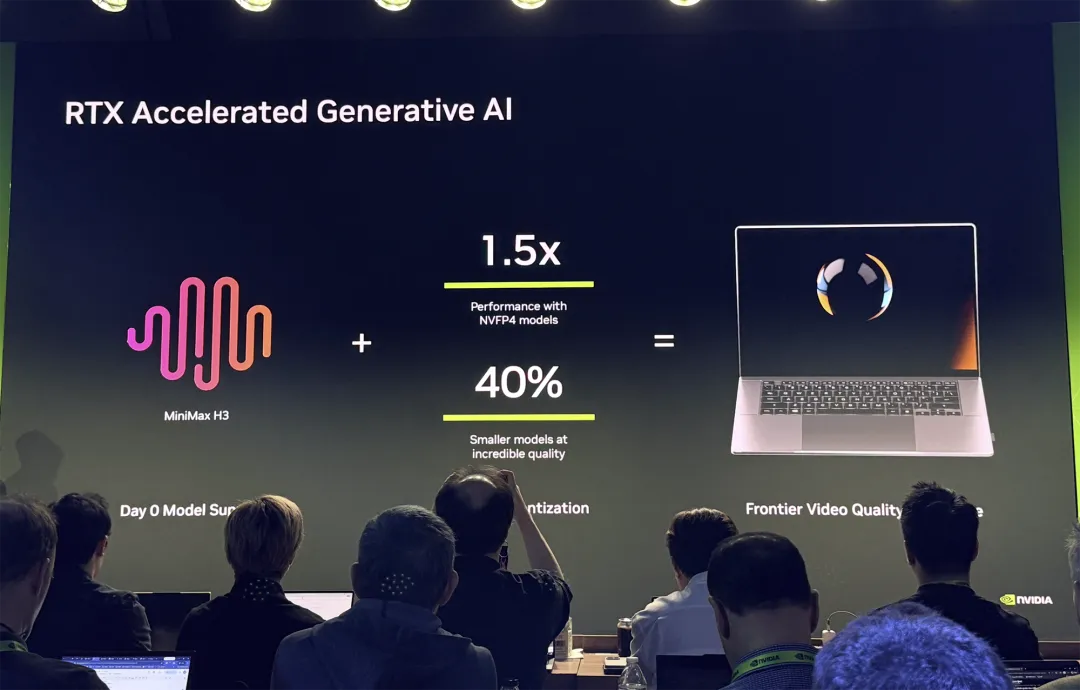
對於雲端資源擁塞、抽卡費錢的視訊生成模型來說,本地運行的好處就非常直觀了,沒有使用量限制,想生成多少次就生成多少次。所有操作的額外直接成本,基本上就是給電腦供電所消耗的電費。
生成式AI創作平台ComfyUI現已支援輝達RTX Video幀生成和HDR功能,可加速AI生成視訊工作流程。
例如,將LTX 2.5視訊生成模型與NVFP4、RTX Video幀生成及HDR技術結合使用,就能將原本1080p、30fps的SDR視訊片段轉換成更流暢的60fps HDR視訊,並支援匯出為EXR檔案來用於後期調色。
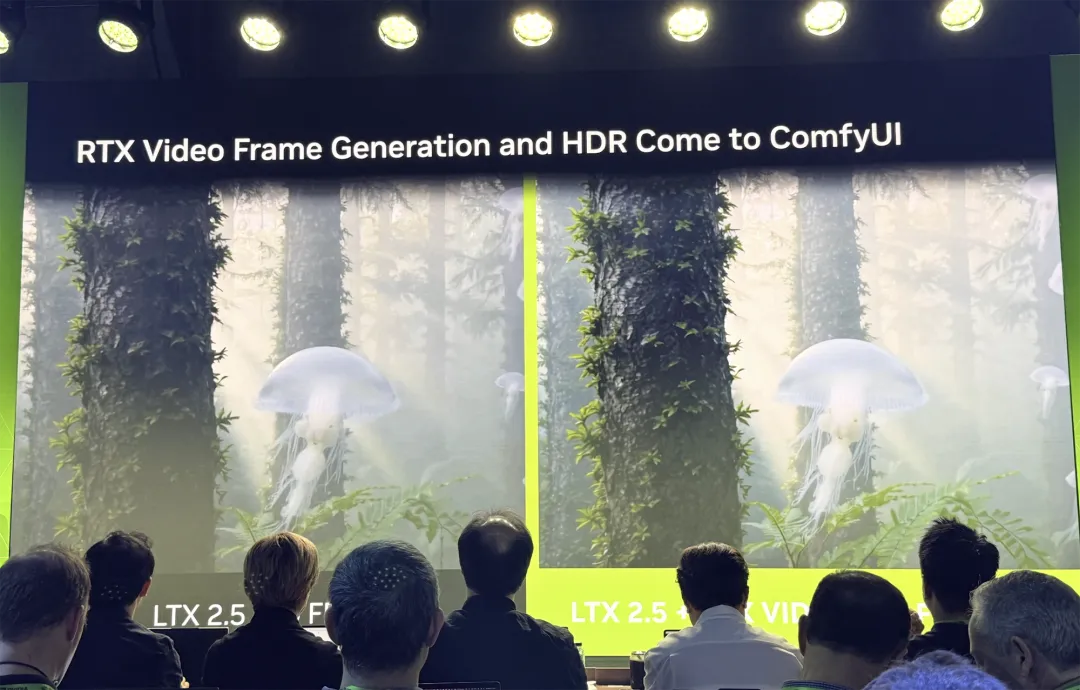
NVIDIA Broadcast 2.3音視訊最佳化軟體可在RTX Spark上原生運行,帶來了新的RTX Video超解析度、RTX Video幀生成、離線檔案處理和智能體MCP控制功能。
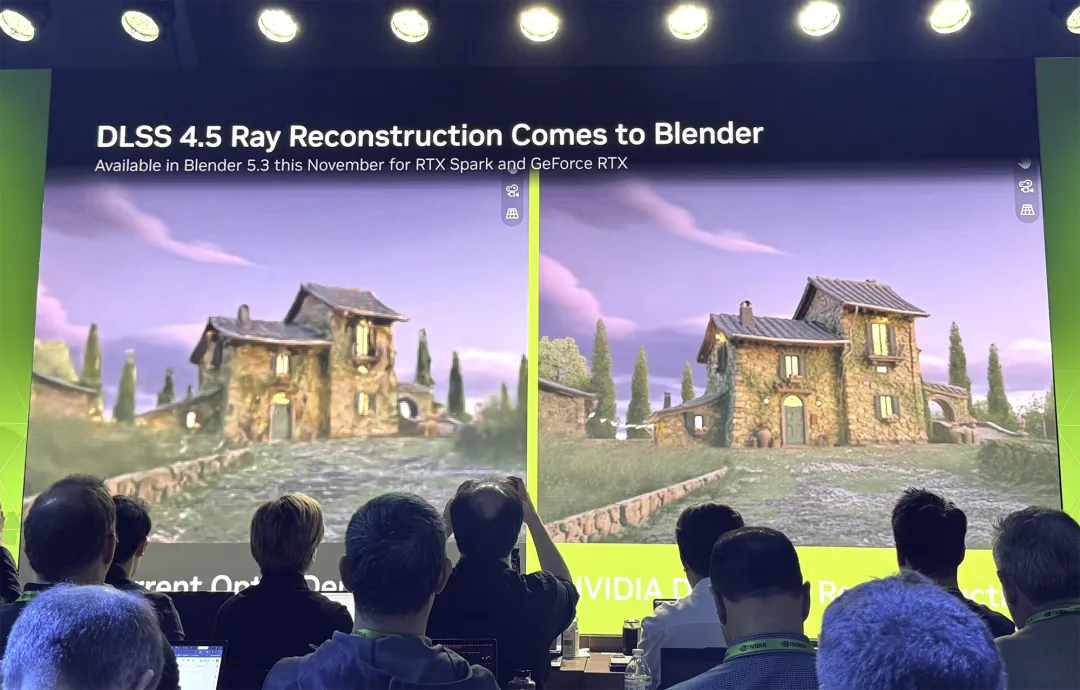
NVIDIA DLSS光線重建技術在Blender 5.3版本中推出,以改善視口中的互動性。相比業界領先的OptiX降噪器,它能顯著提升畫面質量。
10.
能玩數百款熱門遊戲,
支援AI改造遊戲三大環節
基於輝達長期積累的遊戲硬體、軟體和技術支援,RTX Spark可以玩數百款熱門遊戲。
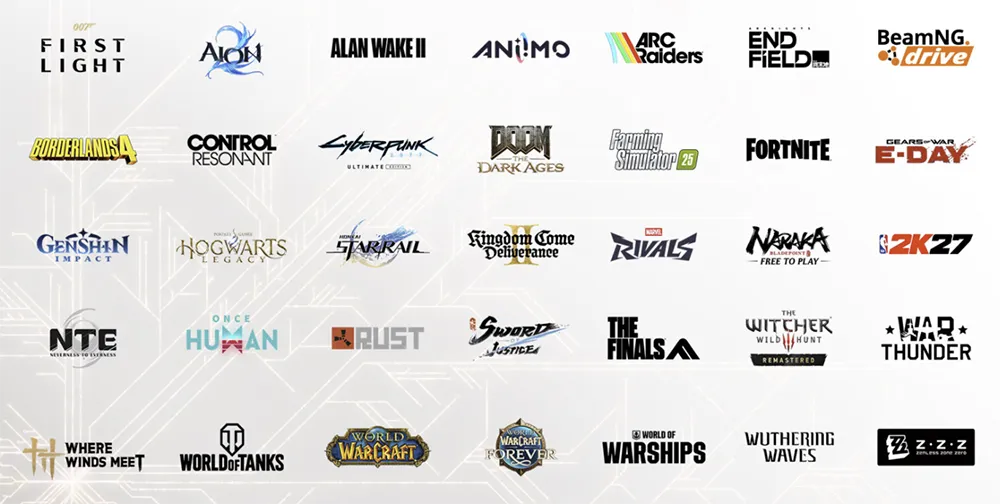
通過RTX Spark,AI能為遊戲的三大環節(渲染、玩法、創造)帶來全新體驗。
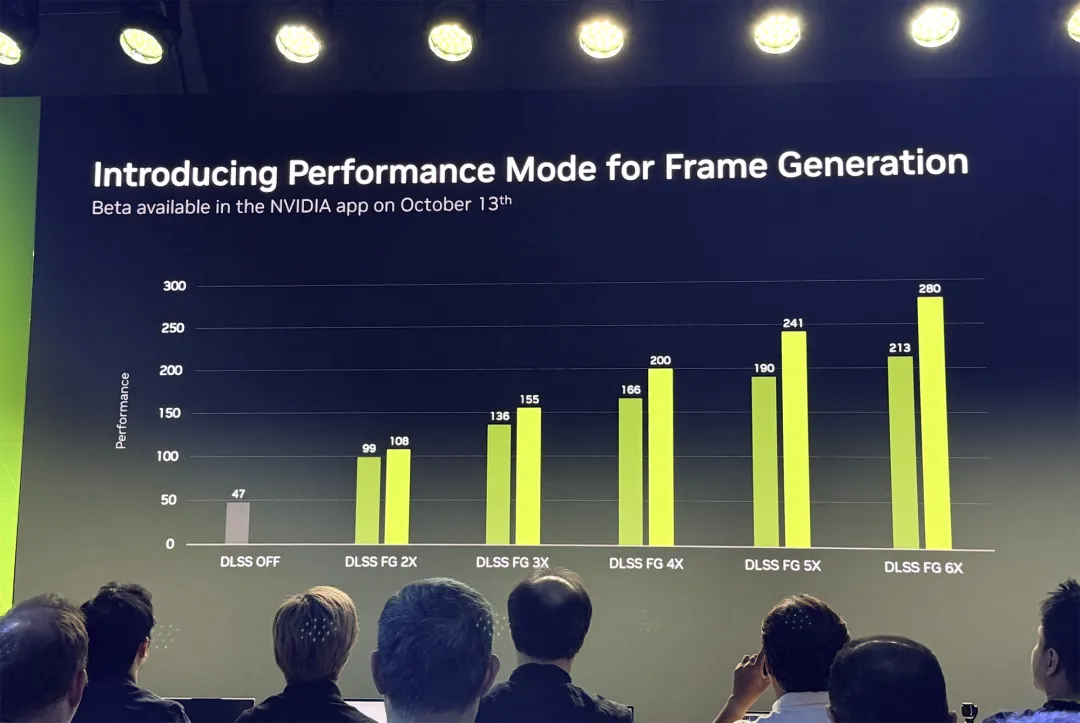
(1)遊戲渲染:模型執行速度顯著提升的新DLSS 5 AI模型將在本周發佈;全新DLSS幀生成性能模式Beta版可通過NVIDIA App獲取,它將原先用於計算 UI、光線追蹤效果等畫面元素光流的第二個 AI 模型取代為更快更輕量的演算法,可進一步降低計算開銷,提升影格率,但會帶來輕微的畫質取捨。
DLSS 5仍使用FP8資料格式,對處理流水線、AI模型等做了大量最佳化,還將模型參數減少24%至1.18億個參數,同時降低了視訊記憶體佔用。開啟DLSS 5後可獲得更出色的光照、陰影和細節。
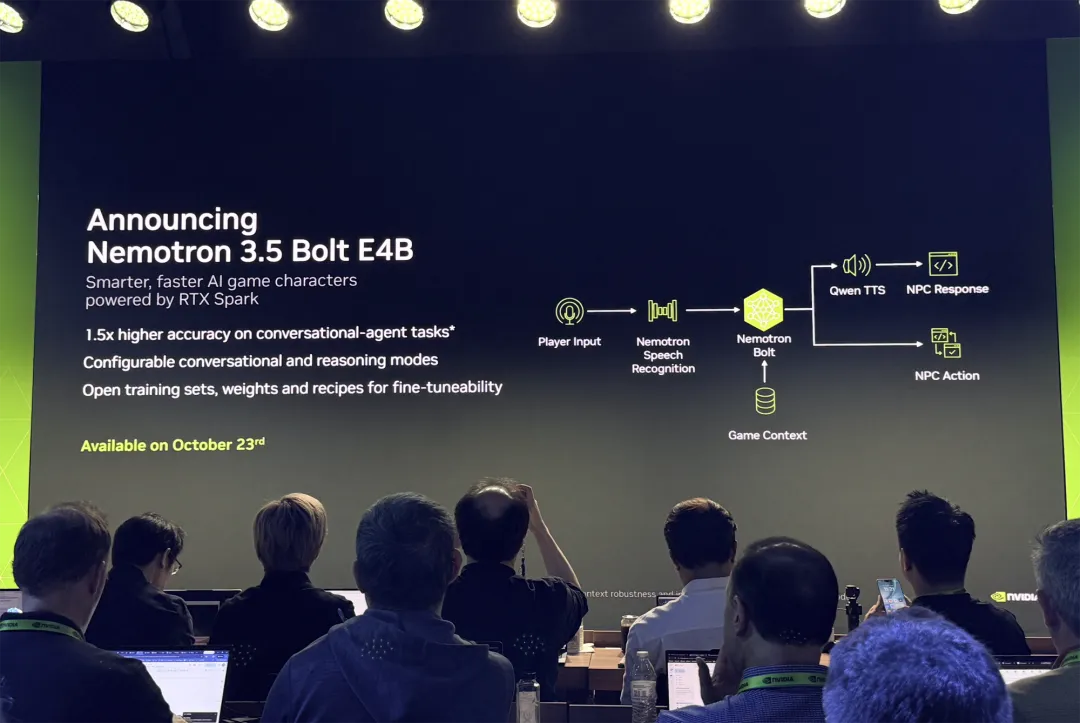
(2)遊戲玩法:支援反作弊系統,NVIDIA ACE AI遊戲角色的第三代小語言模型Nemotron 3.5 Bolt E4B 4GB將於下周發佈;遊戲AI智能體可扮演AI隊友、AI助手、AI NPC等角色,降低玩家的學習成本,提升遊戲體驗。
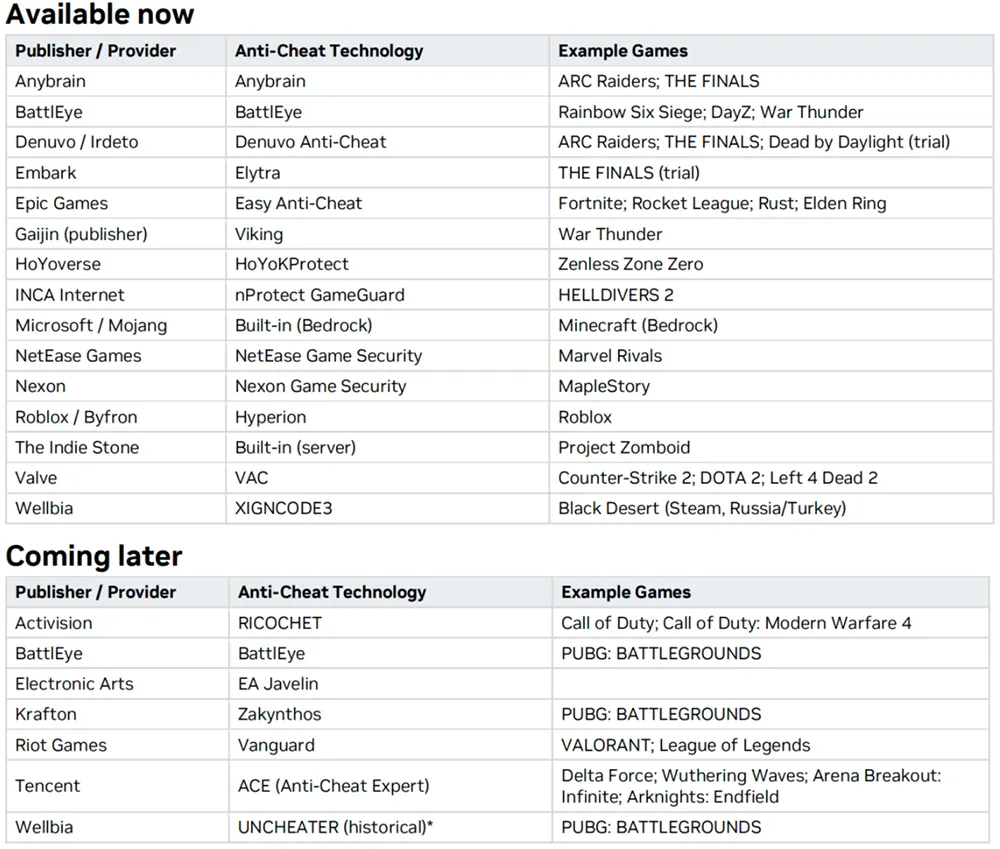
Nemotron 3.5 Bolt E4B 4GB是一款開源模型,利用了GoogleGemma模型系列相關技術,能在RTX Spark上高效運行,在對話智能體任務中精準率提升50%,可使AI角色更準確地理解和回應玩家;對話推理模式可配置,支援開發者按需在精準率與性能之間進行調整。
(3)遊戲創作:程式設計AI智能體正在大幅提升遊戲內容創作效率;Mod開發者引入智能體來讓NPC具備更智能的互動能力,讓更多遊戲相容RTX Remix;包含DLSS 5支援的RTX Remix更新將於下周發佈。
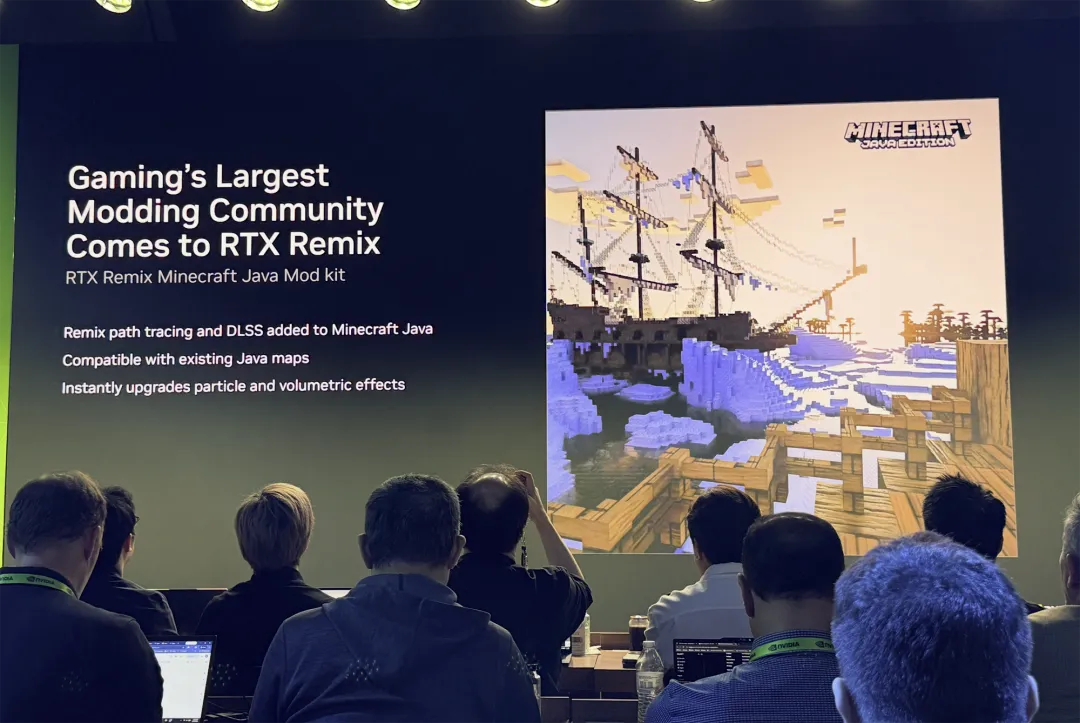
輝達也利用智能體加快了《我的世界》Java版Mod工具包的開發,測試版將於下周發佈。這意味著RTX技術將進入遊戲行業規模最大的Mod創作社區之一。
11.
結語:你需要一台RTX Spark嗎?
總體來看,華碩ProArt 創16 RTX Spark筆記型電腦尤其適合想兼顧本地AI開發、內容創作和玩遊戲的使用者群體。如果只有單一需求,那麼其他針對特定用途的電腦或工作站可能性價比更高。
在跑AI任務方面,RTX Spark筆電顯然是跟M5 Pro版MacBook Pro對打了。對於喜歡用Windows系統的使用者來說,這會是個相當有戰鬥力的便攜Token生產機。
如果你是重度本地AI使用者,天天跟大模型、智能體、軟體開發打交道,那麼建議直接沖滿血128GB記憶體。我們實測下來感覺64GB還是受限,七七八八的軟體一開,留給本地模型的記憶體和容量就很吃緊。
現在本地模型的性能,相比雲端模型仍然不太能打,有時跑AI任務的速度慢到懷疑人生。不過近年來本地模型的智力增速非常驚人,相信未來將大有可為。
這樣一台“個人AI超算”,你會入手嗎?(芯東西)