
工業這盤棋,劉強東已經下了很多年。
京東和AMD,又做成一筆大單。
近日,上海工博會主論壇,京東工業與AMD簽署了一份戰略合作協議,雙方將聚焦“工業大模型+智算硬體”深度融合,面向工廠、車間等工業終端場景與邊緣計算環境,共同開發麵向工業現場的AI終端產品和應用。
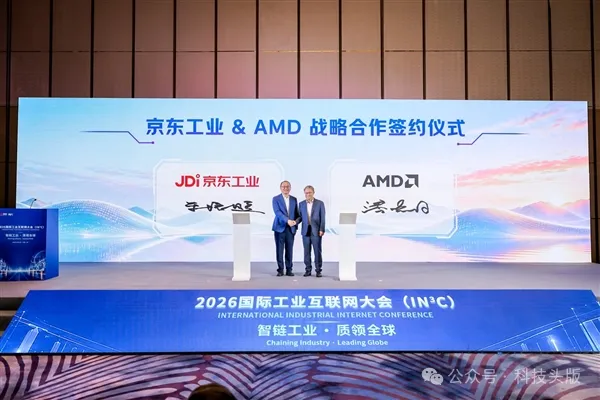
圖源:快科技
同一天,京東工業發佈了工業世界模型,完成了模型體系從認知工業供應鏈到連接物理世界的躍遷。
兩家公司上一次合作,還是在2024年,京東與AMD共同首發搭載銳龍AI處理器的筆記本。
短短兩年過去,雙方的合作已經從消費電子市場走向了工業生產線。而這個外界不太關注的領域,劉強東其實已經悄悄佈局了很多年。
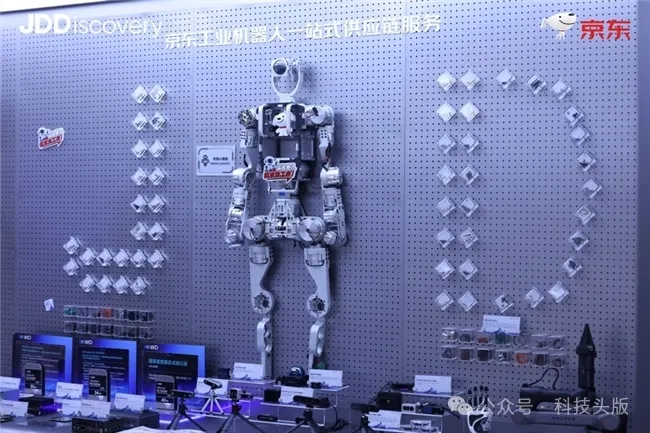
京東工業手裡有一張牌,是許多AI企業羨慕不來的。
根據此前披露的資料,京東工業連接著超過23萬家製造商、分銷商及代理商,服務的重點企業客戶約1.3萬家,業務還覆蓋大量中小企業。
這完全不是一個AI公司的使用者量級,而是一個工業供應鏈的入口量級。
當一家公司掌握了從採購、生產到物流的完整資料鏈路時,它對工業場景的理解,遠比任何一家純AI公司都要具體。
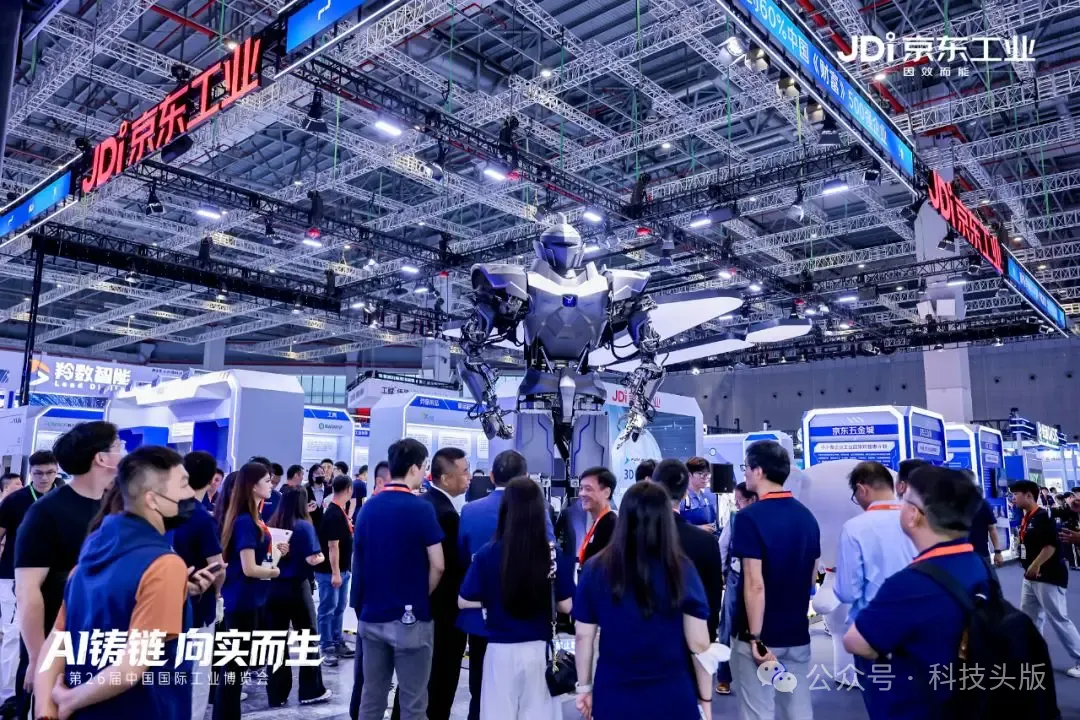
事實上,京東早在2018年就將工業品設為主站一級品類,此後逐步發展出獨立的工業供應鏈業務。
經過多年積累,京東工業已經建立起龐大的工業商品資料庫,並把採購管理、供應商協同和物流履約等環節連接起來。
2026年上半年,京東工業實現營收130.63億元,同比增長27.4%。
但劉強東顯然不滿足於讓京東只做工廠的採購平台。
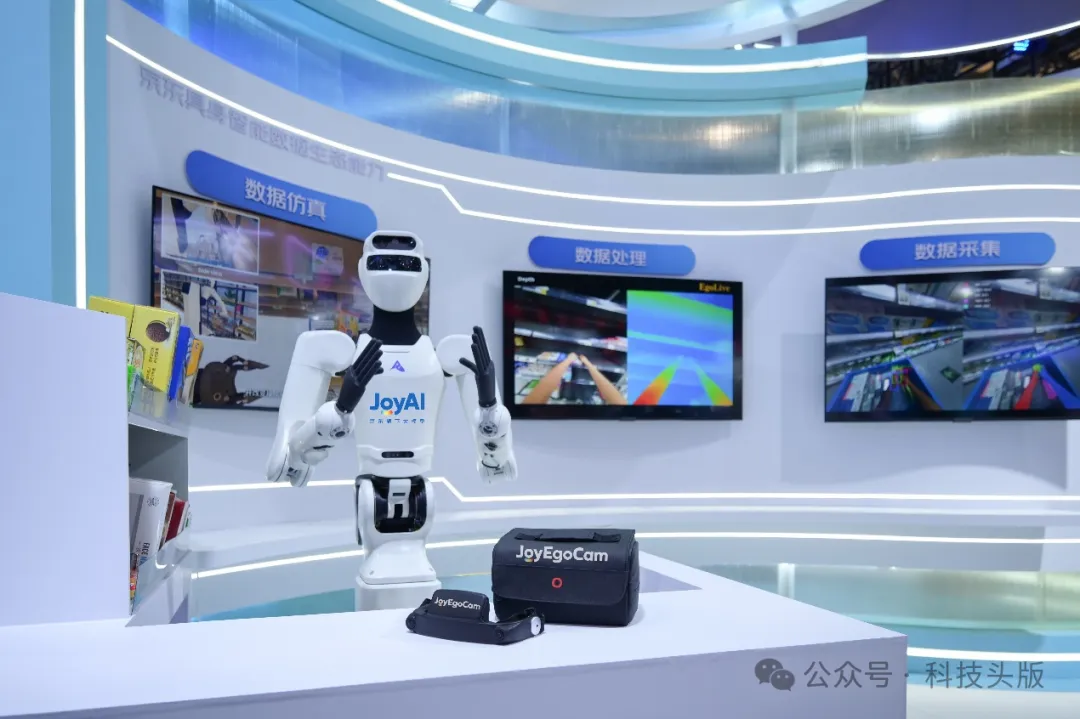
今年9月,京東工業發佈JoyIndustrial 2.0,試圖讓AI進一步參與工業企業的日常業務。它可以理解工業對象和業務狀態,根據需求規劃任務,再呼叫工具和企業系統執行操作。
比如工作人員拿著一台裝置的銘牌,AI可以幫助識別型號、匹配零件,進一步連接採購流程。
但當京東把目光從採購環節移向生產現場時,遇到的問題就完全不同了。
在採購系統裡,AI可以花幾秒鐘查詢庫存,甚至用更長時間完成複雜分析。但在高速運轉的生產線上,幾秒鐘可能足以決定一場事故能否避免。
而且,工廠對於生產資料通常相當敏感。裝置運行參數、工藝流程和產品良率都涉及企業的核心利益,並非所有資料都適合上傳雲端。
於是,京東工業需要一種新的計算方式,讓AI能夠直接在工廠現場運行。
AMD恰好提供了相關的硬體能力。
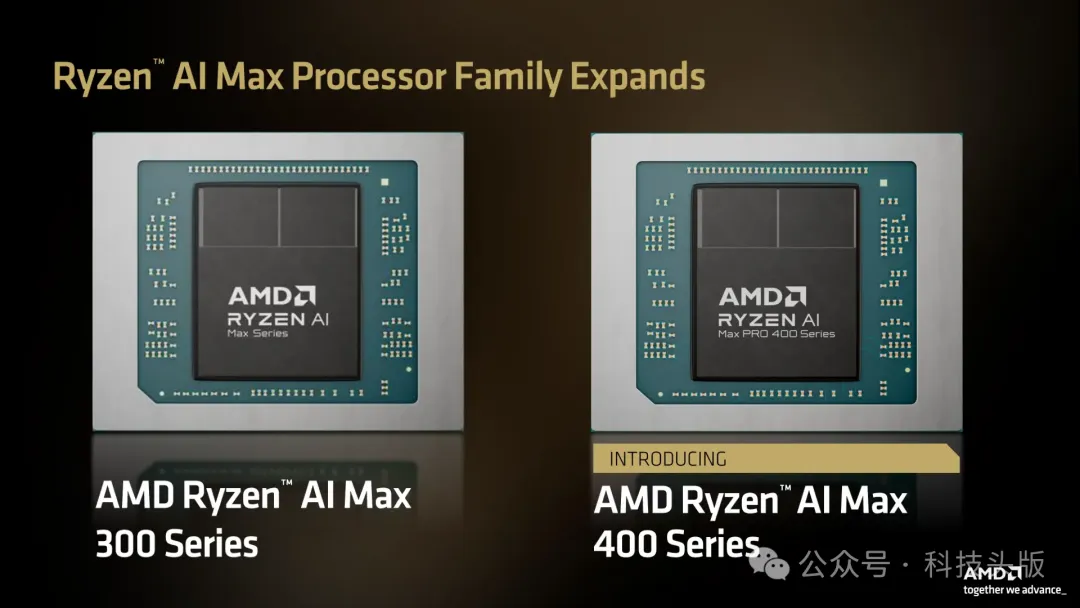
AMD的Ryzen AI Max系列處理器,是這次合作的技術底座。
以高配版本Ryzen AI Max+ 395為例,它將CPU、GPU和NPU整合在一顆處理器中,最高支援128GB統一記憶體,整體AI算力最高可達126 TOPS,其中NPU算力最高為50 TOPS。
126 TOPS是什麼概念?它足以在本地運行一個中等規模的視覺模型,完成即時圖像識別和風險判斷。不需要把資料傳到雲端,不需要等待網路響應,所有計算在裝置端完成。
京東工業的工業世界模型,未來就要跑在這類硬體上的軟體層。
根據官方介紹,該模型聚焦生產製造、裝置維運、物流流轉、質量檢測等場景,實現前瞻式決策。核心技術涵蓋模型訓練演算法及與AMD在計算層面的深度融合推理最佳化。
京東工業CEO王培暖在現場舉了一個具體的例子:在生產車間裡,人員可能進入車輛運行軌跡,帶來碰撞風險。
工業世界模型加上端側算力,能夠實現對人員、裝置的未來狀態進行推演,提前數秒判斷出碰撞風險,觸發報警或者讓車輛提前減速。
此外,Ryzen AI Max+395的可配置熱設計功耗範圍為45至120瓦,也為不同終端的性能和功耗設計提供了一定空間。
對工業現場來說,這一點很重要。
以前,工廠想要部署較複雜的AI模型,可能需要配備專門的計算伺服器。現在,隨著端側處理器性能提升,部分AI任務有機會直接放在現場終端完成。
當然,AMD同樣需要京東。
今年以來,AMD持續加強邊緣AI佈局,1月發佈了Ryzen AI Embedded系列處理器,3月又擴展了面向工業自動化和機器人等場景的產品陣容。
晶片已經準備好了,如何讓更多工業客戶真正用起來,卻不是只靠硬體性能就能解決的。
工廠採購裝置,關注的不只是處理器速度,還要考慮能否接入現有生產系統,出了問題誰來維護,以及投入後究竟能帶來多少收益。
京東工業擁有現成的客戶網路,又在工業場景中積累了多年經驗,自然成為AMD值得爭取的合作夥伴。
按照協議,雙方未來還將利用京東工業的銷售管道,向更多國際企業和出海中資企業推廣相關產品。
京東需要算力和硬體生態,AMD需要場景與客戶入口。兩家公司坐到一起,倒也不難理解。
這次合作的方向是對的,但落地難度被有意無意地淡化了。
工業邊緣計算首先要面對的就是環境問題。工廠車間不是資料中心,溫度波動、粉塵、震動、電磁干擾,每一項都可能讓一台在實驗室裡運行良好的裝置出現故障。
AMD的Ryzen AI Max系列在功耗和算力之間找到了不錯的平衡,為端側部署提供了硬體基礎,但“能不能跑”和“能不能穩定跑三年”,完全是兩回事。
另一方面,資料是繞不開的難題。京東工業的工業世界模型需要大量產線運行資料進行訓練和調優,但工業資料的獲取遠比消費資料困難。
工廠對生產資料的敏感程度極高,產線節拍、良率參數、裝置狀態,都是企業的核心資產。京東工業能拿到多少資料、通過什麼方式獲取,以及如何在保障客戶資料安全的前提下使用,目前都沒有更詳細的公開資訊。
而比獲取資料更難的,是讓模型真正理解物理世界。
京東工業此前的模型體系主要圍繞供應鏈場景迭代,從JoyIndustrial到JoyIndustrial 2.0,積累的是對工業商品、業務流程和供應鏈關係的理解。
現在要解決的問題變成了產線上的人怎麼走、裝置怎麼動,以及不同物體之間會產生什麼影響。
這與分析採購訂單或匹配零部件完全不同。
供應鏈業務有相對明確的規則和流程,物理世界卻始終處於連續變化之中。此前積累的工業知識當然有價值,但要讓AI精準預測真實環境中的變化,還需要大量新的資料和技術驗證。
還有一個更隱蔽的挑戰——AMD在中國工業市場的根基。
根據IDC資料,2026年上半年中國資料中心AI加速器市場中,AMD的份額僅為2.3%。它的優勢在消費級CPU和GPU,在工業邊緣計算這個品類裡,AMD需要從零建立管道、服務和生態。
京東工業能幫它打開入口,但打開之後能不能守住,更取決於產品本身在車間裡的表現。
從商業角度看,京東工業與AMD的合作頗有一種“場景換算力”的意味。雙方各取所需,邏輯自洽。
但工業AI的落地,從來不是簽一份協議就能解決的問題。車間不是實驗室,產線不是演示場。
一台裝置在工博會現場跑通一個demo,和在客戶的生產線上連續運行一年不出故障,中間隔著的是無數個需要逐一解決的工程細節。
劉強東拉來AMD,確實為京東工業打開了新的機會。但想把算力真正塞進車間,還得要等京東工業的世界模型在真實產線裡跑過第一個冬天。 (科技頭版)