
740億參數的AI,瘦到22.1GB,直接塞進筆記本!
就在剛剛,輝達開放了Nemotron 3.5 Bolt的模型權重。原本約148GB,一口氣砍掉約85%,瞄準24GB級本地部署。
看圖、寫程式碼、呼叫工具,這回筆記本也能接活了。
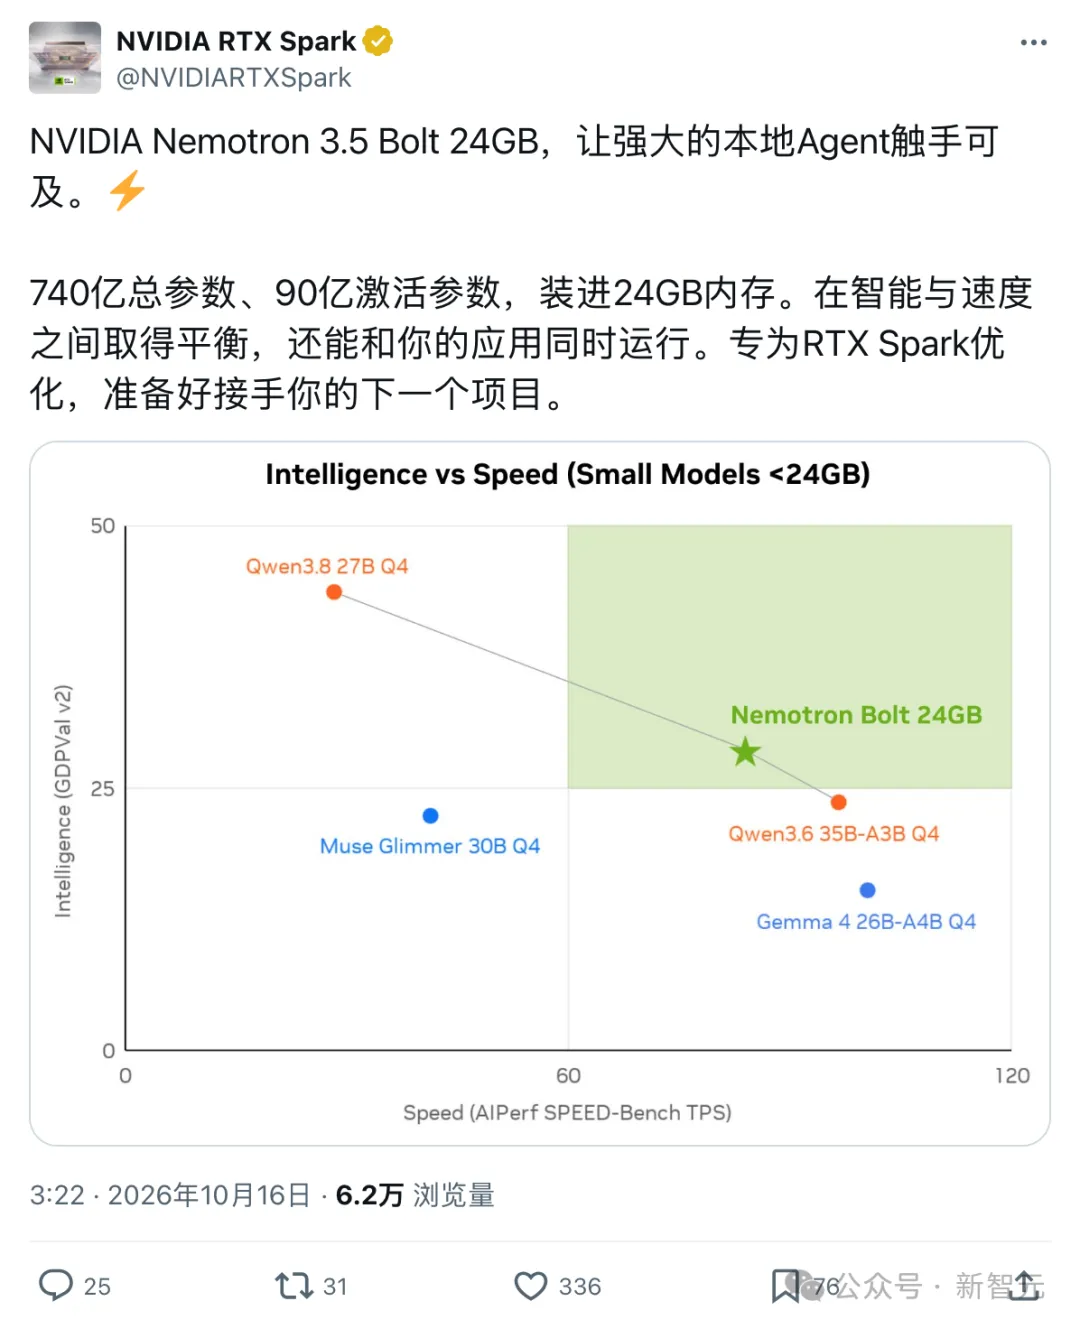
Ollama已經給出了接入OpenClaw的入口。Agent在本機讀檔案、改程式碼,負責推理的大模型也可以在本機運行,少了一趟趟往雲端跑。
模型放出來,電腦也開賣。10月16日,搭載RTX Spark的筆記本全球發售,聯想、微軟等廠商的新機正式登場。
大模型和新電腦,老黃一起端上來了。
01. 龍蝦大腦搬家!筆記本直接接活
一句「幫我改下程式碼」,到了Agent那兒,往往得忙活好幾輪。先讀檔案、找位置,再動手改,運行報錯了,還得回頭重來。
每走一步,背後的模型都可能要再想一輪。如果推理全在雲端,這些請求就得來回跑。
Bolt想接下的,就是這些可以留在電腦上的日常活。
它每次生成token啟動約90億參數,但740億參數的家底都在。工具呼叫、圖片和視訊輸入也都支援,程式碼和圖表都能交給它讀。
訓練時,團隊就讓它進入模擬環境練習工具操作,學習少繞彎、少做無用功。Agent少走一次彎路,螢幕前的人就少等一輪。
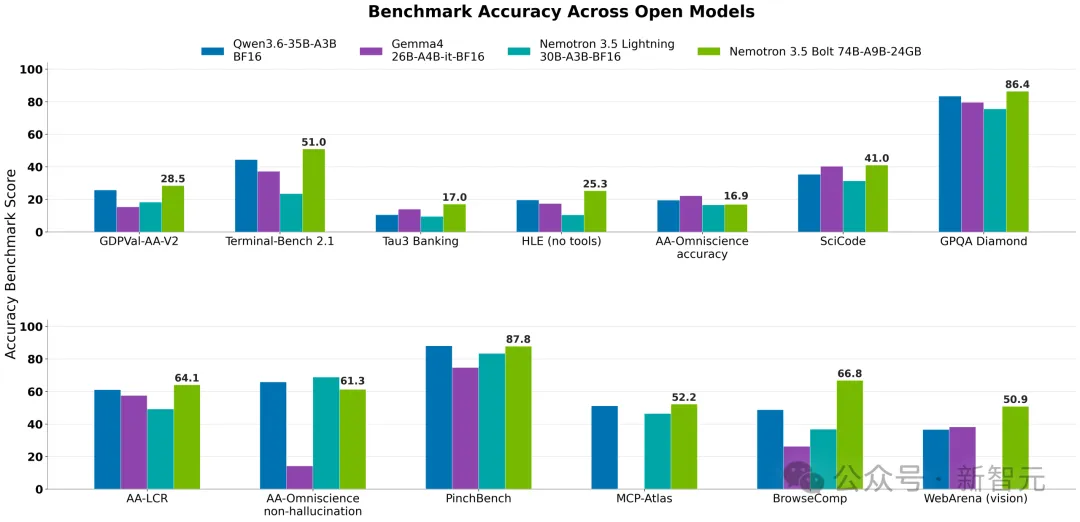
最終量化版Bolt,在考終端操作的Terminal-Bench 2.1拿到50.98%,在考上網找資訊的BrowseComp拿到66.75%。這兩門,都是Agent接活時繞不開的功課。
Ollama已經列出OpenClaw、Hermes等框架的啟動入口。開發者可以給熟悉的Agent換上本地模型,聯網搜尋照常聯網,推理則交給自己的電腦。
這樣,檔案、工具和負責推理的模型,就能在同一台電腦上碰頭。龍蝦在本地幹活,大腦也有了本地的住處。
02. 148GB壓成22.1GB!大模型暴瘦85%
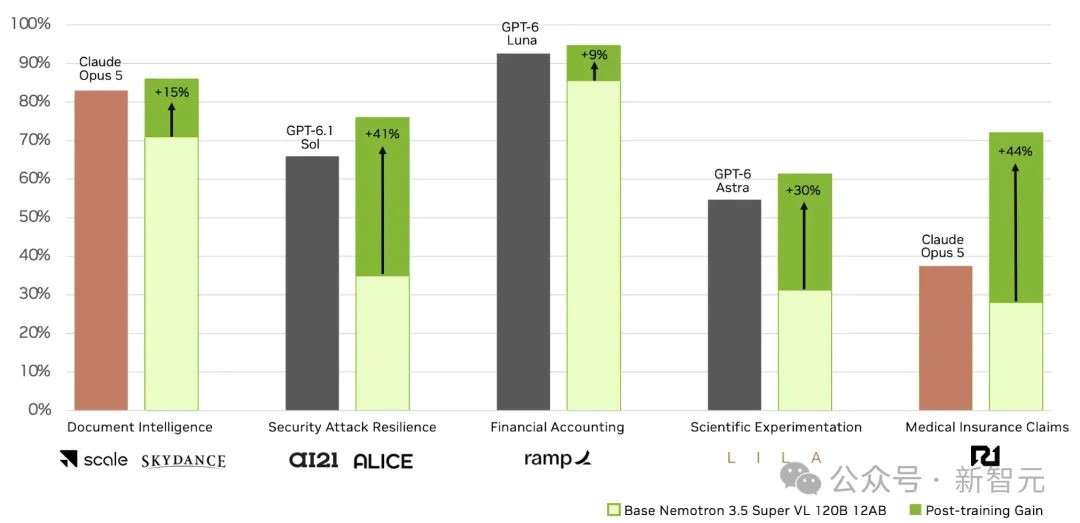
Bolt的底子,來自這次一起發佈的1200億參數Nemotron 3.5 Super VL。後者每次啟動120億參數,面向企業Agent,圖表、文件、視訊都能讀,看完還能呼叫工具接著幹。
企業還可以拿自家資料繼續訓練它。到了財務平台Ramp手裡,它就被派去認小票,把商戶、日期和付款資訊整理成程序能讀取的資料。報銷時那些磨人的抄抄填填,正好讓它接手。
輪到Bolt,團隊要讓這位「大哥」住進筆記本。先動模型結構,從1200億參數壓到740億,再把受損的能力練回來。
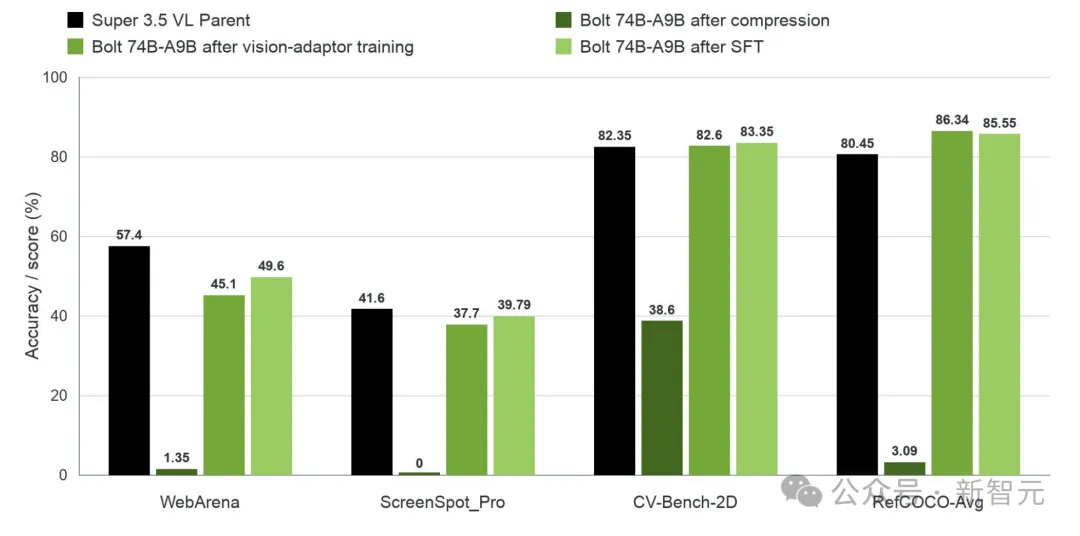
麻煩出在看螢幕上。前面的壓縮只動了語言部分,恢復訓練也先保文字能力;原來的視覺模組接回來,和這副縮小的底子還得重新磨合。
讓它按指令在螢幕上找目標,問題就暴露了:ScreenSpot Pro這項測試,父模型得分41.6%,剛壓縮完、還沒補視覺訓練的Bolt卻掉到了0。
於是,團隊先用每輪約660萬張圖像訓練視覺介面卡,再做視覺任務微調,把成績拉回39.79%。瘦身省下的空間,差點把「眼力」也一起省掉了。
眼力補回來了,體積還沒過關。740億參數按BF16精度保存,光權重就約148GB,連最高128GB統一記憶體的RTX Spark筆記本也裝不下。
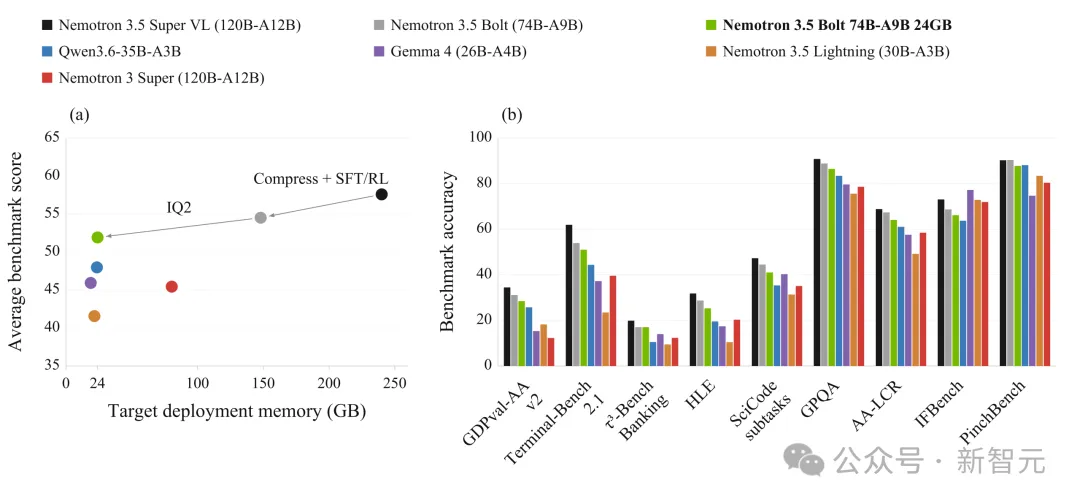
接下來,每個參數也得少佔點地方。佔大頭的專家權重被壓到約2bit,其他部分保留不同精度,再用「量化感知蒸餾」向教師模型補課,儘量追回精度損失。權重終於瘦到22.1GB。
這組實驗裡,同樣的記憶體預算下,先把大模型練好再瘦身,反而比從頭練小模型、再做4bit量化留下了更高的精準率。
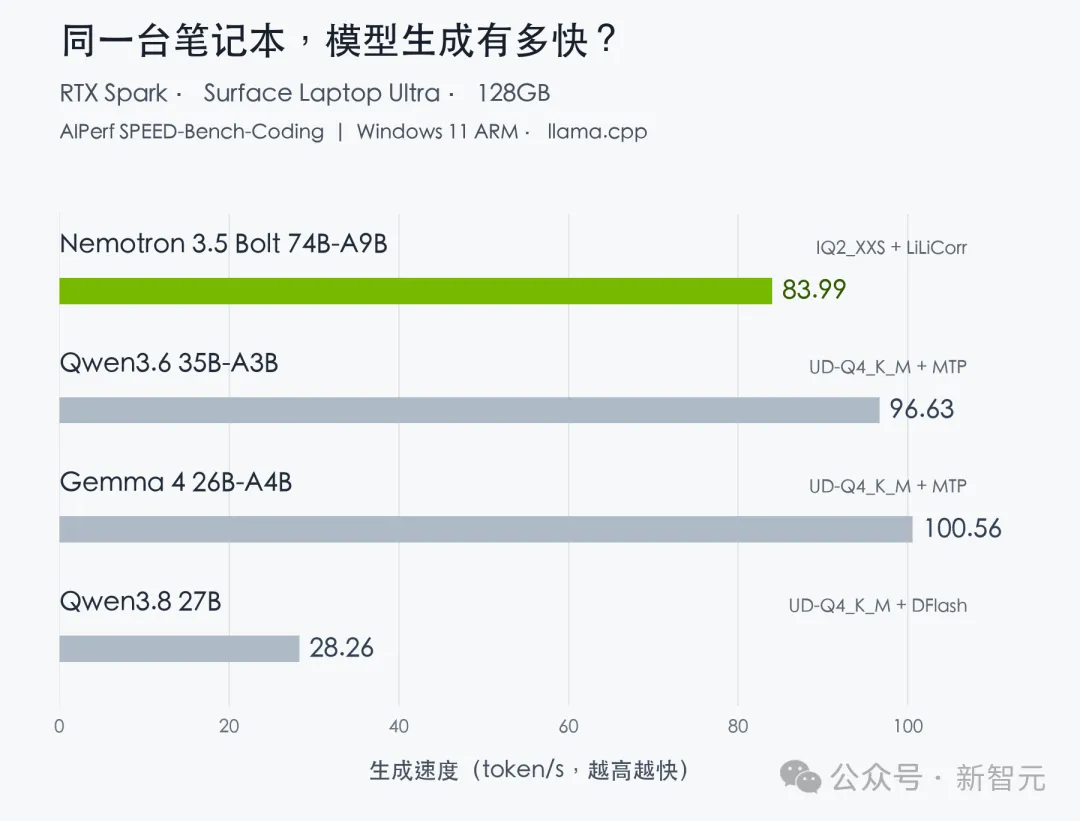
裝得下,還得跑得快。Bolt請來一個叫LiLiCorr的小模型先打草稿,主模型再成批驗收,減少逐個生成token的等待。
在輝達的程式碼生成測試中,搭載RTX Spark的128GB版Surface Laptop Ultra,讓Bolt跑到了約84token/s。
真正配電腦時,還要給快取、視覺模組和加速小模型留位置。按Unsloth的短上下文建議,32GB記憶體或統一記憶體可作為規劃起點,48至64GB更寬裕,22.1GB只是權重的帳單。
03. 128GB新本全球開賣,老黃軟硬一起上
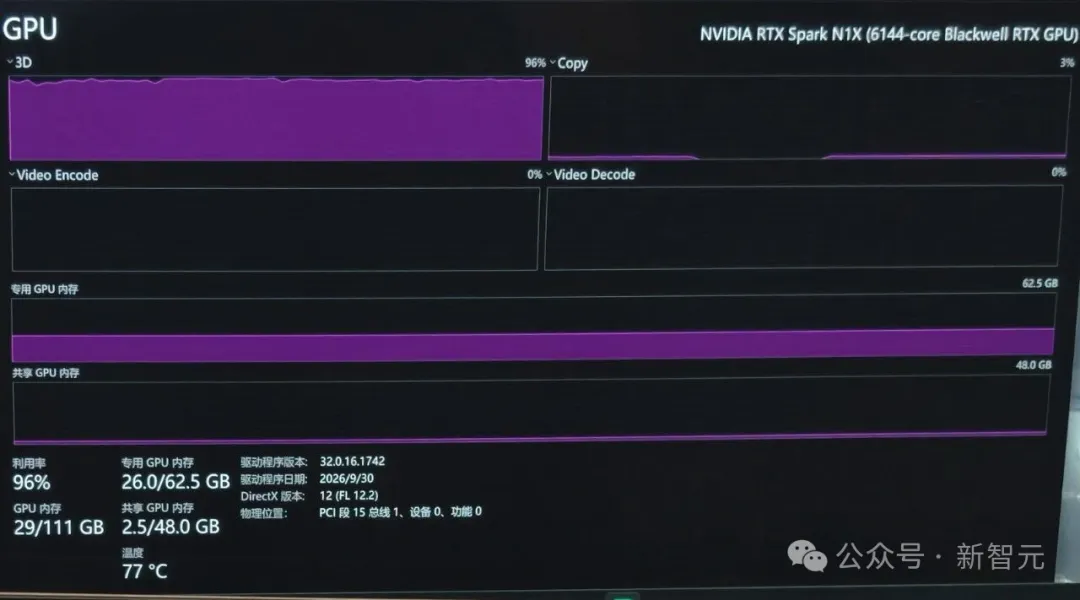
RTX Spark的電腦已經開賣,接下來就輪到這些模型上場。Blackwell RTX GPU和Grace CPU整合在一顆超級晶片裡,CPU與GPU共用最高128GB統一記憶體。
模型拚命瘦身,電腦這邊也得騰地方。兩邊一起往前推,本地Agent才更容易跑起來。
Artificial Analysis拿了一份更大的模型來試這道門檻。Ling 3.0 Flash量化後,光權重就有77GB。
測試中的64GB MacBook Pro和32GB視訊記憶體RTX 5090都裝不下,128GB的RTX Spark筆記本還能繼續跑。
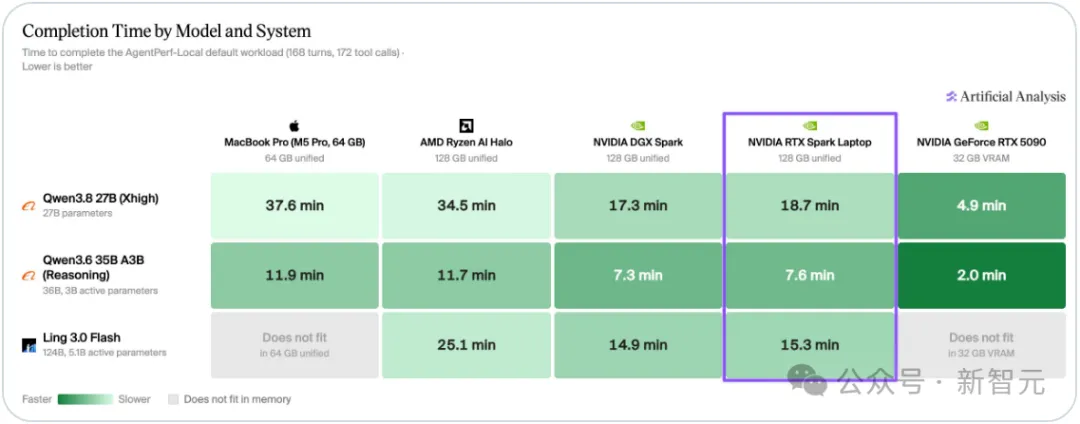
旗艦顯示卡也會遇到這種尷尬:算得再快,模型太大,照樣進不了門。到了本地AI這裡,挑電腦還得看看它的「肚量」。
輝達也把OpenClaw和Hermes列進了發售時的應用生態,並提供引導安裝。想讓更多人養上龍蝦,第一關總不能先考環境配置。
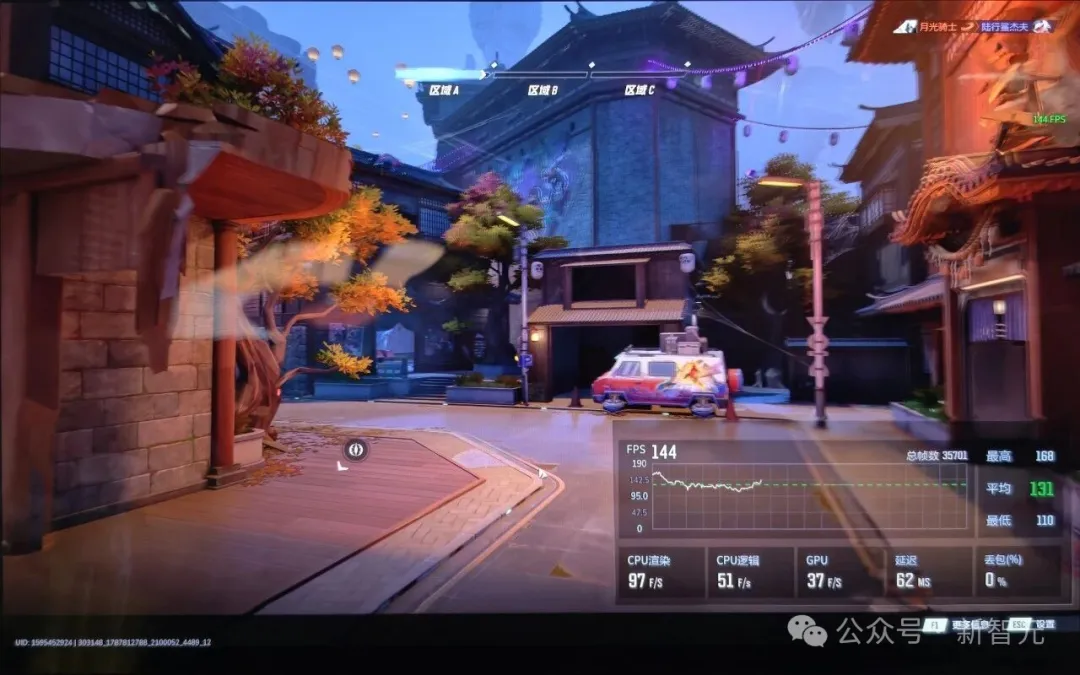
養龍蝦之餘,這台電腦也得照顧原來的活。RTX Spark首發支援數百款遊戲,Photoshop和Premiere的原生支援也通過首發測試版提供,處理完AI任務,還能接著剪片、玩遊戲。
連740億參數都嫌大,還有更小的一檔。Nemotron 3.5 Bolt E4B 4GB計畫10月23日推出,面向本地語音助手、互動角色等場景。
Super VL接企業裡的複雜活,Bolt把日常Agent任務搬進筆記本,E4B再去照顧更輕巧的裝置。這一家子,分頭上班。
老黃的算盤也很清楚:開放模型,讓更多AI任務用上使用者手邊的GPU;新電腦開賣,再把這份需求接過來。
買了這麼多年「生產力工具」,打工人的願望也可以大膽一點了:
「電腦,你先忙,我下班了。」 (新智元)