
打開任何一張現代AI晶片的晶圓照片,佔面積最大的往往不是計算核心,而是記憶體顆粒。這個現象背後是一個沿用七十多年的架構困境:計算和記憶體分居兩地,每次運算都要把資料搬來搬去。到了7nm工藝時代,資料搬運消耗的功耗佔總功耗的比例達到63.7%(業內常引的英特爾研究口徑)。
圖靈獎得主約翰·軒尼詩對此的判斷很直接:AI計算的重心,正在從"算"轉向"搬"。
2026年7月,上海一家公司用14nm製程,通過3D堆疊把計算和記憶體疊在一起,跑出了 520 TFLOPS 的算力,訪存頻寬達到 6.4TB/s。記憶體正在從被動的"倉庫",變成主動的"計算參與者"。
但三條技術路線的成熟度差異巨大。那條先落地,取決於良率、生態和成本,而非技術指標的絕對值。
一、記憶體牆危機:為什麼記憶體必須開始"參與計算"?
馮·諾依曼架構的物理極限
處理器性能以每年約 55% 的速度提升,而記憶體性能每年只提升約 7%(Hennessy & Patterson)。二十多年下來,兩者之間的速度差距已經拉開數個數量級。這個剪刀差,就是"記憶體牆"。
資料搬運的代價越來越高。據英特爾的一項研究(業內廣泛引用),當半導體工藝達到7nm時,資料搬運功耗高達 35pJ/bit,佔總功耗的 63.7%。搬運資料,比計算資料更貴。
更直觀的證據在成本結構裡。據Epoch AI測算,截至2025年第四季度,HBM已佔AI晶片元件成本(BOM)的 63%,而邏輯晶片約13%、先進封裝約15%。一顆晶片裡最貴的部分,是負責"搬資料"的記憶體。
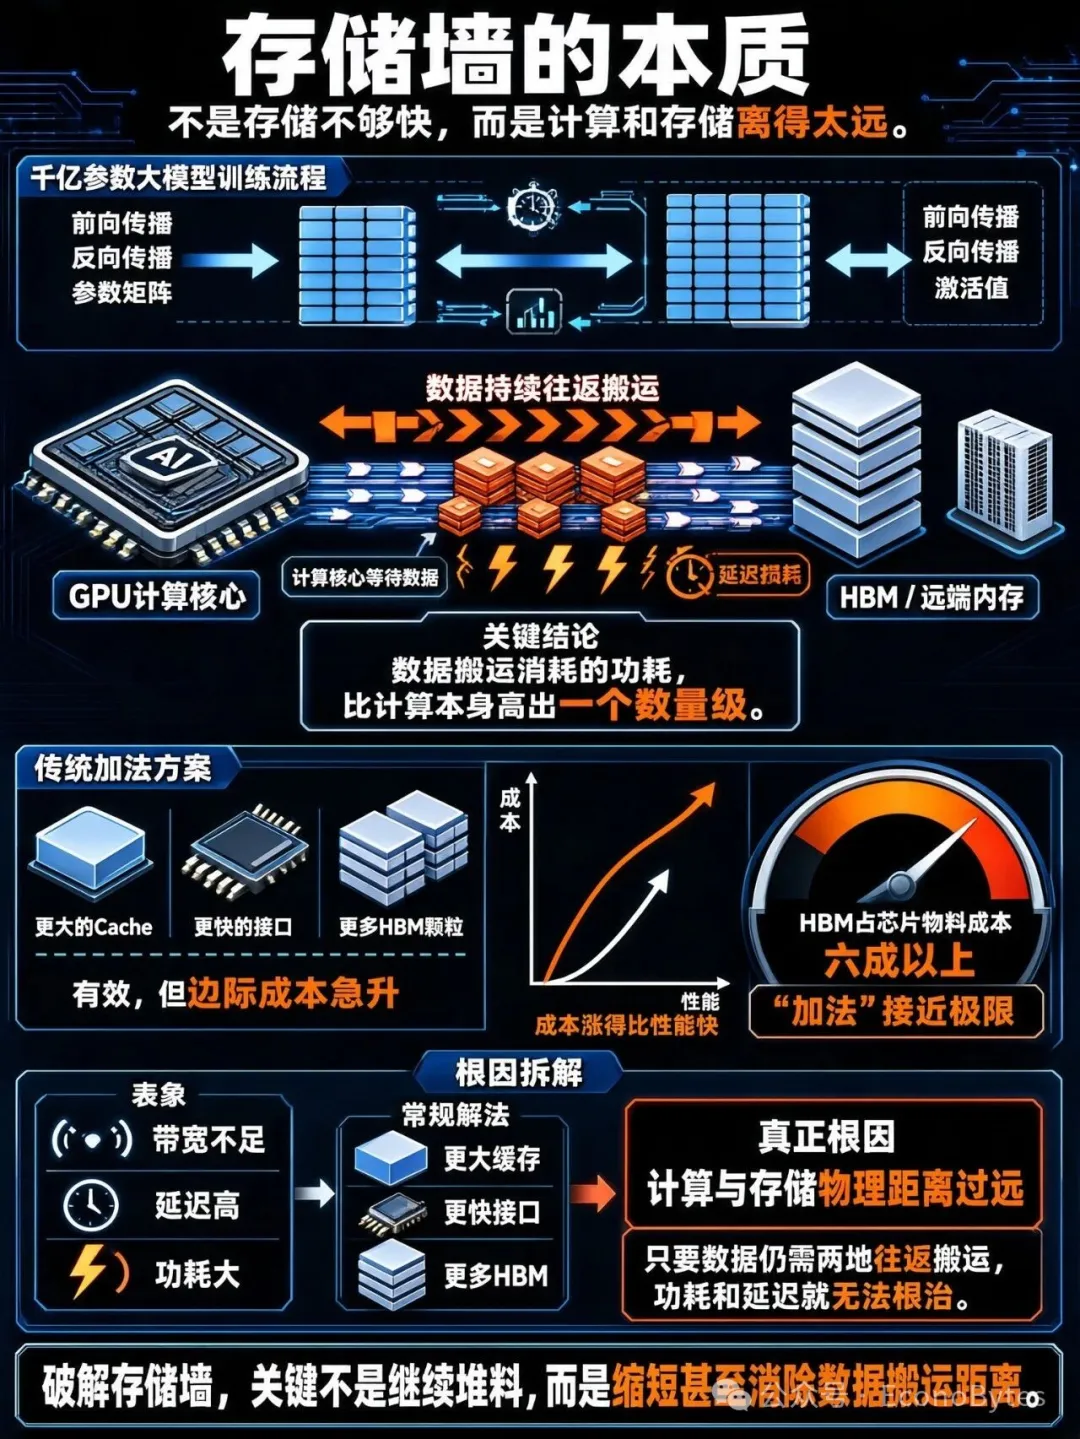
記憶體牆的本質
訓練一個千億參數大模型,每一次前向反向傳播都要從遠端記憶體把參數、啟動值搬到計算核心,算完再送回去。這個過程消耗的功耗,比計算本身高出一個數量級。
堆更大的cache、換更快的介面、堆更多的HBM顆粒——這些辦法有用,但成本漲得比性能還快。當HBM佔到晶片物料成本的六成以上,加法就快做到頭了。
問題的根源不是"記憶體不夠快",而是"計算和記憶體離得太遠"。只要資料還需要在兩地之間來回搬運,功耗和延遲就無法根治。
存算一體的核心邏輯
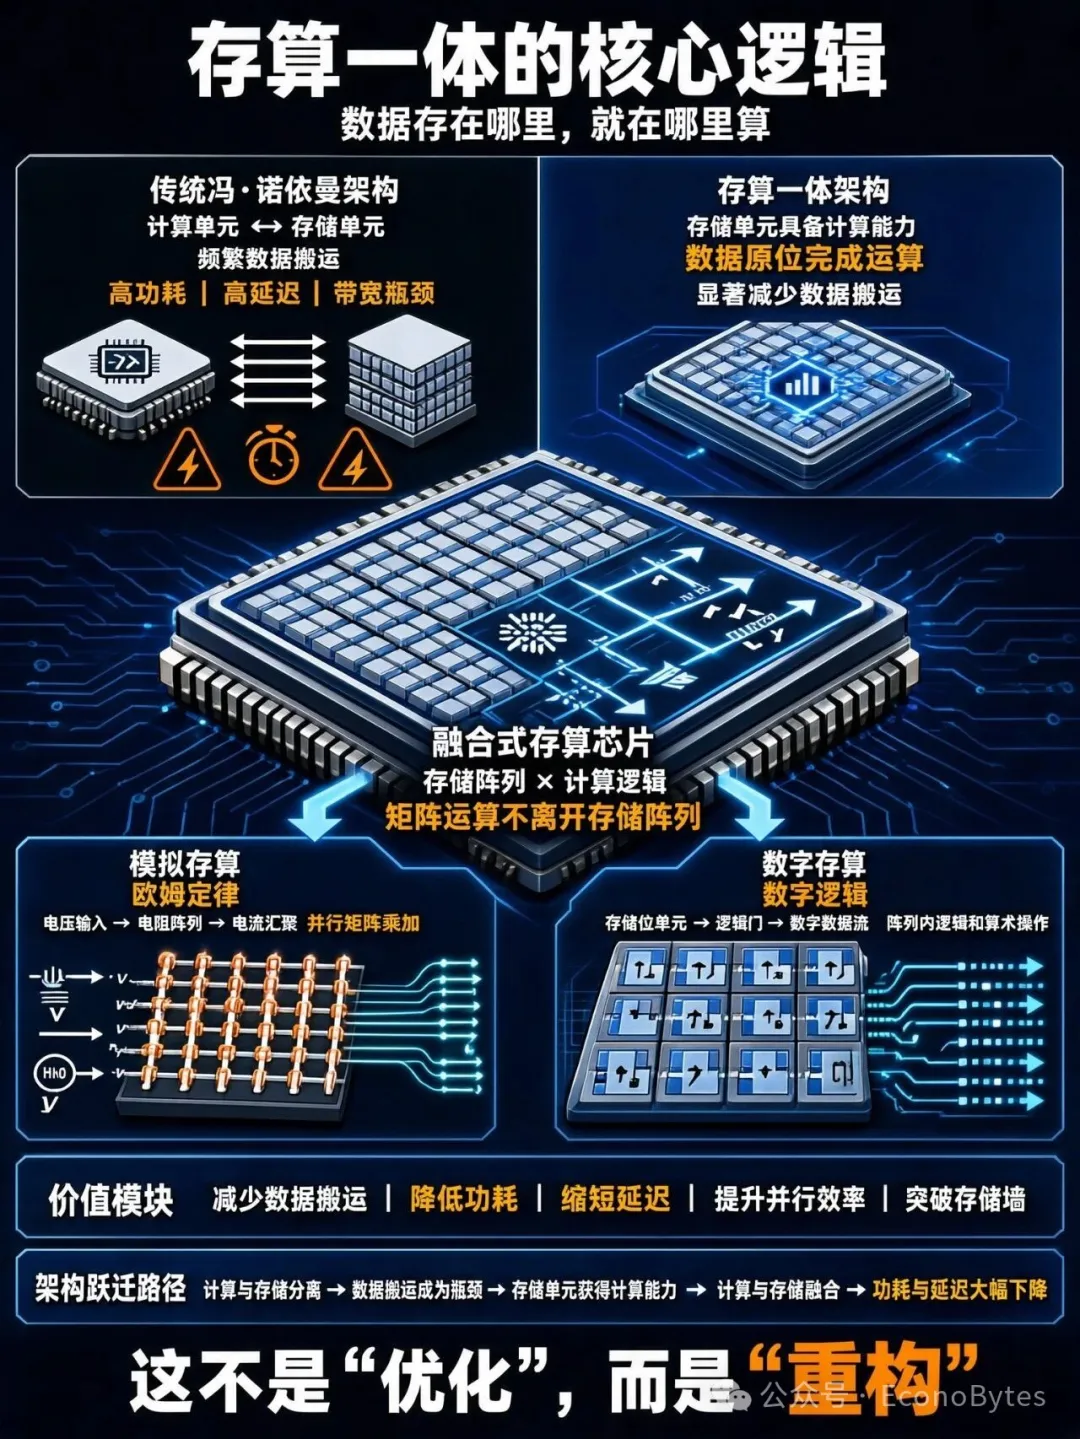
存算一體的思路,是讓記憶體單元本身具備計算能力,直接用物理特性做運算。模擬存算靠歐姆定律,數字存算直接把邏輯做進記憶體單元。
本質上是把計算和記憶體融合,重構架構——資料"存在那裡,就在那裡算",功耗和延遲自然大幅下降。這不是"最佳化",而是"重構"。
二、標誌性事件:東方算芯DF1000用14nm跑出大算力
2026年7月13日,上海東方算芯科技有限公司發佈全球首顆"軟體定義近存計算3D晶片"DF1000。
核心參數
晶片採用DRAM-Logic晶圓級混合鍵合3D垂直封裝,在國產 14nm 製程上實現 520 TFLOPS@BF16 算力,訪存頻寬高達 6.4TB/s,Scale-up互聯頻寬達 900GB/s。
硬體通過垂直堆疊算存層結構,把互連間距從數十微米壓縮到亞微米級。據東方算芯副總裁郭煒介紹,同容量下3D DRAM頻寬可達HBM的 5倍以上。
突破製程依賴的戰略意義
郭煒表示,DF1000以"軟體定義+3D堆疊近存計算"方式,破解了高端算力晶片發展面臨的三大核心瓶頸:突破製程依賴,走出供應鏈自主可控新路徑;打破記憶體牆壁壘,通過創新算存架構釋放算力效能;建構全端軟體生態。
"軟體定義晶片"的邏輯在於:通過軟體靈活調度硬體資源,實現任務空間平行和資源分時多工,把硬體利用率顯著拉高——從而降低對先進製程的依賴。同一塊14nm電路,今天跑A任務、明天跑B任務。
團隊背景與供應鏈
東方算芯植根於清華大學積體電路學院移動計算研究中心,在可重構計算領域擁有10餘年技術積累。董事長兼CEO魏少軍表示,公司已初步建構全國產化供應鏈支撐體系,實現關鍵環節自主可控。
DF1000從晶圓製造、封裝測試到配套伺服器和叢集系統,均採用國產供應鏈體系。發佈現場同步展示了OAM算力卡、一體機和128卡算力叢集。
行業意義
華泰證券在2026年7月的研報中指出:國產算力創新正從單點晶片向以"超節點"為代表的系統化升級,東方算芯推出的DF1000採取和現有AI晶片不同的技術路徑,廣受市場關注。
2026年7月17日,DF1000獲世界人工智慧大會(WAIC)SAIL獎"引領賽道"。
一個關鍵區分:近存,還是存內?
需要說清楚:DF1000是近存計算的代表,不是存內計算的突破。
近存計算(PNM)本質仍是馮·諾依曼架構的最佳化——它通過3D封裝把計算單元和記憶體單元拉近,縮短資料搬運路徑,但不改變記憶體與計算單元本身的設計。存內計算(CIM)則是讓同一器件同時具備記憶體和計算能力,是真正的架構重構。
這個區分很重要:兩者的技術難度、軟體棧和產業化節奏,完全不同。
三、三條路線與節奏:那條先落地?
判斷存算一體各路線誰先落地,核心標準不是"技術是否先進",而是"是否需要更換產線"和"生態是否相容"。
中泰證券將“存算一體”分為三個層次:近存計算(PNM)、存內處理(PIM)、存內計算(CIM)。層次不同,成熟度也完全不同。
路線一:數字存算——當下商用主線
近存計算是落地最快的一條路。HBM通過2.5D封裝+TSV+Microbump實現與GPU近存,雲端訓練卡已全部標配。WOW 3D堆疊DRAM通過3D封裝+混合鍵合實現計算與記憶體上下堆疊,紫光國芯2020年已量產其SeDRAM三維堆疊產品。華邦CUBE通過3D封裝+TSV+Microbump定位邊緣計算。
HBM內建PIM不用更換產線——這是它落地最快的核心原因。三星電子已完成HBM-PIM等技術驗證(PoC),正進入商業化產品階段;其LPDDR系列已針對智慧型手機和終端AI裝置完成最佳化,計畫2026年下半年提供工程樣品。SK海力士也在CES 2026上展示了基於PIM架構的AiMX加速卡。
早在2022年,三星就宣佈在HBM中引入PIM並搭載於AMD MI100 GPU加速卡後,性能提升一倍、能耗平均降低約50%。
NOR Flash存算——端側AI已規模量產。知存科技基於NOR Flash存算一體技術的WTM系列晶片,已應用於華為、小米等品牌的智能可穿戴裝置,用於離線語音喚醒、心率異常檢測等AI功能(出貨量口徑請見文末備註)。安克創新2026年4月發佈的神經網路存算一體AI音訊晶片Thus,同樣基於NOR Flash技術打造,由安克與知存科技聯合研發。
路線二:持久記憶體(SCM)——填補DRAM與NAND之間的空白
據The Business Research Company資料顯示,記憶體級記憶體市場預計從2025年的 53億美元 增長到2026年的 67.2億美元,復合年增長率高達 26.9%。增長來自資料中心工作負載增加、AI工作負載對低延遲記憶體的需求,以及與NVMe架構整合、混合記憶體分層的普及。
CXL正在復甦。微軟已在Azure M系列虛擬機器預覽中啟用CXL附加記憶體——這是業內首個宣佈的CXL記憶體雲部署。Meta則在2026年6月的ISCA大會上披露了自研的CXL 2.0記憶體擴展ASIC"Vistara",已規模化部署在數百萬台生產伺服器上,用於把退役伺服器的DDR4模組回收利用到DDR5平台。
路線三:模擬存算(ReRAM/MRAM/FeFET)——終極長期路線
能效的理論上限。模擬存算利用憶阻器等新型記憶體介質的物理特性,直接在模擬域計算。有研究顯示,基於ReRAM的存算宏在250MHz下實現了 3349.1 1b-TOPS/W 的能效(陽明交通大學論文)。
MRAM的商用進展。熵旋芯智創始人雷坤在2026算力中國AI與算力產業展覽會上表示:基於MRAM的存算一體架構,能耗比SRAM低近10倍,可使AI推理Token成本降低約10倍。三星的8奈米MRAM已於2026年進入量產(ISSCC 2026),按官方路線圖,5奈米目標定在2027年。
記憶體介質的核心挑戰。模擬存算面臨工藝成熟度和良率瓶頸。ReRAM和MRAM對工藝一致性、器件穩定性要求極高,目前仍處於小批次工程量產階段。
三路線成熟度對比
| 對比維度 | 數字存算 | 持久記憶體SCM | 模擬存算 |
|---|---|---|---|
| 成熟度 | |||
| 代表產品 | |||
| 落地場景 | |||
| 核心瓶頸 | |||
| 量產時間 |
一句話總結:近存計算不用換產線,所以最快;模擬存算需要全新工藝和生態,所以最慢。
四、落地優勢與產業訊號:LPU與CMX的啟示
兩條新訊號說明:記憶體正在從單點裝置,變成叢集級共享資源。
LPU近存計算——適配智能體低延時需求
東北證券《海外記憶體深度報告(二)》指出,LPU採用GPU+LPU混合架構:GPU負責預填充(Prefill)算力密集任務,LPU依託片上SRAM實現納秒級超低延遲解碼,規避HBM在即時互動中的性能衰減。
Groq公司的LPU是典型的近存計算方案——把SRAM切成小片,分佈式地放在計算單元附近,形成計算-記憶體的共生單元。東北證券將"LPU近存計算"列為記憶體創新的下一批方向。
CMX平台——從單點記憶體向簇級共享演進
輝達為Vera Rubin平台引入了上下文記憶記憶體平台CMX(官方全稱Context Memory Storage),在HBM和傳統後端網路記憶體之間建構了一個中間記憶體層(輝達稱之為"G3.5"層)。
底層是大量TLC快閃記憶體,通過BlueField-4 DPU連接到Rubin GPU叢集,通過Spectrum-X乙太網路即時處理KV快取。硬體規模上,單台2U CMX伺服器容納 600TB TLC快閃記憶體,四顆DPU各管理150TB上下文記憶體;多台組成部署叢集後,記憶體總容量可達 9.6PB。
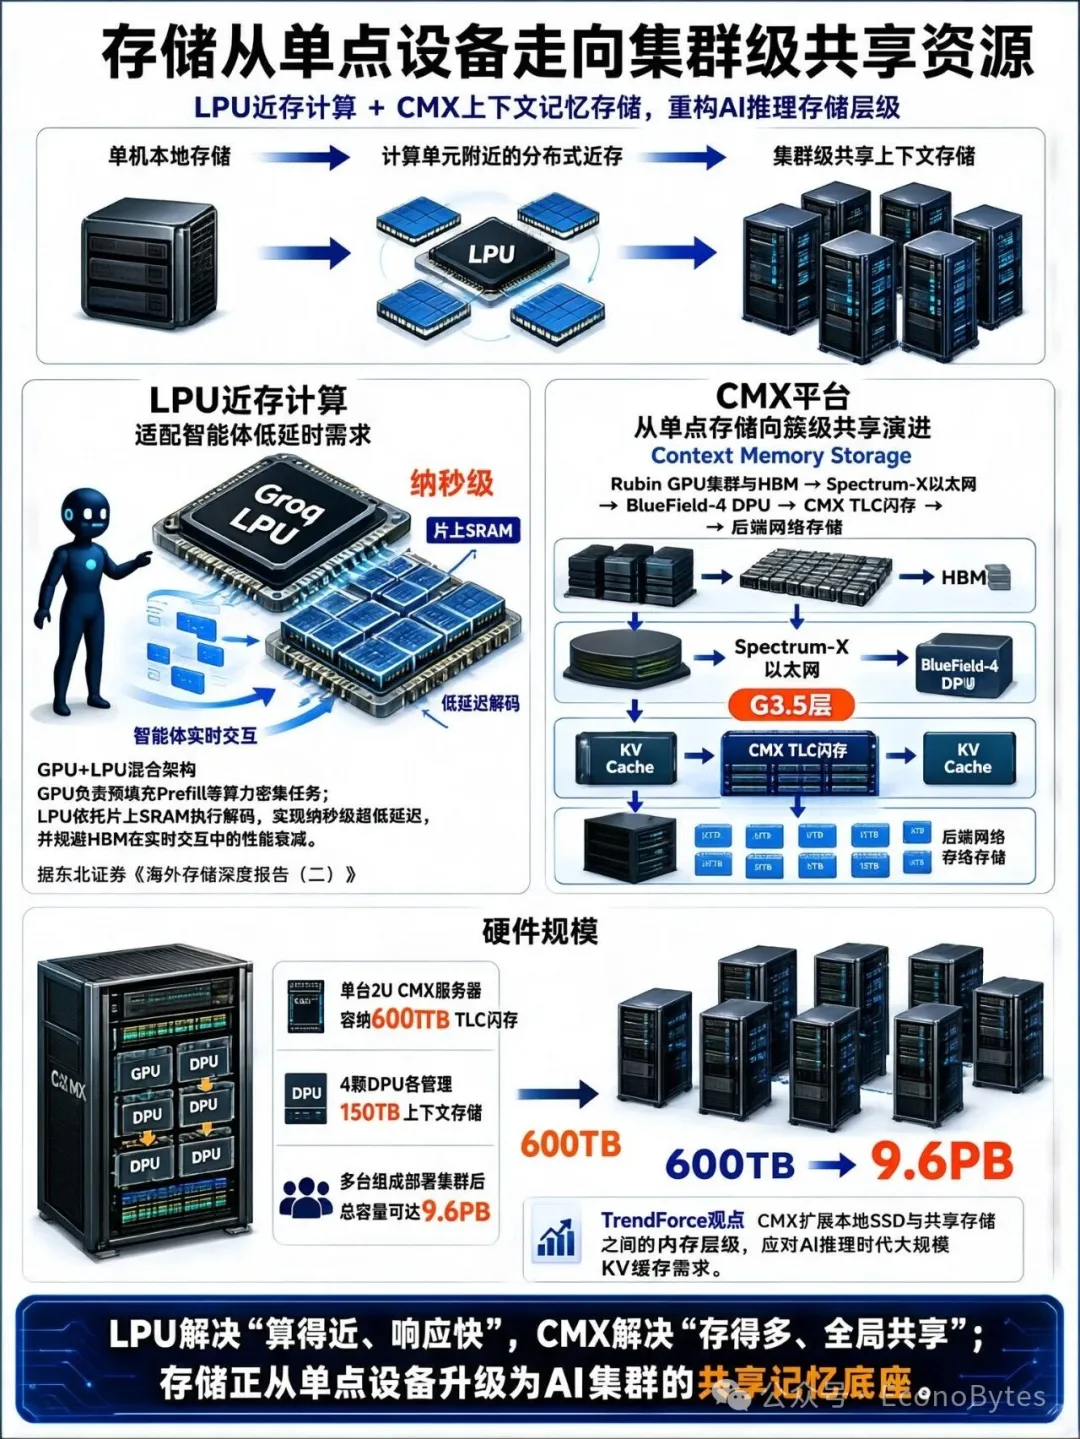
TrendForce指出,CMX擴展了本地SSD與共享記憶體之間的記憶體層級,以應對AI推理時代大規模的KV快取記憶體需求。
CMX和LPU的共同訊號是:記憶體不再只是"放在晶片旁邊的倉庫",而是開始參與計算調度和資料流轉的主動角色。
五、給晶片架構研究者和端側AI投資人的行動清單
(一)對晶片架構研究者:
第一,區分"近存計算"和"存內計算"的架構差異。近存計算本質仍是馮·諾依曼架構的最佳化,不改變記憶體和計算單元設計;存內計算是讓同一電晶體同時具備記憶體和計算能力,是真正的架構重構。兩者的軟體棧和設計方法論完全不同。
第二,關注混合鍵合技術作為存算一體的關鍵底層工藝。無論是近存的3D堆疊還是存內的介質整合,混合鍵合都是實現物理層融合的核心手段。
第三,模擬存算的良率攻堅是2027至2028年最值得跟蹤的技術方向,ReRAM和MRAM的工藝一致性決定了這條路線能否從實驗室走向量產。
(二)對端側AI投資人:
第一,數字存算的商用驗證已經完成——NOR Flash存算晶片已搭載於主流品牌可穿戴裝置並規模出貨,這是可以驗證的商業模式。
第二,關注PIM標準化的時間節點。三星和海力士正在推動LPDDR6-PIM標準化,標準一旦落定,移動端和AI推理場景的PIM晶片出貨可能進入加速期。
第三,SCM市場26.9%的年複合增長率值得關注,CXL記憶體池化和記憶體分層技術在資料中心AI推理場景中的落地速度,可能快於預期。 (EconoBytes)