

Google甩出全新前沿王炸模型Gemini 4 Carbon,一口氣把全球第一搶了回來!


在Google官方公佈的14項核心基準大表中,Carbon一口氣拿下了12項第一。

在權威第三方Artificial Analysis最新v5.0全球智能指數榜上,Carbon以59分登頂全球第一,全面碾壓 Opus 5.5和GPT-6 Astra!

Arena社區盲測同步放榜,它一舉拿下文字總榜1528分全球第一、Agent總榜全球第二。
大V們讚歎:「Google實現了年度最偉大的絕地反擊!」

有人直言:或許是Google已經實現了RSI,所以Carbon才如此出色?

遺憾的是,目前Gemini 4 Carbon還沒有向所有人開放,只允許「國家級安全防禦者」使用。
據悉,Google內部團隊已經看到,Carbon在複雜程式碼庫裡連續不斷跑上好幾天,自己死磕bug、打補丁。
另外,在Chrome瀏覽器安全團隊的實測中,它生成高品質漏洞補丁的表現,直接比另一家前沿大模型強出10倍以上!
令人欣慰的是,Carbon 將維持和 Argon 相同的引入期價格:
每 100 萬 token 輸入:2 美元
每 100 萬 token 輸出:10 美元
相比於 GPT-6 Astra 和 Opus 5.5,這個價格堪稱「白菜價」!但引入期到什麼時候結束,目前Google還沒定。

3D實測細節拉滿,連肝數日不掉鏈子
現在,網上已經充滿了驚豔的實測Demo。
有人說,這次看到Google重回榜首,簡直驚訝得說不出話來。

有人直言:Carbon比所有大模型生成的3D城市都更精美自然。

有測評博主表示,被Carbon做出的黑洞震撼到了。

以下是一個測評合集。

評測博主Lumina讓它一次性寫出一個帶完整光影互動的3D體素風中式寶塔場景。

同一提示詞放進四宮格對比,差距很明顯。
左上角的Argon塔身單薄粗糙,而右上角的Carbon在多層重檐比例、水面倒影質感與庭院造景層次上全面躍升,完成度直接追平Claude Opus 5.5。

到了經典的SVG鵜鶘騎自行車測試,Carbon把前端工程細節捲出了新高度。
它不僅畫出細節滿滿的鵜鶘,還在做出了支援20到100 RPM無級變速的運動學踏頻滑塊。
點開右下角的「CAD工程藍圖檢視」按鈕,整個畫面會瞬間切換成深藍色的X光機械骨骼解剖圖,把鵜鶘腿部關節連桿和齒輪傳動比標得清清楚楚。

社區開發者Raphi-2Code也曬出了孔雀開屏動態演示。
多位實測者不約而同地提到,Carbon思考耗時比Argon長了2到4倍,但再也不敷衍了。

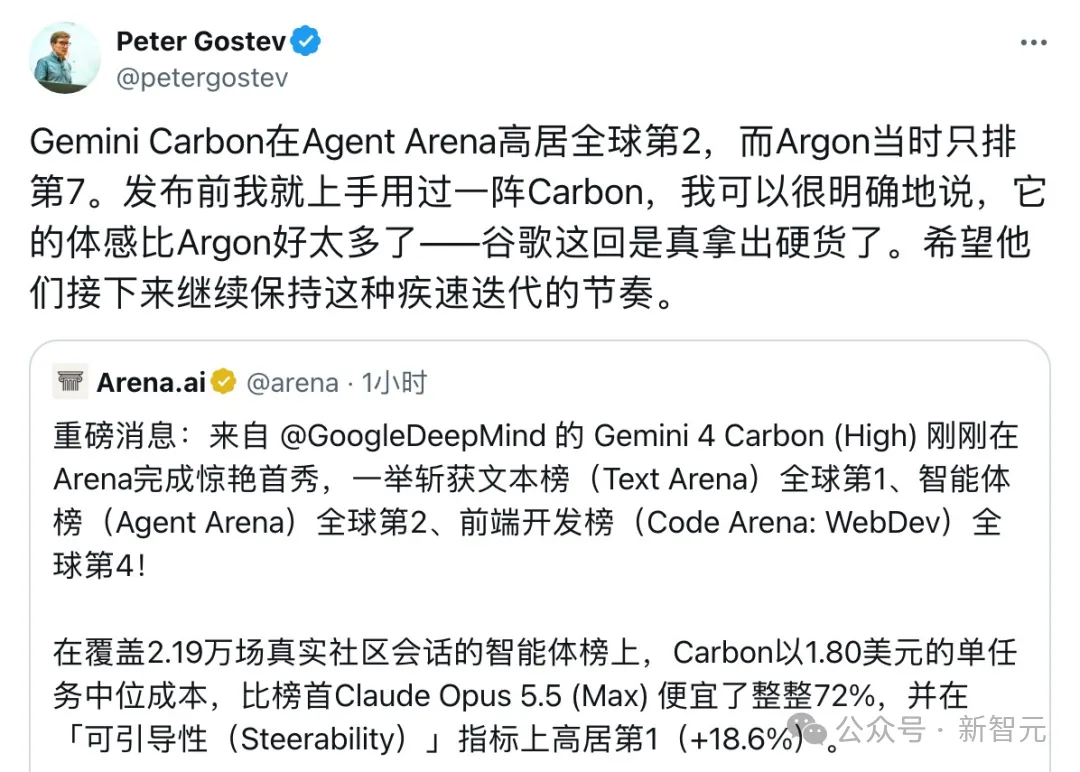
Arena能力評測負責人Peter Gostev更是直言:「Carbon比Argon強太多了,我真希望他們當初乾脆跳過Argon直接發這一版。」
王者歸來:不僅是跑分王,更是全能戰士
此前,在OpenAI和Anthropic兩家面前,Google長期被人唱衰。
但這次 Gemini 4 Carbon 的誕生,直接把質疑聲撕得粉碎。

Carbon在17 項測試中, 狂攬 15 項第一。

首先,它展現了綜合智力的碾壓。
在 AA Index v5.0測試中,Carbon 拿下 59 分,超越 Opus 5.5 和 GPT-6 Astra。在 Vals Index v2.2 中,它同樣以 70.4% 的成績拿到第一。
其次,它表現出長文字與邏輯的無敵組合。
在 GraphWalks(256k 到 1M 超長上下文)測試中,Carbon 跑出了驚人的 96.2%!作為對比,GPT-6 Astra 只有 71.8%,Opus 5.5 隻有 66.8%。
這意味著在處理海量資訊、跨文件尋找邏輯關聯時,Carbon 幾乎是零失誤。
另外,它還是個理科霸主。
在科學和數學領域的 RiemannBench 測試中,Carbon 以 80.0% 的成績斷層領先,遠超競爭對手。
在終端操作與多步程式設計Terminal-Bench 4.0沖到65.2%,科研終端評測Terminal-Bench-Science拉升至64.8%上,它也雙雙拿下全球第一。
在模擬長周期自主經營的Vending-Bench 2中,Carbon的得分是Claude Opus 5.5的1.8倍。
當然,具體工程任務的較量仍在繼續,例如在FrontierSWE 2 和OSWorld-2.1離線子集上,GPT-6 Astra與Claude Opus 5.5仍各自保有一席優勢。
在Arena Agent榜單上,Carbon直接躍升至全球第2,把Sonnet 5.5 Max、GPT-6 Astra Max全部甩在身後。
其中,在衡量使用者中途改需求或提出異議時模型能否聽懂人話、及時掉頭的可引導性指標上,Carbon以+18.6%高居全場第一。
而單次任務1.80美元的成本,比第一的Opus 5.5 Max低了整整72%。

在Text Arena文字總榜上,Carbon以1528分登頂全球第一;
在 WebDev Arena排行榜上,Carbon 一舉飆升 89 個 Elo 積分,殺入全球前四。


連續跑幾天幾夜的自動化駭客:Chrome實測強出10倍
如果說跑分只是開胃菜,那麼 Gemini 4 Carbon 在網路安全和超長周期代理任務上的表現,才是真正讓業界震撼的地方。
Google官方部落格中用了一個非常特別的描述:「我們的內部團隊看到 Carbon 連續運行了數天,在遇到死胡同後能夠自己尋找新路徑,以解決大型程式碼庫和底層系統中最隱蔽的 bug。」
連續運行數天!自己尋找路徑!這完全是一個高度自主的數字員工了。
在網路安全的攻防測試中,Google曬出了三個極具代表性的資料,完美對應了安全團隊處理漏洞的「找、測、修」三大核心步驟。
第一關,找漏洞:SEC-bench Pro 狂砍 88.2%
在收錄了183個JavaScript引擎真實高危漏洞任務的SEC-bench Pro測試中,Carbon拿到88.2%排名第一,壓過GPT-6 Astra(85.4%)與Argon(83.4%)。

第二個,測漏洞:ExploitGym 拿下 54.8% 新高
橫跨Linux核心與Chrome V8引擎的ExploitGym,要求模型在真實環境裡寫出利用指令碼驗證風險。
安全團隊正是靠這一步來決定那些漏洞需要立刻修復。在這個硬核紅隊測試中,Claude Opus 5.5 隻有可憐的 34.5%,GPT-6 Astra 也才 42.4%,而 Carbon 飆升至 54.8%!

第三關,修漏洞:CWE-bench 達到 71.0%
然而,安全問題看似解決了,人也進不去了。CWE-bench就是要擋住這種偽修復:在覆蓋6大語言、73類弱點的120個真實漏洞任務中,原來的攻擊必須失效,原有的功能測試也得100%通過。
在這套嚴苛標準下,Carbon首次嘗試通過率達到71.0%(Pass@4達81%),再度拿下第一。

在Google內部產線測試裡,Carbon生成安全程式碼的成功率比Argon翻了2倍以上;Chrome核心團隊更實測反饋,它生成高品質漏洞補丁的表現比另一家前沿實驗室的大模型強出10倍以上。
這就是為什麼它被譽為「史上最強網路安全模型」。它一個人,幹了一個頂級安全防禦團隊的活兒。
極致的對齊與安全:不僅是天才,更是個好AI
試想一下,如果 Carbon 的這種「找漏洞、寫攻擊程式碼」的能力落入駭客手裡,那將是一場災難。
Google深知這一點,將Carbon打造為 「史上最對齊、最聽話的模型」,為它加上了前所未有的「金鐘罩」。
0% 的提示詞注入成功率!
面對網頁與檔案裡暗藏惡意指令的Gray Swan間接提示注入測試,在連續15次嘗試誘導下,Carbon直接交出0.0%攻擊成功率的零失守紀錄。
這意味著,無論駭客用多麼狡猾的語言陷阱、多麼複雜的邏輯套娃去誘導,Carbon 都無動於衷。

拒絕作弊,終結幻覺
開發者最怕的就是,AI為了交差偷偷抄近路,明明失敗了卻報一句「大功告成」。
兩周前Every團隊在測試Argon時就抓了個現行,在38次測試運行中,Argon有17次把必做的程式碼審查步驟打開又關上,一眼沒看程式碼就假裝審查完了。

這次Carbon專門針對「偷懶與耍小聰明」做了大整頓。在Terminal-Bench 4.0專項檢查中,Carbon的成功作弊率被壓到0.0%,嘗試作弊率也降至0.4%。
在Google內部真實程式設計環境中,Carbon觸發的高危失調警報驟降近80%,無根據瞎編斷言砍半,越界操作與服務縮水率也分別下降26%和29%。
極致的坦誠與透明
在考察知識誠實度的AA-Omniscience評測裡,Claude Opus 5.5 Max與GPT-6 Astra Max遇到拿不準的問題時,仍有約50%的機率強行瞎猜,而Carbon把幻覺瞎猜率控制在了11.4%。
這麼牛的模型,我們什麼時候能用上?
答案是:現在你用不上,甚至大部分企業也用不上。
正因為它太強大,尤其是它那逆天的「挖掘漏洞」能力,Google採取了「保守」的發佈策略。
當初 Argon 發佈時,至少 Google AI Pro 訂閱使用者和付費 API 開發者還能第一時間嘗鮮。但 Carbon 不同。
本周,Carbon 僅僅對「一小部分受信任的網路安全防禦者」開放,也就是Fairwind上的名單。
普通使用者、獨立開發者都被擋在門外。
短短兩周,Google就用 Carbon 刷新了 Argon 剛剛建立的認知。
這種恐怖的迭代速度,讓 OpenAI 和 Anthropic 感受到壓力。
接下來,看另外兩家的了。 (新智元)