
基於 KubeCon EU 2026「From Cloud Native to Agentic AI」主線復盤
過去兩年,行業幾乎把全部注意力都投向“大模型能力躍遷”和“Agent 應用爆發”——GPT 參數競賽、Claude 工具呼叫、MCP 協議橫空出世、Manus / AutoGPT 類產品刷屏,卻集體忽略了一個更底層、更致命的問題:企業級 Agent,到底跑在什麼上面?
答案令人不安:現階段絕大多數企業 Agent 直接被塞進為微服務設計的存量 K8s 叢集,或乾脆跑在裸金屬 + Python 處理程序裡。
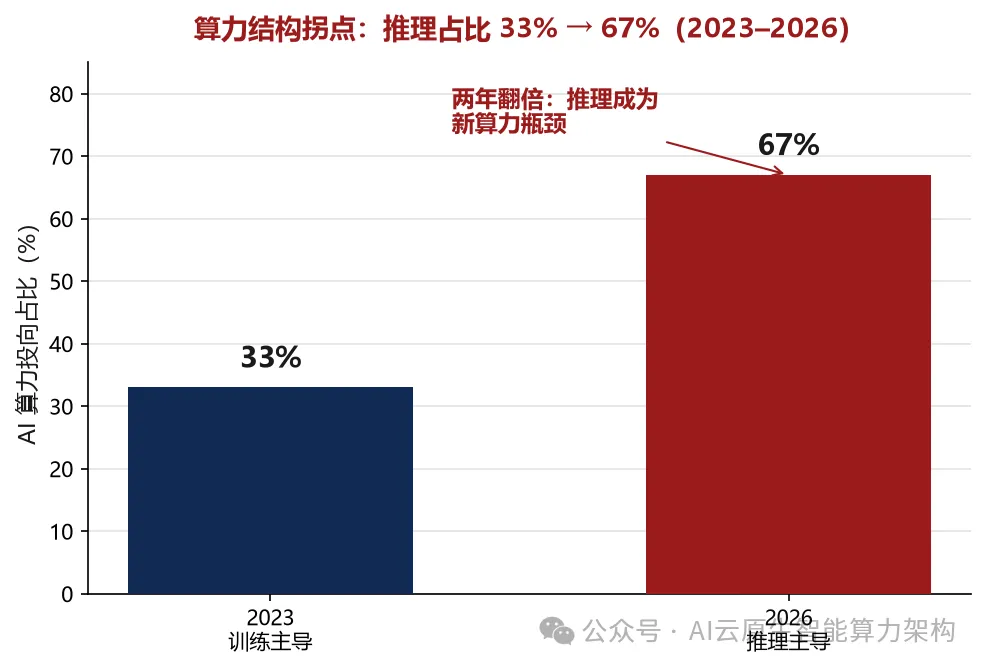
Linux Foundation 預測,2026 年 AI 算力投向中推理佔比將從 2023 年的 33% 躍升到 67%;CNCF 在 KubeCon EU 2026 主論壇上首次將 “Agentic AI Infrastructure” 寫入議程;Anthropic、OpenAI、Block 與所有超大規模雲廠聯合發起 Agentic AI Foundation(AAIF)——一切都指向同一個事實:Agent 不是應用,是全新算力運行範式,需要一套全新底座。
一、時代變革:從雲原生 1.0 到 Agentic AI 2.0
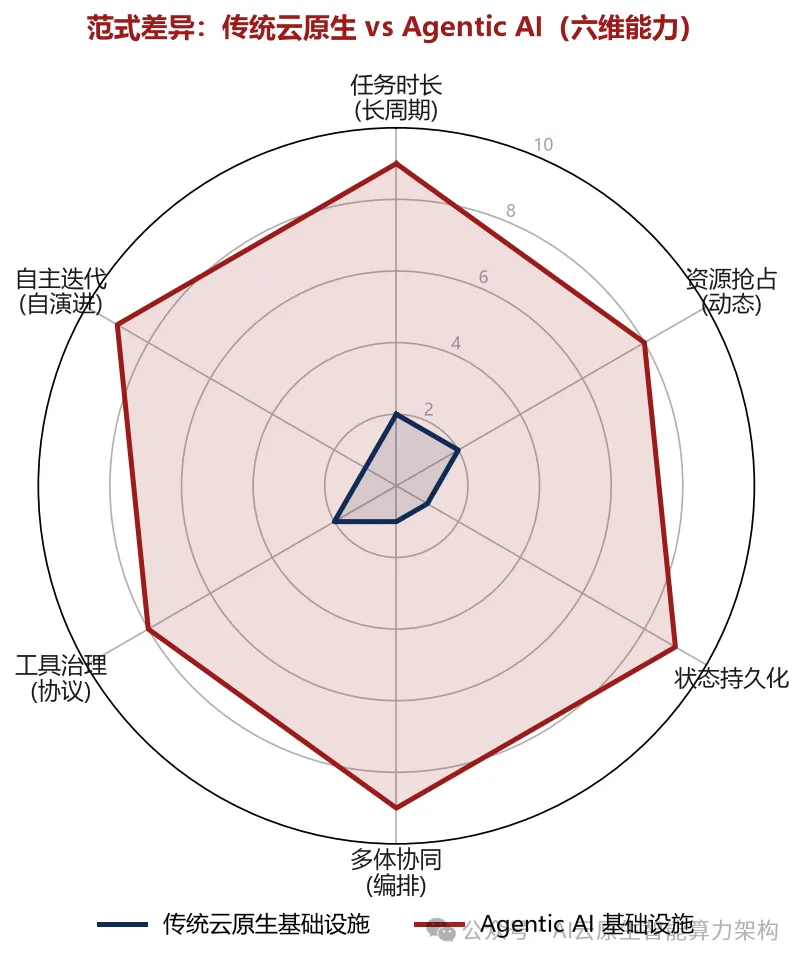
過去十年,雲原生 1.0 的成功建立在一組高度收斂的設計目標之上。K8s 的整個抽象體系,本質是為“無狀態微服務”這一類業務量身打造的:Pod 是處理程序級隔離、Deployment 是聲明式副本、Service 是 L4 負載平衡、Ingress 是 L7 入口——所有 API 都在回答同一個問題:如何讓一組短生命周期、無狀態、被動響應請求的處理程序,被穩定、可彈性、可觀測地調度到一台 Linux 上。
這是一組被極致最佳化過的工程目標。它在 Web、電商、SaaS、API 閘道器等場景幾乎無往不利。但當我們把視角切換到企業級 Agent 業務,會發現兩者的運行範式存在底層維度的不相容:
| 小時級 / 天級 / 周級長任務 | ||
| 主動規劃、自主決策、循環迭代 | ||
| GPU / 視訊記憶體 / KV Cache 動態搶佔 | ||
| 多智能體動態組隊、並行、接力 | ||
| 長上下文、記憶、Checkpoint、KV Cache | ||
| 執行階段工具發現 + 非人類身份治理 | ||
| 上下文溢出、推理死循環、狀態污染 | ||
| Token 速率 / 循環耗盡 / 工具錯誤率 |
KubeCon EU 2026 上,CNCF CTO Chris Aniszczyk 把這種範式躍遷講得非常直白:過去十年我們幫 Uber、Booking.com、航空公司在 Web-scale 分佈式系統上拿到極致彈性;下一個十年的主戰場,是把大規模 AI 推理和 Agent 在 Kubernetes 上跑穩、跑省、跑安全。Google Keynote 甚至把 K8s 重新定義為 “autonomous infrastructure 的神經系統”——這意味著 K8s 不再只是“應用運行平台”,而是要成為 承載模型、算力、資料、安全、應用的 AI 基礎設施。
所以真正的問題不是“K8s 能不能跑 Agent”——它當然能跑,但跑起來會不斷踩到調度、生命周期、狀態、協作、工具治理五大維度的天花板。這就是為什麼 From Cloud Native to Agentic AI 不是升級,而是範式重構。
二、核心辨析:企業級 Agent 到底缺什麼基礎設施?
把行業現狀攤開看,會發現一個尷尬的結構性矛盾:應用層 Agent 已經熱到發紅,底座層 Agent 基礎設施卻冷到冰點。大量企業一邊宣稱“全員 Agent 化”,一邊把 Agent 處理程序塞進一台 16C64G 的開發機、把多智能體協作寫在一個 Python 單體工程裡、把工具呼叫硬編碼進 prompt 範本。這種“應用熱、底座冷”的核心瓶頸,可以拆解為以下六大不適配點:
| 任務調度模型 | |||
| 生命週期管理 | 長會話保活、檢查點恢復、上下文瘦身、KV Cache 主動協同 | ||
| 資源搶佔機制 | GPU 共享、視訊記憶體切片、KV Cache 池化、Token 預算治理 | ||
| 多智能體協同 | 多 Agent 動態組隊、任務分發、成果接力、Swarm Skills 自演進 | ||
| Agent 狀態持久化 | Durable Execution、Checkpoint、事件溯源、跨節點 rehydrate | ||
| 工具呼叫治理 | MCP 協議註冊發現 + 非人類身份治理 + 即時策略攔截 |
六大不適配不是六個孤立問題,而是一個互為因果的惡性循環:狀態沒有持久化,長任務一斷就丟上下文,Agent 被迫全部塞進單處理程序,又反過來加劇了資源搶佔和無調度能力的痛;沒有工具治理,多智能體一旦並行呼叫,權限邊界立即失守;沒有多智能體編排,再大的 GPU 叢集也只能服務單 Agent 的序列循環——存量 K8s 在任何一條上失守,都會讓 Agent 業務整體不可用。
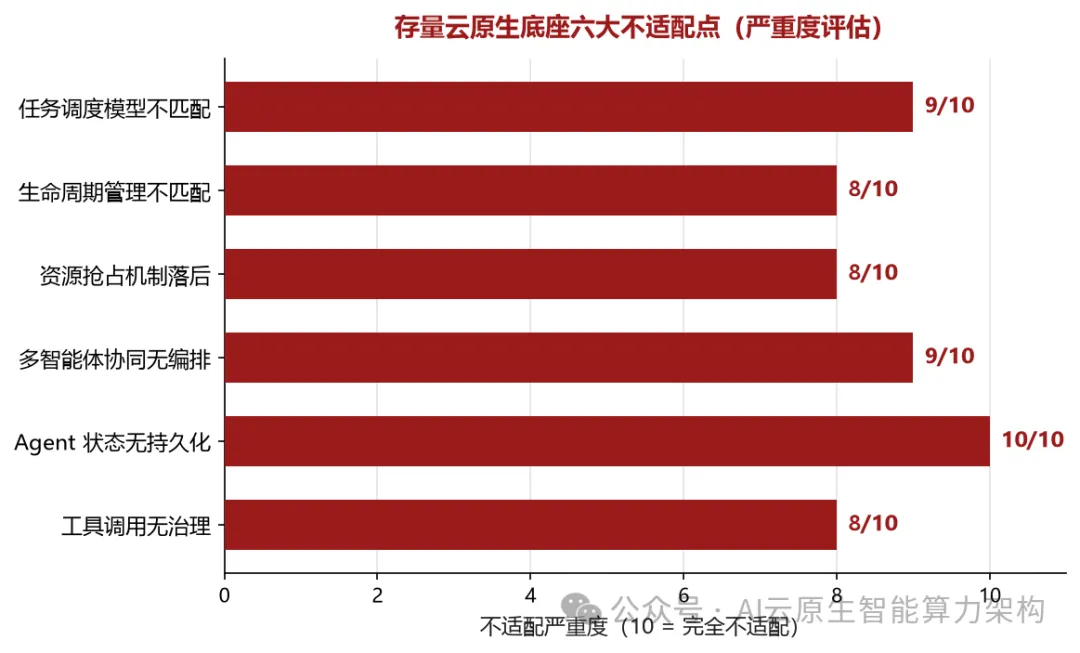
值得警覺的是,“Agent 狀態無持久化”在六個維度中評估為最高嚴重度。這並非主觀感受,而是行業普遍規律:企業一旦把 Agent 跑上生產,幾乎 100% 會撞上“上下文窗口溢出”、“節點重啟導致任務回到原點”、“KV Cache 失效重算”這三類問題,並且沒有任何傳統維運工具能定位。這是 Agentic AI 時代特有的“狀態失憶症”。
三、新基建定義:Agentic AI 專屬基礎設施核心能力框架
從 Cloud Native 到 Agentic AI 不是一個“加幾個 Agent 外掛”的工程,而是一套全新的能力框架。基於 KubeCon 官方演進思路與企業級 Agent 落地實踐,我們提煉出 Agentic AI 專屬基礎設施必須具備的七大核心能力:
| 智能任務調度 | |||
| 多 Agent 叢集編排 | |||
| 長任務容錯恢復 | |||
| Agent 狀態治理 | |||
| 工具生態註冊與發現 | |||
| AI 資源彈性調度 | |||
| 推理 / 訓練混合負載管理 |
這七項能力之間存在嚴格的依賴關係:沒有 ① 就撐不住 ②;沒有 ③ 就跑不長 ②;沒有 ④ ③ 就無法 scale;沒有 ⑤ ② 就無法對接企業系統;沒有 ⑥ ⑦,整個叢集的算力成本結構就不成立。換言之,Agentic AI 基礎設施不是能力堆疊,而是能力閉環。任何一個能力缺位,整條鏈都會被打回原形——這正是為什麼傳統雲原生廠商“加幾個外掛”式的修修補補,本質上解決不了 Agent 規模化的問題。
四、技術落地解讀:開源生態如何補齊 Agent 基礎設施短板
值得慶幸的是,過去兩年國內外開源生態已經從“單點修補”快速演進出完整的四層架構:編排層 / 調度層 / 協議層 / 執行層。以華為雲係為代表的開源棧已經基本完成從“批次調度引擎”到“Agentic AI 全端基礎設施”的躍遷。下面這張分層圖,是我們結合 KubeCon EU 2026 / China 2026 公開演進做的全景對應:
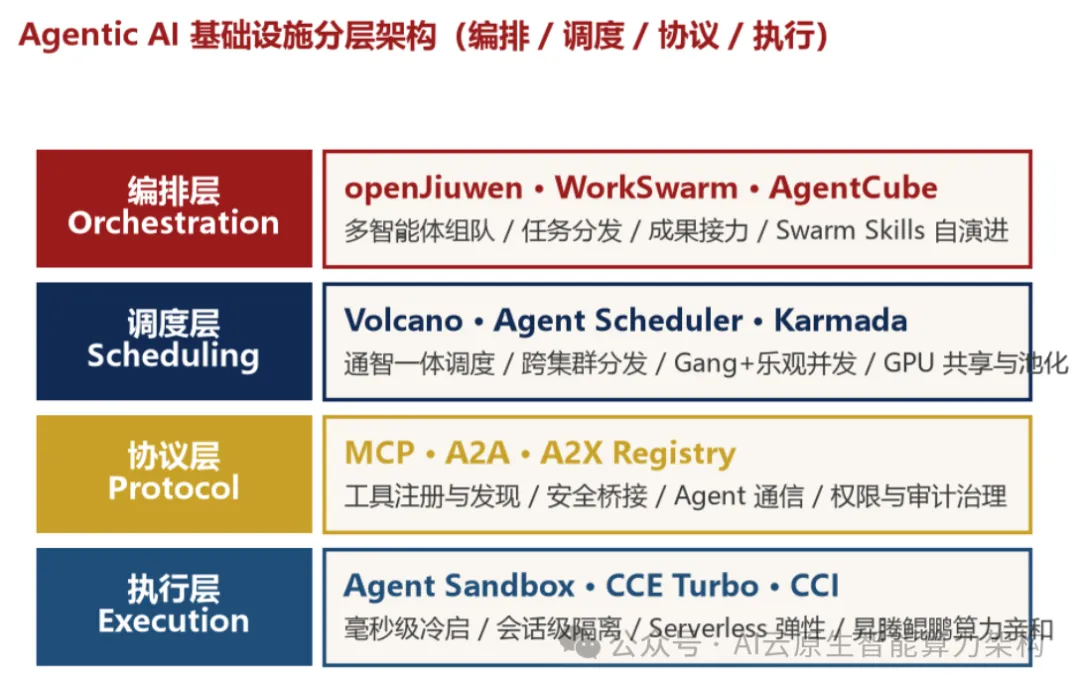
各層分工與代表項目,做一次清晰的責任切分:
| 編排層 | |||
| 調度層 | |||
| 協議層 | |||
| 執行層 |
4.1 編排層:openJiuwen / WorkSwarm 的協同工程範式
由華為 2012 實驗室 + 華為雲 AgentArts 團隊共建的開源 Agent 平台 openJiuwen,把“多智能體協同”從概念工程化為一套可落地的 Coordination Engineering 協同工程範式。
其旗艦產品 WorkSwarm(蜂群辦公智能體)提出了三個在 Agent 基礎設施領域非常關鍵的能力:
一是 Agent Swarm + HOTS / HITS 協同——支援“人在叢集之上指揮”與“人在叢集之中參與”兩種模式;
二是 Swarm Skills + Skills Hub 自演進——把協作流程沉澱為可復用的標準化技能包,並形成社區共享;
三是 KV Cache 主動協同 + 算力親和——和昇騰 / 鯤鵬底層算力深度最佳化,使多智能體並行場景首 token 時延減半、推理記憶體峰值下降約 25%。
更關鍵的是 AgentArts 與 openJiuwen 核心同源度超過 90%——這意味著企業今天基於開源 openJiuwen 建構的 Agent 平台,未來可以平滑遷移到商用 AgentArts,避免被單一廠商鎖定。
4.2 調度層:Volcano + AgentCube + Karmada 的通智一體
Volcano 在 2025–2026 完成了一次關鍵進化:從“AI 批處理調度引擎”升級為“通智融合調度系統”。三個新能力尤其值得架構師關注——Agent Scheduler 面向高並行、短生命周期的 Agent 任務,通過多 Worker 平行調度 + 樂觀並行控制,把調度吞吐拉高一個數量級;AgentCube 提供專為 Agent 打造的輕量級有狀態執行階段,Warm Pool 技術讓隔離容器實現毫秒級拉起;Kthena 面向 LLM 推理服務,支援 PD 分離部署和自動擴縮容,在複雜對話場景下可降低 20%+ 全域延遲。
Karmada 則把視野抬到多叢集聯邦層面:通過 Karmada + Volcano Global 協同,企業可以把一個超大 LLM 任務拆解後跨雲分發,讓算力跟隨任務而不是任務遷就叢集——這是 Agentic AI 時代的“超算聯邦”。B 站已經基於這套組合,把 GPU 利用率提升 40%+、故障恢復時間縮短 70%;科大訊飛則把訓練資源干擾率壓低 50%。這不是 PPT 資料,而是已經在中國生產環境跑出來的工程結果。
4.3 協議層:MCP / A2A / A2X Registry
如果說前面兩層是“引擎”,那麼協議層是“**匯流排**”。MCP(Model Context Protocol) 已經被 Anthropic / OpenAI / Block 和所有超大規模雲廠聯合推為 Agent-to-Tool 的事實標準;A2A(Agent-to-Agent) 解決多智能體協作的通訊問題;openJiuwen A2X Registry 進一步把 MCP 服務的註冊與發現工程化,讓企業能夠以集中方式管理成百上千個 MCP 工具,避免工具散落在 N 個 Agent 處理程序裡。
在協議之上,行業正在快速形成 “Governance-as-Code” 的非人類身份治理體系:把 Agent 視為擁有特權憑證的 NHI(Non-Human Identity),通過 Governance Sidecar 即時攔截越權操作,結合 OPA 之類的策略引擎實現 Policy-as-Code。這一點直接決定 Agent 能不能進入企業的核心生產系統。
4.4 執行層:Agent Sandbox 與 Serverless 彈性
Agent 每一次工具呼叫都可能是一段不可信的程式碼執行,沒有安全沙箱的 Agent 平台不配叫企業級。執行層的核心使命是:每一次 Agent 呼叫都跑在一個隔離、輕量、可毫秒級冷啟的執行階段裡。CCE Turbo + CCI + Agent Sandbox 的組合,讓企業能在共享 GPU 叢集上同時支撐上萬次 Agent 工具呼叫而互不污染,配合昇騰、鯤鵬的算力親和,把單次呼叫的邊際成本壓到極致。
這四層組合起來,才構成一個能跑企業級 Agent 的完整閉環。任何一層缺位,企業 Agent 規模化就一定會撞牆。
五、落地痛點與客觀批判(必須有,不吹捧)
把上面四層架構寫得很漂亮並不難,難的是承認它現在還不成熟。作為架構師,我們必須在企業決策時保持冷峻,避免被生態敘事裹挾。當前 Agentic AI 基礎設施的六大真實痛點:
| 標準未統一 | ||
| Agent 維運體系空白 | ||
| 長任務穩定性差 | ||
| 多 Agent 協同偵錯難 | ||
| 資源浪費嚴重 | ||
| 企業落地成本高 |
客觀結論:現階段 Agentic AI 基礎設施仍然適合“試點場景”,尚不適合全業務規模化替換。我們給出的建議是——優先在知識檢索、研發輔助、客服輔助、文件自動化這類容錯邊界寬、價值可驗證的場景落地,不要在核心交易、關鍵合規、嚴格 SLA 場景大規模替換存量系統。但同時,底座建設必須今天就開始——因為基礎設施不是買來的,是堆出來的,等到核心業務要用時再啟動,已經來不及了。
六、產業趨勢預判
趨勢不是預測出來的,是從今天已經被驗證的工程實踐中歸納出來的。基於 KubeCon EU/China 2026 的產業共識與我們的實戰觀察,給出三個明確判斷:
| 什麼樣的企業需要自建 Agent 基礎設施? | |
| 未來雲原生架構的核心迭代方向? | |
| Agent 底座會不會成為下一代算力平台的核心壁壘? | 會,而且是決定性的壁壘。 |
戰略視角:Agent 業務的勝負,不再取決於模型選型或 Prompt 工程,而取決於底座工程。CNCF 已將 Agent Infrastructure 列入主論壇議程,AAIF 已有 146 家成員;開源生態在 18 個月內就完成了從“單點修補”到“四層閉環”的躍遷。今天不投底座,明天就要為每一次 Agent 試錯買單。
結語:基礎設施才是真正的護城河
把視角拉回全篇——從 Cloud Native 到 Agentic AI,不是一次工具升級,而是一次算力範式的躍遷。Kubernetes 不再只是“容器編排系統”,它正在向“連接模型、算力、資料、安全、應用的 AI 基礎設施”演進;而企業級 Agent 的真正護城河,不在模型、不在框架,在底座——在調度器、在沙箱、在協議、在長任務容錯、在多智能體編排、在每一次工具呼叫的安全治理。
凡是仍然相信“把 Agent 跑在 Docker 裡就夠用”的團隊,註定會在 2026–2028 這一輪 AI Infra 重構期被邊緣化。凡是今天開始認真投入 Agentic AI 基礎設施建設的團隊,都將拿到下一代企業級算力平台的入場券。
範式躍遷不會等任何人。基礎設施的厚度,決定 Agent 業務的高度。 (AI雲原生智能算力架構)