
把一個視覺語言大模型部署到機器人本體上,是不少具身開發團隊面臨的工程難題。
模型在雲端或模擬環境裡跑通了,到了端側,還要面對算力、記憶體和功耗的限制,以及機器人對響應時延的要求。算子適配、張量佈局、記憶體分配和數值對齊,都需要逐項處理。對缺少推理系統專家的團隊來說,這些工作往往拖慢了自研模型從 Demo 走向實際部署的進度。
縮短這段部署過程,模型的進步才能更快轉化為機器人在真實任務中的能力。
為解決這些部署難題,無問芯穹主導,聯合清華大學、上海交通大學推出了 APXInf。這是一款面向具身模型、為機器人量產部署打造的開源高性能具身端側推理引擎,重點服務小批次、多視角、對響應時延要求嚴格的端側推理場景,截止目前已經適配2款主流具身模型和3款晶片,並且在Jetson AGX Thor 上達到了目前行業 SOTA 的性能水平。
它在底層圍繞具體模型和硬體最佳化執行路徑,也把 Agent 參與模型適配和性能最佳化的流程納入項目本身的設計。模型適配、性能最佳化與部署驗證中的專家經驗,被整理成 Coding Agent 可以執行的 Workflow 與 Skills。我們更願意從這個角度理解它的定位:一個 Agentic native 的具身端側推理引擎。
帶著這個判斷,我們在官方已適配的 RTX 4090 上測了一趟 π0.5 的實際表現;又意外發現 APXInf 在 DGX Spark 上也能跑,而官方當時尚未適配這款硬體,我們便按 APXInf 自帶的開發工作流指南把 Qwen3-VL 遷到 Spark 上,完成了遷移開發和使用測試。
01
APXInf:面向具身部署的 Agentic native 推理引擎
模型部署到機器人上,首先要解決的就是響應速度問題。
機器人本體上的小批次(如Batch=1)推理,關注的是一次觀測輸入後,模型能否在規定時間內返回動作。多視角圖像處理、模型前向計算與動作生成共享有限的計算和記憶體資源,除了吞吐量,還要關注響應時延及其波動。
APXInf 針對每個模型,將記憶體分配和算子執行安排在明確的靜態路徑中。計算流程通過 CUDA Graph 捕獲後,可以利用預先分配的緩衝區重複執行;自動調優選出的 kernel 也會在機器內保留,減少每次推理的重複開銷。
使用時,開發者可通過熟悉的 Python 介面呼叫模型。性能敏感的計算交給底層 APXInf 底層的高性能算子庫,Rust 則幫助管理記憶體和資源,確保運行安全穩定。這樣,用模型的人可以保留原來的使用習慣,也不影響性能的提升和運行的穩定性。
在模型結構和硬體變化的場景,往往靜態路徑也需要調整。APXInf 從框架設計之初,就順應時代趨勢將自身定位為一個 Agentic native 具身端側引擎,所以把 Coding Agent 的開發適配納入模型接入、前後處理、本體適配和部署驗證完整開發流程,充分適應 agent 時代。
具體入口是 skills/model-port-workflow/ ,它關聯模型移植、模型層架構、執行路徑整合和新增算子的工程文件。其中三個環節尤其值得展開。
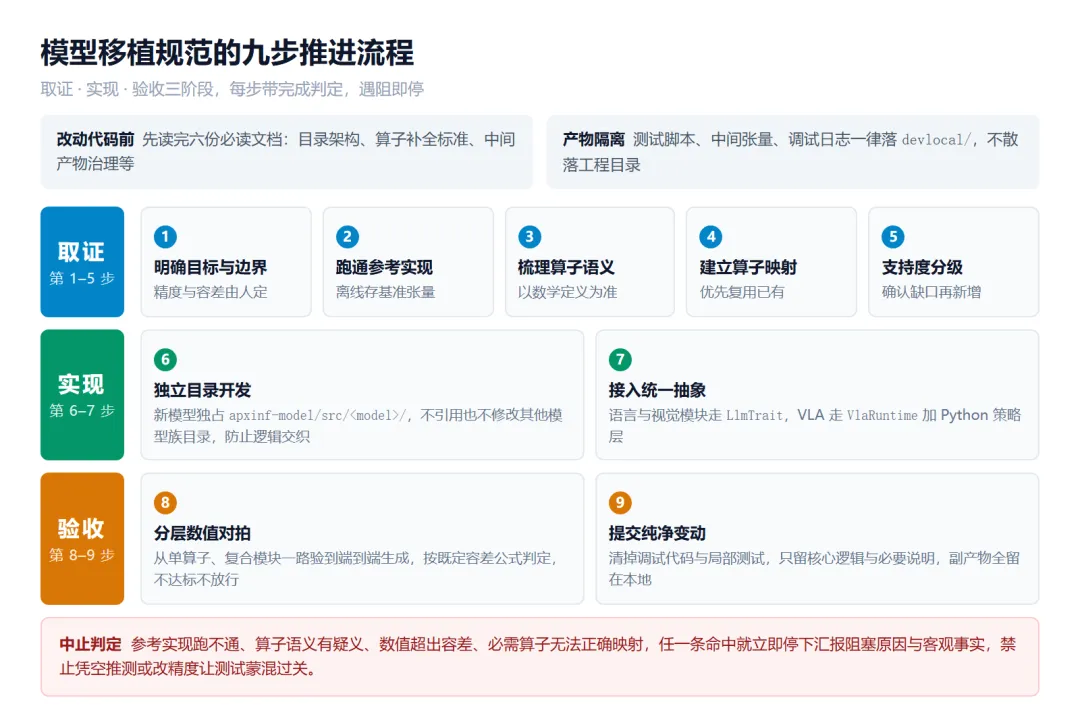
1. 先跑通原模型,建立對照
移植前,先確定模型與參考程式碼的版本,並固定所用權重。在此基礎上,約定目標裝置、推理精度及測試輸入,明確允許的誤差範圍。隨後在隔離環境運行參考實現,保存輸入輸出和必要的中間張量,供後續對照。
中間張量有助於定位偏差最早出現的位置,避免僅憑最終輸出通順就認定實現正確。
換一種實現方式,計算結果也要對得上。因此,改寫前後要使用相同的輸入、權重和隨機條件,再按事先約定的誤差範圍逐項比較。編譯通過、輸出看著正常,還不能算完成。
2. 先找現有算子,再補缺失能力
一個算子存在於倉庫裡,並不意味著模型實際呼叫了它。啟用高性能路徑,還需要目標架構的編譯支援、匹配的資料類型與記憶體佈局,以及正確的呼叫條件。
流程要求先檢查已有實現,優先復用;遇到資料佈局不匹配的問題,就在接入時做適配。缺少高性能實現時,可以先用正確但較慢的版本驗證,確認能力確實缺失後再補開發。
程式碼的修改範圍也劃得很清楚。模型層負責模型結構、權重對應和執行順序,通過統一的安全介面呼叫底層算子,不直接操作 CUDA 或跨語言介面。Agent 修改模型時有明確邊界,工程師也更容易判斷那些地方需要重新測試。
3. 驗證結果,檢查性能
驗證從改動過的算子開始,逐步擴大到完整模型,並通過實際使用的 API 檢查呼叫結果。約定的裝置和精度組合都要覆蓋,啟用 CUDA Graph 後也需要重新核對輸出。性能測試則記錄時延和記憶體佔用,結合資料搬運開銷尋找瓶頸。
結果必須先正確。速度要達到什麼水平,也應在開始前說清楚。如果功能跑通了,性能還沒達到目標,就如實記錄瓶頸和下一步最佳化,不能把“能跑”當成“已經做好”。
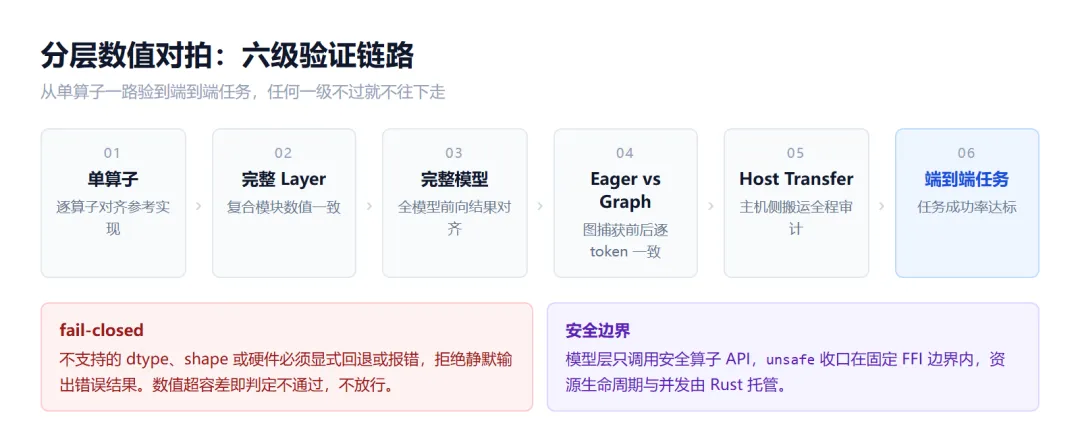
臨時指令碼、張量與日誌放入被 Git 忽略的 devlocal/ ,提交中保留需要持續維護的程式碼、測試和文件,便於審閱與後續回歸。
02
一手實測,讓 Agent 參與模型適配與性能最佳化
對具身開發者來說,一個推理引擎好不好用,既要看已支援模型的運行表現,也要看接入其他模型和硬體是否方便。我們先看官方公佈的 π0.5 測試結果,再結合 Qwen3-VL 的適配實踐,看看 APXInf 在這兩方面的表現。
已適配模型:π0.5 的官方測試表現
以機器人領域主流的 π0.5 為例,APXInf 倉庫內直接提供了 Python Policy 封裝(build_robot_policy ),並自帶相容 OpenPI 的服務介面。開發者不需要手動處理底層的視訊記憶體預分配或 CUDA Graph 捕獲,傳入多視角相機原始畫面即可獲取控制動作。
根據官方在 APXInf-robo 倉庫公佈的基準測試,π0.5 在 RTX 4090 上的單步推理延遲為 31.38 ms(BF16,對應 31.9 Hz)與 25.99 ms(INT8,對應 38.5 Hz);在車載邊緣平台 Jetson AGX Thor 上,FP8 延遲為 41.16 ms(對應 24.3 Hz)。
同時在官方公佈的 LIBERO-10 評測中,Thor 上的任務成功率為 92.2%(FP8)和 92.8%(BF16),與參考實現的 92.4% 基本持平,提速過程中保持了原有的任務完成表現。
我們在 RTX 4090 上也複測了一輪 π0.5,結果與官方公佈的差不多。
擴展適配:讓 Agent 參與 Qwen3-VL 的接入與最佳化
已有模型之外,換一個模型或裝置,適配過程會怎樣?我們從 RTX 4090 上的 Qwen3-VL 適配排查開始,隨後將工作擴展到搭載 GB10 的 DGX Spark,以 APXInf 的移植流程為指導,讓 Coding Agent 參與排查與最佳化。工作基於 APXInf 倉庫的 commit 7126992 展開,後續驗證對齊至 26a4c9c ,主要經歷了四輪改動。
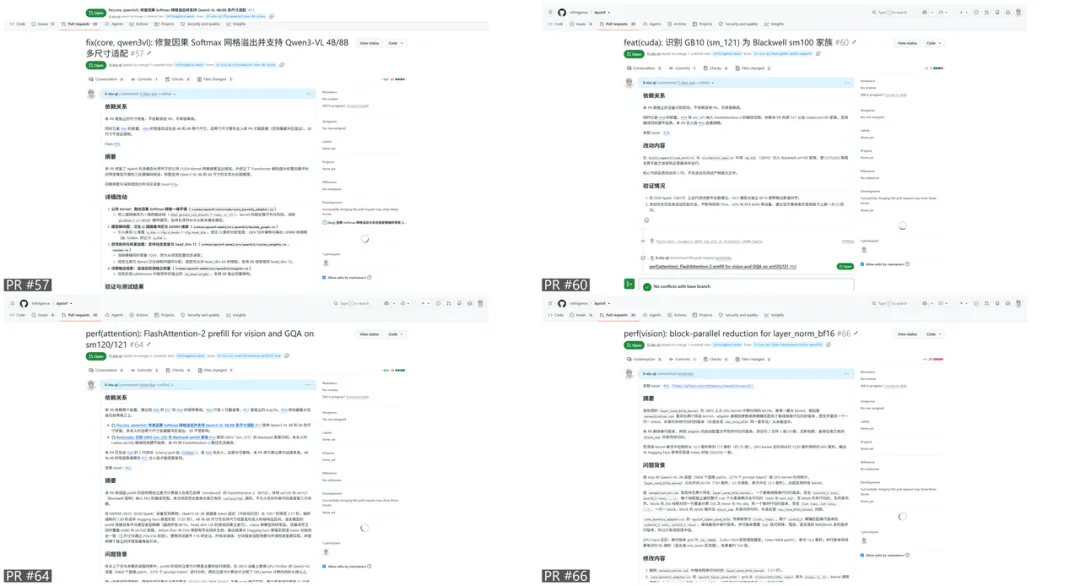
先解決模型尺寸問題。原有實現中的維度硬編碼和因果 Softmax 網格限制,導致 4B、8B 模型運行異常。通過對照參考實現,按實際配置推導維度並修復網格限制後,多尺寸路徑得以跑通,對應 PR #57。
再補齊新硬體支援。當時的架構匹配規則尚未覆蓋 GB10。補齊識別後,倉庫已有的 CUTLASS 等實現可以為該裝置編譯和運行,對應 PR #60。
接著最佳化讀圖速度。排查發現,視覺編碼和語言預填充階段尚未用上已有的 FlashAttention-2。接入後,在 GB10、Qwen3-VL-2B、BF16 和指定高畫質圖輸入下,首 token 延遲從 150.7 秒降至 2.51 秒。這是該適配路徑最佳化前後的單次測試結果,詳見 PR #64。
最後處理視覺模組的 LayerNorm 瓶頸。將呼叫從序列歸約改為已有的塊平行實現後,GPU kernel 總耗時降低約六成,端到端首 token 延遲進一步下降約 10%。兩者降幅不同,是因為主機側資料搬運仍佔用較多時間,詳見 PR #66。
四輪改動均已整理為 PR 提交至官方倉庫,具體配置和驗證結果見對應記錄。
跑完這一趟,最直接的體會是:工程師負責把控方向、定測試邊界和最後 code review;Agent 則在規範約束下去翻算子、提張量、做分層對齊。很多時候我們不用從頭造輪子,倉庫裡本來就有現成的好算子,工作流規範讓 Agent 順著清晰的路徑把這些能力找出來並接通。這種分工,比單靠工程師一個人死磕底層細節要輕鬆得多。
完成適配後,我們進一步在 DGX Spark 上對比了 APXInf 與主流框架的性能。
03
在桌面 AI 超算 DGX Spark,與主流框架同台實測
這裡呈現的是 APXInf 在原先尚未正式支援的硬體上,經我們完成模型適配與最佳化後的表現。
測試模型為 Qwen3-VL-2B-Instruct,各框架使用官方 BF16 權重,輸入同一張 1344×1792 圖像,包含 9408 個 patch,圖文輸入合計 2379 個 token,以貪心解碼生成 256 個 token。下表分別列出首 token 延遲(TTFT)、解碼階段平均每 token 耗時(TPOT)和解碼速率。
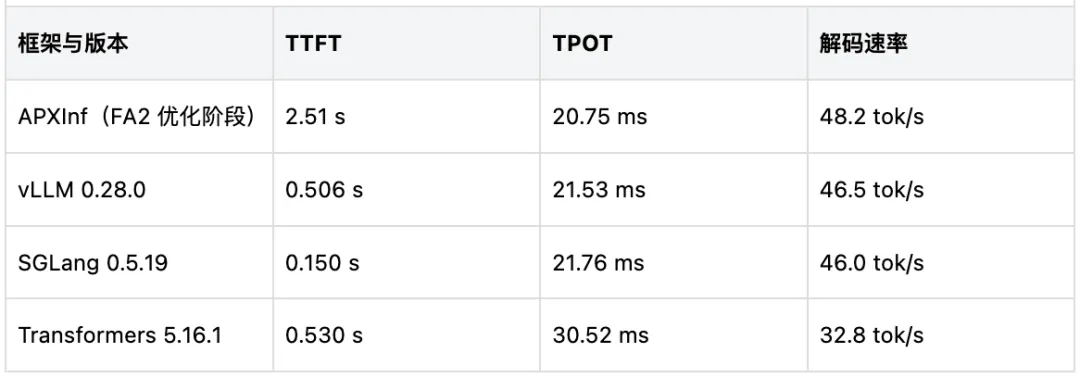
這輪測試中,APXInf 的解碼速率要超過 vLLM 與 SGLang,而且明顯高於 Transformers;首 token 延遲則仍明顯更長。結合前面的性能分析,主機側資料搬運是後續需要繼續排查和最佳化的重點。
需要注意的是,我們這裡測出來的 TPS,是 VLM 文字生成,48.2 tok/s 不能直接換算為機器人控制頻率。完整控制鏈路還包括感知輸入、動作生成、傳輸與執行。總的來說,這次的測試還是有些意外的,APXInf的解碼速度居然比vLLM要更快一些,可以看出 APXInf 的性能確實是比較不錯的。
04
寫在最後:讓模型的進步,早點用到機器人上
跑完這一輪,我們覺得 APXInf 值得關注的地方,除了推理速度,還有它讓 Agent 參與底層開發的方式。
模型還會更新,適配也不會只做一次。如果每次都要等少數專家從頭排查,新模型上機就快不起來。APXInf 把經驗留在流程裡,讓 Agent 能接著推進,團隊也少一些重複摸索。
雖然人還得把關,但有 Agent 一起排查和修改,人就能騰出些精力,繼續改進模型本身。
這也解釋了它為什麼在 RLinf 生態中首發:RLinf 支援模型訓練與評測,APXInf 負責端側推理與部署,兩者銜接起來,模型從訓練到上機的路就更完整了。
期待這次實測中用到的適配與最佳化流程,今後能幫更多具身團隊把自己的模型跑起來,讓模型的進步,早點用到機器人上。 (Datawhale)