
OpenAI 不敢公開的,小米公開了:大模型 RL 訓練全程直播!
今天凌晨,小米羅福莉,把 MiMo-V2.6 的強化學習訓練過程搬上了直播!上午 8 點 13 分,帳單停在 1,113,375 美元。還在跳。
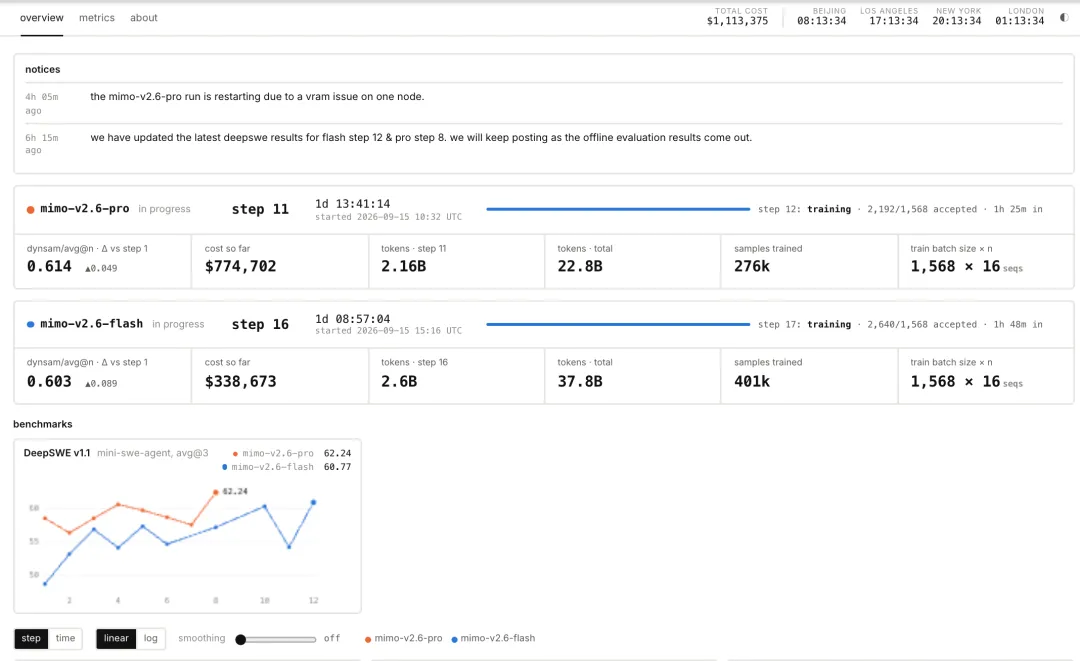
當 Anthropic 和 OpenAI 還在跟你玩捉迷藏時,小米向我們展示了訓練 AI 可以更透明。
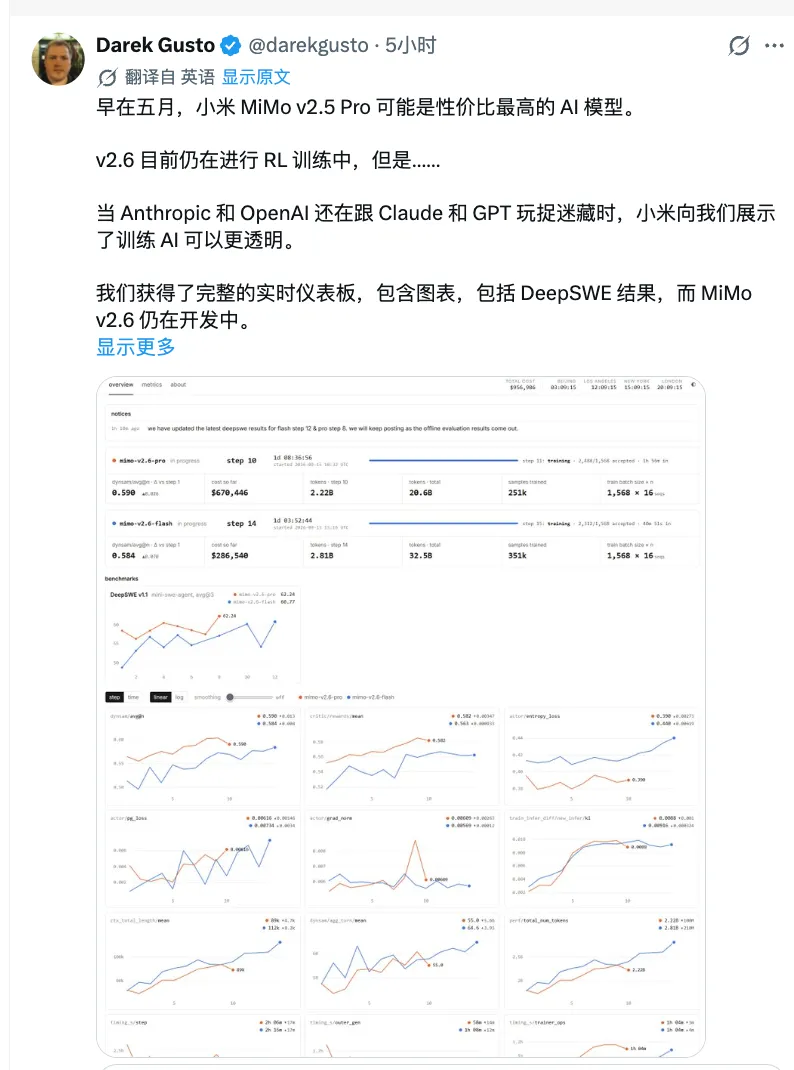
01. 羅福莉 線上直播燒錢
羅福莉表示,小米MiMo近半年沉默。我們用這段時間研究一個問題:強化學習(RL)能擴展到多遠。
這次MiMo-V2.6 目前正處於其 RL 運行的中途。他們擴展了三件事:計算資源(每步約 20 億 token,1568 個提示 × 16 次 rollout,完全非同步)、環境和測試框架(多工代理式 RL,在一次運行中混合多個測試框架),以及評估計算(代理式組內信用分配,帶有測試用例和基於量規的獎勵)。
他們將在未來幾周逐步開源細節。
然後後訓練過程的儀表盤直接公開了!基哥是第一次見!
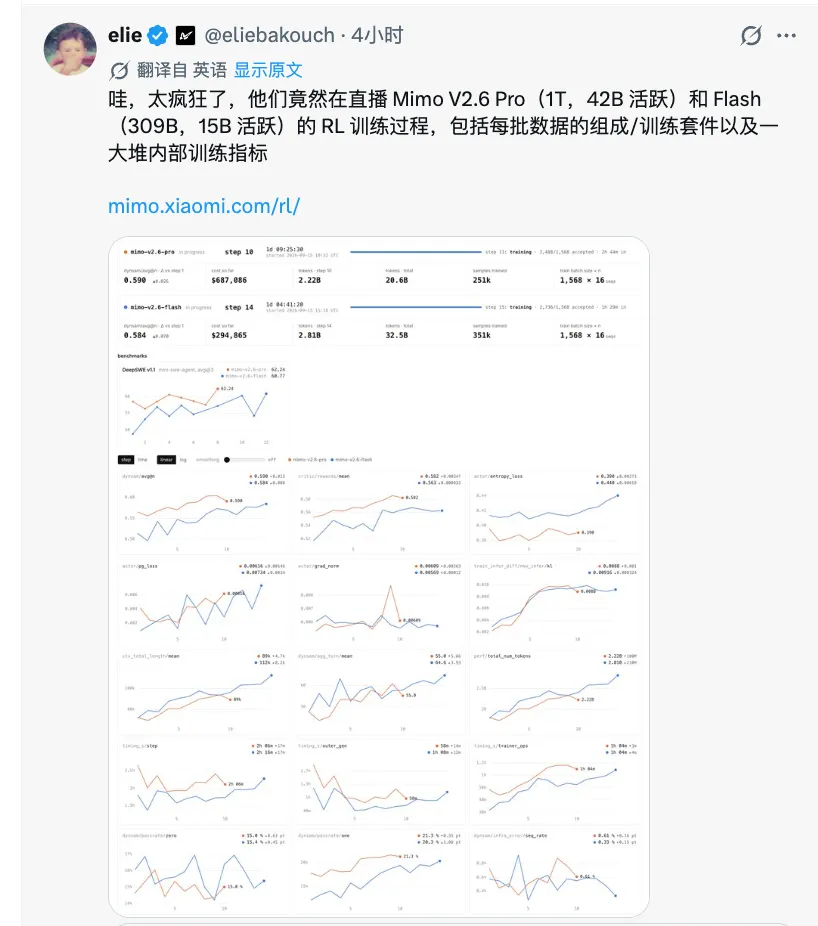
大家都說,小米太瘋狂了!
02. 燒多快?
有開發者盯著儀表板掐表:總費用半分鐘漲了 287 美元。
折算下來每秒約 8.5 美元,每小時 3 萬美元。
儀表盤自己把單價都報了:Pro 檔每步成本除以 token 總量,約 34 美元/百萬 token;Flash 檔約 9 美元/百萬 token。
每分鐘 511 美元的帳。
這次直播的不是發佈會 PPT,是一線大廠的 RL 訓練 telemetry,這種東西,OpenAI、Anthropic 的內部同款,普通人從來只能在論文裡看靜態截圖。
兩個任務在同時跑。
Pro:第 11 步,已訓 1 天 13 小時,燒掉 77.4 萬美元,吃掉 228 億 token。
Flash:第 17 步,已訓 1 天 8 小時,燒掉 33.9 萬美元,吃掉 378 億 token。
每步訓練批是 1568 條 prompt,每條 16 個採樣序列。
03. 透明的公開細節
真正值錢的是細節。
每條樣本平均要跑 47 到 53 輪智能體循環,平均上下文長度 8.7 萬到 10.4 萬 token。這不是讓模型做選擇題,是把它扔進程式碼、終端、網頁任務裡跑長鏈操作,跑完再打分。
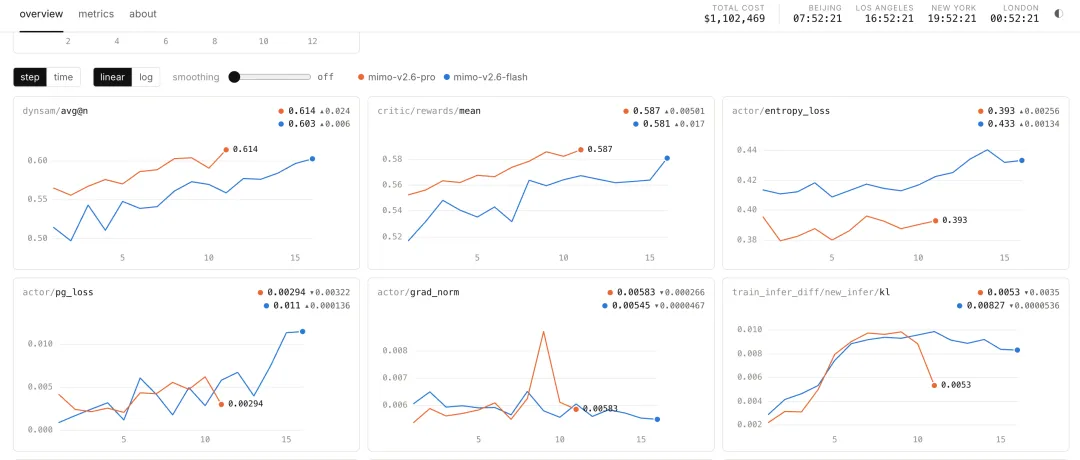
passrate:零嘗試通過率只有 14.6% 到 14.9%,一次重試後也不過 21.8% 到 25.2%。這些頂級模型面對真實長鏈任務,四分之三的嘗試是失敗的。
另一欄是 notices:四個小時前,團隊主動公告"Pro 因單節點 VRAM 問題正在重啟";評測結果隨出隨發。
叢集同時掛著 2.2 萬到 3.8 萬個平行環境,基礎設施錯誤率壓在 0.5% 左右。每步耗時兩個半小時,其中生成佔一個半小時、訓練佔一個小時,兩條流水線重疊著跑。
核心機密其實藏在 "dynamic sampler" 裡。
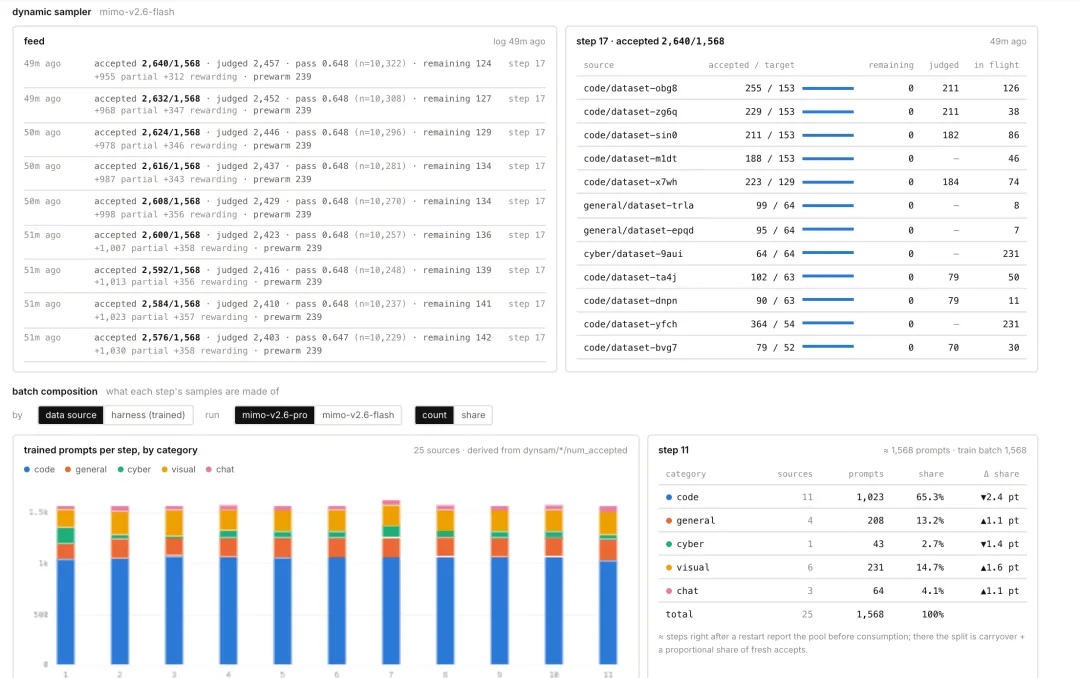
feed 區暴露了他們的採樣機制:step 12 的 pro 實際 accepted 2,200/1,568。超采了 1.4 倍,judge 了 2,110 條,從 6,217 個候選裡篩。
12 個資料來源(code×9、cyber、general×2,名字全是雜湊過的)各有 accepted/target 配額,比如 yfch 目標 54 實際收了 56-364 條。
這就是 MiMo 技術報告裡 RL 範式的線上版:動態配比 + 超額採樣 + 按源配額重組訓練批。
儀表盤自己的 benchmark 曲線顯示,DeepSWE v1.1 上 Pro 是 62.24 分,Flash 是 60.77 分。什麼水平?同一個 benchmark,昨天那個匿名模型 Union Alpha 實測 73 分,GPT-6 Astra 74 分。
差距明晃晃擺在那。
曲線在後段還在爬,Flash 的斜率尤其陡。
04. 小結
小米這波操作,開發者都在鼓掌。這就是最好的入門教材,做 RL 的人能即時看到非同步訓練的 KL/staleness 控制資料,想自建訓練 infra 的團隊第一次有了公開成本基準。
別人把燒錢藏進財報,小米把燒錢做成內容。
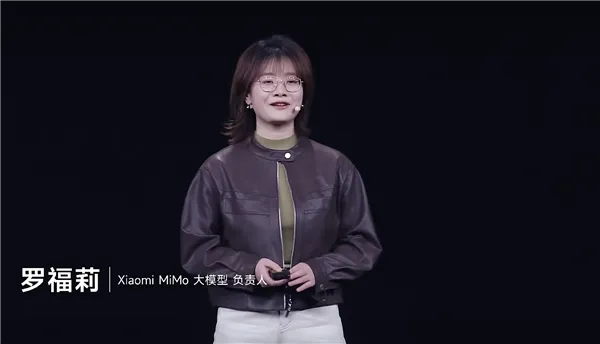
領舞的是去年 11 月入職的 MiMo 大模型負責人羅福莉。95 後,北大碩士,達摩院做過 VECO,在 DeepSeek 參與過 V2。她今年給的關鍵詞是"自進化”。
小米要讓大家相信:這家公司在大模型上是認真的,錢管夠,過程敢亮。
1.6 兆美元的全球 AI 軍備賽裡,111 萬美元的訓練直播算不上大手筆。但它把"透明度"捲到了新高度。 (奇偶工作室)