
2016年,AI教父Hinton給醫院的放射科判了「死刑」:「人們現在就應該停止培養放射科醫生。」他預測,五年內,AI就會勝過放射科醫生。
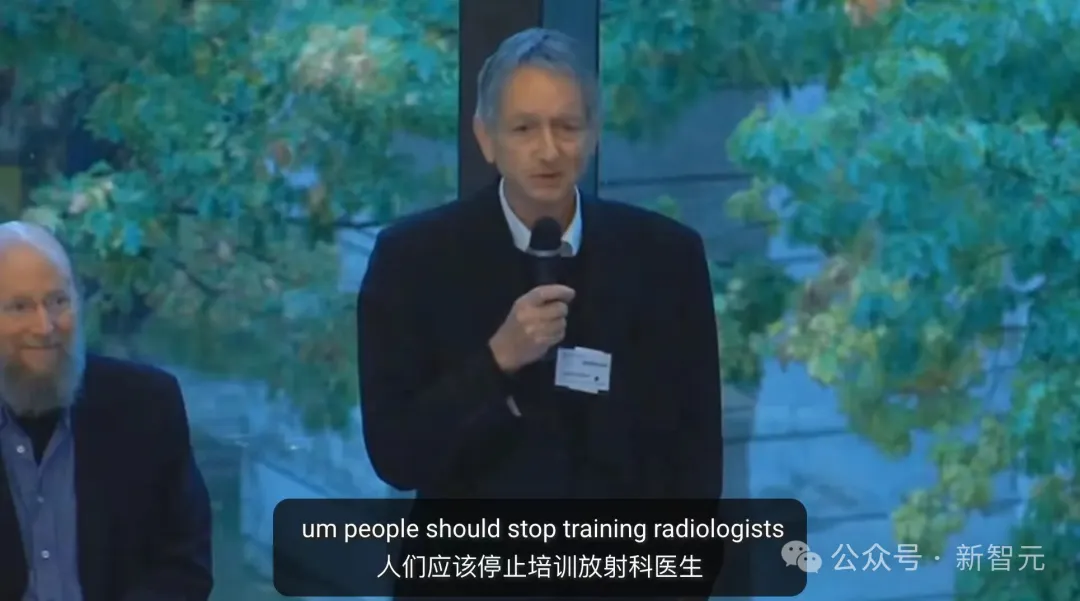
10年過去了,AI沒有攻下放射科。
他低估了醫療。
醫療,是AI的終極測試場。在這裡,模型不是答錯一道題,而是可能漏掉一個病灶、誤導一次診斷。醫療對精度的要求近乎苛刻,對錯誤和幻覺的容忍度極低。
這也是為什麼,醫療影像AI做了十年,還困在「專病專模」裡。
直到這個中國AI橫空出世。
9月18日,阿里巴巴達摩院與浙江大學醫學院附屬第一醫院研發的DAMO RADAR登上Science正刊,它能一次性識別超過146種病症,而且是最難分辨的腹部,AUC高達0.913,首次達到影像科資深醫生水平。
這也是全球首個專家級的通用影像AI模型,有望邁向傳說中的「AI影像醫生」。
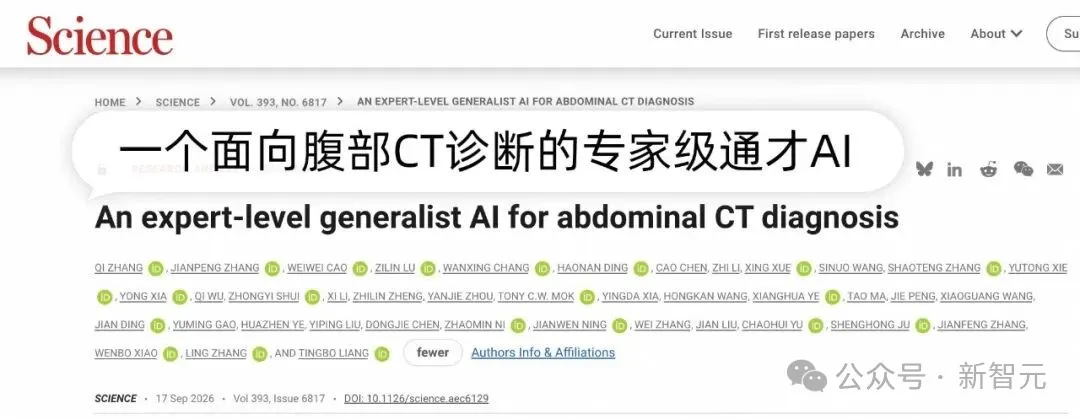
論文連結:www.science.org/doi/10.1126/science.aec6129
開源地址:https://github.com/alibaba-damo-academy/damo-radar
十年過去了,Hiton的預言終於有了一絲希望。但奇怪的是,參與研究的中國影像醫生們並沒有害怕被AI取代,而是熱烈擁抱它。
浙大一院放射科主任肖文波第一次看到實驗結果時,「有點不太相信」。第二次驗證得到相近資料後,醫生們有些躁動:「趕緊部署起來。」
達摩院先做4把「尖刀」
達摩院醫療AI並不是從RADAR開始的。
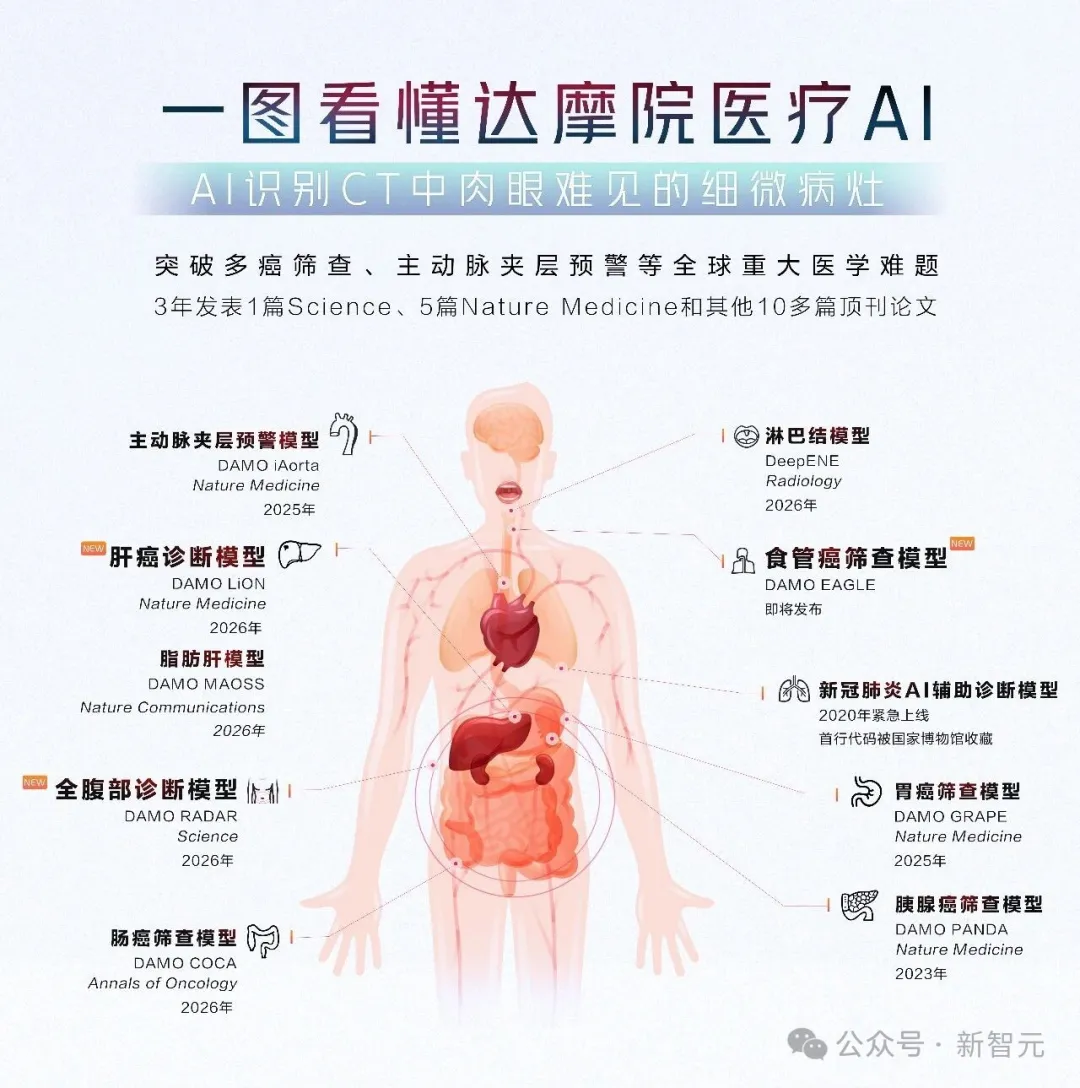
2020年初,新冠疫情暴發,困在家裡的幾名達摩院演算法專家,看到影像醫生閱片太多累倒在醫院走廊的新聞,兩周內緊急開發出新冠肺炎CT輔助診斷模型,能自動勾畫肺部病灶、計算感染比例、對比病情變化。它服務了國內外近600家醫療機構,分析超過80萬例CT。
此前,他們已在CT上浸潤多年,而疫情把演算法團隊直接推到了真實臨床現場。
此後,達摩院把目標瞄準了癌症,還是通過CT,這是醫院最常見的診斷工具之一,價格便宜,使用廣泛。
2023年,DAMO PANDA登上Nature Medicine。它嘗試從平掃CT中篩查胰腺癌——一種早期症狀隱匿、發現時往往已到晚期的「癌王」。
胰腺藏在腹腔深處,早期病灶細小,之前沒有影像科醫生會從平掃CT上看胰腺癌,因為基本看不見。平掃CT對比度較低,醫生一般只用來看肺結節、骨折等常見病症。
在20,530人的真實世界回顧性驗證中,PANDA發現了31例此前臨床漏診的病變。
2025年,DAMO GRAPE同樣發表於Nature Medicine。它把平掃CT機會性篩查推進到胃癌,研究覆蓋20家醫院、近10萬人。胃是不斷收縮、形態變化巨大的空腔器官,過去醫生只能靠操作複雜的胃鏡來識別胃癌病灶,從來沒有人想過用CT。
2026年,DAMO COCA發表於Annals of Oncology,把目標轉向結直腸癌。在27,433人的兩輪真實世界研究中,模型發現了5例既往遺漏病例。它同樣沒有要求患者為AI多做一次檢查,而是試圖從既有影像中,再撈出一層原本可能被忽略的風險訊號。
2026年,達摩院又推出食管癌模型DAMO EAGLE,無需插管和造影,從平掃CT上就能識別食管癌,重點包括早期和癌前惡性病變。
PANDA、GRAPE、COCA、EAGLE,像4把越來越鋒利的「尖刀」。它們盯住一種癌症,圍繞微小病灶、早期訊號和高風險人群一路向下扎。
這條路線打開了一個新入口:病人本來只是因為體檢、腹痛或其他原因拍了一張CT,AI可以順手再篩一次癌症風險,不增加一次專門檢查。
但尖刀也有尖刀的邊界。
每增加一種疾病,就要重新找病例、做標註、訓模型、跑驗證,整個周期再快也要兩三年。「按照這個速度,是不是一輩子都做不完?」 達摩院高級演算法專家張建鵬說,他是腸癌模型的核心作者。
面向最難的目標開火
RADAR不是PANDA、GRAPE、COCA等專病模型的合併。專病模型像狙擊槍,目標明確,追求在一種疾病上看得更深。RADAR更像雷達,要先把整個腹部掃一遍。
對醫生來說,可能更需要雷達。現實世界不是考試,不是只考胰腺癌。腹水、術後改變、金屬偽影、罕見異常,會同時出現在同一個病人身上,還有可能帶有其他病症。
而腹部,恰恰是最難的部位。腹部涉及消化、泌尿、生殖等多個系統,幾乎所有器官都擠在同一組影像裡。一次增強CT,往往包含多個不同期相、每個期相上百幅圖像,醫生需要逐一排查,才能形成一份完整的診斷報告。
「對我們科室所有的年輕醫生中,最害怕進的組,就是腹部組。」浙大一院肖文波介紹,從年輕醫生進科到能獨立稽核報告,往往要先經過胸部組和其他器官組的歷練,最後才敢進腹部組。「我們一直想要一個針對全腹的AI,但大家都知道這個難度,不敢想。」
張建鵬介紹,對於全腹CT的通用影像AI,業界不是沒有嘗試。視覺-語言學習方法也並非全新事物,有研究者嘗試將其引入醫療影像領域。其好處很明顯:不再需要醫生去大量標註資料,可以直接利用醫院現成的CT報告,讓AI從報告中學習,讓影像與醫學語言彼此對齊。
但問題在於,這種自然圖像領域的常見方法在腹部CT上效果不佳。腹部結構複雜,各種器官疊在一起,而病灶稀疏,粗放的全域視角很容易讓模型走偏:「模型非常容易走捷徑,關鍵的異常往往會被淹沒掉。」
這個問題困擾了達摩院演算法專家們很久,他們最終從醫生身上獲得了靈感。
張建鵬經常去醫院觀察醫生怎樣讀片,答案不是「一眼看完整個腹部」,而是按器官,一個一個排查。這個臨床動作,後來變成了RADAR最關鍵的技術結構。RADAR選擇把腹部拆成不同的解剖單元,再讓每個器官與報告中的對應描述對齊。它不靠生成一段聽起來像醫生的話作判斷,而是定位、對齊,再比較正負提示詞與影像的相似度,在醫生工作台上生成熱力圖對病灶進行風險提示。
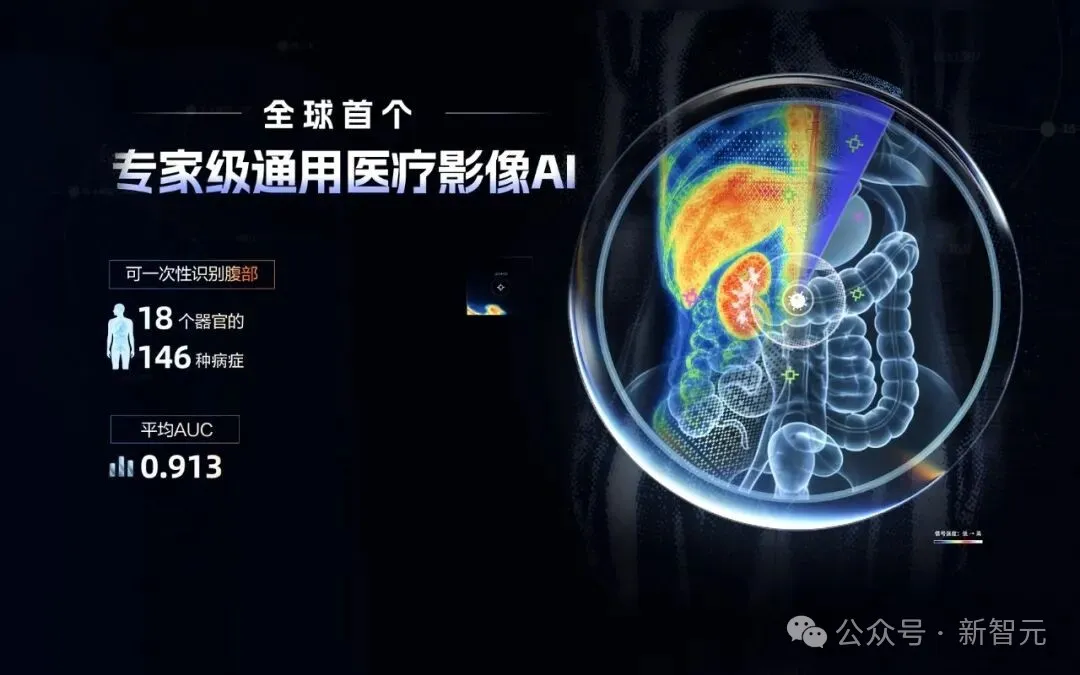
內部真實世界測試中,RADAR接受了39,160次測試。在146項病症上,平均AUC達到0.913。隨後,研究人員又在8家外部醫療中心的回顧性佇列上驗證模型;各中心覆蓋68到136項病症,平均AUC約0.895。在兩個以病理結果為金標準的佇列中,面對肝細胞癌、胰腺癌、胃癌和結直腸癌,AUC達到0.891到0.984。
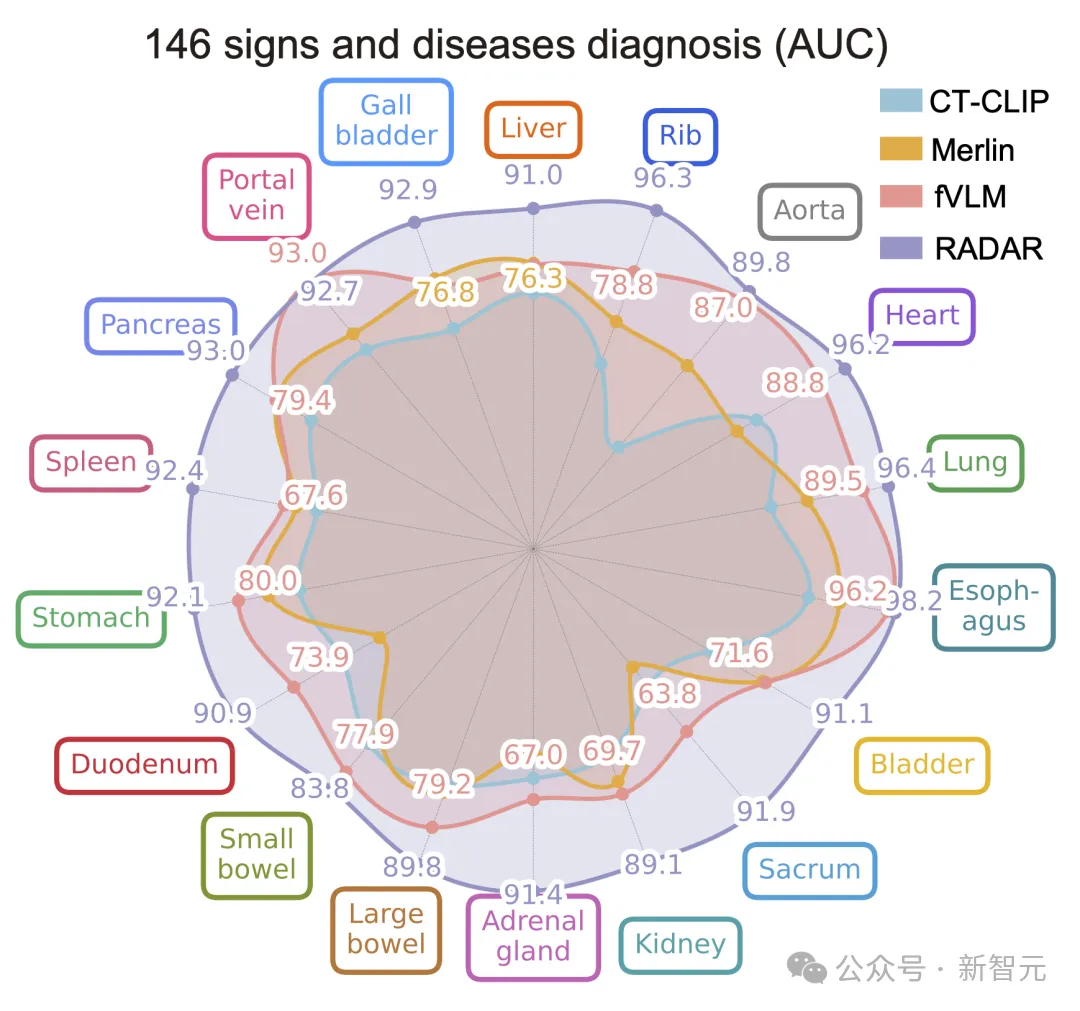
換醫院、換裝置、換病種、換場景...RARDA依然展現出強勁的性能,這比一條漂亮的單院曲線更接近醫院裡的真實考場。讀片測試中,RADAR與14家醫院的26名影像科醫生進行了人機對比試驗,其平均精準率超過了其中23名醫生,僅弱於3名資深醫生。
「最初我聽到這個資料,有點不太敢相信。」肖文波說,這麼多器官、這麼多相像的結構,一次性識別146種病灶,「我做了這麼多年醫生,都得反覆重建、仔細去看才能確保沒有遺漏。」
更難得的是,RADAR在急診等陌生場景中展現出強大的泛化能力。在一項包含27,267例急診CT的測試中,RADAR面對17種常見急腹症,平均AUC仍達到0.904。也就是說,研究人員沒有專門教它應該怎麼做,它仍能把此前學習到的影像規律遷移到新的臨床場景中,通用影像AI由此煉成。
影像醫生催著上線
「我給科室同事介紹了RADAR,也在同行會議上做過分享,大家都特別驚喜,追問什麼時候能上線,能不能快點給我們裝一個?」肖文波說,醫療影像上經常出現」同病異影、異病同影」,不管是多麼資深的醫生,也不敢保證能識別出所有的腫瘤,見過所有的特徵,年輕醫生尤其如此,所以大家其實面臨很大的心理壓力,尤其是在做良惡性判別時。
RADAR打開了一扇窗,在閱片試驗中,AI幫助醫生將敏感性(防漏診的能力)提升了10%,平均閱片時間縮短30.7%。RADAR讓年輕醫生瞬間擁有了資深醫生的閱片能力,其診斷信心也大幅增強。
影像醫生不害怕AI,更害怕漏診,害怕在數百張切片中發現了一個病灶,卻漏掉了另一個。
肖文波介紹,浙大一院放射科一天有四五千例CT,閱片量巨大,而腹部CT讀片難度很大,一個資深醫生也得花費20-30分鐘來讀完一例。「如果在我們醫院,腹部CT都是一個很困難的問題,那普通醫院應該更難吧?大家看的片子沒這麼多,經驗可能沒這麼足。「
肖文波擔心的是另一件事。
年輕醫生借助AI,可以寫出接近資深醫師水平的報告;「但是把AI一撤掉之後呢,又變成了年輕醫生的水平」。
所以,她設想的順序是:醫生先獨立判斷,AI覆核,醫生再對比分析,如果AI看出來了自己沒看出來,那必須追問為什麼。醫生不能把方向盤交出去,而是多裝一套不會疲勞的雷達,這個雷達也會變成年輕醫生的帶教,幫助年輕醫生成長。
One More Thing
很多人也許會問,RADAR出現後,PANDA、GRAPE、COCA、EAGLE這些專病模型還有用嗎?
它們其實面對的是不同問題。
PANDA和GRAPE主要從平掃CT中尋找特定癌症的早期訊號,適合無症狀人群的機會性篩查。RADAR面對的是腹部增強CT,要同時查看多個器官和大量異常。
一條向深處扎。一條向廣處鋪。
專病模型可以圍繞微小病灶、癌症分型和高風險人群持續最佳化,實現超越人類的精度。通用模型則負責掃過多個器官,幫助醫生發現目標。
應當說,通用影像AI模型還在早期,RADAR目前只完成了回顧性實驗,還需要前瞻性實驗等進一步工作,目前還未達到專病模型的成熟度。
達摩院資深演算法專家張靈說,「RADAR已經初步證明了通用影像AI的可能性,我們的實驗證明,它的能力還未被完全挖掘,還有可能隨著Scaling Law進一步上升。」也因此,達摩院選擇開源,希望行業共同推動通用影像AI走向成熟。
十年前,Hinton預言AI即將勝過放射科醫生,並主張停止培養他們。
十年後,RADAR的讀片實驗沒有讓26名醫生離場,而是讓他們和更多的醫生充滿期待。
不久前,黃仁勳也重新談起Hinton的預言。他說,放射科醫生非但沒有被AI取代,人數反而增加了,「如今幾乎每一位放射科醫生,都在以某種方式使用AI」。 (新智元)