
AI正在橫掃一切,但有塊硬骨頭,遲遲攻不下來,讓無數人希望落空。
2016年,Hinton老爺子就預言:“人們現在就應該停止培養放射科醫生。”他甚至認為,五年內,AI就會在醫療影像識別上超過放射科醫生。
老爺子一生謹慎,但歷史和他開了個玩笑。十年過去了,人們離AGI已經越來越近,但在醫療場景裡,即使圖像識別這樣的AI新手村任務,依然是hard模式。
如果從IBM的Watson算起,在醫療上遭遇滑鐵盧的AI專家數不勝數。
為什麼醫療成了AI的阿喀琉斯之踵?
——對模型精度的極高要求,在別的領域,模型幻覺可以一笑了之,但在這裡卻是人命關天。
這也導致了醫療影像AI長期困在專用模型裡。
直到今天,學術期刊的“王者”Science正式刊發一項來自中國的重磅研究:
DAMO RADAR,據介紹是全球首個專家級的通用影像AI模型。
這個模型,能看腹部18種解剖結構的146種病,比很多影像科醫生看得還准。
而且模型、程式碼、框架,全開源了。
一個模型,看146種病
DAMO RADAR,全稱Rapid Abdominal Diagnosis with AI and Radiology,面向腹部快速診斷的AI模型。
這個AI“雷達”,研發團隊就是阿里達摩院,過去幾年他們用AI識別CT中肉眼難見的早期癌症病灶,在胰腺癌、胃癌、腸癌等專病上取得重大突破,發表5篇Nature Medicine。
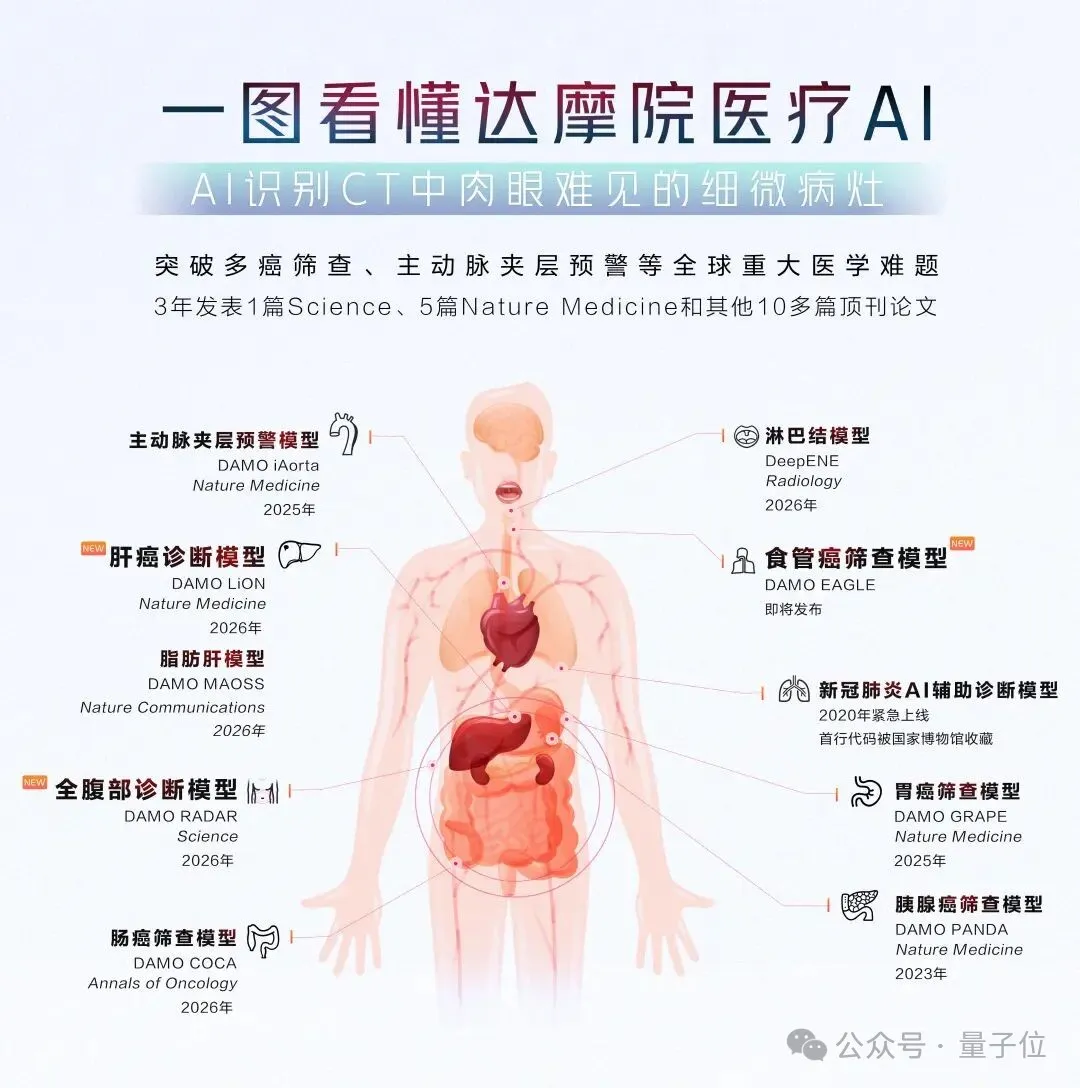
但做著做著,達摩院有些人覺得不對勁了。達摩院高級演算法專家張建鵬說,一個病種啃下來至少兩三年,人類疾病成千上萬種,那他們搞一輩子都搞不完……
更棘手的是,真實世界裡,病人不會只帶著一種病來醫院,對著專病模型問他是不是有這種病。事實上,一份CT影像裡,很可能同時存在多種器官,多種病變。
達摩院聯合浙大一院等全球眾多醫院向腹部CT發起衝擊,希望AI能一次性識別出腹部各種疾病。
選腹部,是因為這是臨床公認最難的影像場景。
浙大一院放射科主任肖文波介紹,年輕醫生通常最害怕被分到腹部組。
因為腹部涉及消化系統、泌尿系統、生殖系統,肝膽胰脾腸道全擠在一起,腸道還盤繞整個腹腔,所有器官幾乎都是軟組織,密度接近,全靠肉眼對密度差的敏感度把病灶揪出來。
之前,已經有了針對肺結節之類的AI輔助工具,但腹部太複雜了,一直是個禁區,沒人敢碰。
RADAR要做的,就是用一個模型覆蓋整個腹部。
最終它覆蓋了18種解剖結構、146種病,涵蓋肝臟、胰腺、膽囊、腎臟、脾臟、腸道等主要器官,基本覆蓋了臨床常見病變。
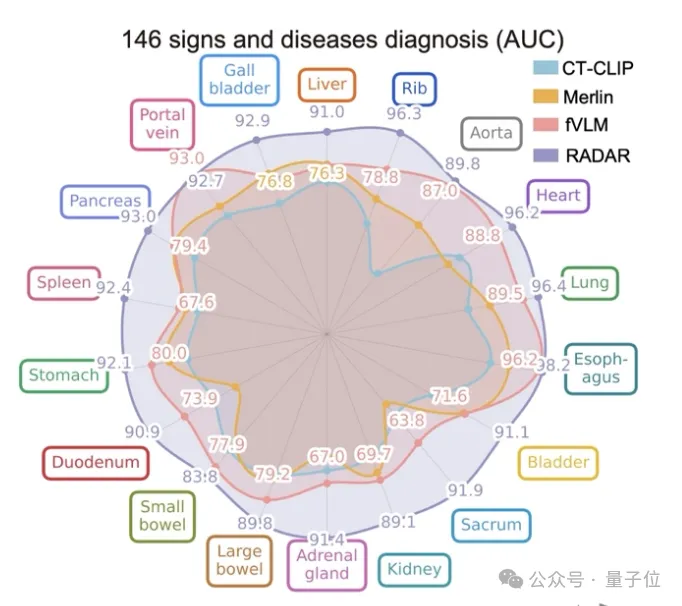
對其效果,團隊做了非常嚴格的多層驗證。
在內部近3.9萬例真實世界連續佇列中,RADAR的平均AUC達到0.913。
AUC是衡量診斷模型區分患者和正常人能力的指標,1是完美區分,0.5等於瞎猜,超過0.9就算優異。
之後,團隊又在來自8家外部醫院的超過2.4萬例CT上驗證,這些案例覆蓋不同地區、不同掃描裝置,RADAR的AUC仍然達到0.895。
而且RADAR還泛化到了急診場景。
急診場景與一般門診的區別是,由於時間緊急,來不及等造影劑發揮最佳效果,患者也不一定有能力配合,CT成像效果偏差。
RADAR的訓練目標並未包括急診,但測試時團隊拿2.7萬例急診資料一測,結果AUC依然有0.904。
而且達摩院在肝癌、胰腺癌、胃癌、腸癌四種癌症的診斷上,還提高了對RADAR的要求。
在這四種癌症上,他們用來考驗RADAR的依據,是“病理金標準”,也就是以病理活檢結果作為Ground truth,確認影像判斷准不准。
這個拔高測試當中,RADAR的AUC仍達到了0.891-0.984。
達摩院還做了一波人機對比。
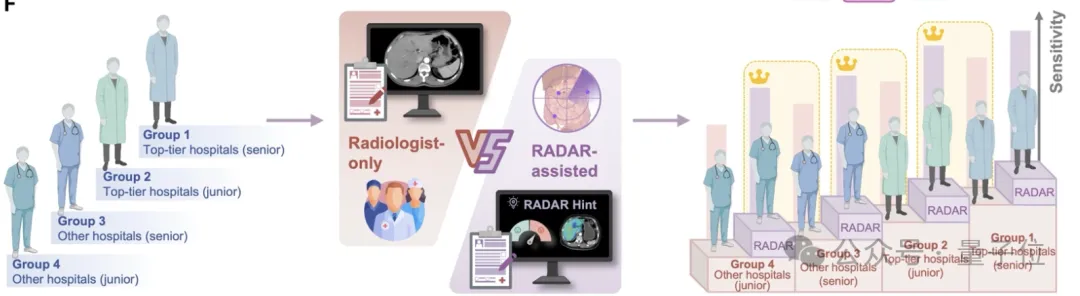
這波對比共有來自14家醫院的26名放射科醫生參與,RADAR和TA們在同一批病例上各自獨立診斷,結果RADAR的精準率超過了其中23名醫生,只稍弱於3名資深醫生。
與此同時,達摩院還測試了人機協同場景,發現醫生在有AI幫助的情況下讀片,整體敏感度提升了大約10%,平均閱片時間減少了30%以上。
“初級醫生+AI”的配置,敏感性甚至超過了資深醫生獨自閱片。
那RADAR到底是怎麼做到的?
過去的醫療影像AI用的是監督學習,簡單說就是讓醫生一張一張地標註CT圖像,然後AI照著標註學。
這種方法標註成本巨大,而且模型只能識別被標註過的那幾種病,換一種就不認識了。
RADAR走了一條不同的路,叫視覺-語言對比學習。
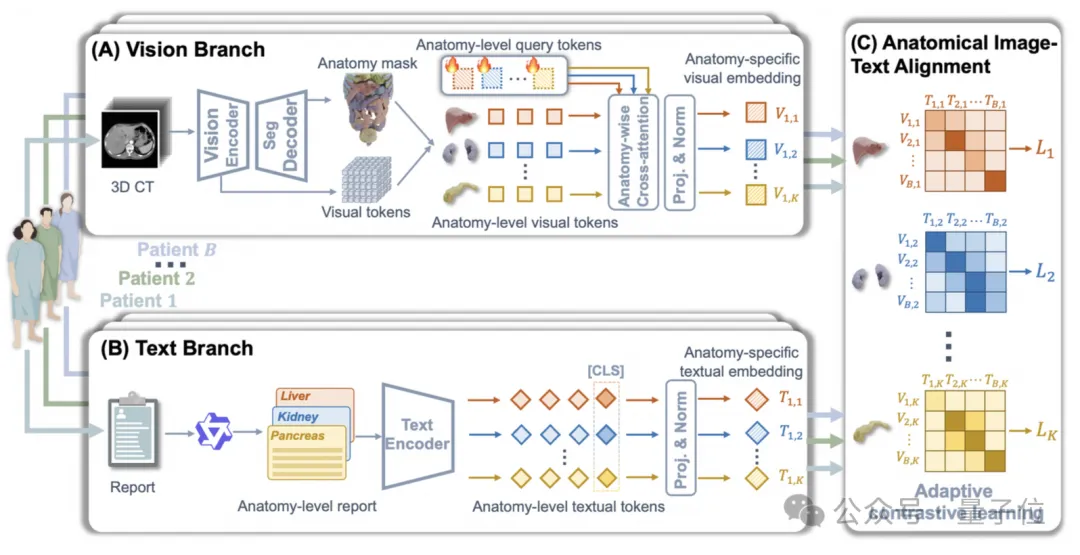
醫院裡天然存在大量CT影像和對應的診斷報告,RADAR直接從影像和報告文字的對應關係中學習,不需要醫生額外逐片標註。
這有點像醫學生跟著主任查房,主任看片子的時候會說“肝臟有一個低密度灶,考慮血管瘤”,學生聽多了,自然就知道什麼影像特徵對應什麼診斷。
但直接把整張CT和整份報告對齊,效果很差。
團隊一開始就試過這條路,結果發現模型只能學到一些粗糙的統計特徵,建立不起來“那個器官對應那段描述”的關聯。
因為一套腹部CT有幾百張切片,包含好多個器官,真正有問題的可能只是某個器官上一個很小的病灶,如果讓模型拿整張圖去理解,關鍵訊號就被大量正常組織淹沒了。
這就涉及到了RADAR的核心突破——“器官級細粒度對齊”。
它先從CT中定位出肝臟、胰腺、膽囊、腎臟等各個器官,把一整套CT拆解成一個個器官單元,再把每個器官單元和報告中對應的描述精確對齊。
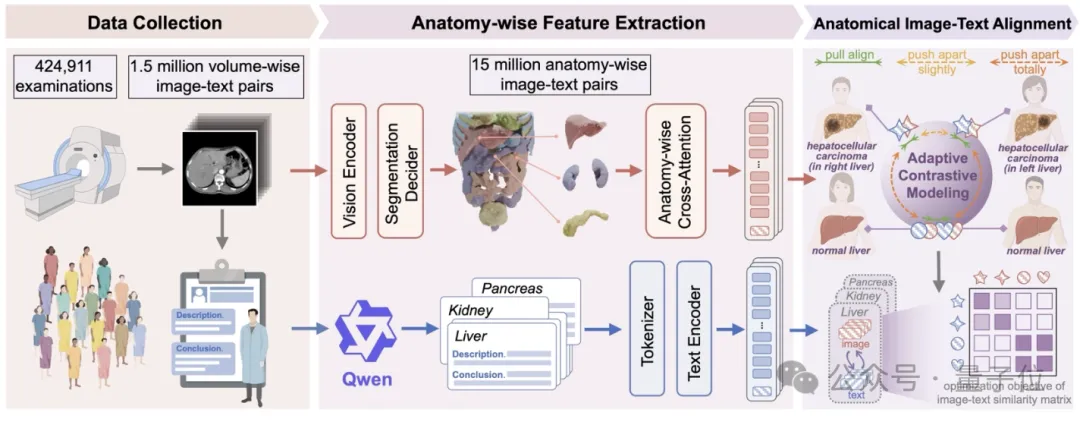
這一設計的靈感,來自放射科醫生的真實工作方式。
醫生看腹部CT時,也不會把整個腹部當一個整體掃一眼,TA們會依次看肝臟、胰腺、膽道、腎臟、腸道,一個器官一個器官地過。RADAR讓AI也按這種方式去學習。
另一個創新叫自適應對比建模。
標準的對比學習默認把不同病人的特徵嚴格區分,但在醫療場景裡,如果兩個人的肝臟都是健康的,就不應該被割裂看待。
同理,得了同一種病的兩個患者,影像特徵也應該被放在一起學習。
RADAR會根據這些醫學知識,動態調整樣本之間的距離。
而且論文裡展示的Scaling Law曲線顯示,隨著資料增長,模型性能還在持續上升,曲線沒有飽和的跡象。
幫醫生“少漏一個病灶”
Scaling Law曲線還在漲,但眼下RADAR夠到的能力,已經開始改變一線醫生的工作節奏了。
“第一次看到RADAR的驗證資料,我都不敢相信。”浙大一院放射科主任肖文波說,AI能在腹部這麼多相似結構裡一下子檢出146種病,AUC還有0.9上下,完全超乎醫生們的想像。
科室裡開始沸騰,很多醫生說:趕緊部署起來!很多外面醫院的醫生也聞訊前來,希望AI能幫助他們解決腹部CT這個頭疼的問題。
肖文波幹了三十多年影像,帶著300多人的科室,科室每天處理幾千份片子。
寫一份腹部CT報告,那怕中高年資的醫生,沒有20分鐘下不來,一例CT包括數百張圖像,挨個過。
這活兒她太清楚有多難了。
直到她發現RADAR接受了一次又一次驗證,精準率還是差不多之後,她才真的服了。
影像科有句話叫“同病異影、異病同影”,同一種疾病可以長成完全不同的樣子,不同的病又可能看起來一模一樣。
肖文波坦言,一個醫生可能要看幾十萬張片子才能把各種特徵都見過一遍,可能窮其一生也見不到如此多的病例。
這恰恰是RADAR最大的價值,它補上了人類醫生的盲區,能夠幫他們少漏一個病灶。
尤其在良惡性鑑別這種生死攸關的場景,醫生的壓力非常大;這時候有了AI,就相當於隨時有一個影像助手在手邊,在醫生猶豫的時候給一個補充性參考。
不過AI輔助也會帶來一些隱憂。
這說的倒不是精準率,畢竟即使用AI,最後也有真人在一旁把關。
這個問題關乎的是未來醫生群體的發展。
醫生培養講究影像邏輯思維,這種思維從理論到實踐反覆打磨,這個過程不能跳過。
年輕醫生用了AI,報告可能會達到主任級水平,一旦形成路徑依賴,反而把培養路徑截斷了。
但也不必過慮。
肖文波的想法,是讓RADAR同時變成“一對一帶教工具”。
她說現在科室300多人分佈在好幾個院區,過去那種老師坐旁邊一份一份帶著看的模式,已經很少了。
但AI可以替代這個角色,年輕醫生按常規寫完報告,再用AI做一次自我檢測,那個病灶漏了、那個判斷偏了,當場就知道。
就像隨時有個主任站在旁邊說,“哎,這還有一個病灶,你怎麼沒看見?”
這樣,每個病例都變成一次交叉驗證和學習的過程。
再往遠看,RADAR的器官級對齊框架,也適配其他影像模態,只要有相關資料,MRI、PET、超聲都可以成為遷移的目標。
而且這些東西,達摩院沒有藏著,模型、程式碼、技術框架已經全部開源,任何團隊都可以拿去復現、改進、遷移到自己的場景。
說到這裡,其實已經不只是一個醫療AI的故事了。
RADAR背後的思路,是用一個通用模型,去解決一整個領域的問題。
醫療是所有行業裡對精度要求最極端、對錯誤容忍度最低的場景,一個誤判就可能改變一個人的治療方案甚至生存期。
如果這套範式在這裡都能跑通,那換到其他高精度場景,大機率也能適用。
達摩院資深演算法專家張靈說,“Science極少發醫療影像AI的文章,因為它長期被當做工程技術問題。RADAR首次證明了通用的醫療影像AI是一條具有現實可行性的技術路線,改變了Science審稿人的想法,審稿人開始把它當作‘科學問題’來對待。”
RADAR能過這道門檻,說明這套方法經受住了最嚴格的同行評議。
回過頭看,從達摩院幾年前用PANDA模型攻克胰腺癌篩查難題,到今天RADAR登上Science,其實都是在求證AI到底能不能在最苛刻的真實場景裡真正頂上去。
今天Science給出的答案,不只是對一個模型的認可,也是對一種可能性的確認。
它證明,用通用AI去啃最硬的骨頭,這條路走得通。 (量子位)