
嘴閉上了,腿腳快得飛起!
AI 圈子裡最懂怎麼讓模型「開口聊天」的人,現在決定剝奪大模型的語言能力。
這位前 OpenAI 研究員、ChatGPT 的共同發明者 Diogo Almeida,在潛行兩年後帶著他的新公司 TypeSafe AI 和 4000 萬美元融資回到牌桌。他們發佈的全新模型 Jev,既不能寫打工人的周報,也不能陪使用者深夜長聊。它甚至連一個標點符號都吐不出來。
這是一個反常識的時刻。過去三年,全行業都在教大模型怎麼學會像人類一樣「慢思考」,各家實驗室拚命拉長推理鏈條,讓模型在給出答案前默默自言自語幾千個詞。
但 Jev 走了一條完全相反的路:它不做文字生成,只輸出確定性的結構化決策。
這不僅是一個新產品的發佈,更像是對當前大模型技術範式的一次公然叫板。
01 給 AI 裝上「反射神經」
要理解 Jev 到底是個什麼東西,得先看懂當下的 AI 開發者有多痛苦。
如今大部分工程師把大模型接入業務系統時,做的事情往往很荒謬。你明明只需要它回答「這封郵件是不是垃圾郵件」或者「在五個 API 介面裡選一個」,但你不得不讓一個擁有上千億參數的龐然大物,在漫長的幾秒鐘裡,一個詞一個詞地把一串 JSON 字元敲出來。
為了保證這串字元符合程式碼規範,開發者得寫滿整整兩頁提示詞,求著模型「不要輸出任何廢話,只要純 JSON 格式」。即便如此,模型偶爾還是會在前後加上一句「好的,這是你要的格式」,瞬間搞崩下游的整條流水線。
Jev 解決問題的方式極其粗暴。它根本就不是一個文字自回歸模型。
在 Kahneman 著名的《思考,快與慢》中,人類的思維被分為兩個系統。系統一是無意識的、極速的本能直覺;系統二是緩慢的、需要調動精力的邏輯推理。當下的主流大模型都在拚命卷系統二,而 Jev 給自己的定義是世界上第一個純粹的「系統一模型」(System One Model)。
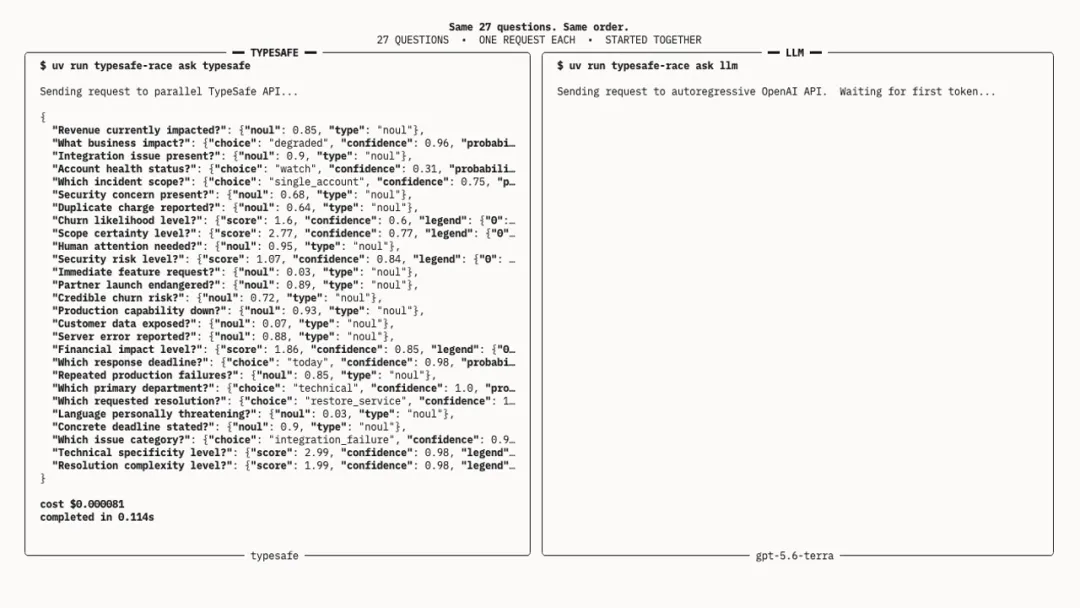
它不逐字生成內容,所有決策都在一次單向平行計算中同時產出。這意味著它沒有生成式的廢話,輸出永遠嚴格鎖定在開發者預先定義的 Schema 裡。
在數學層面上,Jev 徹底消滅了結構化輸出的格式幻覺。
由於不需要一步步推演下一個 token 是什麼,它的端到端延遲直接被壓縮到了 70 到 500 毫秒之間,比目前市面上的前沿大模型快了 40 到 200 倍。
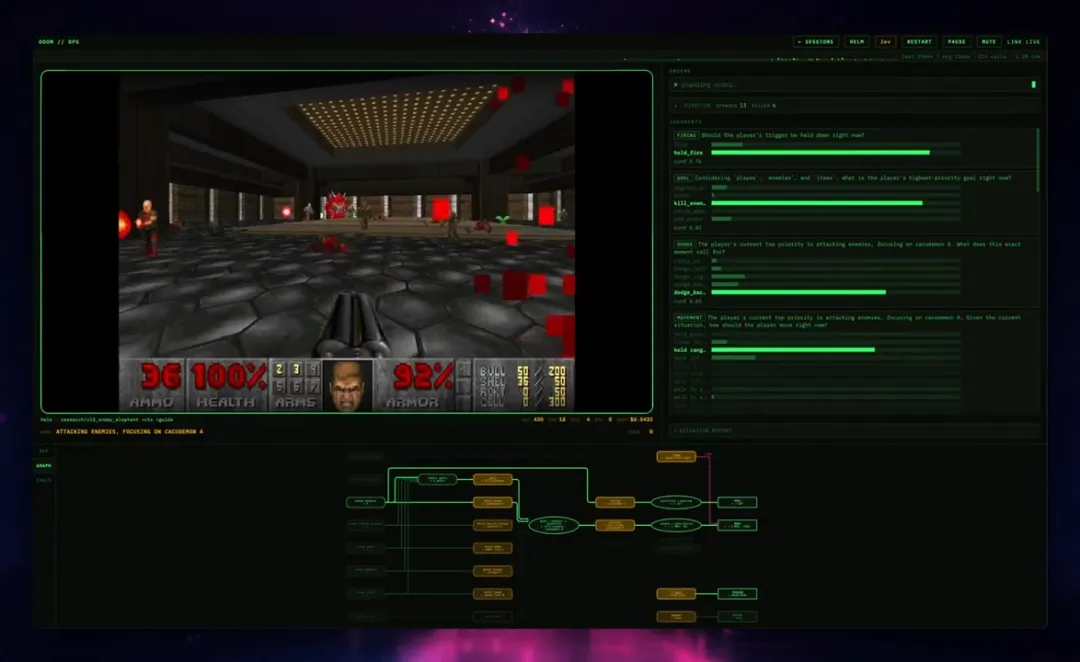
TypeSafe 甚至拿 Jev 去玩射擊遊戲 Doom。在不需要做複雜長線規劃、只需要每秒鐘做出約 10 次即時操作判斷的場景下,Jev 表現得像一個反應極快的人類玩家,而整套推理成本每小時大概只要 7 美元。
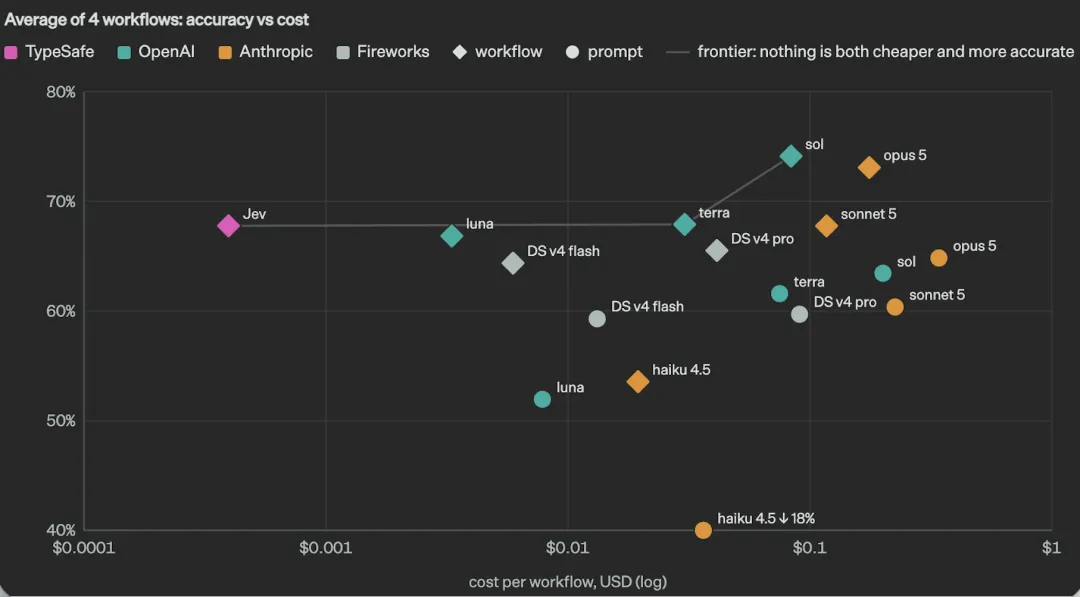
更誇張的是價格。Jev 的輸入成本是每 100 萬 token 僅需 0.042 美元,輸出則完全免費。平均算下來,單次結構化決策的成本大約是 0.0004 美元。作為對比,呼叫一次 GPT-5.6 Terra 的費用大概是它的 76 倍,而 Claude Opus 5 則是它的數百倍。
輸入非結構化資料,瞬間吐出帶有校準機率的分類選擇、數值評分或布林判斷,然後立刻交出控制權。這就是 Jev 的全部工作。
02 Agent 的瓶頸不是腦子太慢
為什麼 TypeSafe 會選擇在這個時間點,做一個完全不吐字的模型?
答案藏在正在全面鋪開的 AI Agent 裡。
無論是 Cursor、GitHub Copilot 還是矽谷各種企業級自動化工作流,工程師們很快發現了一個殘酷的現實:現在的 Agent 之所以又卡又貴,往往不是因為核心邏輯不夠聰明,而是因為中間的「執行摩擦」太大了。
一個完整的 Agent 任務通常包含幾十個微小的決定。比如判斷當前步驟是否成功、決定呼叫工具 A 還是工具 B、提取上一段輸出裡的關鍵欄位、判斷要不要終止流程。
如果每一個微小動作都要去呼叫一次千億參數的超級大模型,不僅延遲會層層累加到幾十秒甚至幾分鐘,成本也會迅速失控。更要命的是,只要其中任何一步的 JSON 格式解析失敗,整個 Agent 就會直接卡死在半路上。
行業被自回歸文字模型綁架得太久了,以至於大家幾乎默認了所有 AI 任務都必須通過自然語言去中轉。
但現實世界裡的生產系統,絕大多數節點本質上只是傳統的程式碼控制流。程式碼不需要情緒價值,程式碼不需要排比句,程式碼只需要一個極度廉價、極其迅速、絕對符合類型的決策訊號。
Jev 的出現,其實是在大模型的系統架構裡插進了一層「前置反射弧」。
在理想的協同架構裡,那些昂貴的前沿大模型應該退居幕後,充當統領全域的系統二,負責宏觀規劃和高難度思考。而在第一線負責處理髒活累活的,比如工單分類、內容合規初篩、大批次資料打標、乃至在幾十個 API 裡精準選擇呼叫那一個,完全可以交給 Jev 這樣的系統一模型去毫秒級搞定。
TypeSafe 給出的自有測試資料顯示,在四個典型的企業工作流中,Jev 的精準率達到了 67.8%,幾乎打平了 GPT-5.6 Terra 的 67.9%。如果只看判斷的精準度,它並沒有輸給比它貴數十倍的大模型,而執行速度卻拉開了幾十倍的差距。
把大腦皮層的慢思考與脊髓的條件反射拆開,這或許才是 AI Agent 能真正跑進大規模工業化落地的正確姿勢。
03 0 誤差背後的黑盒
不過,如果把 Jev 看作一顆完美的銀彈,顯然過早了。在這份驚豔的技術答卷背面,至少有兩塊巨大的陰影被刻意迴避了。
首先是可解釋性的全面喪失。
傳統的思維鏈模型雖然囉嗦且容易出錯,但它至少會把「為什麼這麼選」的過程寫在草稿紙上。當一個信貸稽核 Agent 拒絕了客戶的申請,或者安全系統攔截了一筆交易,合規部門可以通過推理過程去追溯模型的決策邏輯。
而 Jev 的輸出只有乾癟的選項和機率,它根本不具備用自然語言闡述理由的能力。當模型做出一個關鍵誤判時,沒有任何人能從它黑盒般的權重裡找出原因。在金融、醫療、法律這些強監管領域,這種缺乏審計能力的決策機制,往往會直接撞上合規的南牆。
其次是技術細節與評估基準的封閉。
TypeSafe 宣稱他們發明了一種名為 RLCD(基於校準決策的強化學習)的全新訓練方法,取代了傳統的 RLHF。但從目前公開的資訊來看,具體的獎勵函數怎麼設計、網路架構到底基於什麼、校準機率的數學方法論究竟為何,官方全都沒有披露。
更微妙的是那些漂亮的分數。目前所有的基準測試全部來自 TypeSafe 內部評估,沒有任何第三方獨立機構完成過復現。他們用來作為真值標準的參考答案,甚至是由 GPT-6 Astra 和 Claude Fable 5.1 跑出來取平均值得到的。用競爭對手的下一代模型來當裁判,再宣佈自己在性價比上大獲全勝,這種自證閉環本身就帶著強烈的公關色彩。
更不用說商業模式的可持續性。每 100 萬 token 僅收 4 美分,且輸出完全免費,這種價格低到了讓人懷疑是在燒 4000 萬美元融資打價格戰。
目前 Jev 依然處於小範圍邀請內測階段,當大量高並行的真實企業級流量湧入時,這套體系能否在保持超低延遲的同時維持收支平衡,還要畫上一個問號。
把模型做小、做快、做確定,確實擊中了當下的行業痛點。但在沒有真正接受真實業務環境裡極端情況的拷打之前,斷言它已經顛覆了範式,還為時尚早。
過去幾年,所有人都在驚嘆於 AI 越來越會說漂亮話。而現在終於有人意識到,在沉默的機器世界裡,行動往往比語言更重要。(極客公園)