
通過一整套晶片、光互聯、記憶體和軟體生態,把越來越大的AI計算系統進一步連接起來。
華為進一步攤開了AI算力的技術版圖。
9月17日,在華為全聯接大會2026上,華為副董事長、輪值董事長汪濤集中展示了面向AI基礎設施的新一輪技術進展:昇騰960研發進度提前,NPO光互聯產品Hi-ONE即將規模量產,採用NPO技術的昇騰960超節點正式發佈;同時圍繞計算、互聯、記憶體和管理,華為還首次完整展示了支撐超節點叢集的11顆關鍵晶片。
相比一年前強調“超節點+叢集”的算力路線,今年華為進一步將目標指向Agentic AI(智能體AI)。
智能體持續工作時間變長、上下文持續增長以及多智能體並行,使得AI基礎設施面對的不再只是NPU算力問題。CPU需要同時處理大量推理任務,記憶體系統要記憶體不斷擴大的KV快取,數千乃至數萬顆晶片之間還要進行高速通訊。AI基礎設施已經開始從單一晶片競爭,轉向計算、互聯、記憶體協同的系統工程。
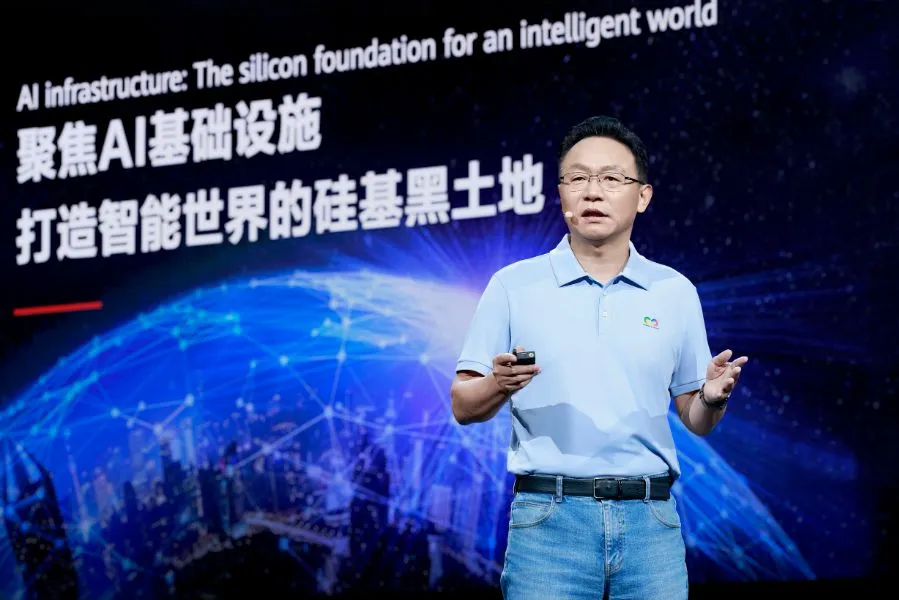
汪濤表示,華為AI戰略的核心仍是算力,將繼續圍繞“超節點+叢集”進行系統架構創新。截至目前,昇騰910C超節點已經部署超過1000套,昇騰950超節點開始規模商用。
如果說過去幾年華為試圖回答的是“如何在單晶片之外獲得更大的系統算力”,今年給出的進一步答案則是:通過一整套晶片、光互聯、記憶體和軟體生態,把越來越大的AI計算系統進一步連接起來。
11顆關鍵晶片組成算力“全家桶”
超大規模AI叢集越來越像一台複雜的電腦。
汪濤提到,目前兆參數級MoE模型持續迭代,10萬卡規模的算力叢集正在成為前沿模型訓練的重要基礎設施。但將10萬張AI加速卡放在一起,並不意味著10萬張卡的算力能夠簡單相加。
其中最大的損耗之一來自通訊。
根據華為測算,在由傳統八卡伺服器組成的10萬卡叢集中,模型訓練期間晶片之間通訊所消耗的時間可能超過全部訓練時間的40%,而衡量AI叢集有效算力的重要指標MFU(模型浮點算力利用率)每提升一個百分點,都可能縮短模型迭代周期。
在華為常務董事、ICT BG CEO楊超斌看來,AI基礎設施的瓶頸正轉向互聯。他表示,隨著模型參數增大、叢集規模擴大,一個典型MoE模型在10萬卡叢集上的MFU可能不到20%;與此同時,Prefill(預填充)、Decode(解碼)等階段的計算和訪存特徵開始分化,CPU和NPU之間的配比也隨不同場景發生變化。計算系統需要支援異構算力協同、記憶體池化和分級快取。
華為超節點的思路,是利用靈衢UnifiedBus統一連接系統中的不同元件,支援跨物理伺服器統一記憶體編址,使多個物理節點在邏輯上更接近“一台電腦”。
圍繞這一架構,華為此次進一步亮出了11顆關鍵晶片“全家桶”,包括鯤鵬CPU、昇騰NPU等計算晶片,面向Scale-Out(橫向擴展)的大容量交換晶片,面向Scale-Up(縱向擴展)的低時延交換晶片和高速光互聯晶片;記憶體側則包括介質控制晶片以及專門面向AI KV快取設計的Smart Storage Unit,此外還有承擔系統協調和管理功能的晶片。這11顆關鍵晶片共同支撐超節點和叢集,覆蓋計算、互聯、記憶體和管理等主要環節。
其中最核心的仍然是昇騰。
汪濤透露,昇騰960研發進展快於預期。其中,昇騰960DT支援2 PFLOPS FP8、4 PFLOPS FP4算力,最大支援288GB HBM,訪存頻寬達到9.6TB/s,計畫於2027年一季度準備就緒,比原計畫提前三個季度;昇騰960PR的FP4算力達到8 PFLOPS,計畫於2027年三季度準備就緒,比原計畫提前一個季度。
未來,華為仍會維持“一年一代”的昇騰晶片演進節奏,2028年、2029年陸續推出昇騰970和980。
這也意味著,在先進製造工藝受到限制的背景下,華為仍在延續此前的技術路線:一方面提升單顆晶片能力,另一方面通過互聯和系統架構,將更多晶片組成更大的計算系統,持續突破AI算力瓶頸。
NPO光互聯進入超節點
隨著超節點規模不斷擴大,另一個瓶頸開始出現:連線千顆NPU的銅纜正在逼近物理極限。
汪濤指出,當SerDes(序列器/解串器)速率達到224G以上後,銅纜的傳輸能力會快速下降;隨著NPU數量增加,傳統可插拔光模組也難以滿足系統對互聯密度的需求。
華為因此將光互聯進一步匯入算力基礎設施中,此次推出NPO(Near-Packaged Optics,近封裝光學)光互聯產品Hi-ONE,其核心思路與CPO類似,都是儘量縮短高速電訊號傳輸距離、儘早將電訊號轉換為光訊號,但不同之處在於,NPO沒有將光器件和電晶片完全封裝在一起,而是保留獨立光引擎。
華為稱,Hi-ONE是業界首個實現量產的NPO產品,單引擎傳輸容量達到7.2T。目前,它也是行業內唯一採用內建光源設計的NPO產品。
光互聯能力已經被用於華為新一代超節點。基於Hi-ONE,華為正式發佈昇騰960超節點,單個超節點最大支援4096張昇騰卡,可提供8 EFLOPS FP8算力以及最高1PB HBM容量。
根據華為測算,昇騰960超節點使用約5500個Hi-ONE模組,可以替代原方案約4.8萬個800G光模組,系統功耗降低超過550千瓦,無故障執行階段間提升一倍,可用度達到99.8%。
從技術路徑看,AI基礎設施競爭正在快速從晶片性能擴展到晶片互聯層面。
輝達持續以NVLink和NVSwitch推進Scale-Up,AMD、博通等廠商也在圍繞高速互聯展開佈局。對於華為而言,自研昇騰晶片只是其中一部分,靈衢、交換晶片以及NPO光互聯共同決定著數千張甚至數萬張卡能否真正形成一套高效率AI算力系統。
劍指Agentic AI
在華為看來,Agent興起還會進一步改變資料中心內部的計算結構。
傳統的大模型互動主要發生在人和模型之間,而多Agent系統需要頻繁建立沙箱(給每個Agent任務臨時建立的隔離運行環境)、搜尋長期記憶,並反覆呼叫模型,這讓過去主要圍繞GPU或NPU建設的AI基礎設施,同時面臨來自CPU、記憶體和記憶體的壓力。
例如,多Agent系統可能需要實現數十萬個沙箱的秒級啟動,並完成大量向量檢索,華為因此把超節點架構進一步擴展至通用計算。
升級後的鯤鵬超節點採用靈衢全光組網,最大支援4096個節點,並形成最高256TB的統一記憶體池。根據華為測試,在十萬級沙箱啟動場景中,其速度相比傳統伺服器方案提升30倍,沙箱密度提升25%;在百億級千維向量檢索場景下,系統吞吐最高達到30萬TPS。
記憶體同樣成為Agent時代的一大瓶頸。
隨著上下文從4K延伸至百萬Token,以及Agent與模型互動頻率持續增加,單張AI加速卡對應的KV快取容量可能達到TB級。僅依靠晶片上的HBM和伺服器DRAM已經難以承載,因此需要在叢集層面建設PB級KV快取。
華為此次推出OceanStor M900,通過靈衢讓算力卡可以直接訪問全域KV快取,相比傳統方案大幅降低資料搬運次數,並大幅提升性能。
最終,昇騰超節點、鯤鵬超節點、KV快取和網際網路絡被進一步組合成華為所稱的“Agentic超節點叢集”。
硬體之外,華為也在繼續補齊軟體生態。截至目前,CANN外部開發者佔比已經達到61%,社區月活開發者超過5200人;基於昇騰和CANN原生訓練的模型超過40個,CANN已覆蓋PyTorch、Triton、vLLM等90多個主流第三方框架及社區,適配超過200個開源大模型。
這也是華為近年來AI算力戰略的主線:AI算力的競爭,已經不只是單顆晶片之間的較量,當單顆晶片難以支撐大模型對規模算力的需求時,便轉向系統級創新——從晶片到超節點,再到萬卡、數十萬卡乃至百萬卡叢集,並進一步覆蓋CPU、記憶體、網路與軟體生態。 (21Tech)