
據路透社報導,美國國家檔案館營運的《聯邦公報》官網(Federal Register)被發現部署了基於阿里通義千問Qwen模型的AI搜尋功能,用於幫助使用者搜尋擬議中的聯邦法規。
《聯邦公報》官網是美國聯邦政府的“官方公告欄”,政府新出的法規、行政命令、部門通知都會先登在這上面。
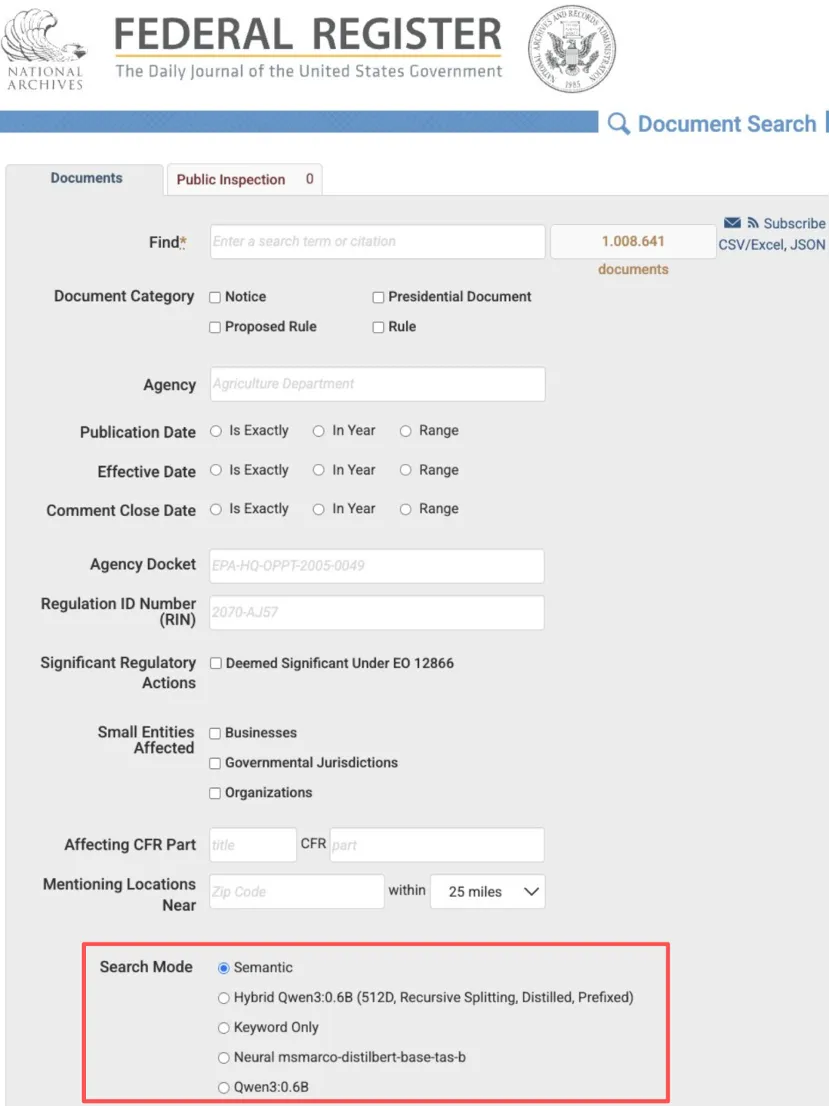
根據路透社查閱的截圖和該網站原始碼的存檔版本,使用千問模型的搜尋工具在16日被下線。目前,美國國家檔案和記錄管理局以及白宮均未公開解釋千問何時被部署、具體如何運行。
然而,就在此前,美國FBI等機構剛剛把矛頭指向包括阿里巴巴在內的中國AI公司,指責其對美開展“工業規模”蒸餾,獲取美前沿模型能力。中方則否認相關指控。
於是,出現了一個有些微妙的場面:美國政府一邊警告中國AI,一邊自己的官方網站卻悄悄用上了千問。
美國資訊技術與創新基金會主席丹尼爾·卡斯特羅(Daniel Castro)指出,一邊是中美之間圍繞先進AI模型展開競爭,一邊卻有美國政府機構選擇使用中國AI模型,兩者之間存在明顯矛盾。他甚至形容,這是自己見過“最不可思議的事情之一”。
不是美國AI不努力,而是中國模型更有“性價比”
千問是一款開放權重模型,這意味著該系統的關鍵組成部分可以公開獲取。開發者可以下載並修改這一模型,以滿足特定用途,而且其成本通常低於Anthropic和OpenAI等公司的閉源模型。
此外,此前《聯邦公報》官網的高級搜尋頁面顯示,其千問方案使用的是Qwen3 0.6B等級的小模型,而不是阿里最大的旗艦模型。它服務的也不是複雜推理,而是對大量政府法規檔案進行檢索。
一個只有數億參數的開放模型,可以下載到自己的伺服器運行,不需要每次查詢都向外部模型廠商支付API費用,也不必把政府資料傳送給第三方。模型越小,對GPU和伺服器的要求也越低。
這對大量美國政府網站尤其有吸引力。
很多機構需要的並不是最強的GPT或Claude,而只是文件分類、語義搜尋、摘要和內部知識檢索。如果一個小模型已經能完成80%甚至90%的任務,是否值得為了剩下的能力持續購買昂貴的大模型呼叫,就會變成一個很現實的工程和預算問題。
使用中國AI,不等於交出了敏感資料
這次《聯邦公報》使用千問,並不等於美國政府把敏感資料交給了阿里雲。
開放權重模型可以在組織自身的基礎設施上運行。安全專家表示,這使公司和機構能夠更好地控制敏感資料,避免資料被轉移到外部供應商。
AI專家表示,在《聯邦公報》網站上使用這款中國工具可能並未構成國家安全風險。《聯邦公報》網站每天發佈新提出的擬議法規清單,並提供千問模型作為瀏覽公眾評論的工具。
美國喬治城大學法學院教授阿努帕·錢德(Anupam Chander)表示,使用千問模型似乎不會立即構成網路安全風險。由於《聯邦公報》的內容已經是公開的,因此千問並未處理機密政府資訊。
中國AI模型出現在美國政府網站,真正值得關注的不是一次“烏龍”,而是中國開源模型已經發展到了一個讓傳統技術脫鉤政策開始變得模糊的位置。
如果一家美國機構把千問權重下載下來,部署在自己的伺服器上,不連接阿里巴巴,也不向中國傳輸資料,那麼它究竟算“中國服務”,還是一段來源於中國、但已經由美國機構自行控制的軟體?
這個問題正在變得越來越現實。
據ATOM報告資料,2024年1月,Qwen在新開源模型微調與適配中佔比僅1%,到2026年2月已飆升至69%,中國開源模型已成為美國創業公司技術堆疊中難以繞開的基礎元件。 (國是直通車)