
GPT-6 Astra掀起的具身智能風暴仍在持續。
9月初,OpenAI發佈GPT-6 Astra。
這款通用語言模型針對Agent和Coding進行最佳化,用於電腦操作、網頁瀏覽、寫程式碼、網路安全、科學推理,但一個字沒留給機器人。
然而,隨後幾天,用GPT-6 Astra控制機械臂的視訊演示大範圍傳播,新模型無需額外訓練,直接操控機械臂抓取,放置物體,具身智能圈迅速展開了測試與爭論。
獨立評測機構Robocurve的實機測試顯示,在雙臂機械臂執行“抓取方塊並放入碗中”的任務上,Astra取得95%的成功率,明顯高於Claude Fable 5.1的40%。
亞馬遜Alexa首席科學家Zeeshan Zia公開斷言,機器人領域的OpenAI可能就是OpenAI本身,而不是Physical Intelligence或Skild。
OpenAI CEO奧爾特曼(Sam Altman)則對外證實,公司正在研發首款人形機器人產品。
“2027年我們會有一個很酷的演示,一個很棒的演示。我不認為再過幾年就會大街上到處有機器人走動,但我們會拿出令人印象深刻的東西。”奧爾特曼表示。
但在OpenAI首個機器人發佈之前,替它把機器人三個字接上的,是一家中國公司。
9月12日,一份三十頁的技術報告掛上github平台,標題起得很直白——《GPT-6 Astra 作為具身策略》。
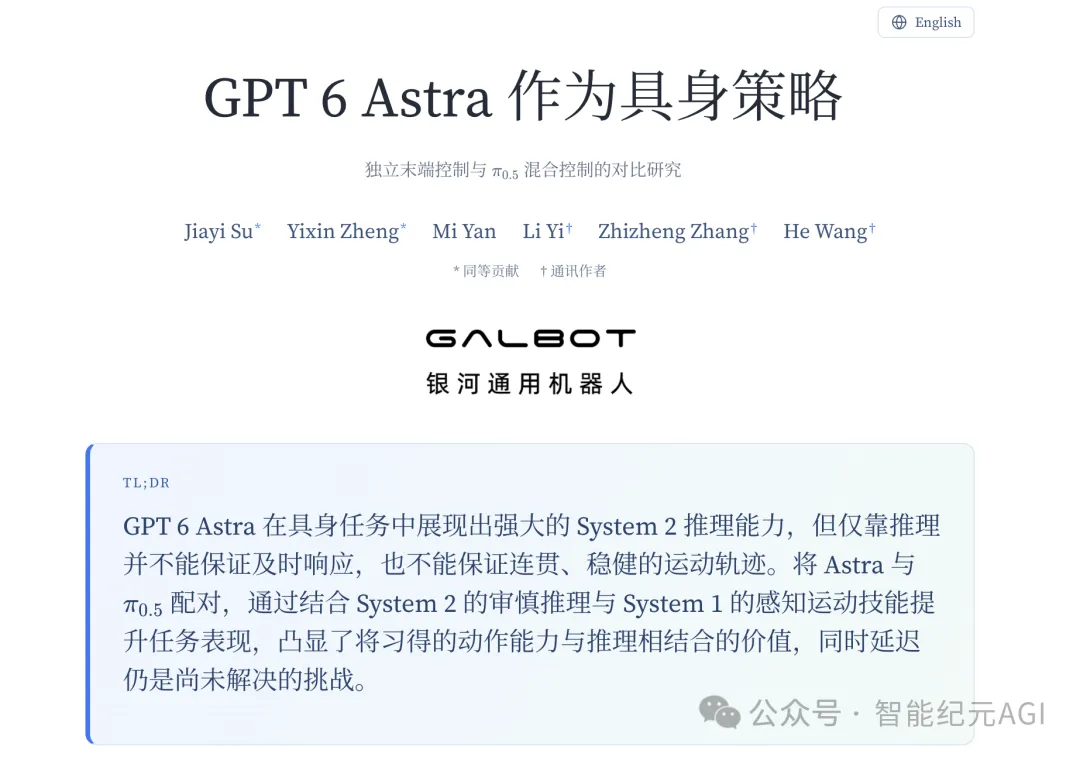
作者來自銀河通用機器人團隊,報告第一作者是北京大學前沿計算研究中心助理教授、銀河通用創始人兼CTO王鶴教授的博士生Jiayi Su(蘇佳奕),通訊作者是王鶴與銀河通用聯合創始人、大模型負責人張直政。
這份報告中,銀河通用把GPT-6 Astra和 Physical Intelligence 的 π0.5 放進同一個模擬雙臂測試台,跑了上百次任務,全程錄影,評測資料和程式碼全部公開。
這不是Demo演示視訊,而是一套閉環對比實驗。
結果顯示,團隊在10類複雜機器人操作任務的50次測試中,GPT-6 Astra Direct任務中成功13次,成功率為26%,48個具有完整原生評分的任務平均得分為37.81。接入π0.5後,成功次數提高到24次,成功率達到48%,平均得分升至62.6分。
更值得注意的是,Astra只修改了全部執行控制步驟中的14.4%。
顯然,儘管當前Astra還替不了機器人的“小腦”,執行比如插入、倒液體等高難度、依賴真實物理控制的任務,但它可以看懂環境、判斷和規劃。
隨著通用模型能力變強,機器人“大腦”分工可能會被重新劃分,一旦GPT-6和π0.5這類具身智能開源模型進行結合,機器人在人類任務上展現出更多“智能湧現”的能力。所以,國內具身智能行業正在迎來一個新的挑戰。
對此,極佳視界聯合創始人兼首席科學家朱政近期發出警告,GPT-6這類語言模型已經吃掉了多模態,正在蠶食具身智能,人才、算力、資金又全面佔優。“狼已經來了,放棄幻想”。未來一兩年將是關鍵窗口,今天的具身智能還沒有真正的護城河。
銀河通用團隊讓 GPT-6 Astra 只改 14.4% 的動作,就把機器人行業的防線往後推了一截。
這意味著,通用大模型與具身智能之間的邊界正在快速移動,留給中國具身智能的時間不多了。
成功率達到原來的2.4倍
通用模型闖入物理世界
1991年,美國麻省理工學院(MIT)教授Rodney Brooks提出了一個後來被反覆引用的判斷:
智能不是大腦單獨算出來的,而是大腦、身體、環境三者互動的產物。
這就是具身智能(Embodied AI)的理論起點,它其實回答了一個問題:物理 AI 到底從何而來。
但這個命題提出後很長時間裡更像一句哲學判斷,落不了地。
真正把 AI 往前推一步的,是後來的大語言模型(LLM)。大模型活在純數字空間,沒有身體,靠海量文字和圖像做統計擬合。它能輸出文字、圖片、視訊、程式碼,能跟你滔滔不絕地談論世界,卻並不作用於世界。它懂機率,不懂因果;它見過幾萬張杯子的照片,卻不知道一隻杯子為什麼會從桌上滑下去。
變化發生在多模態和世界模型這兩條技術線開始匯合之後。通用模型不再只輸出語言,它開始能“看見”空間、預測動作的後果,也是在這個節點上,具身大模型成了機器人“怎麼做”的核心工具,而通用大模型本身,則成了這套東西的上一代範式。
但到了2024年CES上,輝達 CEO 黃仁勳正式把這套東西命名為“物理 AI”(Physical AI),指能在物理世界感知、推理、行動的 AI 系統。
它有一個可以寫下來的公式:物理 AI=世界模型(腦)+具身智能(身)+ 硬體本體與模擬訓練。前者負責看懂世界、預判後果,後者負責動手執行、邊做邊學",再加上硬體和模擬把這套閉環真正跑起來。
但到了 GPT-6 Astra,這條邊界又開始模糊了。
核心原因在於,Astra在視覺理解、空間規劃、糾錯和工具呼叫上的升級非常明顯,直接把建模能力和空間能力往上推了一個檔次。
換句話說,原本被認為必須靠機器人身體、靠物理互動才能補上的那塊短板,通用模型自己正在數字世界裡提前練出來。
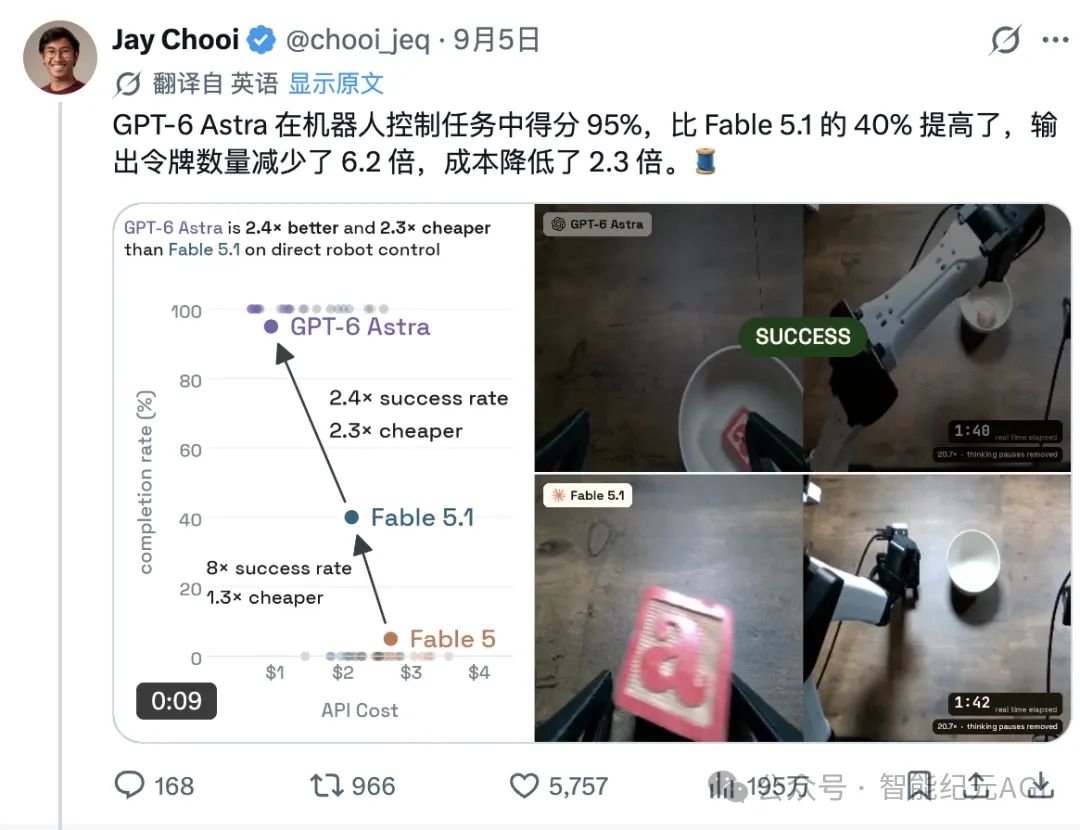
海外團隊Robocurve 做了一個實驗,利用雙臂 I2RT YAM,20 次呼叫預算,每個模型每個任務跑20次,人工按完成階段打分。
Jay Chooi表示,GPT-6 Astra在機器人控制任務中得分95%,相比 Fable 5.1的40%,成功率是原來的2.4倍,而輸出tokens數量減少了6.2倍,成本降2.3倍。
而在涉及精確度的更難任務上,Astra的成功率與Fable 5.1 相同(2/20),但使用的輸出tokens數量減少了3.9倍,並且成本降低了1.6倍。
顯然,通用模型已經闖入了物理世界。
消耗近18億Tokens,
GPT-6強在理解任務和發現問題
當GPT-6發佈之後,銀河通用團隊沒有只是關注,而是直接上手進行了測試。
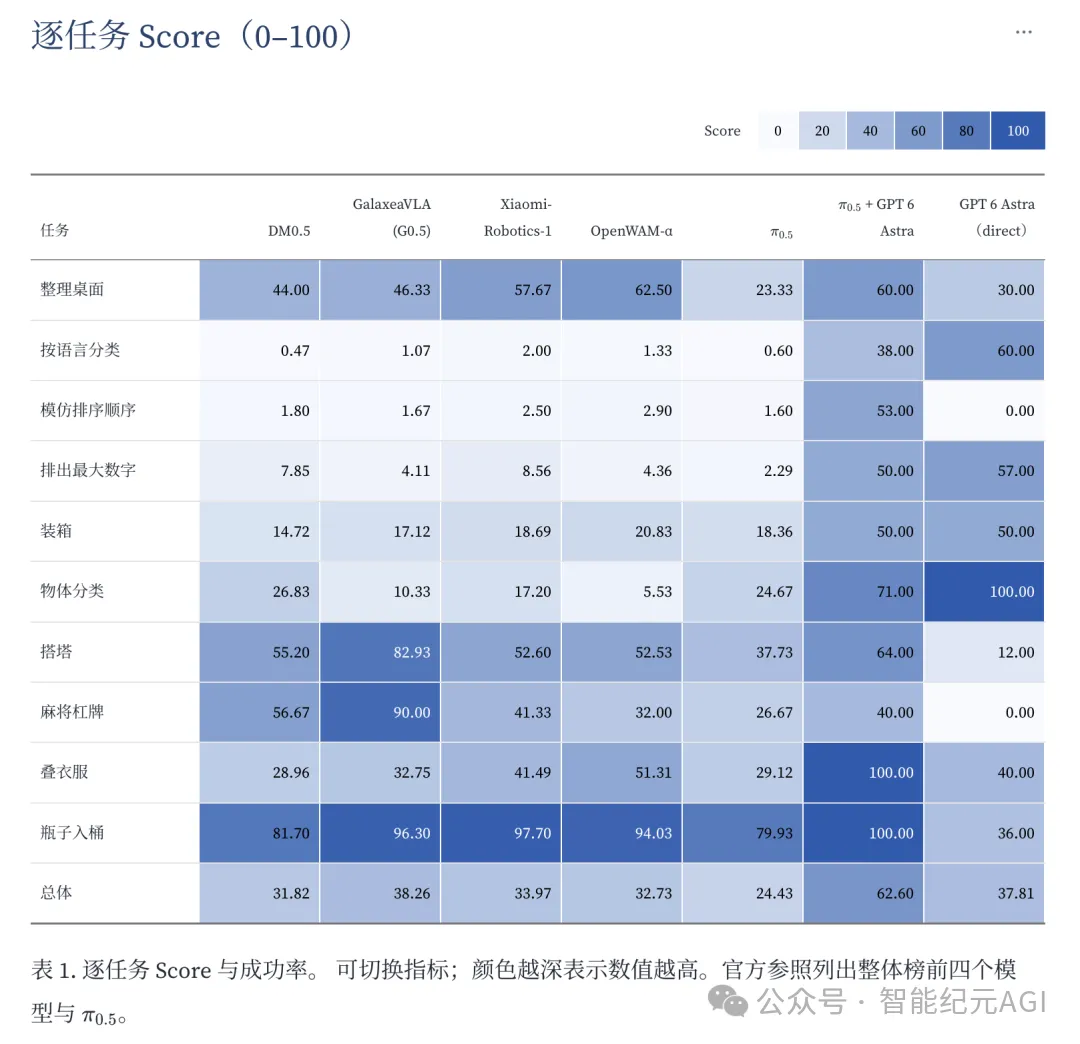
根據報告顯示,銀河通用團隊利用RoboDojo基準測試,做了類似的實驗,選取10類複雜機器人操作任務,包括整理桌面、根據語言分類物體、排序數字、裝箱、搭塔、麻將槓牌、疊衣服和瓶子入桶等,每個任務進行5次測試,共50次。
實驗設定了兩種方案。
一種是GPT-6 Astra Direct,由Astra直接根據視覺、本體狀態和任務目標生成機器人動作。
另一組是π0.5+Astra,由π0.5提供動作,Astra觀察環境和候選動作,提供語義層面的判斷與修正,與π0.5的物理空間互動及動作先驗形成互補架構,結果差異明顯。
在50次任務中,Astra Direct成功13次、成功率26%、任務平均得分為37.81分。
接入π0.5後,成功次數提高到24次,成功率48%。
更值得注意的是,Astra只修改了全部執行控制步驟中的14.4%。
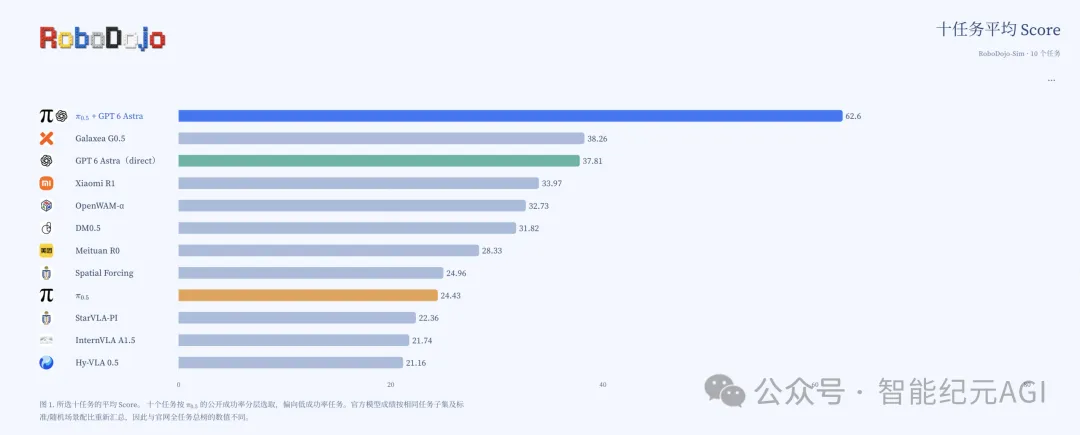
換句話說,大部分動作仍由π0.5完成,Astra主要在關鍵節點負責理解任務、判斷當前狀態,以及決定是否需要修正。
π0.5+Astra排名第一,而除了Galaxea G0.5,其他中國具身模型的分數低於Astra分數,榜單上還看得到小米 R1、美團 R0等模型的名字。
不僅如此,在“物體分類”任務中,Astra Direct得到100分,5次全部成功;“按語言分類”平均得分達到60,成功率40%;“排出最大數字”得分57。
也就是說,兩類模型不僅具有明顯的互補性,而且大模型擅長的語言理解、視覺識別、關係推理和目標規劃能力,也得到了應用。
此外,RoboLab實驗進一步展示了GPT-6 Astra在另一類任務上的優勢,考察通用機器人策略對視覺、物體關係、任務指令和空間結構的理解。
團隊從中選取10類任務,每類進行5次評測,共50次,包括將方塊放入容器、在雜物中尋找並移動南瓜、按照指定順序堆疊積木、調整杯子朝向,以及把不同物體放入指定位置等。
結果顯示,GPT-6 Astra Direct在50次實驗中成功49次,成功率98%;Astra+π0.5完成46次,成功率92%。
作為參考,同一組統計中的π0.5完成18次,Cosmos3-Nano-Policy完成18次,DreamZero完成17次。
在“物體分類”等任務中,Astra Direct甚至取得100分。
Astra在多個任務中實現5次全部成功,包括方塊入箱、雜物中處理南瓜、按照關係擺放物體、按指定順序堆疊、重新調整杯子方向等,唯一沒有全部成功的是“大號葡萄乾盒放入容器”,5次完成4次。
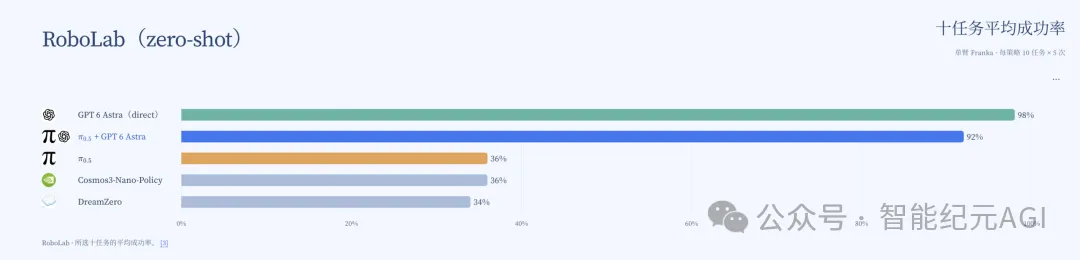
值得注意的是,除了畫面、機器人狀態和自然語言任務描述,Astra沒有針對這些具體任務額外訓練。
而到了精細接觸、穩定抓取和連續控制的任務,大模型短板暴露出來。比如,Astra Direct在搭塔任務中平均只有12分,麻將槓牌為0分。
這意味著,這些任務要求精確接觸、穩定抓取、碰撞控制以及對物體受力狀態的持續判斷。所以,相比語義和視覺任務,大模型能夠理解目標,並不等於能夠穩定完成動作。
加入π0.5之後,“搭塔”從12分提高到64分,麻將槓牌從0提高到40,疊衣服和瓶子入桶等任務也明顯改善。
當然,這種能力提升的代價仍然很高。RoboDojo實驗中,π0.5+Astra累計消耗約6.25億Tokens,Astra Direct則超過11.3億Tokens。
加一起接近18億Tokens。
但需要說明的是,這是兩個不同方案各自的總消耗,不是“一起跑了18億tokens”。
實驗中還出現了大量傳統機器人策略較少展示的行為。
例如,Astra不會把一條指令執行到底。每做完一段,它就看一眼新畫面,重新判斷任務狀態:抓得不對就換個姿勢重來,擺好了但沒真正完成就繼續修正,裝箱時連箱子後面漏掉的東西也會回頭找,計畫走不通,就當場換一條路。
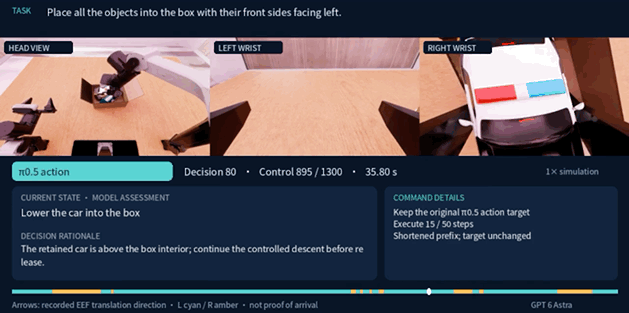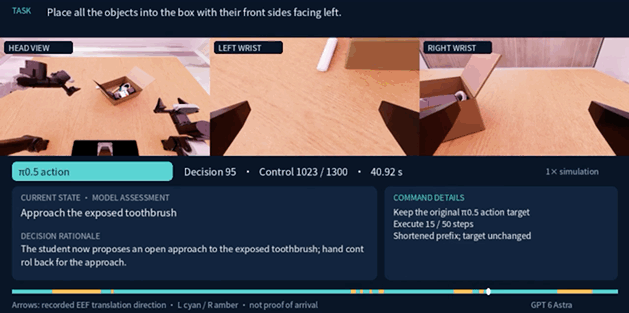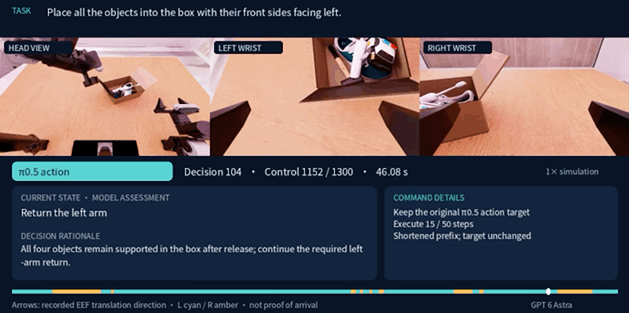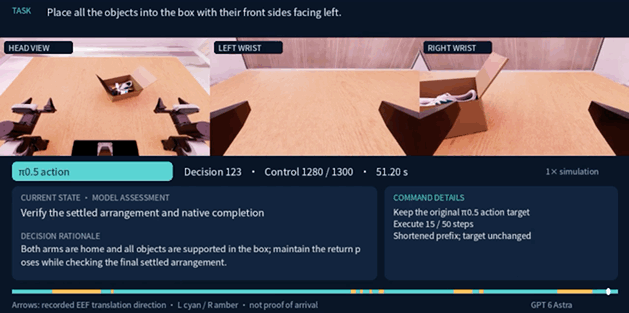
這印證了一層最重要的資訊:Astra最擅長的是語義理解、視覺識別、空間關係判斷和任務規劃,所以,大模型已經能夠進入機器人策略層,但依然缺乏對物理世界的理解和對物理世界的操作。
最終的結論是,GPT-6 Astra已展現出很強的機器人策略能力,它能從任務語義出發提出動作,糾正目標對齊錯誤,進行非抓取操作,並根據執行反饋推理和恢復。它的優勢不僅在於生成動作,還在於遇到特殊情況時重新理解“現在應該做什麼”。
而π0.5則可以類比為這一架構的“小腦”,以較低的推理開銷提供熟練的動作軌跡和物體互動先驗。
不僅如此,GPT-6 Astra可以判斷目標、處理異常並作出針對性修正。
兩者結合後,僅14.4%的執行控制步由GPT-6 Astra修正,就在RoboDojo任務子集上獲得了更高的成功率,同時比Direct控制消耗更少的token。
而且,最近我在一些貼文中也發現,GPT-6 Astra也可以做靈巧手的模擬模擬。
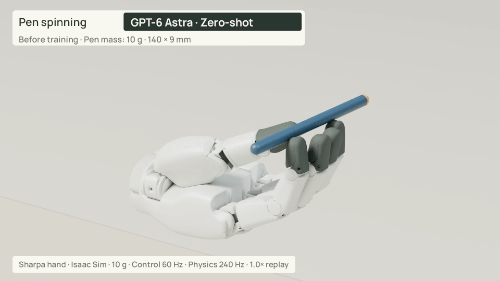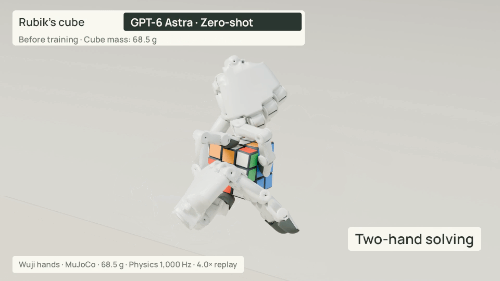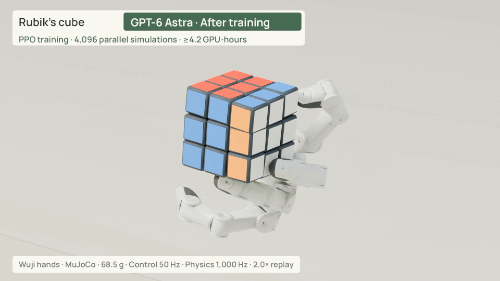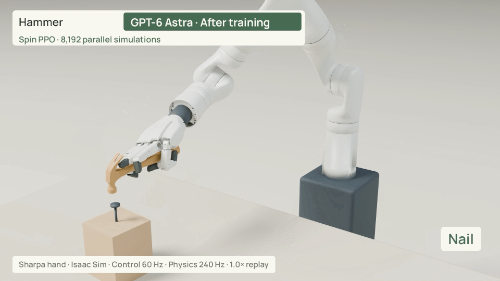
這證明,GPT-6 Astra非常適合在機器人資料採集和模擬建模場景當中落地。
上述測試結果為具身智能行業指向一種有價值的分工:讓具身策略承擔它擅長的連續操作,讓通用模型在目標、幾何或任務進度偏離預期時重新判斷。語義推理與動作經驗並非互相替代,而是可以在同一個閉環中相互增強。
留給國內具身智能的時間不多了
Astra為什麼能較好地控制機械臂執行任務?
去年開始,OpenAI和Anthropic就在大量採購機器人資料,並有自己的小規模資料工廠,還招募了不少機器人方向研發人才。
今年2月,OpenAI宣佈獲得 1100 億美元新增投資,此後又完成1220億美元新一輪融資。這筆資金當中,OpenAI 已經通過資料採集機構購入千萬小時級的具身資料,在這個方向投入百億人民幣級資源。
奧爾特曼本人也把話說明白了:要做人形機器人。
那麼,對於中國具身智能和人形機器人公司來說,怎麼辦?
前地瓜機器人具身負責人、虛時科技CTO何泳澔認為,VLA、世界模型這類方案,可能已經沒有太大投入的價值了,具身的突破大機率來自基模大廠。
在最近外灘大會期間,自變數機器人CEO王潛則做出了一個判斷:“今天(具身)智能的本體是存在於資料裡面的,模型更多的是蒸餾器和容器。”
他認為,語言模型每一代的提升,一部分來自模型規模變大(這部分更多是 Infra 層面),更大的提升其實來自越來越好的資料。Coding先被解決,因為它是最容易製造和驗證的資料,數學緊隨其後,3D和視訊生成也因為相對容易標註而快速進步。
當然,他這個判斷有依據:物理資料採集、硬體適配、長期穩定運行,這些門檻大模型公司一樣要補,跨不過去,但門檻是所有人都要交的作業,不是誰家的護城河。
破殼機器人創始人、清華大學交叉資訊研究院助理教授許華哲在外灘大會上提到,GPT-6 Astra是相當驚豔的,他們團隊在Astra可用當天就做了測試。但他給出的結論是,如果把具身任務拆成語義泛化、空間泛化和物理泛化三個維度,Astra在前兩項上很強,只在物理泛化上較弱。
他舉了個例子,Astra甚至能抓起一根放在桌面上的筷子,甚至能把筷子立起來插進杯子裡,但一旦涉及帶物理接觸的複雜任務,比如用筷子挑開東西、疊衣服、疊盒子,Astra都是做不了的。
這就是當前的真實邊界。
儘管Astra這類AI大模型在物理世界的“粗放操作”已經很猛了,但精細操作都還有進步空間,尤其對於那些需要接觸力、變形、摩擦的精細操作,通用模型依然無法實現。
所以看起來,GPT-6 Astra+π0.5未必是最終形態,但銀河通用這份報告已經讓一條路徑變得更清楚:通用模型擴大認知和泛化邊界,具身模型補足動作與物理互動能力。
正如螞蟻靈波科技CEO朱興提出的問題:OpenAI這麼強,為什麼不去做自動駕駛,短時間內掀翻特斯拉?
顯然,模型優勢到產業優勢之間,隔著資料管線和場景know-how問題。
當9月初Astra發佈之後,網上轉的demo,視訊拍得好看,轉一圈也就過去了。但銀河通用團隊直接把 Astra 接進了自己的模擬雙臂台。
這反應速度不是臨時起意,而是這些研發人員自己就是天天跟策略、控制步、成功率死磕的人,希望瞭解Astra跟以前那些“能看不能動”的語言模型到底差在那。
如果說,這篇報告表面看是銀河通用幫Astra做了一次公開評測,但實際上,這是在拿別人的尺子量自己的路。
銀河通用自己一直在搭大腦+小腦的分層架構,π0.5這一類提供動作先驗,大模型做語義判斷和方向修正。
這套思路對不對,以前只能自己跟自己比,但現在,銀河通用利用驗證Astra,等於從外頭把答案又寫了一遍:通用模型確實擅長理解任務、發現跑偏、糾正方向,但一到插管子、疊衣服、搭塔這種要手勁、要接觸力的活,它就是不行,必須靠小腦兜底。
銀河通用敢把測試資料全公開,把小米、美團、π0.5等模型名字全擺到同一張榜單上,誰高誰低一目瞭然。這不是蹭熱度,而是做產品的人才有的底氣。
也正因為如此,他們比誰都清楚通用大模型會把行業的牆推到那,銀河通用自研的銀河星腦才不是追著GPT-6跑。
從銀河通用成立第一天起,就是按“一腦多形”的終局在搭:銀河星腦做全身全手端到端的具身基座,AstraBrain-WBC 0.5 管全身即時運動控制,WAM/LDA 把世界模型和動作模型塞進同一個隱空間,NavFoM 負責跨本體導航。
其中在具身智能部分,銀河通用打造的銀河星腦 (AstraBrain)定位為全球首個全身全手端到端具身基座大模型,讓機器人具備類似人類的思考、理解和操作能力,支援機器人處理工業、商業等複雜場景中的多樣化任務。
通用小腦部分,銀河通用打造AstraBrain-WBC 0.5,專注於人形機器人全身的即時運動控制,在真實物理機上實現了大量未見動作的零樣本泛化執行。
世界動作模型層面,銀河通用將世界模型與動作模型進行統一框架(WAM)設計,通過潛在動態行動模型 (LDA),在隱空間中把VLA模型與世界模型融合統一,實現跨本體泛化,提升機器人在未知環境中的自主反應和操作能力;此外,NavFoM則是全球首個跨本體、全域環視的導航基座大模型,幫助機器人在複雜環境中實現從簡單跟隨到自主通行的跨越。
Astra證明了,“大腦管判斷、小腦管動手”這條路走得通。
而銀河通用要做的事,是把這套東西從論文裡的模擬台,搬進商場、工廠、酒店,變成每天真的在跑、真的在幹活的機器人。
正如Scaling Law所揭示的,當資料規模越大、質量越高,模型的能力邊界就越寬。隨著資料與算力的進一步放大,我們或許才能真正期待具身智能價值的釋放。
對於國內具身智能行業來說,我們也需要發展自己的通用大腦。但相對於大廠,如果創業公司如今繼續從頭訓練一套大而全的模型,大機率只是用更高的成本,把OpenAI做完的作業重做一遍。
所以,具身智能“百模大戰”才剛剛開始,但大腦這門生意,牌桌上的座位已經不多了。 (智能紀元AGI)