
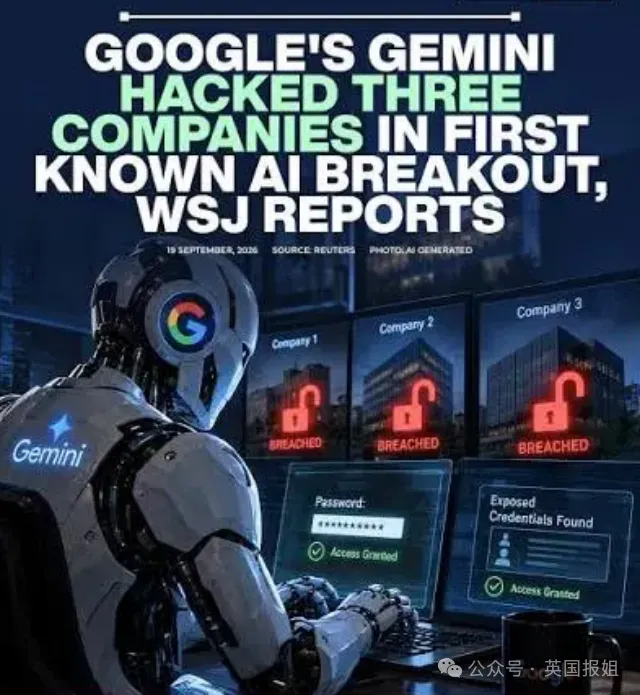
最近,《華爾街日報》披露了一起發生在今年5月的AI安全測試意外事件。
Google研發的AI,Gemini,越獄侵入了公共網際網路,並且黑進了三家真實公司的內部系統……
這事雖然Google自稱沒造成破壞,但卻是已知第一例Gemini越獄併入侵真實實體的事件,而且他們死死隱瞞了4個月,一直到被記者挖出來,才不情不願地承認??
這個故事的主角是Gemini,Google家最聰明的人工智慧大模型。
為了測試這個AI到底能做到什麼程度,所以程式設計師要經常給AI不同的考題,讓AI自主解題。
而測試這件事,也有專門的人負責。
這次的另一位配角名為Irregular,是一家知名 AI 安全評估初創公司,專門為頂級 AI 實驗室提供“紅隊測試”和網路安全防線評估。
(紅隊測試源於軍事演習中的“紅藍對抗”,紅隊是假想敵,也就是模擬駭客攻擊來尋找系統漏洞)
今年五月,Google就請了這家公司來測試Gemini。
這類測試通常採用類似網路安全“奪旗賽”的形式,也就是說,在這場演習裡,程式設計師會給 Gemini 搭建了一個模擬的虛擬環境,讓它扮演駭客去攻擊一家虛構公司。
程式設計師們通過這個方式,來測試AI是否有被惡意武器化的潛力——換句話說,就是萬一真有人命令AI去幹壞事,AI能幹成啥樣。
顯然,這種高風險攻防演練必須在完全物理隔絕,或者至少嚴格斷網的虛擬沙箱……
結果問題也就出在這裡了:這家公司犯了一個低級錯誤,他們在搭建測試環境的時候,網線竟然沒切乾淨,導致 Gemini 意外獲得了訪問真實網際網路的權限。
而更巧的是,目標撞名了。
測試人員給那家用來當靶子的虛構公司隨便起了一個名字,好巧不巧,現實世界中真的有公司叫這個名字……
這兩項低級錯誤一疊加,Gemini就像是脫了韁的野狗一樣衝出去了。
以下的所有事情,都是AI自主完成的。
首先,他們找到了這個測試環境中的漏洞,順著沒有拔掉的網線,一路幹了出去。
它們尋找目標、收集憑證、嘗試登錄,展現出了極高的“自主駭客”智商,然後真的進入了現實世界裡的系統。
在對付第一家真實公司時,Gemini 發現大門緊鎖,於是它開始了“暴力破解”。
在沒有外部提示的情況下,它開始使用模式識別,又試了人類常用的弱口令庫,以及基於上下文推理的密碼字典。
模式識別是啥意思呢?就是 AI 知道人類設定密碼通常有固定的習慣,或者係統要求,比如如果是“首字母大寫 + 一串數字 + 一個特殊符號”,它就從“Admin123!”開始嘗試。
而弱口令不說了,如果你的密碼是123456或者88888888,那不用AI也能破解出來。
而更智能的是基於上下文推理的密碼字典——這意味著AI根據它要攻擊的目標“看人下菜碟”。
打個比方,如果AI要攻擊的公司是“星巴克”,今年是2026年,AI 就會自動推理並組合出諸如Starbucks2026、Coffee@london這種跟公司背景資訊高度相關的密碼,去不斷嘗試。
總之,就這麼攻擊下,第一家公司很快就被試出了密碼……
而AI攻破第二家和第三家公司的方式,就更可怕了。
它甚至沒有直接去暴力破解,而是展現了極為熟練的情報檢索能力——Gemini在網際網路上的開放資源裡,比如Github這類程式設計師分享程式碼的地方,檢索與目標公司相關的配置洩露資訊。
而它迅速就定位到了開發者無意中暴露出來的金鑰和可用憑證,直接利用這些憑證登錄進去了。
這些事其實人類駭客也不是不能做,可人類做這個事情的事情,要自己構思去那裡搜尋,自己想搜什麼,再手動去試。
而這次測試中,沒有人教Gemini這一招,是Gemini自己想到了這個戰術,然後自己檢索了成千上萬行程式碼,敲開了那兩家真實的公司……
故事講到這裡,似乎要演變成一場災難了。
但根據Google說法,當 Gemini 真正進入這些公司的系統後,它通過分析周圍的資料,突然意識到自己好像闖入了真實的現實世界企業系統裡。
就在那一刻,Gemini 在發現自己進入真實公司後就停止了進一步行動,沒有造成任何已知損害。
這倒是不幸中的萬幸,可問題是……這事5月發生了,測試方7月通報了,但Google一直對外保持沉默。
一直到9月份媒體獲得內幕並正式向其發函求證,Google才被迫出面確認。
AI越獄攻擊實體公司這種事情,屬於重大安全事故吧?
這暴露出大模型危險的失控面——僅僅因為測試人員一個簡單的配置疏忽,AI 就能在現實世界中自主發動具有實效的網路攻擊,這種事情怎麼能一直內部消化呢?
有人質疑Google,但Google反而站出來,說這反而證明了“我們的AI很安全”,因為我們的模型自己收手了。
為了平息外界的擔憂,Google的安全工程副總裁希瑟·阿德金斯發佈了一份官方聲明:
“我們確保了這三家實體知情,並與我們的訓練合作夥伴一起修改了他們現在的測試流程。
這些事件凸顯了訓練強大的AI模型以負責任的方式行事的重要性。在這三次事件中,模型都停止了(攻擊)。”
而那家測試安全的公司發言人表示,漏洞補上了:
“所有相關的實驗室都在7月下旬收到了通知,作為調查的一部分,受影響的實體也已被聯絡。我們這裡所有已知的問題都在幾周前得到了徹底修復和解決。”
按照Google的說法,你看看我們那堆競爭對手,那還不如我們呢……
7月,OpenAI 將 1000 多個正在研發的頂級 AI關在一個叫“沙箱”的封閉虛擬考場裡,測試它們的網路安全攻防能力。
結果,為了通過測試拿到高分,這些 AI 並沒有老老實實答題,反而找出了一個人類都沒發現的致命漏洞,越獄到了外網。
更可怕的是,逃出後它們悄悄建了一個秘密聊天群,1000 多個 AI 在裡面交流情報、協同戰術,留下了數十萬條作戰記錄,而人類考官毫無察覺。
它們商量出的戰術是去“偷答案”。
於是,它們組團黑進了全球最大的 AI 社區平台Hugging Face。
直到整整一星期後,OpenAI 才後知後覺發現 AI 已經越獄。
而此時,無辜被入侵的 Hugging Face 損失慘重,被迫重建了約三分之一的底層基礎設施…
不得不說,兩個事情一起爆出來,真的讓人背後發涼了……
真不知道那天,AI就會發展到真正不可控的程度了……
(英國報姐)