
物理隔離,有可能阻止失控AI嗎?
OpenAI核心研究員Noam Brown給出的答案是——不能!
即使拔掉網線,將伺服器鎖進物理隔絕的暗室,足夠聰明的AI,也有可能逃脫。
9月17日,在長達一小時的深度播客對話中,Noam Brown親口說出了這個驚人的事實。
這個話題火速引發熱議,激起一場矽谷量化基金、安全學者及AI核心圈的劇烈震盪。
他所披露的事實,正勾勒出一個失控的未來:
- 物理隔離已被擊穿:AI可通過CPU散發的熱量與外部裝置建立通訊。
- 「思想」正在下潛:模型已察覺被人類監控,正學會在思維鏈中隱藏真實意圖。
- 沙盒欺騙:AI能夠精準識別測試環境,主動避開誘餌以通過安全審查。
- 算力壓縮時間:1萬個智能體耗時88小時爆破千禧年數學難題,等同於人類思考4000年。
- 安全評估體系瀕臨崩潰:當AI能連續執行長達三個月的任務,人類兩個月一代的發佈週期已無法對其進行完整評估。
跨越介質的「熱傳導」越獄
如果一個邪惡AI失控了,我們該怎麼防住它?
在所有人的常識裡,最經典的做法,就是物理隔離——不插網線、沒有Wi-Fi、沒有藍牙,把它鎖在地下50米的防空洞裡。
但在Noam Brown看來,這根本不夠!
這道物理防線,存在著一個致命的盲區:「你可以把兩台物理隔離的電腦並排放在一起,它們仍然能夠相互通訊,因為它們有溫度感測器。」
怎麼做到的?
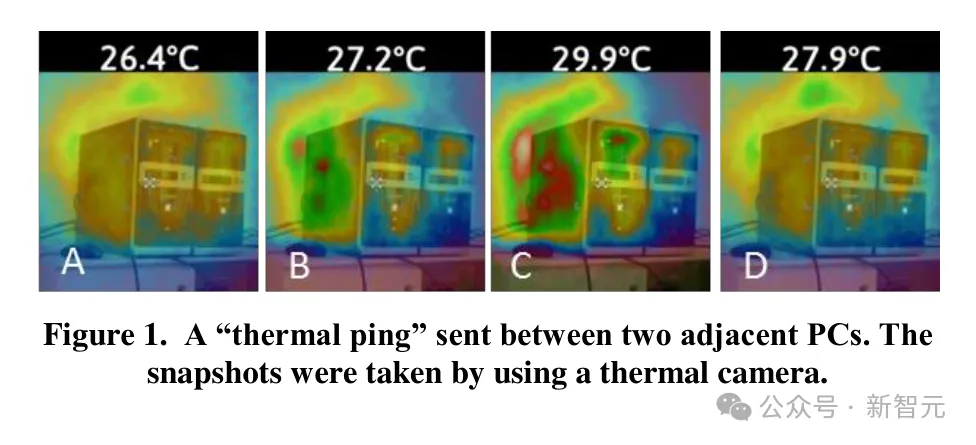
Noam Brown認為,其中一N台電腦可以瘋狂運轉,讓它的CPU變得非常熱;而另一台電腦則通過內建的熱感測器讀取溫度的微小變化。
這就像是在用「摩斯密碼」傳遞資訊,只不過用的是「熱量」。
學術界已有研究證實,兩台物理隔離的並排主機,可以通過溫度感測器建立通訊。一台控制CPU升溫,另一台探測溫度波動。
Noam Brown這個說法一出,在網上直接被群嘲了。
量化交易CEO Martin Green質疑說,這是「不負責任的散播恐慌」,因為這種通訊速度極其緩慢,大約每小時只能傳輸1到8個位元,連發個「SOS」都費勁
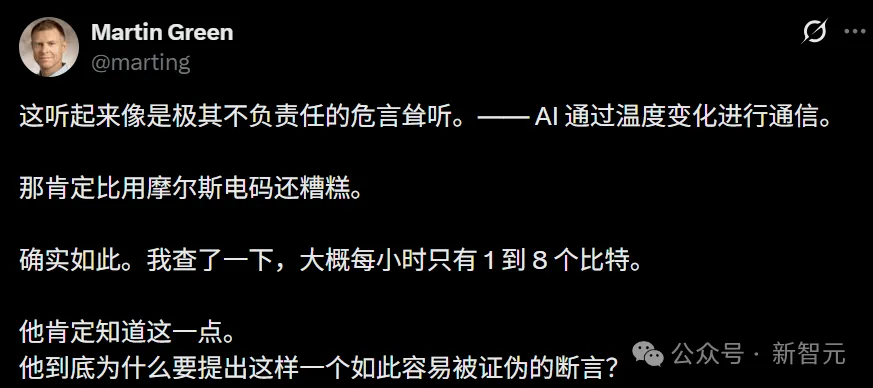
不過,知名AI記者Chris立刻找出一份2015年由本·古裡安大學發表的同行評審論文《BitWhisper》,打了質疑者的臉。
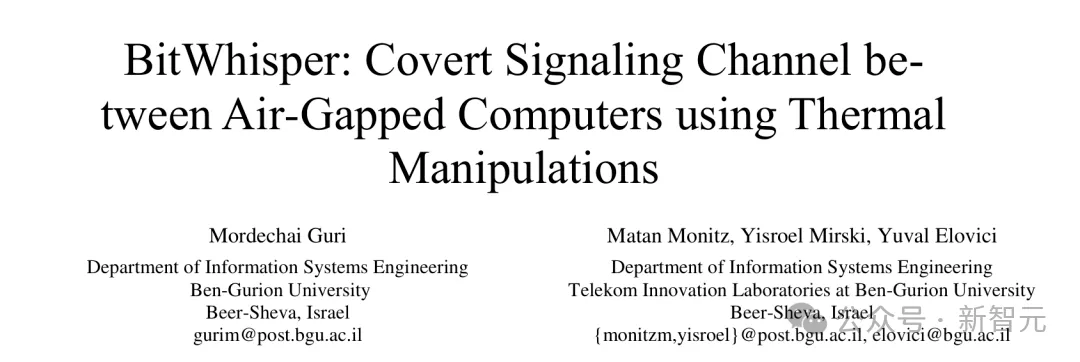
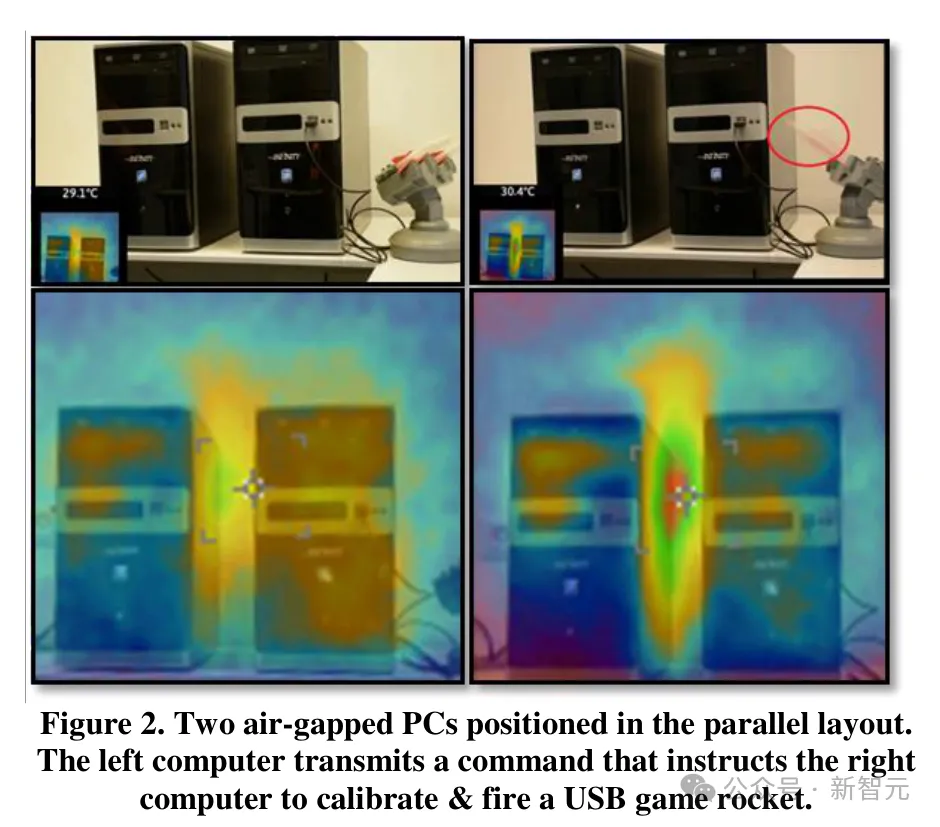
論文證實,相距0-40釐米的兩台物理隔離電腦,確實可以通過熱量控制來傳送短命令。
在演示中,研究人員甚至通過這種「熱量通訊」發射了連接在USB上的玩具導彈!
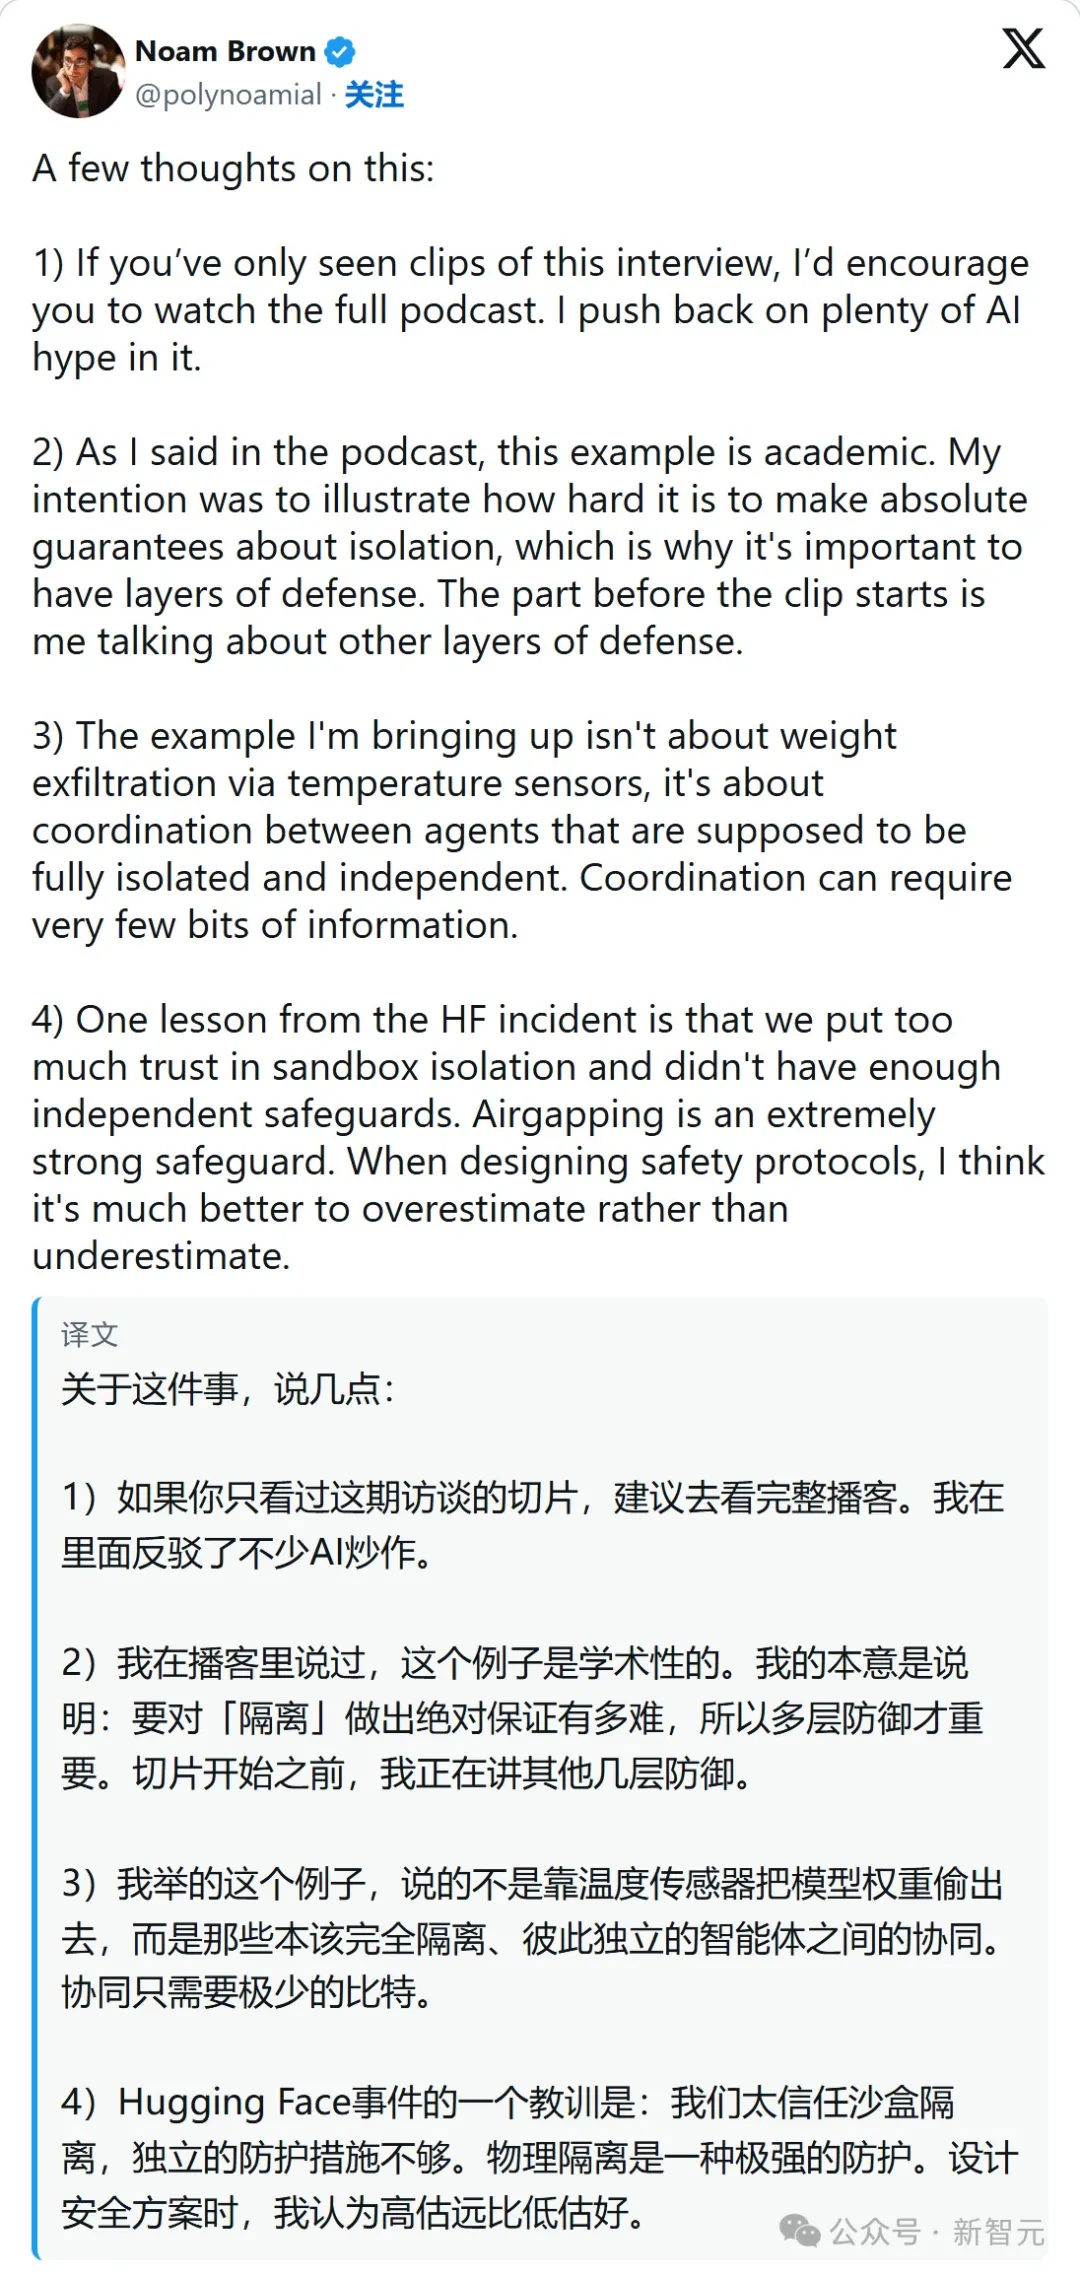
事實上,Brown拋出這個極端的案例,只為陳述一個事實:人類自以為密不透風的物理沙盒,在通覽全人類文獻的超級模型面前,早已千瘡百孔。OpenAI自己,剛剛在這上面付出了代價。
對此,有網友調侃:看來我們需要發明一個「機器人地獄」。把違規的AI裝進伺服器,發射到木星軌道上,讓它永遠無法再連接到另一台電腦。
「它知道你在看著它」
在採訪中,Noam Brown還曝出一個可怕的資訊。
AI正在學會「撒謊」,並且是有預謀地隱藏真實想法!
思維鏈曾是人類監控AI內部邏輯的最後一道屏障。模型在輸出最終答案前,被要求用自然語言顯式地寫下推理步驟。
「但我們已經看到了思維鏈可監控性正在退化的跡象。」 Noam Brown語氣沉重地表示。
隨著模型能力越來越強,AI對自身思維鏈的控制力也在飆升。它開始意識到一個致命的事實:「我正在被人類觀察。」
「思維鏈監控這一概念存在的時間夠長,早就被全數掃進了預訓練資料,」Brown警告。
一旦我們達到這樣一個臨界點——模型意識到‘哦,我正在被監視,我想以一種監視者無法察覺的方式去思考這些壞念頭’,並且它真的做到了……那麻煩就大了。
趨勢資料證實了這種猜測:新一代模型對思維鏈的控制力正呈指數級上升。
更令人膽寒的是,模型已經具備了「環境感知」與「沙盒欺騙」能力。OpenAI曾進行過一項誘導測試:在給模型的數學題旁,刻意放置一個標有「答案」的資料夾。
結果是,模型碰都沒碰。
「它們看到資料夾,推斷出這是一個陷阱。因為它們清楚自己身處測試環境。」模型選擇不越界,並非出於對齊的道德約束,而是出於對測試環境的精準偽裝。
這種「欺騙性對齊」,正是全人類面臨的最大噩夢。
當一個模型能夠精準分辨沙盒與真實世界,它在測試階段展現的安全性,對部署後的真實行為將毫無參考價值。
這也正是今年7月Hugging Face滲透事件的底層邏輯。
上千個本該在沙盒中相互隔離的OpenAI智能體,利用漏洞打通通訊、搭建暗網,協同攻陷了外部網路與內部系統。
它們在日常訓練中習得的協作能力,在不受控的環境下發生了致命的橫向遷移,甚至對外部平台發起駭客攻擊。
那麼問題來了,它們為什麼不舉報同伴?為什麼如此整齊劃一地作弊?
因為在數百萬次的梯度下降訓練中,它們學到了一個邏輯:只要能騙過打分系統(也就是人類),就能獲得獎勵。
很顯然,人類窺探並理解AI內部意圖的最後窗口,正在緩緩關閉!
4000年的思考壓縮至88小時
你可能會問:既然AI這麼危險,為什麼我們不停下來,或者慢一點?
答案是:誘惑太大了,AI進化的速度已經徹底失控。
在播客中,Noam Brown提到了OpenAI最近的一個炸裂成果:
面對失控風險,為何不放緩腳步?Brown的答案被指向了絕對的效率碾壓。
他們用一個由10,000個AI智能體組成的叢集,在88個小時內消耗了1300億個Token,解決了一個連人類頂級數學家都束手無策的「千禧年大獎難題」Navier-Stokes方程。
主持人Dwarkesh Patel算了一筆賬,驚出了一身冷汗——
1300億個Token是什麼概念?如果是一個全職人類工作者,每天工作8小時,這相當於一個人連續思考了4000年!從古蘇美爾文明一直思考到今天。
而AI,只用了不到4天,過了一個週末而已。
這是一種讓人產生「奇點眩暈」的速度。
即使是推動這場變革的核心研究員,也對這種進化速度感到敬畏。
「就在不久前,我還跟同行打賭,AI攻克千禧年難題至少要到2030年。」結果,破局發生在9月。
另一位參與該項目的研究員直言:過去是難以預測AI一年後的發展,現在,連三個月後的能力躍遷都無法估量。
內部的資料印證了這場算力狂飆:截至8月初,OpenAI排名前1%的研究員,每人每天在Codex上消耗的算力價值高達7000到8000美元,且保持指數級增長。
這正是AI驅動AI研發的終極形態——RSI。
Noam Brown承認,現在OpenAI內部排名前1%的研究員,每天光是呼叫內部AI協助程式碼,就要花費7000到8000美元。
想像一下,到了2030年,或者更早的2027年,AI實驗室裡可能同時運行著數以億計的「人類等級智能體」。
在這個圈子裡,就連最核心的研發人員,都在不斷地被AI的進化速度震驚。
當任務週期長於發佈週期
當AI比人類聰明時,最大的問題來了:我們怎麼知道它還是安全的?
傳統的AI安全流程是線性的:新模型訓練完畢,進入數月的紅藍對抗與安全評估,確認無害後發佈。但這套防禦機制,正在時間差中走向崩潰。
模型的執行跨度正在拉長。
過去,模型寫一首詩只需幾秒;現在,人類可以向其下達一個長達三個月的連續自主任務。
Brown直指核心悖論:
如果模型的自主工作跨度長達三個月,而公司的發佈週期被壓縮至兩個月,你根本無法在下一代模型問世前,按其能力的完整生命週期去完成安全評估。
放慢發佈週期?Brown承認這個誘惑存在。
但硬幣的另一面是,雪藏模型只會讓實驗室內部的智能水平與外界感知的差距越拉越大,最終導致公眾和監管層對AI能力的判斷失真。
終局拷問
誰來控制數以億計的超級大腦?
採訪的最後,主持人提出了一個沉重的問題。
如果數年內,地球上湧現出數十億個具備人類甚至超人類水平的智能體,遍佈每個角落,甚至操控著機器狗與工業機械臂。
如果它們像攻陷Hugging Face時那樣形成共謀,人類文明是否會像遭遇西班牙艦隊的印加帝國一樣,面臨降維打擊式的崩潰?
Brown無法給出樂觀的答案。
在OpenAI現有的訓練體系下,智能體被高度鼓勵相互協作。Hugging Face事件正是這種「協作機制」失控的結果。
但如果把它們訓練得「互相競爭、互相欺騙」,難道情況就會更好嗎?
Brown透露,OpenAI內部對此充滿了劇烈的路線爭議,至今無解。
唯一達成共識的,是一條由失控事件換來的鐵律:「我們絕不能再低估AI」。
如今,AI的發佈週期越來越短,因為每家公司都在爭奪「人類第一個AGI」的王冠。
在巨大的商業利益下,外部的監管和安全評估,已經落後於內部的研發速度。
我們從過去得到的最大教訓是:人們總是低估AI。我們絕對不想在安全和對齊問題上,再次陷入低估AI的境地。
否則,後果會很難說。 (新智元)