
九年磨一“芯”,拆解AI算力產業真實變局。
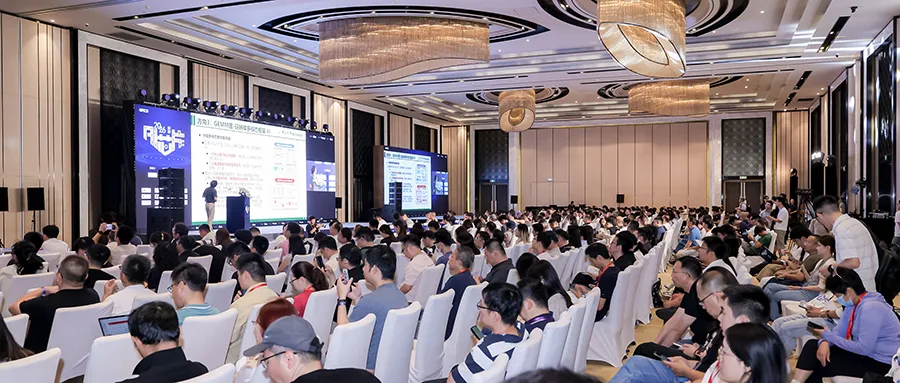
芯東西9月21日報導,今日,2026全球AI晶片峰會在上海圓滿落幕。
本屆大會由智東西發起,旗下智猩猩主辦,芯東西協辦,以“芯路求索 聚力致遠”為主題,全景透視從TOPS到Token的AI算力關鍵鏈路。
整整兩天,超過60位重磅嘉賓,在1場開幕式、3場論壇、5場閉門研討會上密集輸送技術創新、落地實踐與產業趨勢乾貨。多位演講嘉賓還在會上預告重磅新品。
大會直擊AI晶片前沿,涵蓋架構創新、3D堆疊、超節點、KV Cache、新型儲存、Token工廠異構混訓混推、大模型推理、智能體推理、具身智能推理等焦點議題。來自超百家AI晶片生態企業的專業觀眾來到現場參會交流。
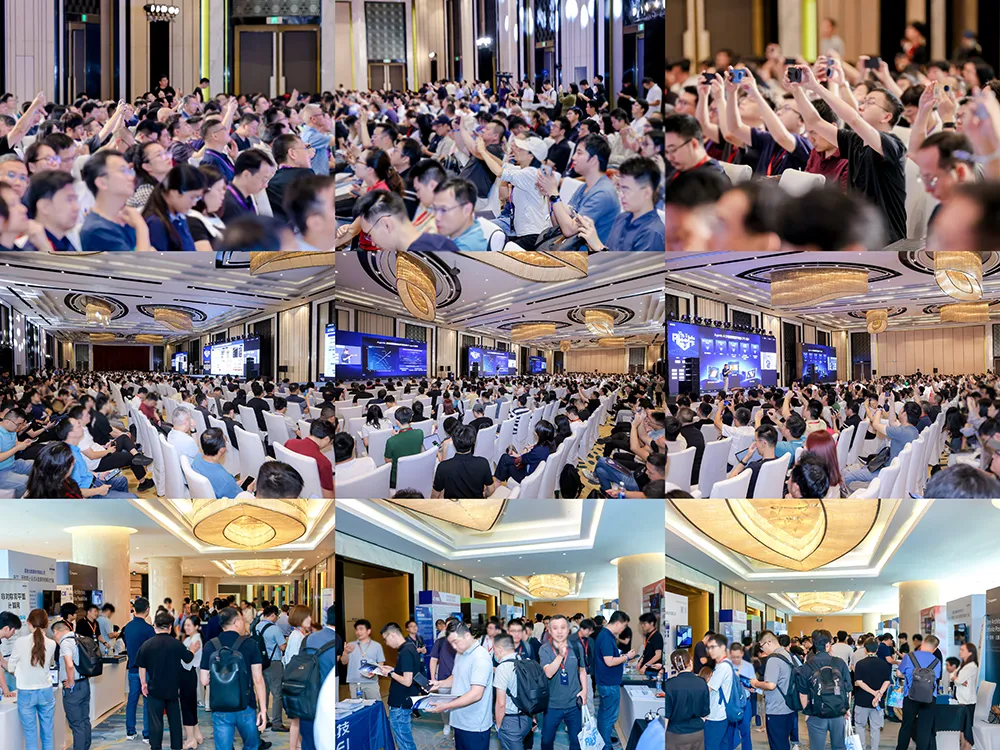
在展區,奎芯科技、芯來科技、Imagination、進迭時空、奇異摩爾、星融元、啟芯宸光、科華資料、博倫智匯、硅芯科技、先進編譯、恆瀚微電子、焱融科技等企業帶來最新的技術產品方案展示。
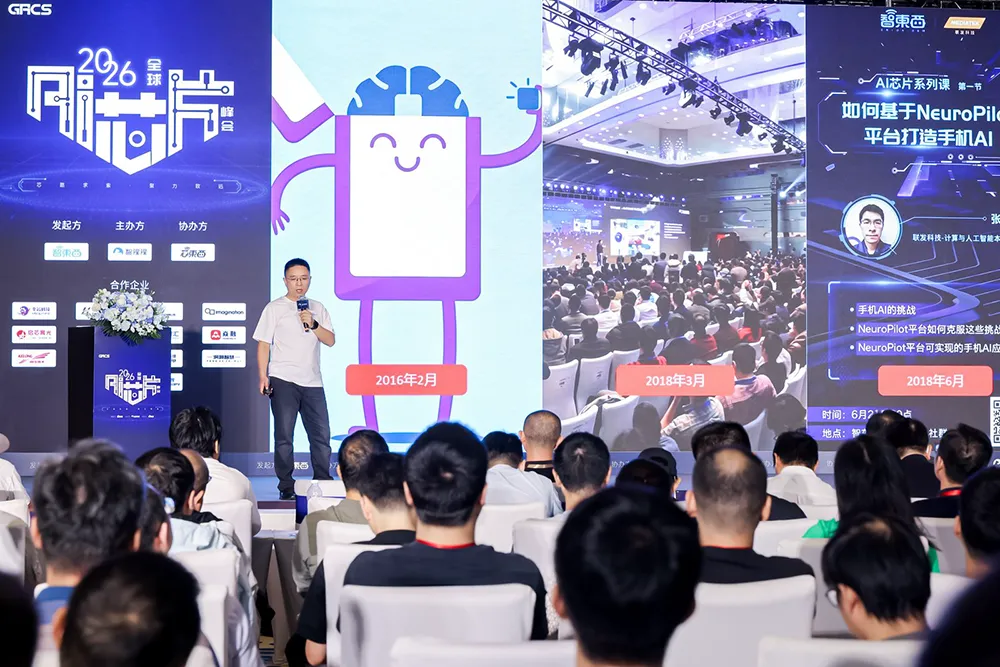
“九年前,我們在上海舉辦了首場全球AI晶片峰會。九年來,全球AI晶片峰會的足跡已遍佈北京、深圳和上海。”智東西聯合創始人兼CEO龔倫常在發表致辭時談道,“這是我們持續關注整個AI領域的一個縮影。”
我們對開幕式及3場高峰論壇(大模型AI晶片、Agent推理晶片、具身智能晶片)中30位嘉賓分享內容做了梳理總結,重點如下:
01.
雲端AI晶片論劍!高效算力呼喚新架構
CPU殺回智能體時代焦點
隨著智能體爆發,全球AI晶片產業格局持續演變,頭部模型廠商深度參與晶片架構定製,幾乎每家雲端運算巨頭都在自研AI晶片,國產AI加速卡持續放量,算力營運重心從不計成本搶佔高端算力,轉向以token成本和算力利用率為核心的精細化營運。
如何通過技術創新提高大模型訓推效率?為什麼智能體時代呼喚“六邊形”CPU?突破算力、記憶體、網路瓶頸有哪些新解法?大模型怎麼輔助提高晶片設計效率?5位演講嘉賓在開幕式上妙語連珠,暢談他們的成果與思考。
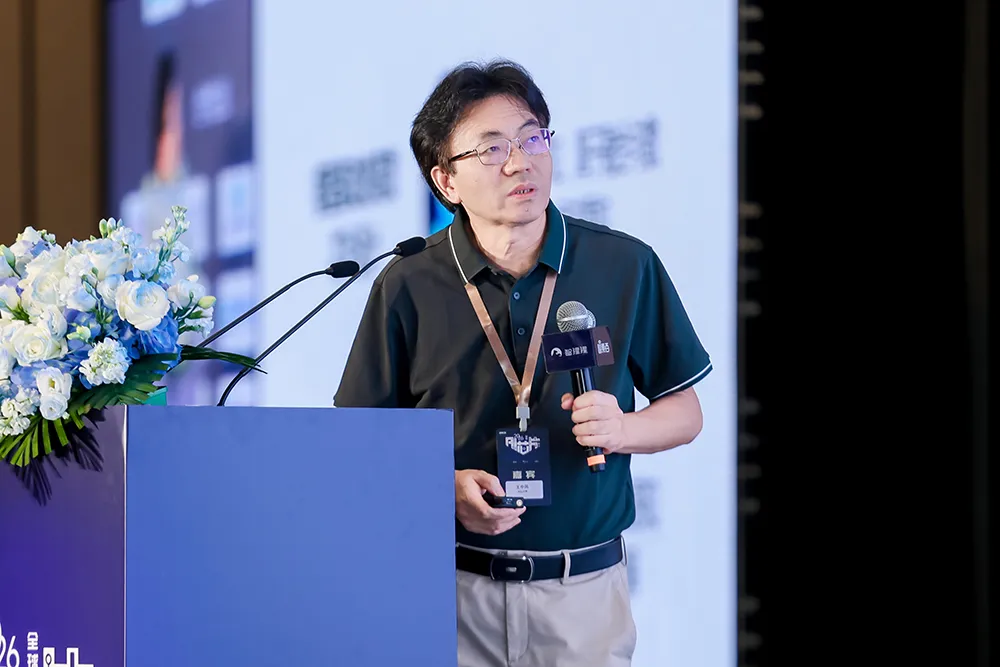
1、中山大學王中風:把AI晶片算力用滿,讓大模型參與晶片設計
中山大學積體電路學院院長、IEEE/AAIA Fellow王中風分享了大模型時代下AI晶片的設計挑戰與演進方向。當前如何將硬體峰值算力轉化為模型部署的有效算力成為關鍵問題,為了實現高效部署,其團隊通過壓縮與量化技術創新降低資料開銷,基於軟硬體協同提升推理效率。
模型驅動晶片設計方面,王中風團隊通過視覺Mamba高效加速器、超低BitLLM推理加速器、多層次稀疏Transformer加速器設計,解決算子適配、儲存調度、稀疏利用等挑戰;面向大模型輔助晶片設計自動化,提出性能感知GEMM Verilog生成設計、GEMM圖-碼轉換多模態框架等創新。
王中風認為,提升AI有效算力的演進方向將是模型、硬體與系統設計的協同創新,包括探索更低位元的模型壓縮與精度適配、聯合最佳化算子融合與資料重用、用部署反饋驅動模型迭代。
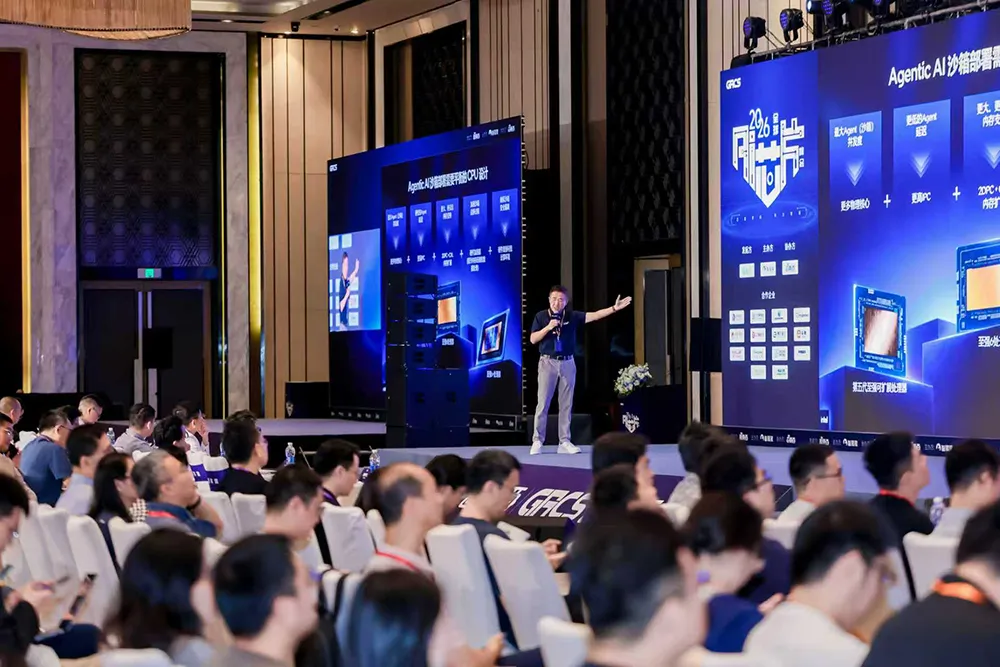
2、英特爾高宇:智能體時代,CPU重回C位
英特爾中國區技術部總經理高宇說,智能體爆髮帶動CPU、記憶體、SSD和隱私需求,讓CPU告別過去給GPU“打輔助”的角色,重回AI算力體系的C位。
智能體的運行是一個循環過程,其主執行緒主要運行在CPU上。CPU需要負責上下文處理、呼叫大模型、權限檢查、工具呼叫以及結果處理等環節。
適合智能體的CPU不能只追求單點性能,而要成為“六邊形戰士”,同時具備更高的沙箱並行度、IPC和頻率、更大的記憶體容量,以及硬體加速和安全能力。
高宇預告說,英特爾將在兩天后的英特爾技術創新與產業生態大會(Intel Connection)大會上展示內建128張或192張Granite Rapids處理器的高密度CPU機櫃設計,單機櫃可承載5萬個Agent同時並行運行。
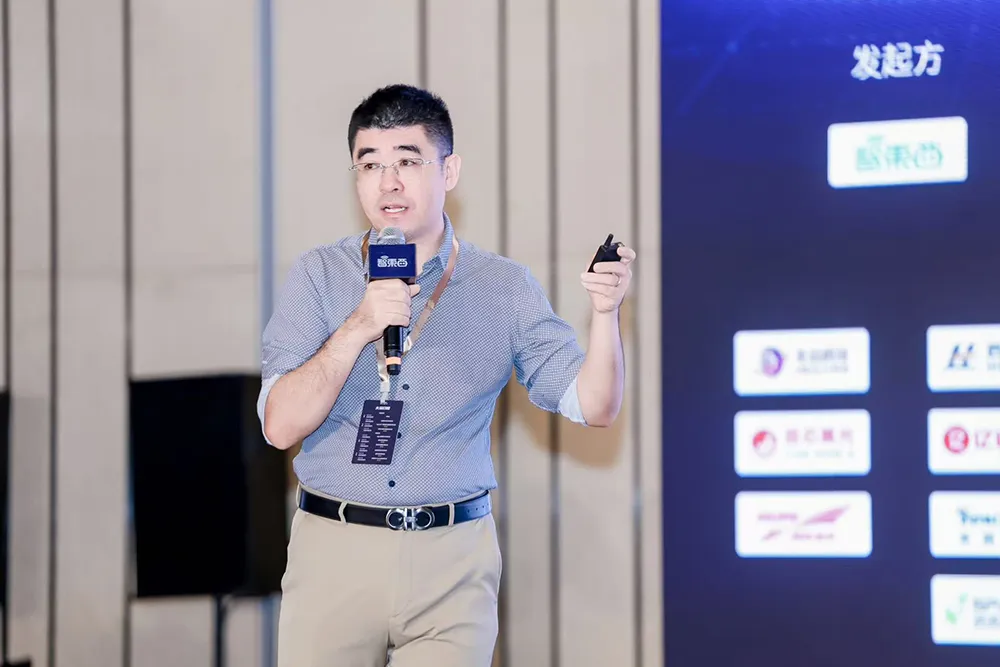
3、清華大學胡楊:以晶圓級協同設計提升Token經濟性
清華大學積體電路學院副教授胡楊指出,AI基礎設施的價值不能僅以單晶片峰值算力衡量,還應同時考慮有效Token產出與裝置、網路、供電冷卻等全生命週期投入。其團隊圍繞Token經濟性,開展從計算芯粒、晶圓級晶片到叢集的全系統協同設計。
針對通訊、功耗和整合密度三大瓶頸,團隊根據任務需求與面積、功耗約束,最佳化計算、儲存和通訊資源配比。在系統層面,將高頻寬通訊轉入晶圓內部,聯合設計晶圓內外互連及供電冷卻,減少通訊等待與外圍裝置投入。
報告介紹了模型部署、專家佈局和叢集組網等研究進展。通過協同最佳化Token對應與專家負載平衡,MoE推理方案在4毫秒輸出Token間隔約束下,單芯粒吞吐達到對照方案的1.84倍。晶圓間組網方案在所評估組態中的電力成本較基線降低46%。相關研究分別從提高有效產出和減少系統投入兩方面探索晶圓級的經濟性。
胡楊強調,性能收益需要與製造、運行代價共同評估。團隊已將熱致翹曲、製造與裝配良率、容錯和散熱約束納入設計,聯合清微智能研製了國產晶圓級晶片樣機,形成大尺寸硅基板設計PDK、芯粒整合與系統驗證能力。並聯合清微智能與浦江實驗室建構了軟體基礎設施。
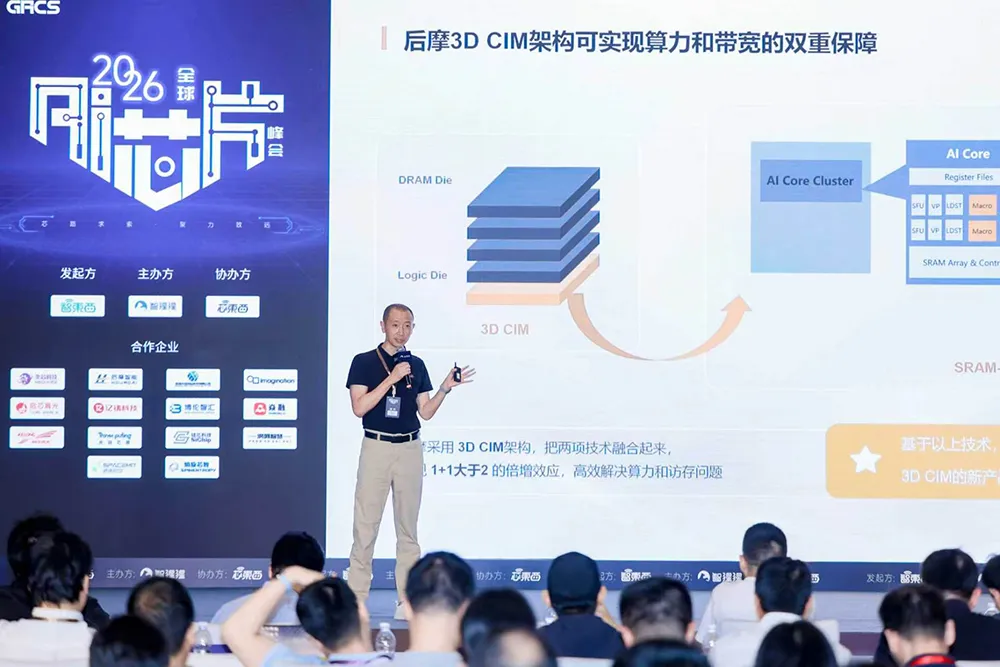
4、後摩智能信曉旭:M50已定點150+產品,3D CIM架構取得階段性成果
據後摩智能聯合創始人、產品副總裁信曉旭分享,應對AI晶片提升算力和訪存的兩大挑戰,後摩智能作為存算一體的先行者,過去六年沿著基於SRAM的存算一體路線迭代,成功將存算一體架構從學術界帶入產業界。其旗艦產品M50量產半年,產品定點已達到150+,形成商業閉環。
針對行業主流3D堆疊技術算力受限、散熱不佳等難題,後摩智能自研3D CIM架構,實現同等面積下算力翻倍,功耗與散熱壓力顯著最佳化。
信曉旭表示,後摩智能將圍繞端側AI對算力、能效和儲存頻寬提出的新需求進行技術演進,並加速推進3D CIM架構的晶片產業化探索。
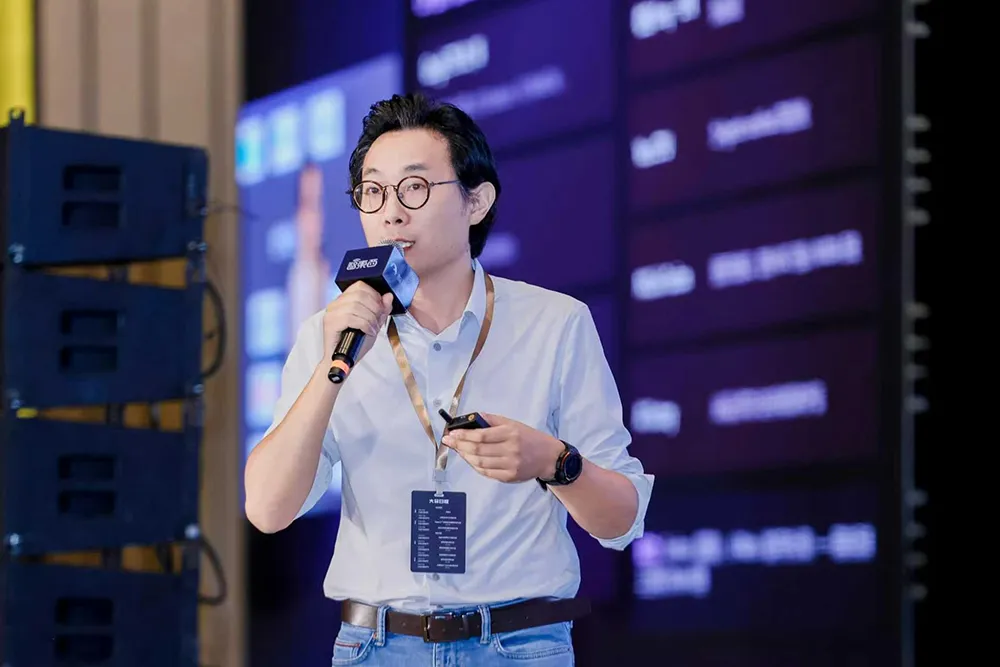
5、奎芯科技王曉陽:未來AI晶片或採用定製記憶體(HBM+HBF)+標準互聯新架構
在奎芯科技聯合創始人兼副總裁王曉陽看來,AI晶片設計逐漸走向定製化、異構化、專用化,給記憶體架構創新帶來新機會,HBM Base Die定製化和HBF分層儲存成為新趨勢。
HBM記憶體已從標準單品發展成小型子系統,需針對不同工作負載深度定製。HBF採用NAND Flash定製化堆疊,達到HBM級頻寬但容量高一個數量級。未來AI晶片可能採用NAND Flash(HBF)+HBM混合架構,將KV Cache、Attention等延遲敏感資料留HBM,可預測的專家權重卸到HBF。
奎芯科技擁有全端記憶體與介面IP,在UCIe,HBM,LPDDR,ONFI/NAND等介面方面積累深厚,能夠為定製記憶體+標準互聯架構提供介面底座技術。目前奎芯M2 UCIe:介面底座的標準封裝32G已完成硅驗證,其打造的Chiplet產品ML100 IO Die能實現HBM與xPU解耦,已流片交付客戶。
02.
經緯圓桌:AI的平民化
及端側模擬計算的未來
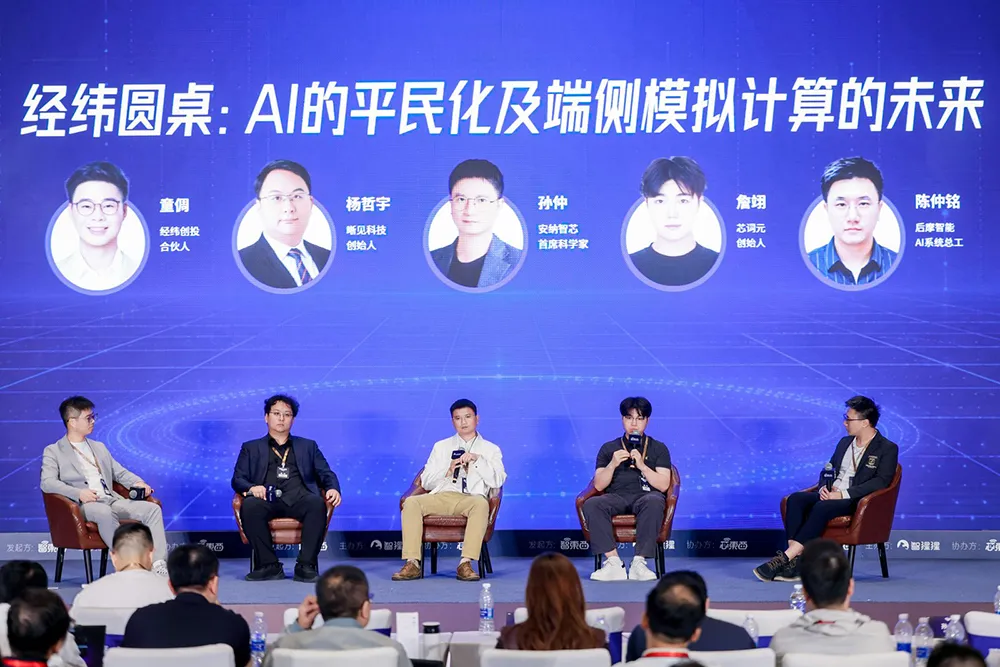
經緯圓桌由經緯創投合夥人童倜主持,晰見科技創始人楊哲宇、安納智芯首席科學家孫仲、芯詞元創始人詹翊、後摩智能AI系統總工陳仲銘四位嘉賓圍繞“AI的平民化及端側模擬計算的未來”主題進行分享。
經緯創投合夥人童倜給本場圓桌劃出兩大重點:一是AI平民化,AI服務面向富人是階段性的中間過程,未來肯定會有大量產品和服務面向普通人;二是在端側,傳統GPU、數字NPU是“老登”,未來需要用更多新技術解決現在的問題。
計算晶片公司有了水,還需要配套的管子,這裡的水管代表晶片能夠支撐的模型規格能力。童倜認為,企業具備核心計算能力是前提,而儲存架構的選型,則是根據不同應用場景,基於對應模型的參數規模及系統需要,來決定。
1、晰見科技楊哲宇:天眸芯成果榮登Nature封面,實現物理通用智能(Physical AGI)
晰見科技創始人楊哲宇說,端側智能或者更大的範疇Physical AGI是比肩AI Coding的下一個機會,晰見科技要讓AI擁有看世界的眼睛。其感存算傳一體的3D IC晶片天眸芯是一顆能直接輸出token的晶片,相關論文登上國際頂刊Nature封面。
天眸芯的結構是基於3D堆疊技術,在感光陣列下方堆疊高密度儲存陣列與運算單元,通過模擬計算降低ADC的轉換頻次,功耗僅為對應同規格晶片的幾十分之一。
據楊哲宇透露,目前頭部具身智能企業打網球、踢足球、打乒乓球的視覺方案都直接來自天眸或進入深度評估階段,具身運動人形機器人未來都會在3-6個月內,採用晰見科技的天眸芯或Token Camera。
今年11月,晰見科技將發佈基於天眸芯的多模態大模型。內部測試顯示,基於天眸芯的稀疏Token該模型的首token延遲(TTFT)僅為傳統基礎模型的二十分之一,性能可直接對標國內外頭部多模態大模型,且率先支援主動感知與視覺注意力,是未來Physical AGI時刻的基座模型
2、安納智芯孫仲:用模擬計算晶片把機器人時延壓到幾毫秒
安納智芯成立不到一年,專注於模擬計算晶片設計。安納智芯首席科學家孫仲談道,模擬計算晶片有希望將相關應用的時延從百毫秒級降到幾毫秒,人可感知的延遲為幾十毫秒,機器人延遲在幾毫秒運動會更流暢。
端側大模型的資料量很大,處理這一問題的自然方法是做3D堆疊。安納智芯擅長做矩陣計算,在面對如端側裝置微調等具體應用時,資料儲存就可以使用DRAM或HBM,再利用模擬計算晶片進行資料處理、微調,這也是安納智芯將後續探索的方向。
孫仲透露說,其工程樣片即將回片,下一步會聯合銀河通用等具身智能公司做運動規劃和即時控制Demo,與科大訊飛等端側AI企業打造訊號處理、大模型微調等相關應用。
3、芯詞元詹翊:庖丁解牛式拆解AI平民化三道檻,正聯合小米打磨超高速AI推理終端產品
芯詞元創始人詹翊認為,AI平民化分為AI是否值得用、用不用得起、能否顯著提高生產力三個維度:第一個維度和基座模型有關,第二、第三個維度反映在硬體上,就是降成本和提升推理速度。
芯詞元將基於全新一代存算架構打造速度更快、成本更低的AI推理晶片與推理算力叢集,預計明年上半年發佈MO-I1,展示近萬tokens/s的端到端推理速度,聯合小米等產業夥伴實現超高速AI推理硬體在現實應用場景中的實際落地。
詹翊判斷,未來AI推理硬體會是集各種儲存介質所長的綜合系統。其中芯詞元的eDRAM負責片內高頻寬和高速計算需求;片外3D DRAM和HBF互有頻寬和密度優勢,都會有他們各自適配的場景。所以AI推理硬體會在不同場景下採用不同的搭配方案,但芯詞元的eDRAM存算一定是片內方案的最優解。
4、後摩智能陳仲銘:10W功耗跑100B大模型,下一代旗艦芯已流片
在後摩智能AI系統總工陳仲銘看來,3D堆疊能把記憶體頻寬做大,實現極高的資料吞吐,尤其在物理AI場景下,有機會實現即時互動,不過現階段相關供應鏈還未成熟。
HBF是應對HBM高昂成本的一條技術思路。陳仲銘認為,HBF無法完全替代HBM,更多是作為互補方案,未來3D堆疊技術可能將出現HBM+HBF等混合堆疊架構。
後摩智能採用3D CIM(存算+3D DRAM)的下一代旗艦晶片A20已流片,新一代存算架構可將100B大模型部署至端側晶片,功耗約10W,具備裝進手機的潛力。
該公司也在關注模擬存算,可能會在下一代或下下一代產品實現大規模生產。
03.
大模型AI晶片狂奔
3D堆疊、新型儲存、模擬計算風起雲湧
隨著大模型參數向兆級膨脹,峰值算力不再是衡量AI晶片能力的唯一標尺,制約系統效率的要素還包括資料搬得動、存得下、連得快,以及晶片能否以可接受的功耗和成本真正落地。訪存頻寬、互聯效率、軟體生態和工程化能力,正在共同影響一顆AI晶片的有效算力。
AI晶片創新正從單點提升計算性能,轉向計算、儲存、互聯、軟體與設計工具的系統級重構。如何打通從架構創新到規模量產、從理論性能到真實應用的漫長鏈條?在大模型AI晶片高峰論壇上,8位嘉賓給出了他們的答案。有人以軟體定義、3D堆疊和近存計算突破記憶體牆,有人押注存算一體、HBF與現代模擬計算,也有人將戰場推向融合GPU、STCO和AI賦能EDA。
1、東方算芯彭貴強:用“軟體定義+3D堆疊”創新繞過系統瓶頸
東方算芯董事長特別助理彭貴強談道,“更聰明的模型”需要大算力和高訪存頻寬,“更低成本的應用”需要高訪存頻寬和低成本推理,算力評價標尺正從峰值算力變為有效算力。晶片性能不僅取決於計算單元本身,更受限於訪存頻寬、互聯延遲、調度效率等系統因素。
東方算芯聚焦軟體定義晶片,從計算、儲存和互聯架構三大方面進行創新:(1)軟體定義Tile,提升硬體利用率,降低程式設計複雜度;(2)採用邏輯-儲存三維匹配的3D IC設計,提供極致頻寬並突破記憶體牆,這一過程需要應對應力與晶圓翹曲控制、熱管理和良率成本損失三大工程化挑戰;(3)通過Infinity Chiplet 3.5D,實現更強算力和更大互連規模。
2、億鑄科技熊大鵬:三大定律,指引通用存算一體
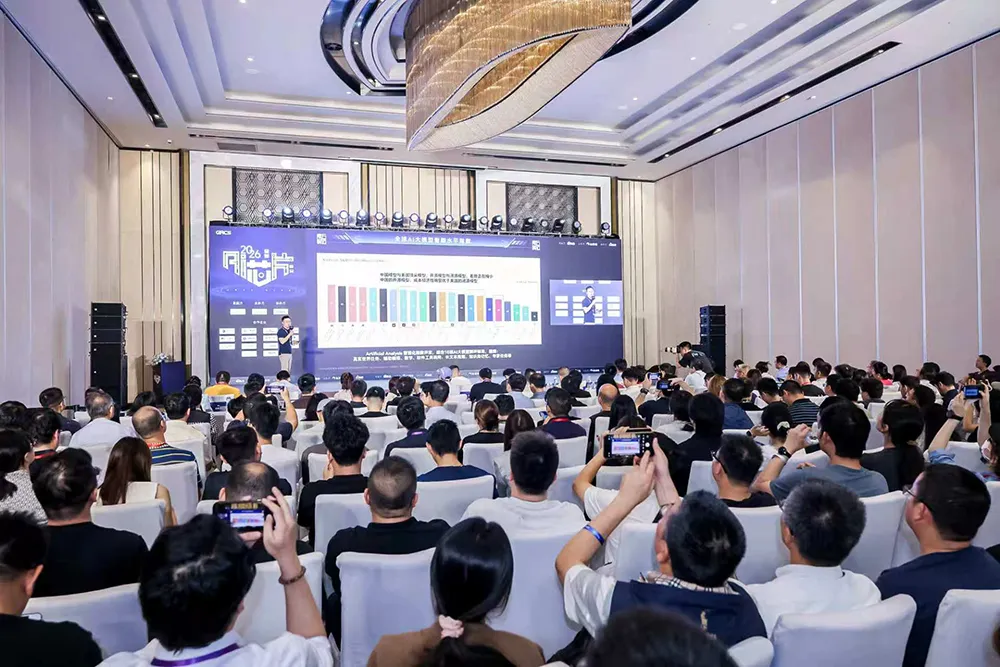
億鑄科技創始人、董事長兼CEO熊大鵬認為,通用存算一體是突破AI晶片算力與記憶體瓶頸的關鍵。對此,他提出三大核心定律,為行業落地提供理論支撐。
(1)搬運代價定律:AI資料搬運功耗與延時遠高於計算本身,存算一體核心是儘可能消除資料搬運頻次與距離。
(2)通用邊界定律:通用存算一體需相容CUDA主流生態,全覆蓋通用GPU算力,適配各類模型迭代。
(3)異構終局定律:存算一體與GPU架構邏輯不同,二者融合能力直接決定晶片商業化成敗。
熊大鵬強調,存算一體的核心在於儲存,億鑄科技選定大容量、高成熟度、低成本的3D DRAM技術路線,未來將推出多形態全端算力產品,覆蓋雲邊端各類算力場景。
3、邁特芯李凱博士:端側模型有“三座大山”,3D近存計算可破局
深圳邁特芯科技晶片產品經理李凱博士分享了橫亙在端側大模型推理面前的“三座大山”:一是功耗、算力與成本的“不可能三角”,二是記憶體牆限制,三是通用方案與專用晶片之間的場景適配難題。
邁特芯採用張量脈動架構疊加3D近存計算來打破“記憶體牆”,將頻寬利用率提升至80%左右。經測算,同樣實現600GB/s頻寬,傳統2D方案功耗約為30~50W,而3D方案可將功耗降至3~7W。
據李凱博士透露,邁特芯3D TPU晶片已於今年流片,預計今年11月回片並點亮,首批將適配2B至9B模型,平均功耗約6W,預計推理速度可達80tokens/s。
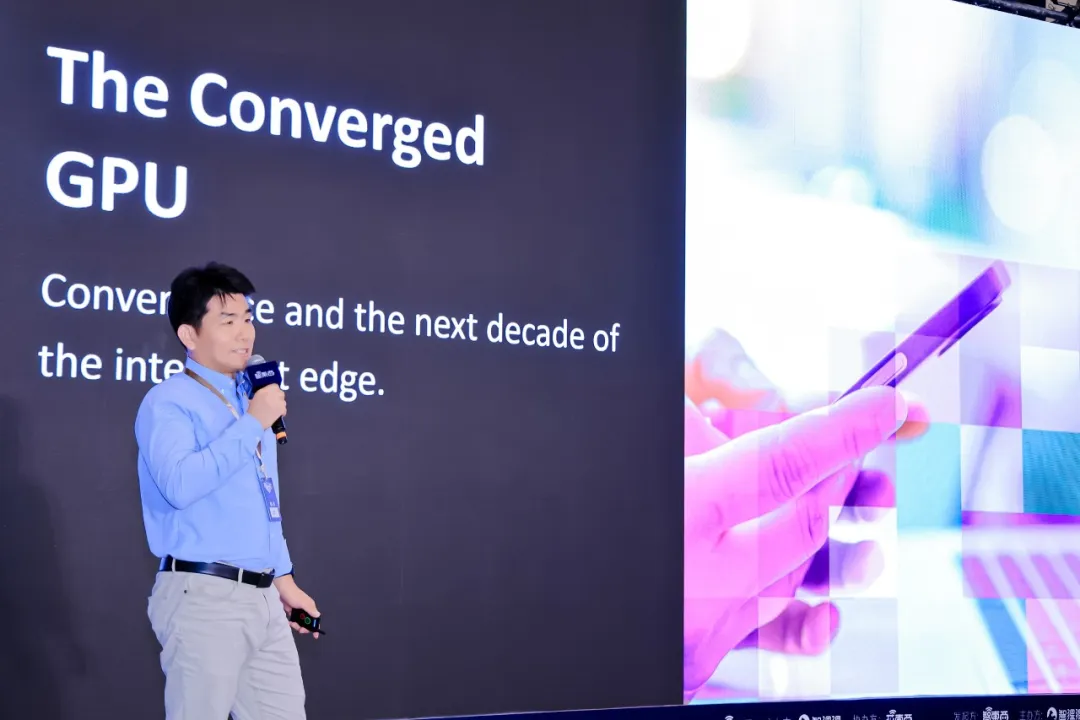
4、Imagination艾克:端側晶片需要融合GPU
Imagination應用工程總監艾克觀察到,端側晶片已經開始同時承擔感知、計算、推理與圖形渲染等任務,傳統異構架構暴露出資料搬運、記憶體吞吐、任務調度與軟體適配等短板,如何應對5-10年生命週期中不斷變化的模型與應用需求,成為端側晶片設計的新挑戰。
產業正探索更靈活的異構融合計算架構,趨勢是讓GPU從單純的圖形處理向通用計算與AI計算中心演進。ImaginationE系列GPU IP通過矩陣乘法直接嵌入GPU核心來提高GPU利用率,AI計算、通用計算與圖形處理由韌體統一調度並隔離多工,再通過算子庫、圖最佳化與多格式量化支援輕量化部署,減少計算單元間的資料搬運與調度成本。
5、硅芯科技趙毅:3D晶片EDA是“無人區”,需要STCO+AI開路
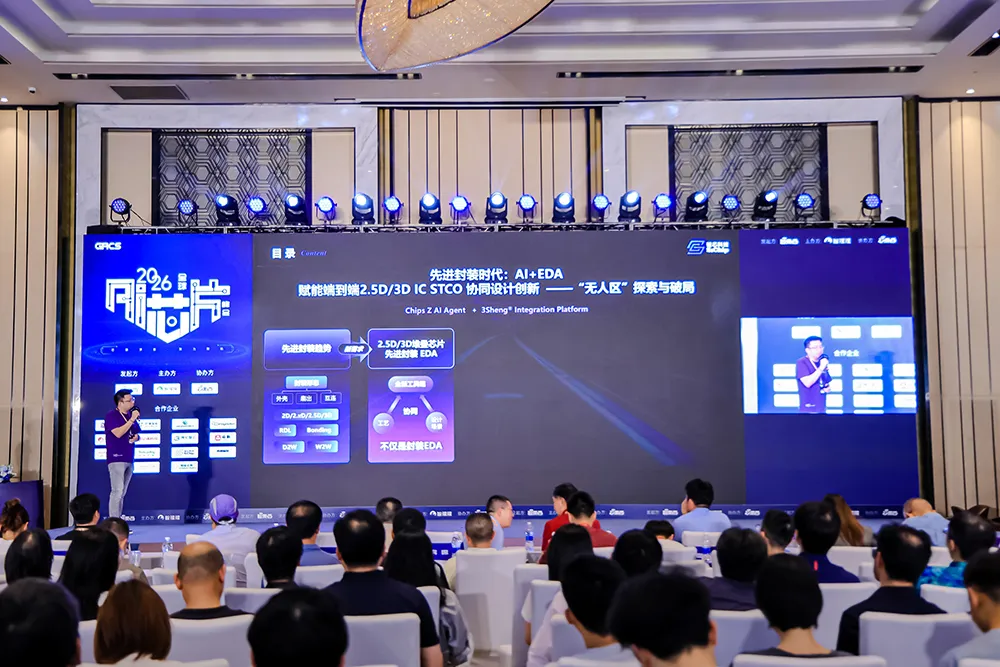
硅芯科技創始人兼總經理趙毅博士指出,3D IC EDA領域被視為"無人區"——2D時代積累的設計方法學與工具鏈在三維堆疊場景下面臨比較大的變革,需要重構工具鏈與設計範式。當前3D DRAM多層堆疊與存算晶片企業亟需一套全新工具鏈,訊號、電源、熱等多物理場模擬也需從單點後置轉向協同前置。
晶片設計正從傳統單晶片時代的DTCO(晶片設計與硅工藝協同),向端到端深度協同的STCO(系統-工藝協同最佳化)升級。硅芯科技STCO閉環協同流程貫通架構、設計、工藝與製造,將翹曲、電源完整性等量產風險前置管控。
同時,AI將賦能EDA新範式。硅芯科技推出了3Sheng Integration平台,核心AI Agent“Chips Z”實現自動迭代、閉環尋優等功能,顯著壓縮研發週期,加速晶片產品推向市場。
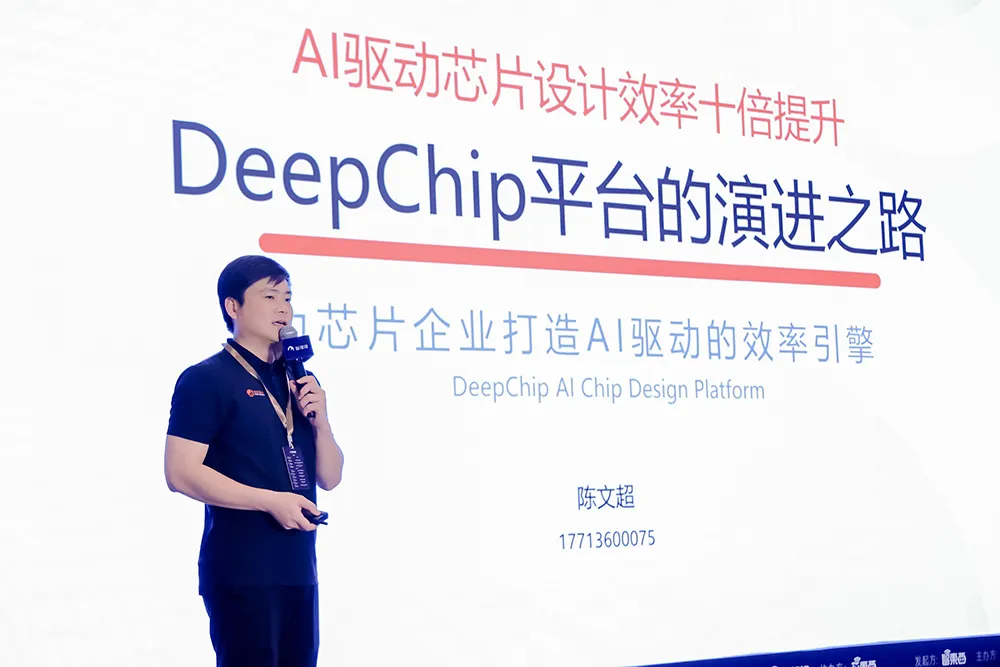
6、啟芯宸光陳文超:以DeepChip平台推動AI賦能晶片設計全流程
啟芯宸光副總裁、EDA智算平台首席架構師陳文超介紹了DeepChip平台的技術佈局與應用實踐,分享了通過AI智能體、行業知識庫與EDA工具協同,提升晶片設計、驗證及測試效率的探索。
啟芯宸光DeepChip平台涵蓋DeepEDA、DeepIP、DeepATE與DeepEDU四大業務模組。DeepEDA融合EDA智算平台與AI²C智能體平台,通過算力調度、參數最佳化和流程自動化提升設計模擬效率;DeepIP接入本地或雲端大模型,結合企業知識庫與EDA工具,覆蓋系統設計、RTL生成、功能驗證和偵錯最佳化;DeepATE聚焦測試程序生成、測試向量轉換與引腳自動匹配,提升晶片測試自動化水平;DeepEDU則將產業級AI工具與真實項目引入教學實訓,培養AI與晶片設計複合型人才。
通過演示搭建測試平台、完成指定驅動程式碼生成與驗證的案例,呈現了AI輔助工程師減少重複工作、加快研發迭代的應用價值。
7、九天睿芯劉錚:HBF AI晶片國內外研發競速中
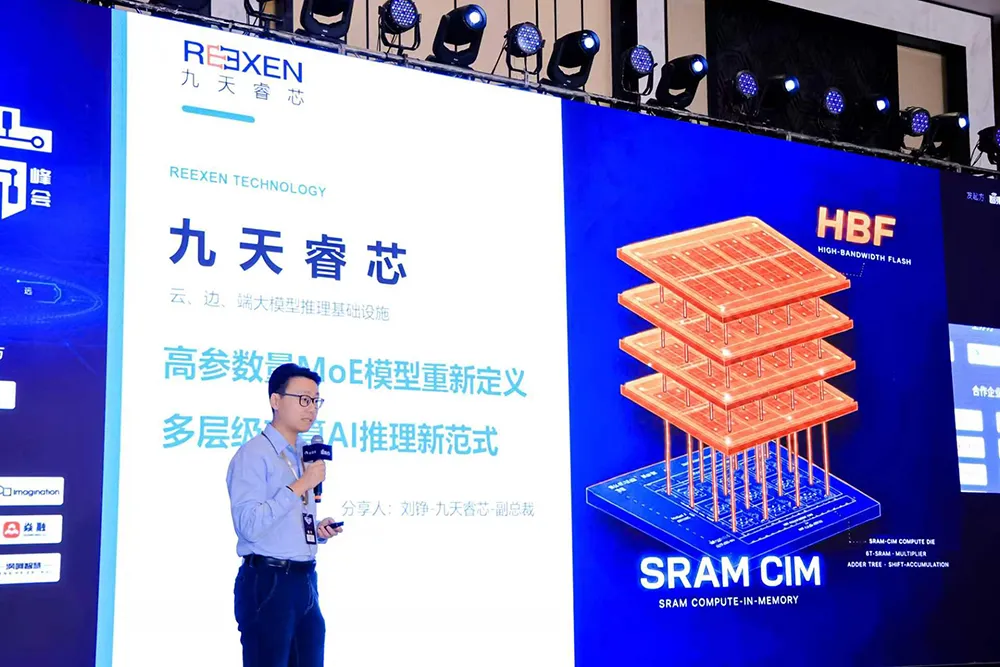
九天睿芯副總裁劉錚談道,MoE模型參數量越來越大,儲存容量的重要性越來越高,基於HBF高頻寬快閃記憶體的解決方案愈發重要,預計國內外廠商將在2027年上半年完成計算、儲存層流片,HBF AI晶片有望在2027年下半年推出。
在先進“存算+近存”的技術路線上,國內廠商探索出三維堆疊晶片設計方案,能夠把TB級大模型權重設於超高容量儲存層;結合SRAM存算一體技術,解決儲存牆、功耗牆。該方案可支援超高參數量MoE大模型在雲端推理場景和AI手機等智能終端場景落地應用,給使用者帶來更優的智能體驗。
據劉錚分享,九天睿芯雲端推理晶片可高效支援FFN階段的計算,可獨立或搭配其他GPU方案完成Attention(注意力機制)階段的處理,在系統層級形成A/F分離的高效異構計算方案。
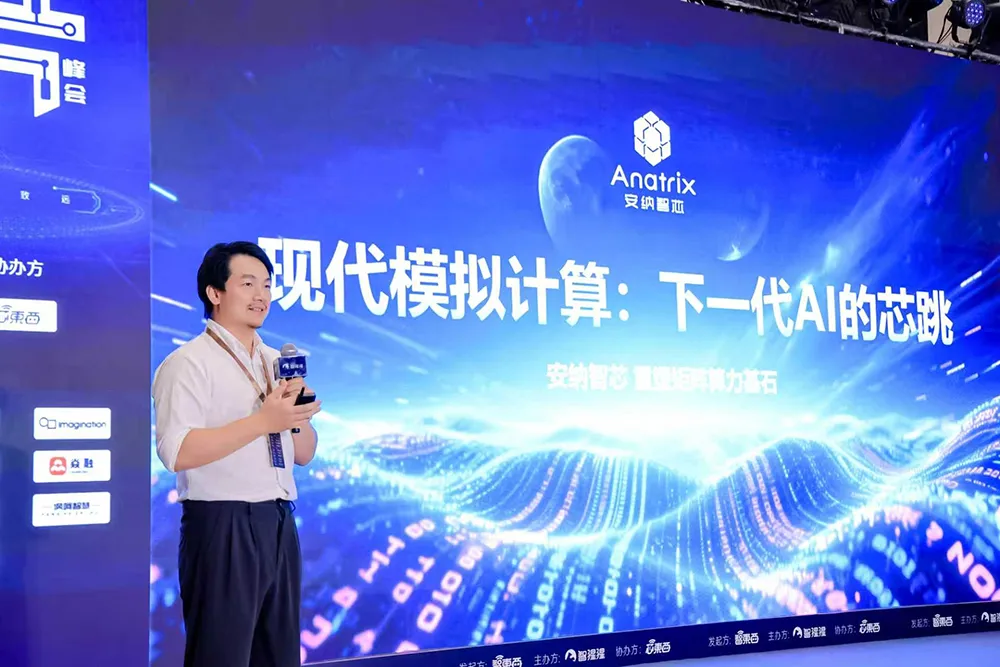
8、安納智芯向銳:現代模擬計算“一步”解矩陣方程,AI訓練少走彎路
安納智芯聯合創始人兼CEO向銳認為,矩陣方程求解是AI訓練的重要數學基礎,但數字晶片直接求解效率較低,工程上需將其轉化為一系列矩陣乘法。同等精度下,現代模擬計算方案在運算速度和能效比上大幅超越先進數字晶片,為廣泛的矩陣方程求解需求,提供了顛覆性的解決方案。
對此,安納智芯提出“現代模擬計算”,利用天然平行的物理法則,將計算壓縮至一步操作。2025年,其方案實現24位定點精度,向銳稱,這是世界首個全模擬高精度矩陣方程求解方案。
其晶片在應用上,面向雲端,計畫支援二階最佳化器—現在幾乎所有開源大模型廠商開始採用這類訓練方法,降低大模型訓練成本;面向端側,則希望憑藉近百倍能效優勢支援後訓練,並探索具身智能采訓推一體化和線上自進化。
04.
Agent推理需求爆發!AI算力告別單一晶片
CPU、異構算力、RISC‑V成下一程關鍵
隨著智能體走向規模化落地,AI產業正式邁入推理算力主導的全新發展階段。區別於傳統AI模型的互動模式,智能體具備自主決策、持續運行、長任務處理的特徵,催生了指數級增長的推理算力需求,也讓行業長期面臨的Token供給不足、推理成本高昂、端雲適配脫節等痛點愈發凸顯。
在此產業變革關鍵節點,6位嘉賓在Agent推理晶片高峰論壇上,聚焦推理晶片的落地痛點與產業未來路徑,亮出了自家的前沿技術方案與實戰經驗。
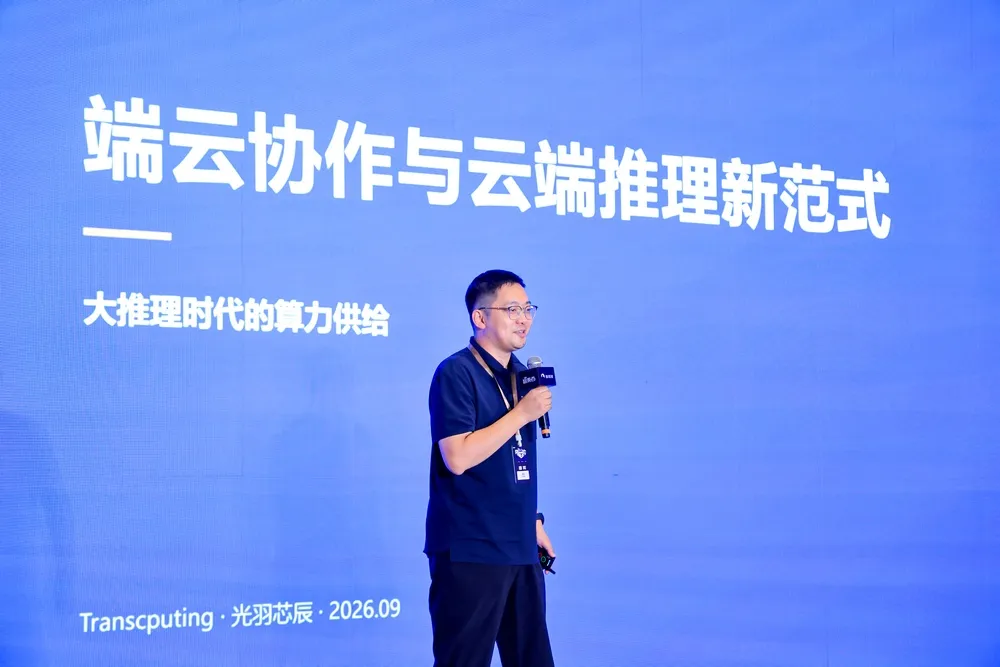
1、光羽芯辰張晴:異構算力替代單一結構,公佈端雲協作和雲端推理新路線
光羽芯辰聯合創始人、董秘張晴稱,AI推理需求正迎來指數級增長,但推理側的Token供給嚴重受限。為此,光羽芯辰提出通過3D堆疊、異構計算和儲存分層,大幅增強端側推理能力並推動能落地的端雲協同,同時在雲端通過PD分離大幅降低雲端推理成本。
作為光羽芯辰解決方案的第一步,TC1000系列晶片已量產部署,可在低功耗下高性能運行35B MoE模型。第二代TC2000系列將於明年量產,以更低的功耗服務於AI手機登手持式裝置;第三代TC3000系列將專門面向超大規模模型的端側部署和雲端PD分離市場,目標是單晶片支援兆參數模型,並降低HBM需求及雲端推理成本。
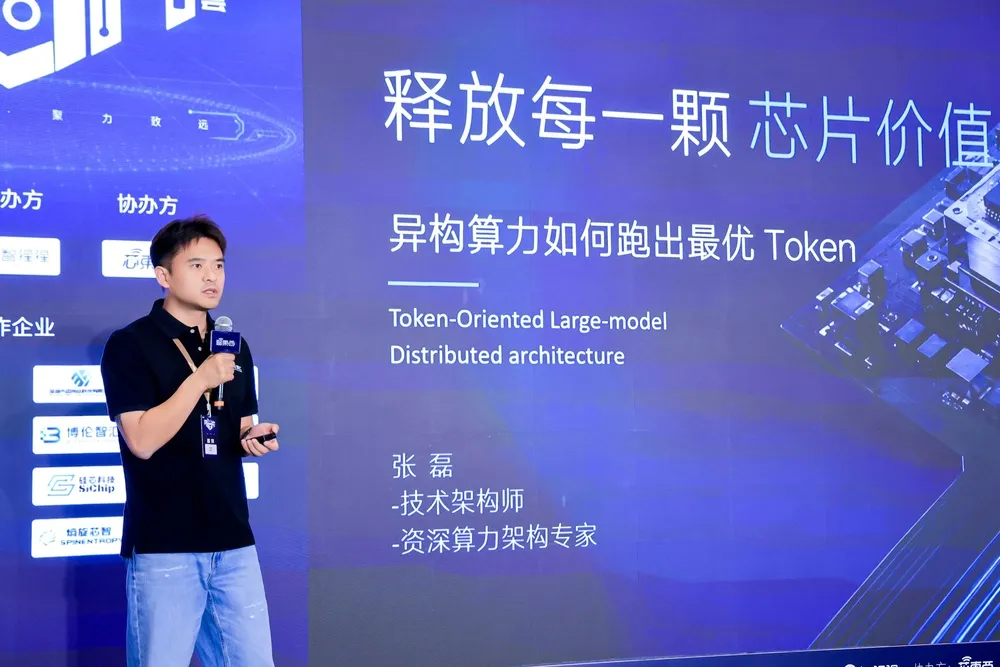
2、博倫智匯張磊:從“有卡”到“用好卡”,異構算力調度成關鍵一環
國內算力需求快速增長,但算力供給和需求之間存在大量缺口,存在大量CPU閒置問題。博倫智匯技術架構師、資深算力架構專家張磊認為主要原因在於異構GPU規模化部署後,軟體生態和調度能力在國產晶片上的適配仍不完善。
對此,博倫智匯通過DRA Proxy連接廠商裝置外掛與K8S,統一轉換、補全裝置資訊並上報,實現異構GPU的資源發現與調度。同時,其自研TOLD架構面向Token,以低時延、高吞吐、低成本為目標,進一步串聯資源規劃、資源管理與推理服務部署。
在此基礎上,博倫智匯的MIX調度平台通過復用廠商裝置外掛,降低晶片接入成本,讓不同廠商的GPU釋放算力價值。
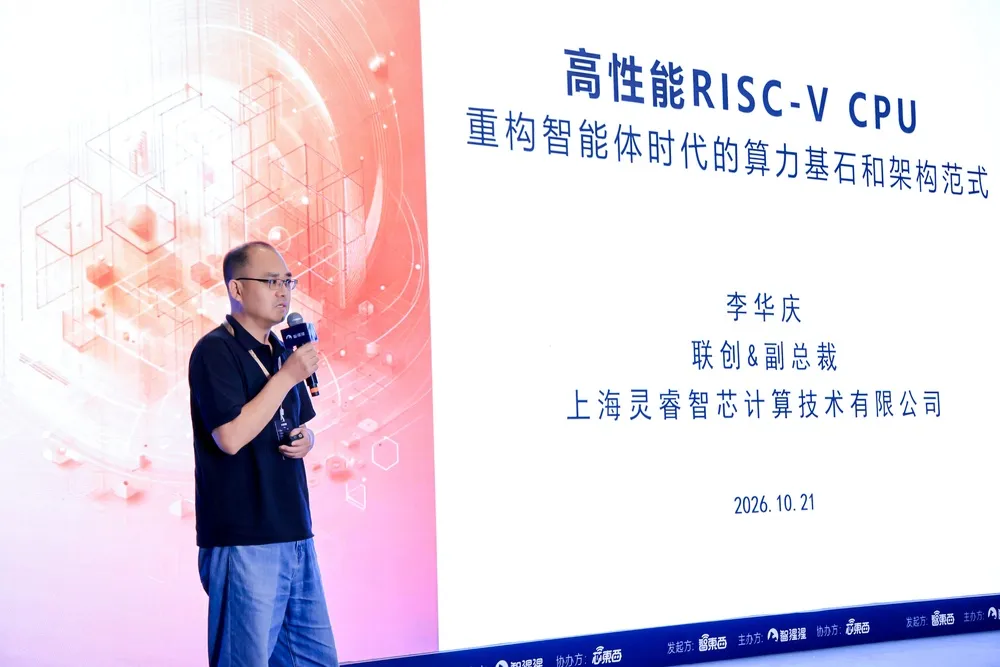
3、靈睿智芯李華慶:智能體時代,CPU將扛起Agent Harness大旗
靈睿智芯聯合創始人兼副總裁李華慶認為,Agentic AI正推動計算範式從以GPU為中心的計算密集型,轉向以CPU為中心的控制密集型和I/O密集型。模型推理主要由GPU或其他AI晶片完成,長短期記憶管理、工具呼叫、多智能體調度和安全隔離等Harness環節則主要依賴CPU。
在他看來,智能體的爆發會給CPU帶來巨大機會。未來業務將越來越長尾化、碎片化,底層晶片需求也會千差萬別。隨著摩爾定律放緩、工藝紅利變薄及能耗約束加劇,晶片僅靠工藝演進已不足以繼續提升計算效率和能效,需要結合不同業務特性定製晶片。因此,智能體時代的CPU需要具備高性能、高並行、高可靠、AI增強與可擴展性,而RISC-V則是最適合的指令集選擇。
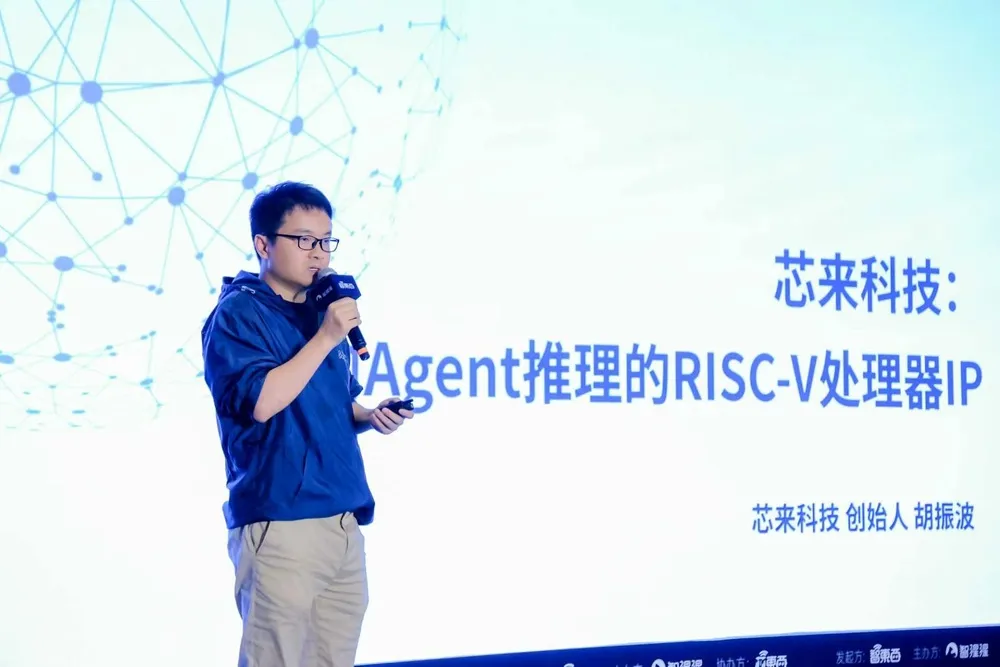
4、芯來科技胡振波:RISC‑V是AI晶片時代最好的ISA,NI系列IP賦能AI晶片
芯來科技創始人、董事長胡振波提到,AI晶片對通用輔助算力的需求日益增長,RISC-V憑藉開放、靈活的架構,可在AI晶片中承擔主控核、算力核及啟動核三類角色。其中,算力核的重要性正日益凸顯。
今年,芯來科技推出面向AI推理的NI1000系列RISC-V處理器IP,支援1024至4096位向量寬度,融合算力核心,以RWV、VME、SFU全域加速AI晶片發展。
相比僅傳統RVV架構,RVV+VME僅增加約15%的晶片面積,即可帶來約2.5倍的矩陣運算性能提升,對比純標量計算提升100多倍以上,NI系列同時相容現有RVV軟體生態。胡振波認為,RISC-V的開放性及自訂擴展能力,有助於AI晶片企業在共享軟體生態的基礎上實現差異化創新,降低開發和學習成本。
5、渢呵智慧丁闊:Token工廠進入精益營運階段,兩大指標形成飛輪效應
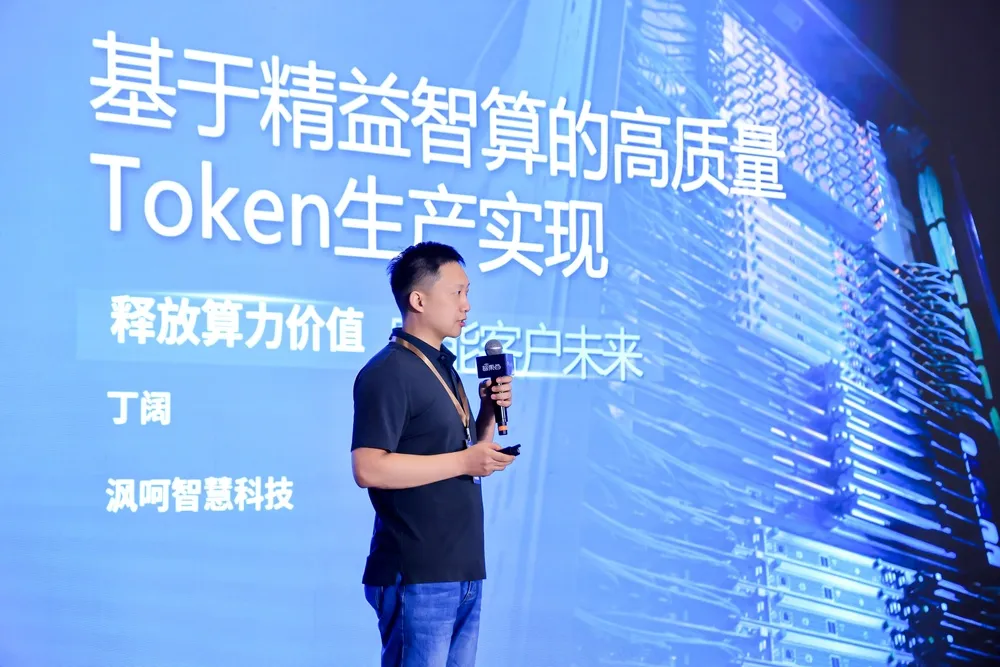
渢呵智慧智算產品總監丁闊提到,圍繞能耗、產能和售賣效率等維度,他們基於兩大指標建立了Token工廠的營運指標體系。
其中TEF(Token效率因子)用來衡量GPU叢集生產Token的效率,由GPU可用率、算力佔用率和有效計算效率共同決定;TFI(Token工廠指數)用於評估商用Token平台的售賣情況,將TEF與服務交付率、Token售出率、價格實現率進行結合。
通過TEF和TFI,Token工廠可以形成飛輪效應,企業能夠憑藉對兩大指標中參數的診斷和調整,從而改善Token業務的利潤,滿足企業經營的目標。渢呵智慧如今的產品交付形態已經從底層算力資源逐步走向標準化的Token產能。
6、IO資本俞楓:晶片創業機會相對平權,硬體公司需要懂模型、懂晶片、懂系統
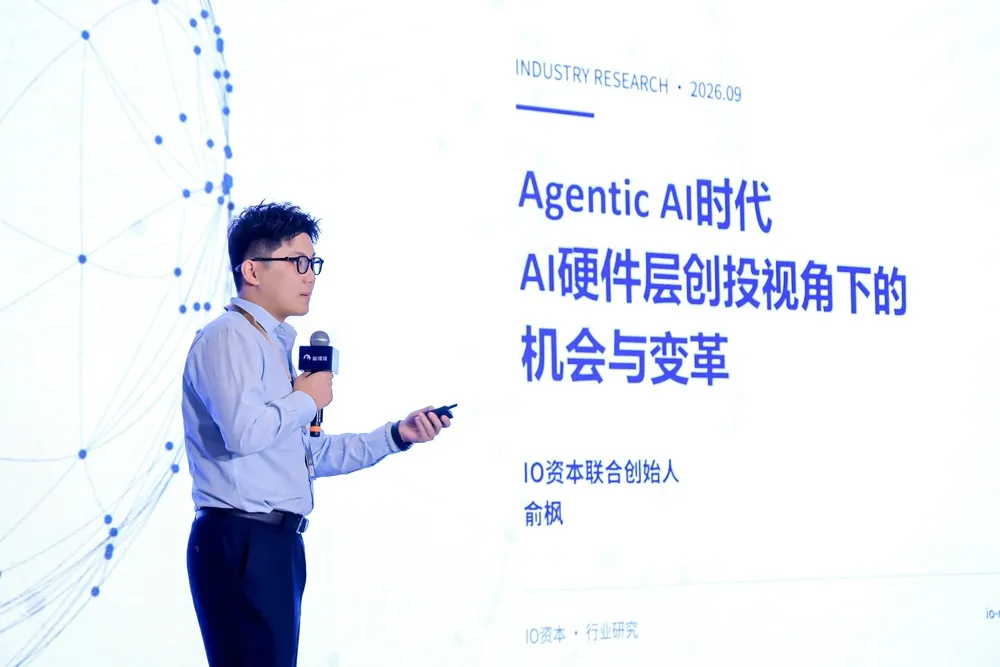
IO資本聯合創始人俞楓對AI晶片及半導體創業比較樂觀。他認為,Agentic AI正處於指數級膨脹的過程,舊的生態壁壘正在加速瓦解。模型快速迭代的同時,AI晶片的需求也走向差異化,大公司無法壟斷所有創新場景,市場正在充分獎勵創新帶來的效能提升,創業公司獲得了與大公司相對平權的機會。
隨著機會增加,創業門檻比以前高得多,團隊不僅要懂晶片,還要懂模型、懂工藝、懂系統。他談道:“沒有模型公司能預測未來兩年會發生什麼變化,但硬體公司卻要提前下注,這對創業公司管理層判斷提出了更高要求。”
05.
不止堆算力!
具身智能產業還要拼架構與生態
具身智能正逐步從實驗研究走向工業製造、家庭服務等實際應用,然而機器人端仍舊需要同時處理高維視覺資訊、動態三維場景以及生成式的動作策略。面臨計算量大、資料翻譯頻繁以及儲存開銷高、即時性要求嚴格和功耗受限等多重挑戰,傳統通用計算平台難以兼顧性能、能效和持續運行能力。
圍繞AI晶片在具身智能賽道的落地,在具身智能晶片高峰論壇上,6位嘉賓分享了各自的最新實踐與思考。
1、復旦大學朱浩哲:具身智能的核心是物理世界下“理解‑行動”的即時閉環
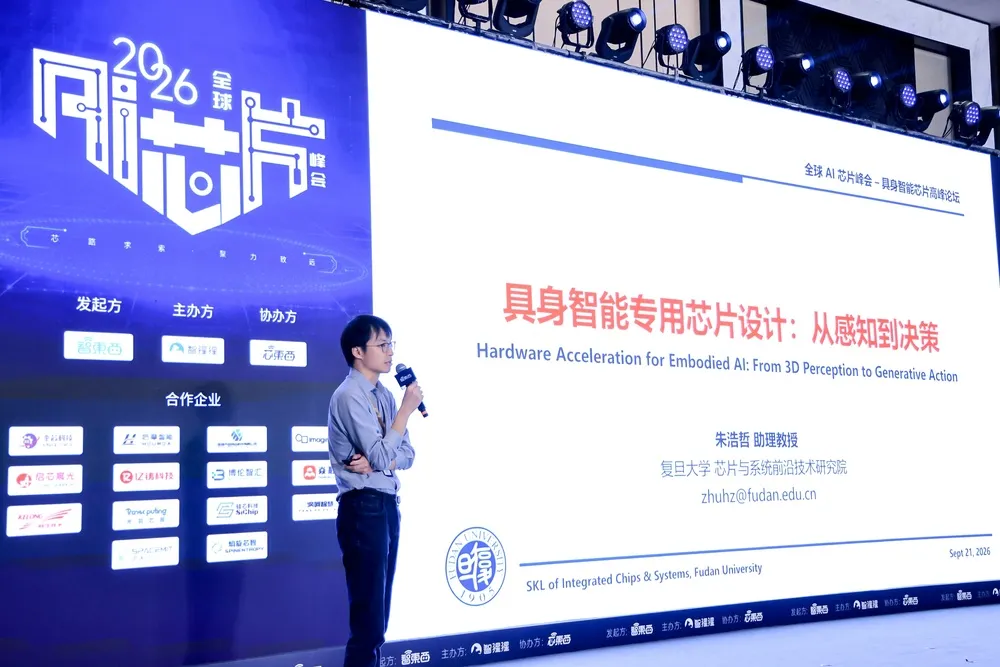
復旦大學晶片與系統前沿技術研究院助理教授朱浩哲提出,具身智能的關鍵性能指標通常不是平均的TOPS或者吞吐率,專用晶片最終要服務機器人的端到端閉環。
報告從“感知—建模—決策—行動”閉環出發,分析三維場景表示、即時定位建圖和視覺—語言—動作模型的計算特點。他介紹了三維高斯潑濺的訓練、渲染與硬體加速方法,並討論VLA模型的推理流程、即時性需求及部署挑戰。結合團隊在3DGS、SLAM和VLA晶片架構方面的研究,報告說明演算法與體系結構協同設計的必要性,並就具身智能專用計算平台的發展方向展開交流。
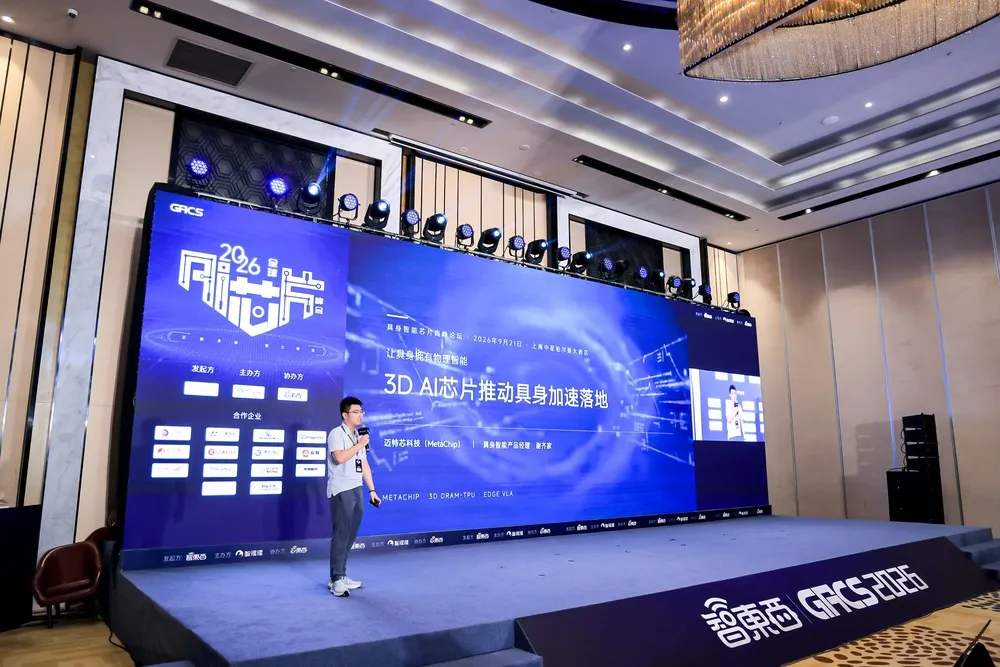
2、邁特芯謝齊家:以3D-IC晶片破解端側VLA落地難題
邁特芯科技具身智能產品經理謝齊家分享了公司為解決端側VLA模型落地而設計的3D晶片方案。他認為,目前VLA模型正在經歷三大趨勢:資料飛輪推動模型參數規模持續變大、快慢系統協同提升動作流暢度、Few-shot模型將率先落地。在此背景下,端側算力需在即時性、功耗、頻寬之間實現平衡。
邁特芯核心技術為3D-IC。在等頻寬條件下,傳統2D方案功耗最高約40多瓦,難以滿足端側要求,而3D-IC方案最高僅需約7W。在PPA微架構上,傳統3D/2D IC共用統一匯流排,資料需要先經匯流排traffic再分發至各PE,耗時明顯。邁特芯採用3D直連架構,讓上層IO直接對應下層PE,顯著縮短頻寬訪問路徑,頻寬利用率可提升至80%以上。
此外,謝齊家還提到,針對Transformer的算術特性進行最佳化、避免算子間的 reshape overhead,是PPA提升的關鍵貢獻點。
3、天數智芯夏廣武:具身智能主控晶片下一步是“大小腦”融合
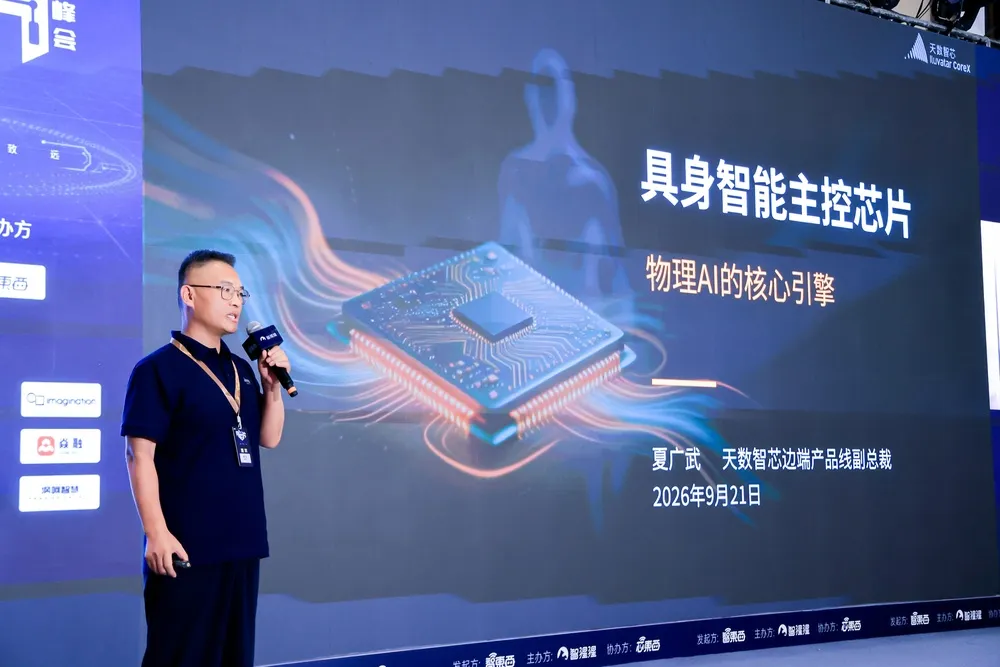
天數智芯邊端產品線副總裁夏廣武提出,後續大模型需要從數字世界走向物理世界,具身智能就是物理AI的具象化,而主控晶片就是物理AI的核心引擎。
在技術特點上,他提到當前是算力分層對應模型分層,大腦負責規劃,小腦負責運控,大小腦在物理上是分離的,下一步會首先在物理上將二者合一;並簡介了天數智芯在具身智能領域的產品佈局和方案特點。就如何推進具身智能產業發展和落地,他總結了四個抓手:開放的軟體棧平台及工具鏈、開發者生態社區、產業鏈協同發展、具身落地的工程化思考,並指出產業發展需小步快跑,重在跑通某一具體場景的端到端業務,積小成至大成。同時還需各方合作,建立人才培養資源池,夯實具身智能發展的基礎。
4、進迭時空陳儉東:RISC‑V同構融合計算,打造機器人軟硬同構算力平台
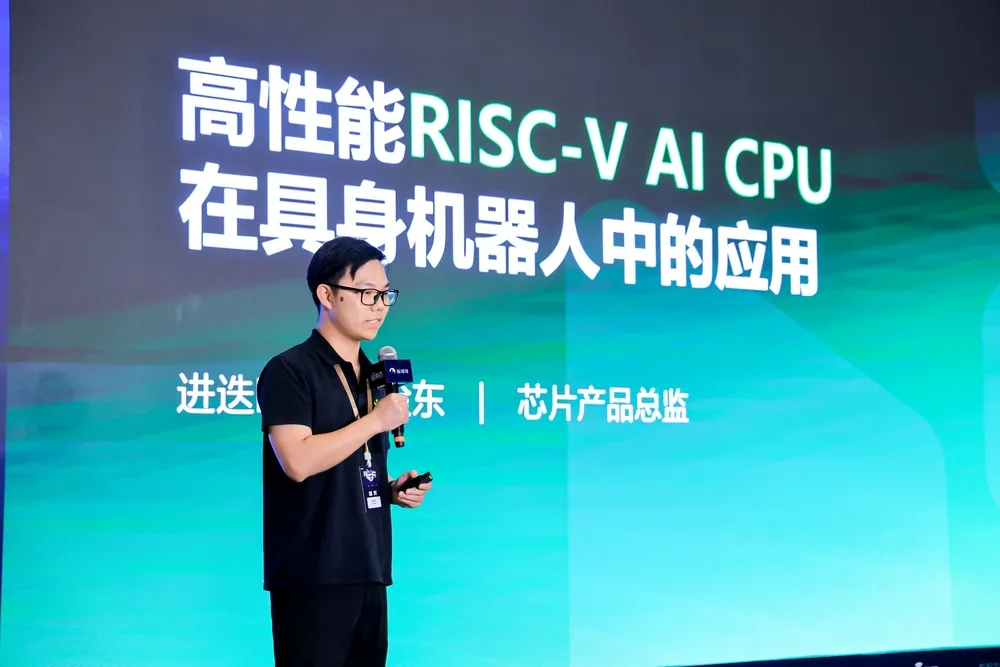
進迭時空晶片產品總監陳儉東認為,行業正邁入機器人電腦的新時代。當前具身機器人普遍採用多異構計算方案,存在軟體生態割裂、資料反覆搬運、硬體冗餘、開發門檻高等痛點。
團隊針對這些痛點,基於RISC‑V架構推進同構融合計算,依靠統一架構、記憶體和軟體系統實現CPU算力、AI算力和即時算力的按需分配。
目前,進迭時空兩代晶片已量產發佈。K1為第一代,AI算力為2T;第二代K3為八核CPU,主頻達到2.4G,AI算力達60T,支援部署30B模型。陳儉東透露,後續將開發更高平台算力的大小腦融合晶片。
5、維泛智能殷積磊:不只拼算力,還要建構具身算力生態
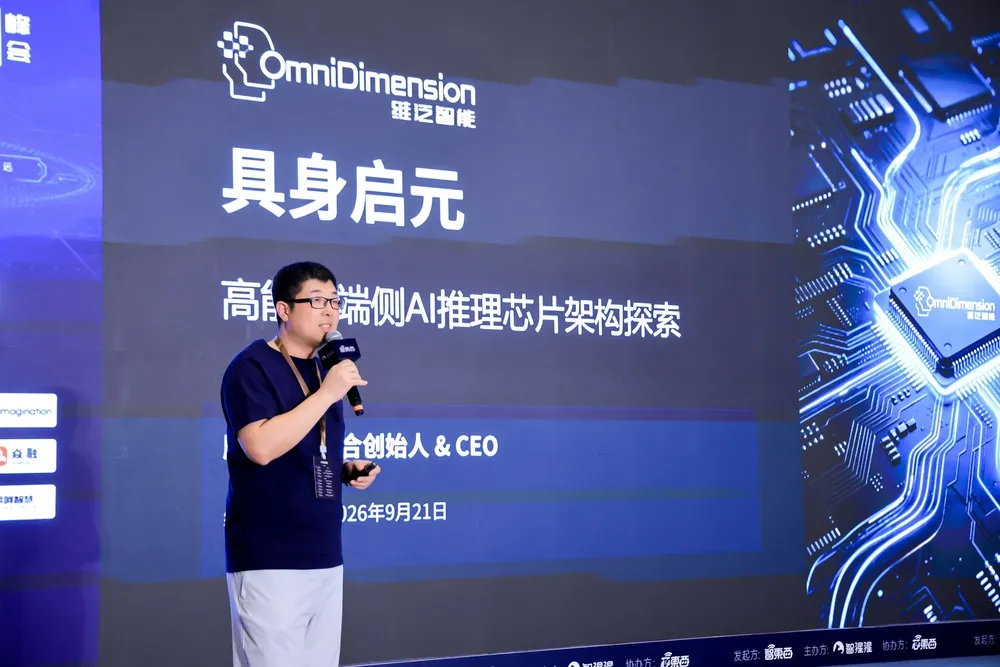
維泛智能創始人兼CEO殷積磊指出,“大腦”晶片當前面臨算力不足、能效失衡痛點,百TOPS算力只是具身大模型端側運行的起步門檻,同時還需要兼顧FP8、BF16、FP16等混合精度計算,以及即時響應和7×24小時穩定運行。
為此,他提出仿生類腦晶片BiGPU架構,引入新的計算範式減少資料搬運和儲存帶來的能耗,並原生支援FP8及脈衝神經網路,適配具身場景下不同模型和計算任務。
殷積磊稱,目前規劃的晶片算力為100~1000TOPS,但機器人晶片的競爭不只看峰值算力,還要看有效算力、能效和部署效率。未來,維泛智能將探索建構面向機器人的“Brain OS”,推動多方生態協同發展。
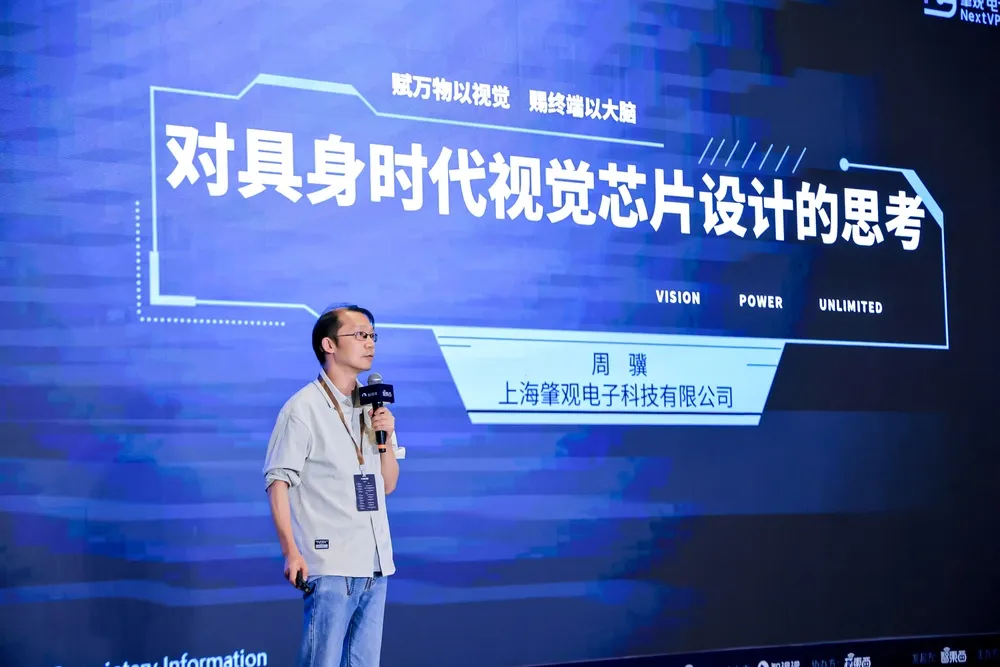
6、肇觀電子周驥:降低視覺處理功耗和成本,有利於具身智能更快落地
具身智能落地的關鍵在於低功耗、低價格,而降低視覺處理的功耗和複雜度是其中關鍵的一環。作為生物進化的頂端,人類視覺給具身智能的視覺系統的設計提供了參考和啟發。肇觀電子CTO周驥認為,未來視覺晶片不應一味追求大吞吐與大解析度,應利用時域資訊與生成式模型提升性能。視覺系統和語言/運動之間以高度壓縮的Token傳遞資訊,用生成式模型來取代傳統ISP(傳統訊號處理),大解析度圖像只在需要對智能體行為進行解釋時輸出。
現階段的視覺晶片有四大問題待解決:需補全機器人感知能力,缺失其他感官輸入不利於降功耗;需要業界共同努力改變軟硬體架構;VLM在端上運行仍然很吃力;目前現有Token壓縮效率相比人腦差距較大。
06.
結語:奔赴智能體時代
AI算力開啟精細化、場景化新週期
從晶片架構革新、3D堆疊先進製程,到KV Cache最佳化、異構混訓混推等演算法算力協同技術,再到智能體、具身智能全新推理場景的探索,2026全球AI晶片峰會全方位覆蓋當下AI算力產業的熱點、難點與痛點議題。
當前,智能體技術的全面爆發,正在倒逼全球AI晶片產業格局迎來重構。過往單一的峰值算力指標,已無法適配大模型時代複雜的算力需求,資料儲存、傳輸、互動、互聯的全鏈條效率,以及功耗控制、成本可控性、工程化落地能力,共同定義了新時代AI晶片的“有效算力”。
隨著架構創新持續深化、軟硬體生態不斷完善、場景落地持續滲透,AI晶片或進一步擺脫“重參數、高消耗、低效能”的發展瓶頸,實現算力、功耗、成本、場景的更優匹配。
放眼未來,AI算力作為AI產業的核心底座,其迭代進化將持續牽引整個AI產業的發展走向。 (芯東西)