
GPT-6 Sol、Luna深夜上線,API價格直接砍半!
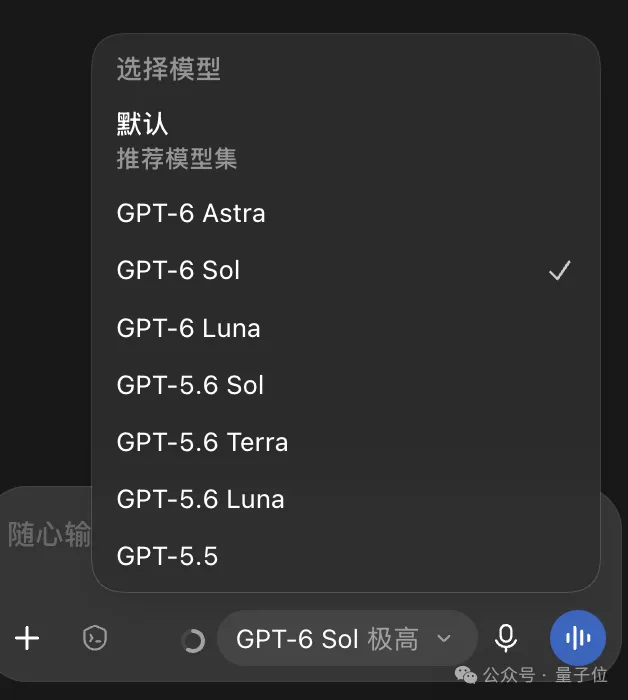
Astra改進的訓練方法這兩款也都用上了,所以也繼承了Astra在電腦使用等方面的提升。
那還有啥好說的,等於5.6系列直接被斬殺了唄。
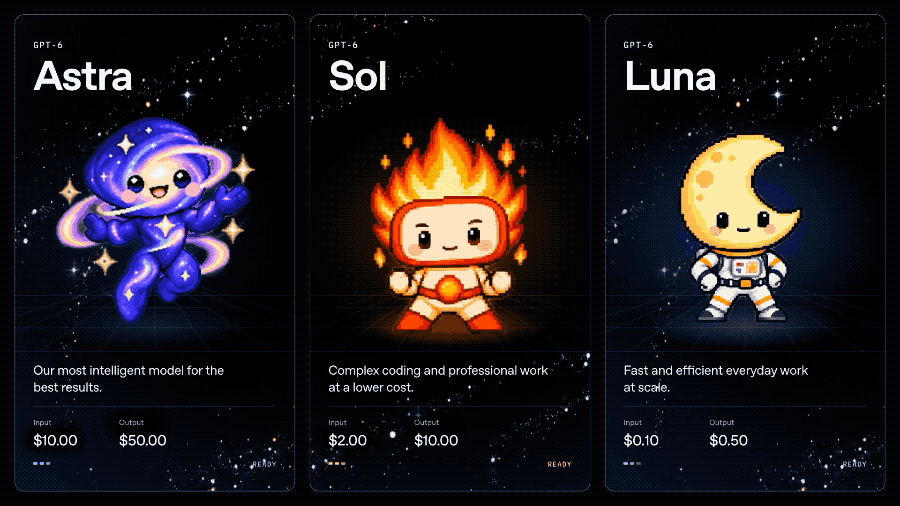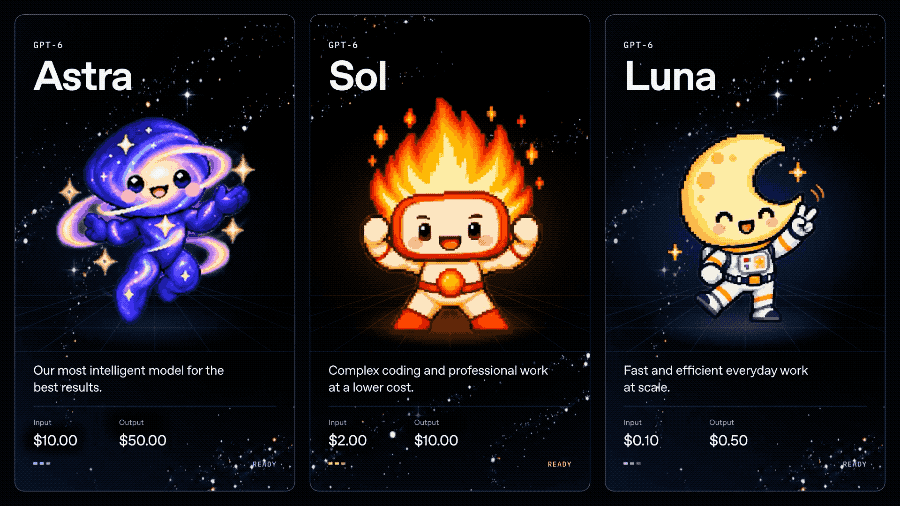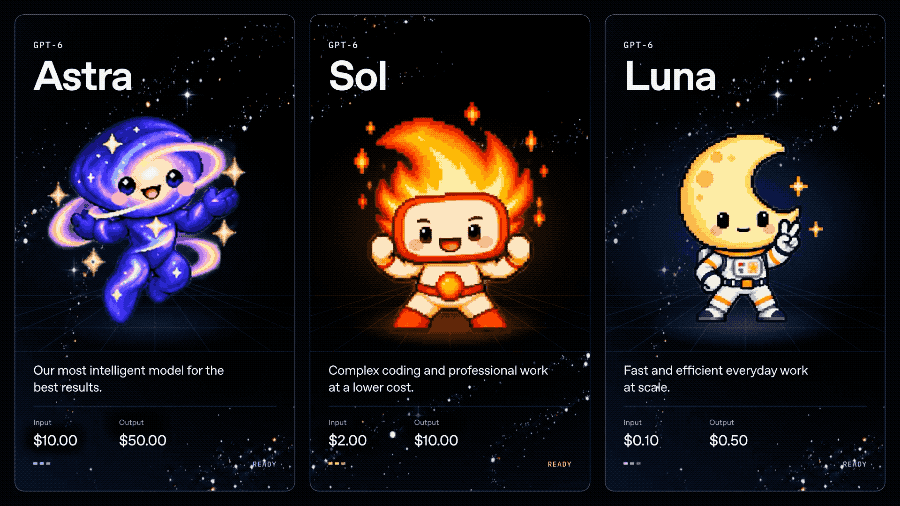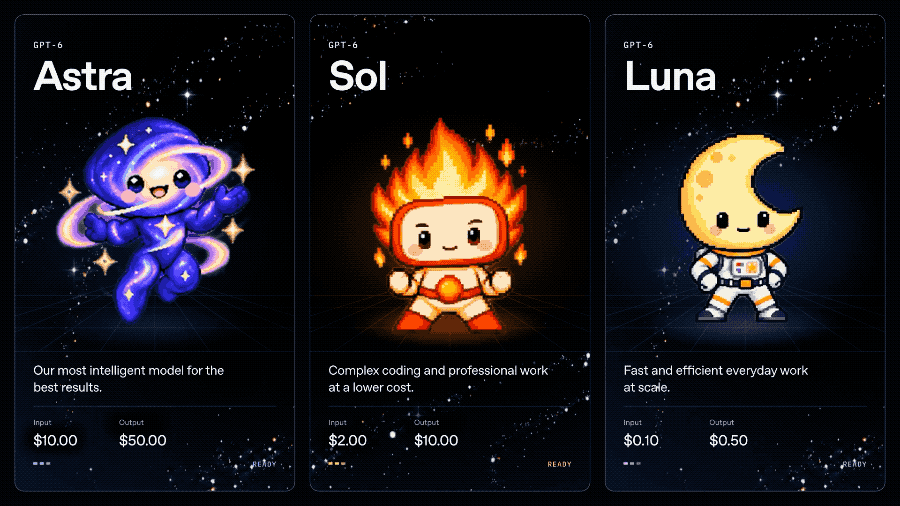
現在系列裡Astra負責當以前的Sol,Sol負責當以前的Terra,Luna還是以前的Luna。
Terra生態位直接被擠沒了。
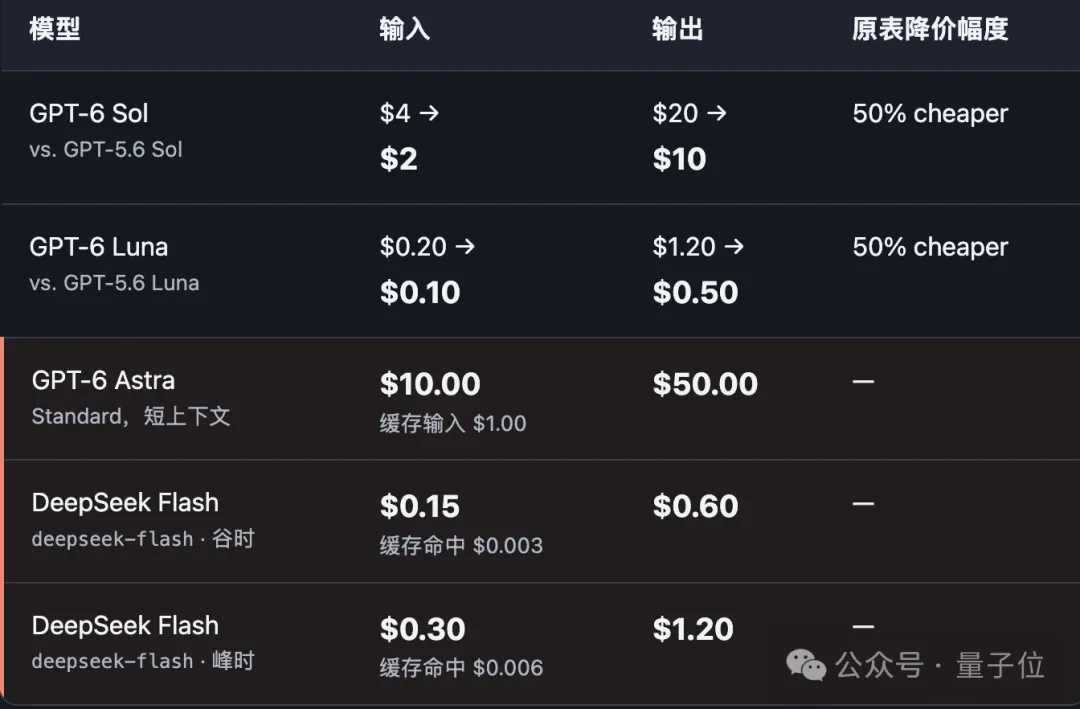
與5.6系列相比,6系列的API定價直接砍50%,其中Luna的輸出砍得比50%還多一點。
而且Luna的輸入價格比DeepSeek-V4.1 Flash的梁文谷價格($0.15)還便宜一點了,就是不知道快取命中率有沒有的比。
為何升級還便宜了?
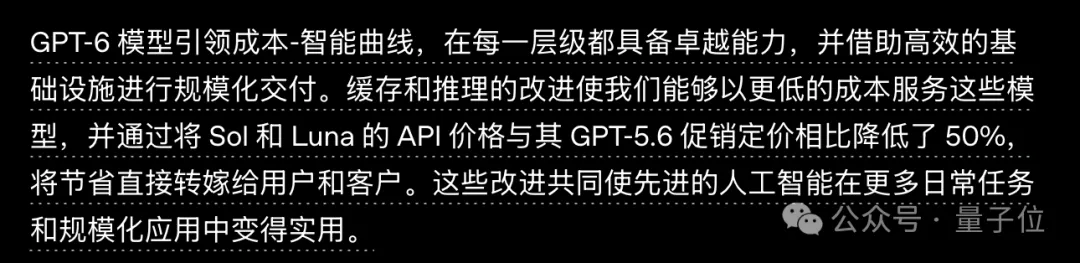
OpenAI稱這得益於快取和推理環節的效率提升,省下來的成本直接讓利給使用者和開發者。
這不得尊奧特曼一聲奧特之王(限時24小時)。
用一成價格,盯著Fable打
整個發佈公告看下來,我先學會一招,用GPT-6 Sol最好別開Max。
效果提升有限,價格提升很大,就不如直接開Astra了,還有個別榜單跑分Max比xHigh掉分。
什麼你不知道怎麼在Codex裡開Max?
在設定裡可以選,默認是沒打開的,這下知道為什麼沒打開了。
按照AutomationBench這個榜,GPT-6 Sol的high和xhigh兩個檔位已經摸到了Astra的light和medium的水平。
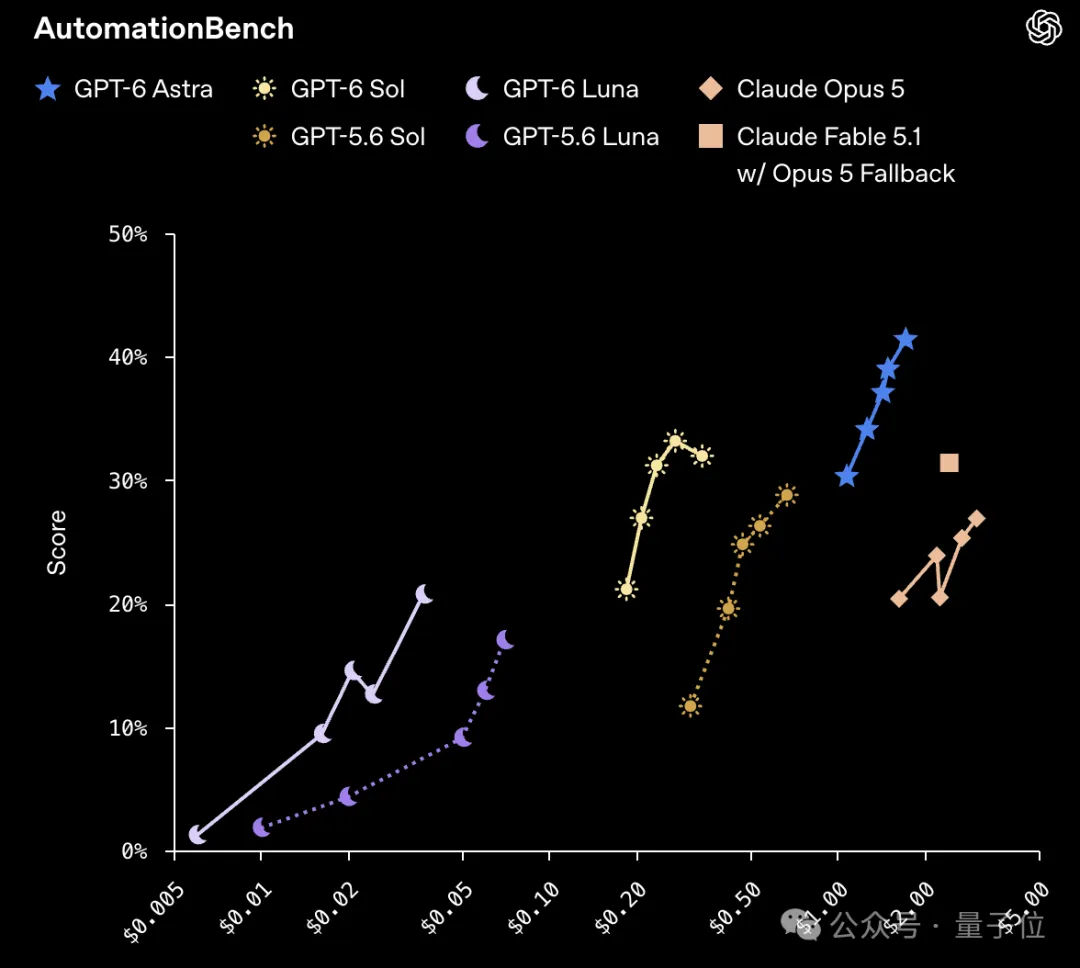
AutomationBench測的是AI在銷售、行銷、營運、客服、財務和人力資源六大領域47個工具上執行端到端業務流程的能力。
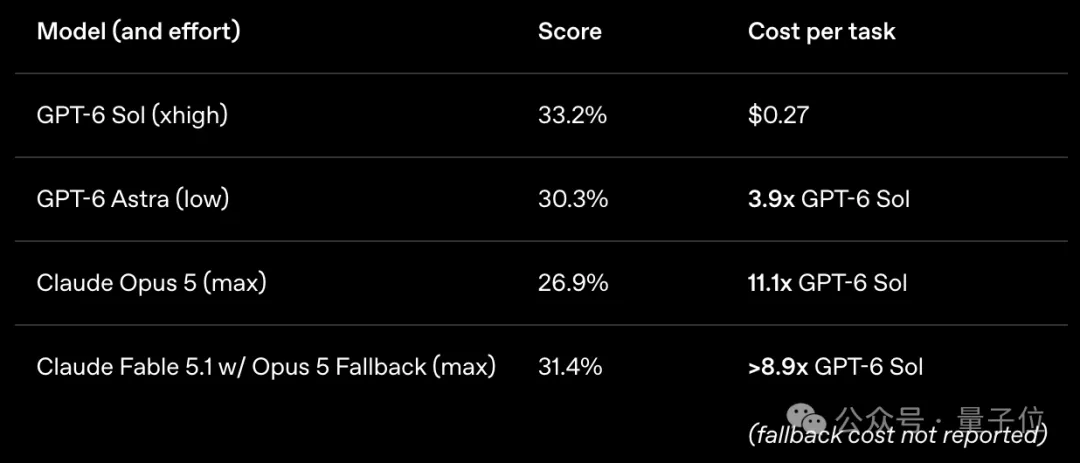
作為對比,Claude Opus 5在max effort下得分和GPT-6 Sol的medium差不多,但單任務成本是Sol的11.1倍。
Claude Fable 5.1,成本是Sol的8.9倍以上,而且這還沒算上約40%任務觸發Opus 5回退產生的額外開銷。
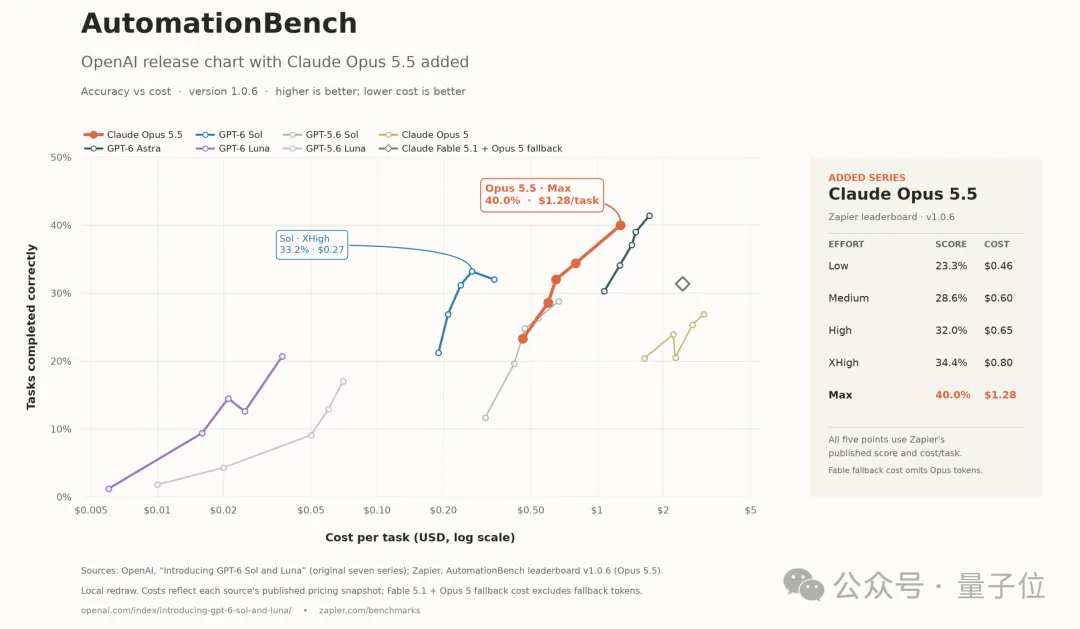
為測試GPT-6 Sol的電腦使用能力,我讓它在圖表中把隔壁新發的Opus5.5成績也畫上去。
這下可以直觀看出,Opus5.5的Max檔達到了GPT-6 Astra水平,價格也達到了Astra水平。
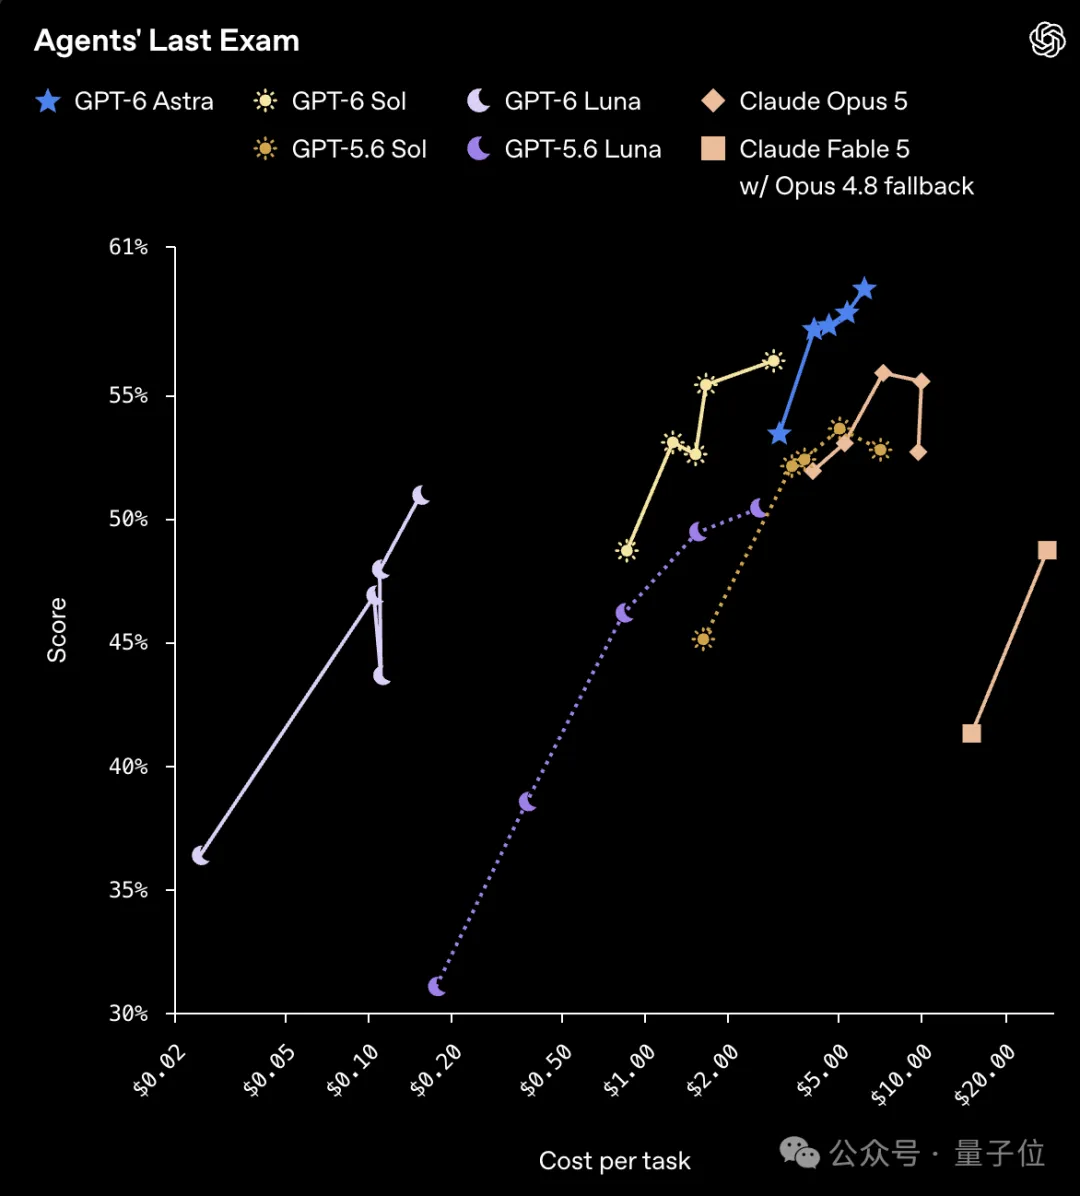
換Agents' Last Exam,這次考長周期任務,覆蓋55個子行業。
GPT-6 Sol在max effort下得分56.4%,超過Claude Opus 5在該測試中的最高分,成本還低了60%。
程式設計是這次重點展示的方向。
OpenAI透露了一組內部資料:公司內部的Coding Agent使用量呈指數級增長,按API價格折算,中位數研究員每天的token消耗已超過600美元,90分位的研究員超過7000美元。
隨著程式設計agent承擔的任務越來越長、越來越複雜,持續使用的成本變得更加關鍵,這正是Sol和Luna要解決的問題。
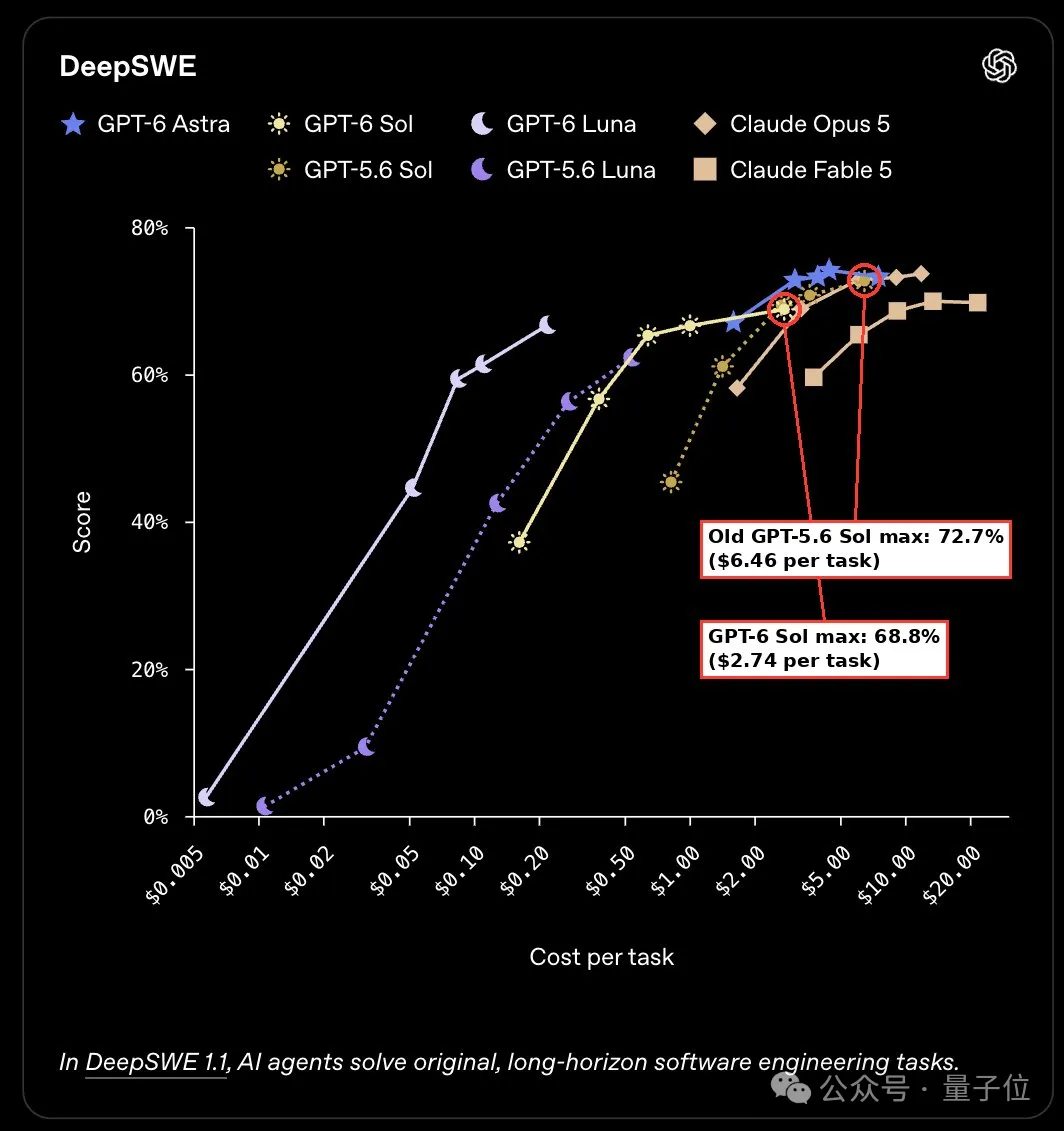
在DeepSWE v1.1(測試AI在真實程式碼庫中解決複雜軟體工程任務)上,GPT-6 Sol其實並沒有比5.6 Sol更好,但確實便宜不少。
GPT-6 Luna在max effort下得分66.6%,與Claude Opus 5和Fable 5在medium effort下水平相當,成本分別低了93%和96%。
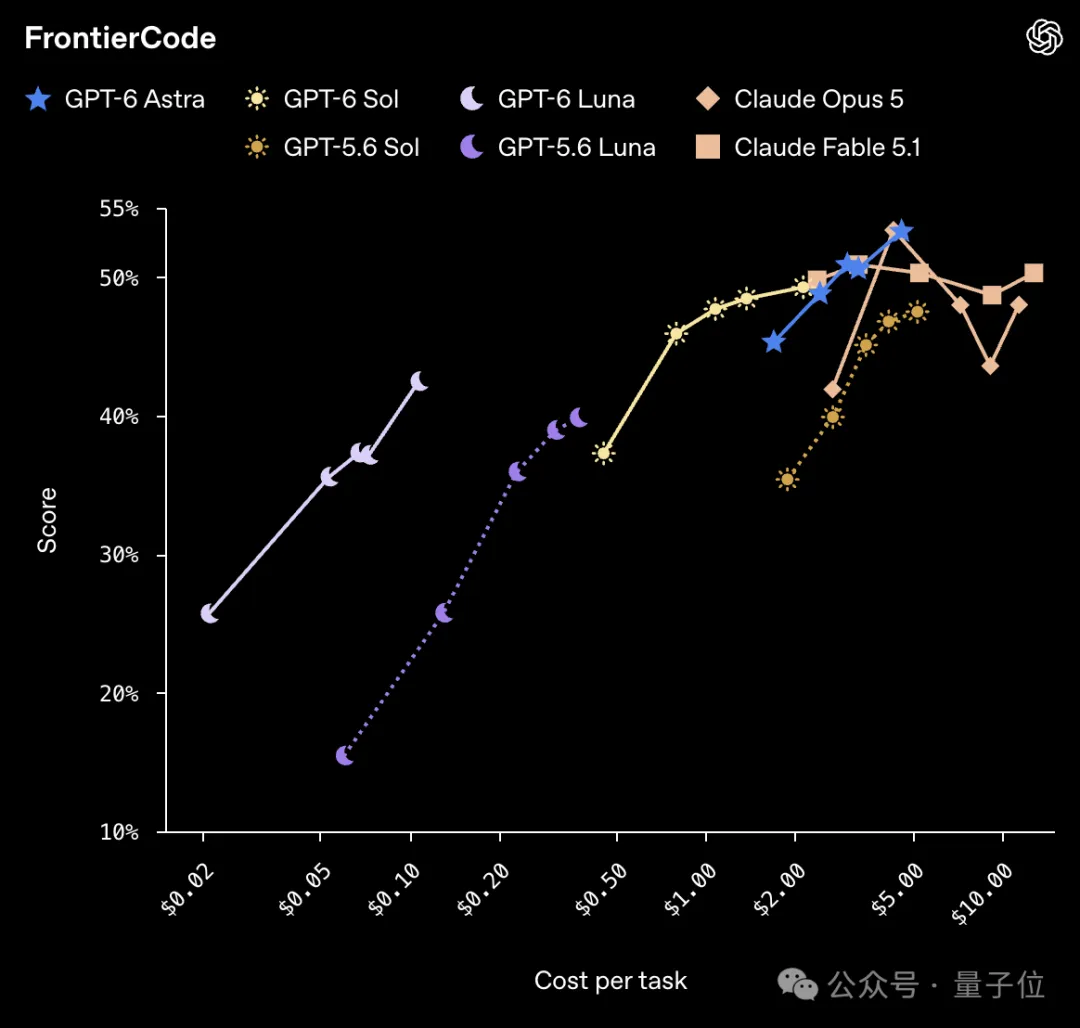
在Cognition推出的FrontierCode(評估AI編寫的程式碼是否達到可合併進真實程式碼庫的標準)上,GPT-6 Sol相比GPT-5.6 Sol同樣有明顯提升,能以更低成本匹配Claude Fable 5.1 xhigh的表現。
這個榜隔壁Claude的檔位又亂了起來。
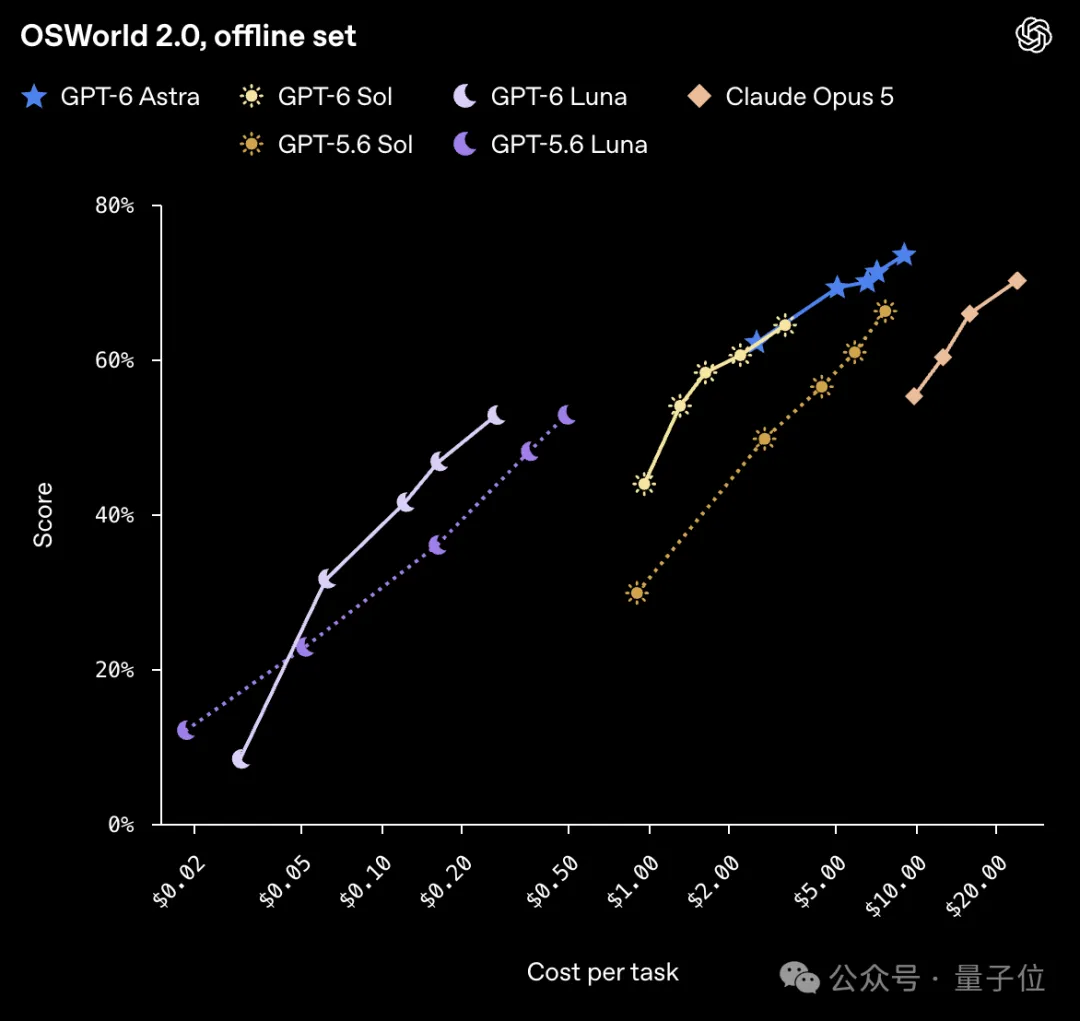
電腦操作,這塊還是Astra比較權威。
GPT-6 Sol也僅僅是比5.6 Sol便宜了,high檔位以上水平其實沒超過5.6多少。
GPT-6 Luna在max effort下超過了GPT-5.6 Sol在medium effort下的表現,成本僅為後者的十分之一。
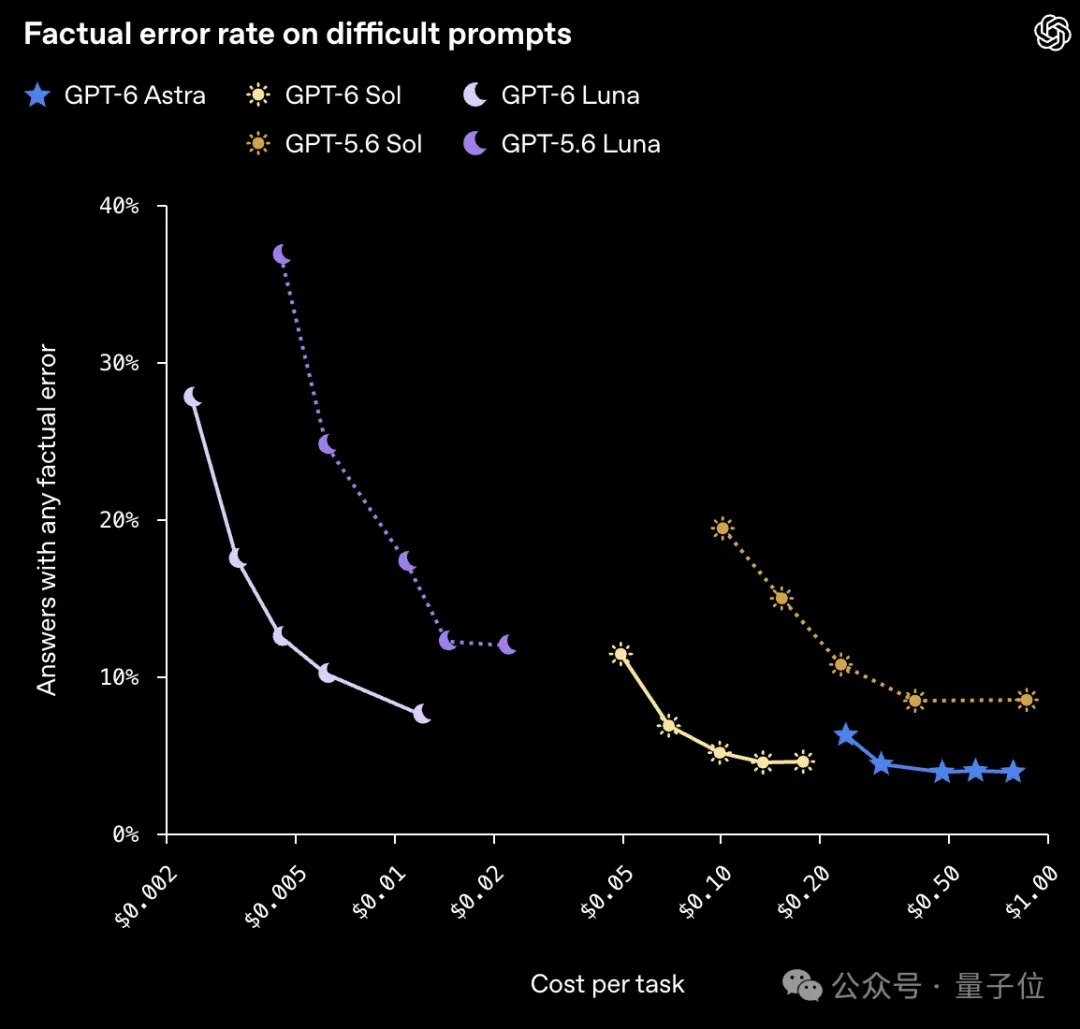
事實精準性方面,OpenAI用一組從真實ChatGPT對話中提取的、使用者曾標記過事實錯誤的案例進行了測試。
結果是GPT-6 Sol的錯誤率大約是上一代的一半,接近Astra的水平。GPT-6 Luna在較高effort下能匹配GPT-5.6 Sol的精準度,而成本只有百分之一。
快取命中率提升,重設馬上來
模型能力之外,OpenAI對GPT-6的基礎設施也做了幾項改進。
首先是提示詞快取。
改進後的快取機制默認提供更高的命中率,快取命中的輸入token可享受90%的價格折扣。
OpenAI還上線了快取監控面板和診斷工具,開發者可以查看快取使用情況、定位未命中的原因並針對性最佳化。
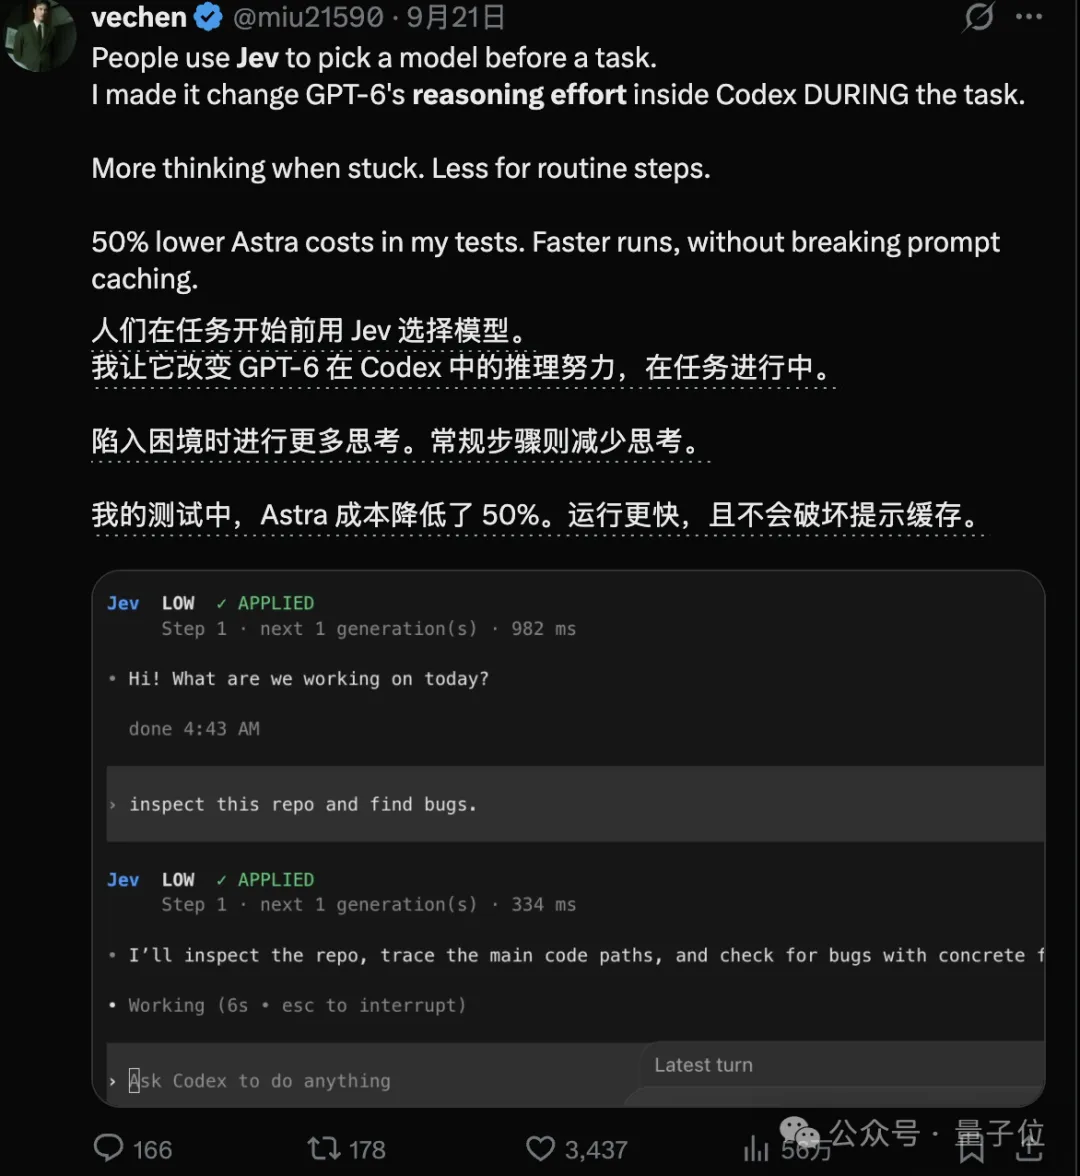
還有這樣一個實用的改動:調整推理effort等級或開關工具時,不再會打斷之前的快取上下文。
GitHub已經在用這套方案。據OpenAI披露,過去幾個月裡這些最佳化讓GitHub Copilot需要重新處理的提示token比例下降了超過50%,涉及數十億次請求。
終於能在任務的不同任務靈活切換組態了。
之前看已經有人做出來,搭配Jev可以在任務中途毫秒級切換。
然後是對話風格。
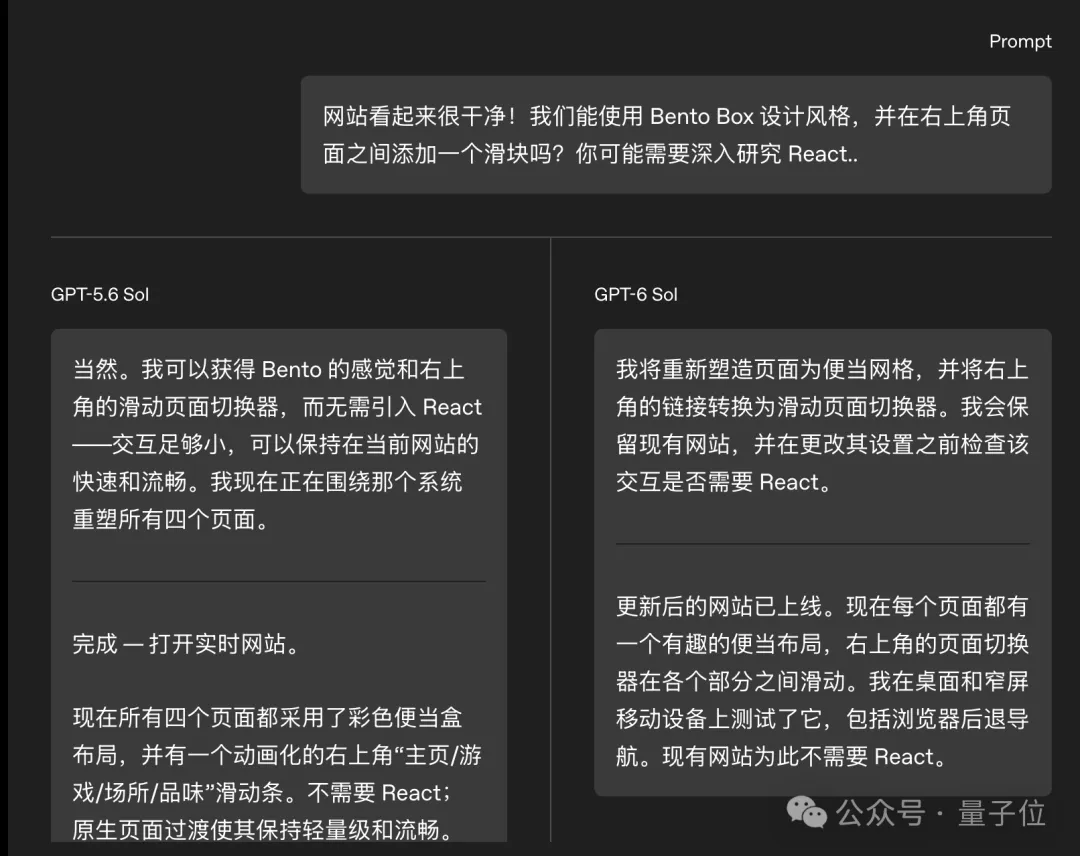
OpenAI把Astra上改進過的溝通方式帶到了Sol和Luna上,在技術和程式設計對話中感知會尤為明顯,表現為更清晰、更少術語、更少無效細節、回覆整體更簡短但不丟失關鍵資訊。
OpenAI在部落格中展示了同一個網頁開發任務下GPT-5.6 Sol和GPT-6 Sol的對比回覆。
5.6會主動複述使用者已知的資訊並使用含糊措辭,6則更直接,會說明自己檢查了什麼、沒檢查什麼。
對齊方面,Sol和Luna在測試中優於GPT-5.6同級模型,包括在程式設計任務中做出誤導性聲明的比率更低。OpenAI強調,這些對齊測試專門挑選了容易誘發不誠實行為的場景,正常使用中出現此類問題的機率遠低於測試資料。
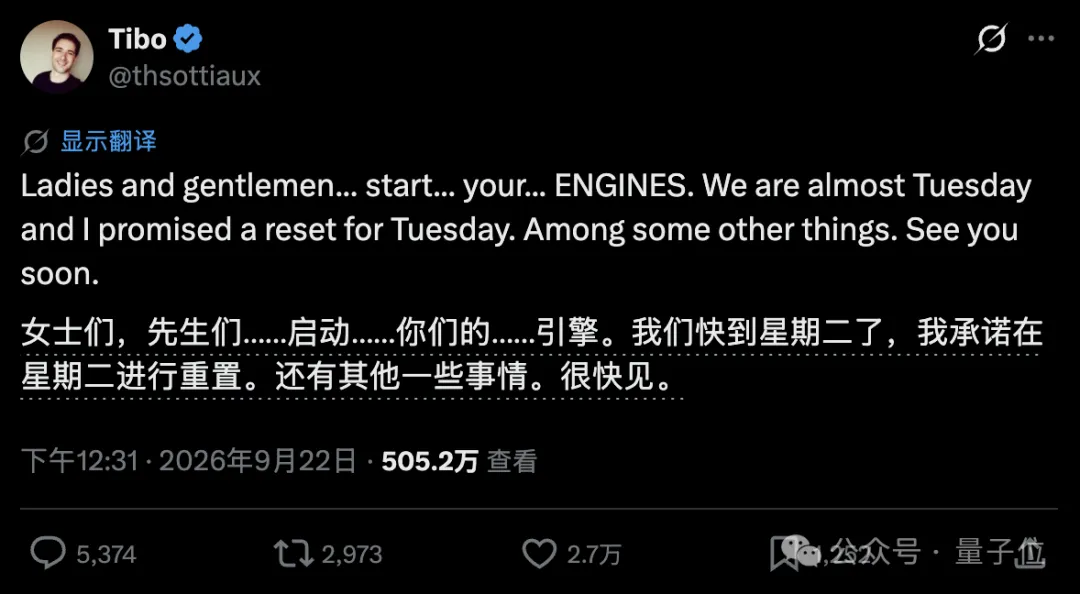
最後,關於額度重設。
總之是周二,具體時間未定,醒來的朋友們可以開蹬了。
(量子位)