
平時我們搭 Agent 工作流或者客服系統,經常會遇到這類需求:判斷使用者想幹嘛、工單分到哪個部門、該調哪個具體工具。這類事情沒有開放式創作的要求,可如果每次都扔給幾十億參數的自回歸大模型,哪怕只吐一個詞,也得乾等幾百毫秒,輸出偶爾還夾帶解釋廢話或者殘缺的 JSON。
前段時間 TypeSafe 推出 Jev 專門做這類判斷,單次前向幾毫秒就能搞定,但目前只有雲端付費 API,權重沒有開放。開源社區很快做出了完整復刻,Laya 用 Apache-2.0 協議放出了全部模型權重,可以拉回本地自己跑。
這篇文章給大家簡單介紹 Laya 是什麼,然後介紹四步流程把它的部署跑通。指定模型、視訊記憶體最佳化、實驗倉庫這些內容統一放在教學後面,不打斷上手過程。文中的延遲和視訊記憶體資料,都在 aarch64 架構的 GB10 算力卡(20 核 CPU,121 GB 統一記憶體,PyTorch 2.14.0+cu130)上測出。
文中用到的安裝命令、最小指令碼和全部實測日誌都放在這個倉庫裡,可以直接 clone 下來跟著跑,如果視訊記憶體不足的讀者,想要看看運行結果可以去下面的地址,直接看執行日誌,這樣就不用下載模型運行了:https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/laya(https://github.com/li-xiu-qi/XiaokeAILabs/tree/main/experiments/test_jev_open_source/laya)
01. Laya 是什麼
Laya 做決策,不生成文字。Qwen、Claude、ChatGPT 屬於自回歸解碼器,推理時逐 token 序列生成,哪怕只輸出一個類別名稱,也得走完整個生成週期。
Laya 走的是判別式路線,骨幹是 ModernBERT 這類雙向編碼器。輸入文字(State)和待判定的問題(Questions)一起輸入到模型,末層直接輸出各個選項的機率分佈。實測單題前向 p50 在 8.31 毫秒(中文 multilingual 分支)到 16.41 毫秒(英文 english 分支)之間,三套權重全量常駐的 CUDA 佔用在 4 到 6 GB,單卡即可承載。
它不適合寫文章或長文字總結,適合意圖識別、路由分流、安全護欄這類確定性判定任務,作為大模型的前置元件降低流水線延遲。
02. 保姆級部署跑通教學
第一步,環境組態與依賴安裝
跑 Laya 建議準備一張 6 GB 以上視訊記憶體的顯示卡,系統記憶體 16 GB 以上。Linux 和 macOS 都支援(x86_64 與 aarch64 架構均可),Python 要求 3.10 或更高(實測環境為 Python 3.12)。
建議單獨建一個乾淨的虛擬環境,避免和其他項目的依賴版本衝突。在終端敲下面幾行(Windows 把第二行替換成 ~/laya-env/Scripts/activate)。
# 建立並啟動虛擬環境python -m venv ~/laya-envsource ~/laya-env/bin/activate
# 安裝 laya 核心庫pip install laya
裝完看一下版本。
pip show laya
版本在 0.3.5 以上即可。國內伺服器從 HuggingFace 拉權重時,先組態鏡像環境,避免下載卡住。
exportHF_ENDPOINT=https://hf-mirror.comexportHF_HUB_DISABLE_XET=1
第二步,權重與自動分流
官方目前放出三個預訓練權重,分工如下。
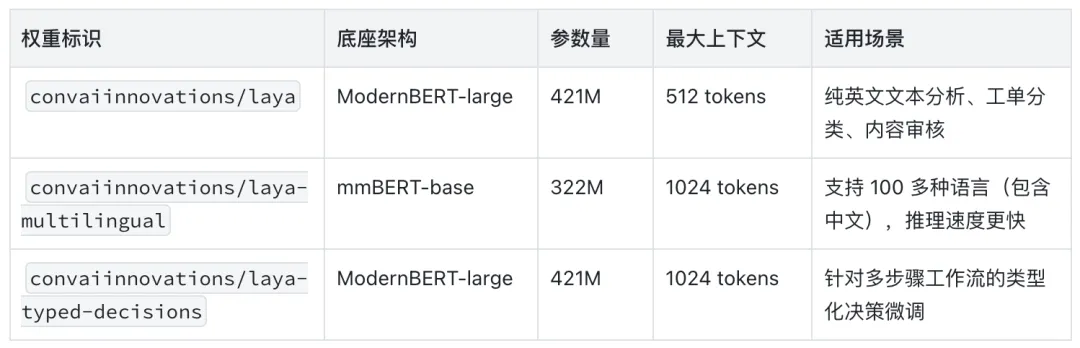
日常使用不需要手動挑權重。官方封裝的 Router 介面會識別輸入語種並調度對應分支,輸入以中文為主時自動走 laya-multilingual,直接初始化 Router 即可,具體寫法就在下一步的指令碼裡。
第三步,編寫最小運行指令碼
我們先跑一個最簡單的驗證指令碼 test_laya.py,看看它怎麼接收輸入並給出結果。
from laya import Router
# 初始化路由器,指定使用 GPU 並預載入權重
router = Router(device="cuda", preload=True, max_loaded=3)
# 1. 待分析的輸入文字
state = {
  "from": "user@acme.com",
  "subject": "Duplicate charge on invoice #4411",
  "body": "Hi, we were billed twice for March. Please refund the duplicate today or we will cancel your plan."
}
# 2. 定義判定問題與候選選項描述
questions = {
  "department": {
    "type": "choice",
    "instructions": "Which department should handle this request?",
    "criteria": {
      "billing": "invoices, payments, refunds",
      "technical": "bugs, outages, system errors",
      "sales": "pricing, new contracts",
      "other": "everything else"
    }
  }
}
# 3. 執行前向推理
result = router.predict(state, questions)
# 4. 列印路由去向與判定結果
print("路由到:", result["routing"]["model"])
print("判定結果:", result["answers"]["department"]["choice"],
    "置信度:", round(result["answers"]["department"]["confidence"], 4))
在終端執行,第一次跑會自動把權重下載到本地快取。
python test_laya.py
第四步,看懂返回結果
執行完後,result 是一個標準 Python 字典,不需要用正則摳答案,也不用擔心 JSON 缺括號。下面是在 GB10 上跑完 test_laya.py 拿到的完整真實返回結構。
{
  "model":"laya-rl-agent",
  "answers":{
    "department":{
      "type":"choice",
      "choice":"billing",
      "probabilities":{
        "billing":0.9582,
        "technical":0.017,
        "sales":0.0134,
        "other":0.0114
      },
     "confidence":0.8419,
     "action":{
       "act_probability":1.0
    }
  }
},
  "usage":{
    "input_tokens":96,
    "output_tokens":0
},
"routing":{
  "model":"english",
  "repo":"convaiinnovations/laya",
  "reason":"English Latin text",
  "detection":{
    "script":"latin",
    "script_profile":{
      "latin":1.0
    },
    "language":"en",
    "is_english":true,
    "language_undecided":false,
    "diacritic_rate":0.0,
    "non_latin_fraction":0.0
  },
  "workflow":null
  }
}
把這個返回體落到業務程式碼裡,看三個核心欄位。
1. 勝出選項(choice):直接讀 choice 拿到結果 billing。答案裡還有一個 action.act_probability 欄位,官方在 Honest limits 說明裡提過,它目前讀出來幾乎恆為 1.0,和精準率反向,做門控用 confidence,不要讀這個欄位。
2. 置信度與機率分佈(probabilities / confidence):probabilities 給出各個候選標籤的機率分佈(和為 1),confidence 是校準後的綜合置信度。可以按它設流轉門檻,得分太低就轉人工或者召回大模型兜底。
3. 路由詳情(routing):routing 記錄本次請求走了哪條分支以及判定理由。換成中文輸入時,reason 會變成類似 non-Latin script (han, 95% of letters); the English checkpoint cannot read it 的描述(比例隨輸入的中文佔比變化),並自動切到 multilingual。頂層的 model 欄位固定顯示為 laya-rl-agent,那是底層運行標識,判斷實際分支要讀 routing.model。
除了單選題(choice),Laya 還支援打分題(score,輸出各檔位分佈)和是非題(boolean,輸出真值機率),在 questions 裡改 type 指定。同一個 state 下可以放多個問題,單次前向一起算出。
03. 指定模型與視訊記憶體最佳化
默認流程跑通之後,如果業務只涉及單一語種,或者視訊記憶體比較緊張,可以手動指定模型分支。這裡集中給出三種方式和它們的實測代價。
第一種,Agent 直調鎖定單個分支,繞過 Router,只載入一套權重。
from laya import Agent
# 只載入 multilingual 分支,不載入 english 和 typed-decisions
agent = Agent("convaiinnovations/laya", device="cuda", subfolder="multilingual")
result = agent.predict(state, questions)
第二種和第三種都基於 Router。構造時傳 default 設全域兜底,它只在語言檢測失效時生效,日常請求仍走自動檢測;predict 時傳 model 做單次覆蓋,優先順序最高,語種檢測整個跳過。
# 全域兜底:檢測不到語言時走 multilingual
router = Router(device="cuda", default="multilingual")

# 單次覆蓋:這一批請求固定走某個分支
result = router.predict(state, questions, model="multilingual")
手動指定拿掉了路由保護,指定錯分支的代價會直接體現在置信度上。我們用同一句中文輸入把四種模式完整跑了一遍。
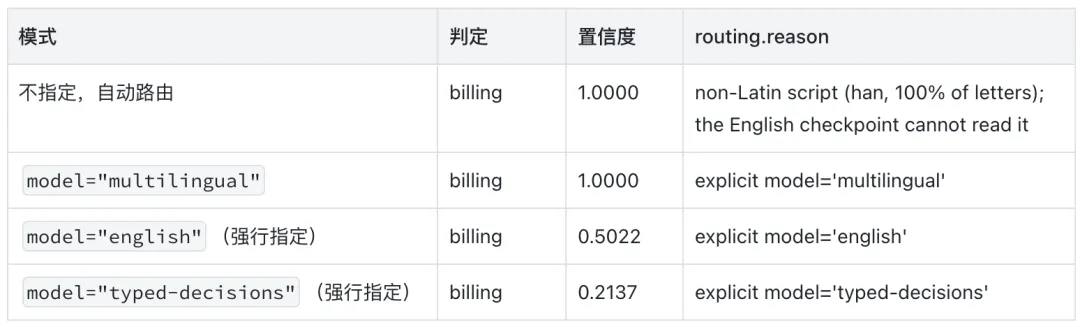
後兩行說明問題。同一句中文送給只見過英文的 english 分支,置信度從 1.0 掉到 0.50;送給沒做過該場景微調的 typed-decisions 分支,只剩 0.21。中文場景下手動指定分支要用 multilingual,其餘情況交給 Router 自動分流。
三種呼叫方式的開銷對比如下(中文輸入,p50)。
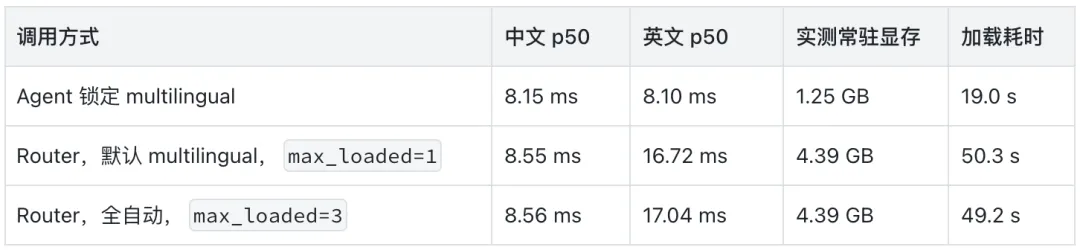
兩個結論。延遲上三者持平,Router 做一次語種判定只多花 0.2 毫秒左右。視訊記憶體差別大,Router 為了隨時切換會把權重留在視訊記憶體裡,實測駐留 4.39 GB;Agent 鎖定單分支只佔 1.25 GB,單語言業務視訊記憶體吃緊時用它最省。
三個權重在 HuggingFace 上的首頁如下,參數規模和定位都寫在卡片裡。
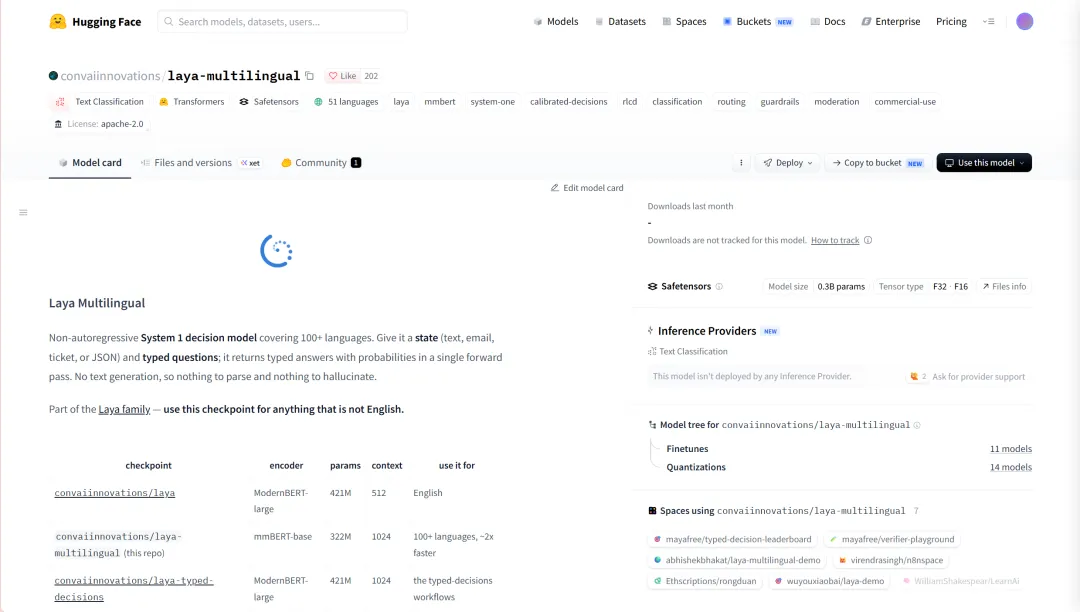
convaiinnovations/laya 的 HuggingFace 卡片。卡片寫明單次前向約 33 毫秒返回帶機率的判定結果,且不做文字生成。
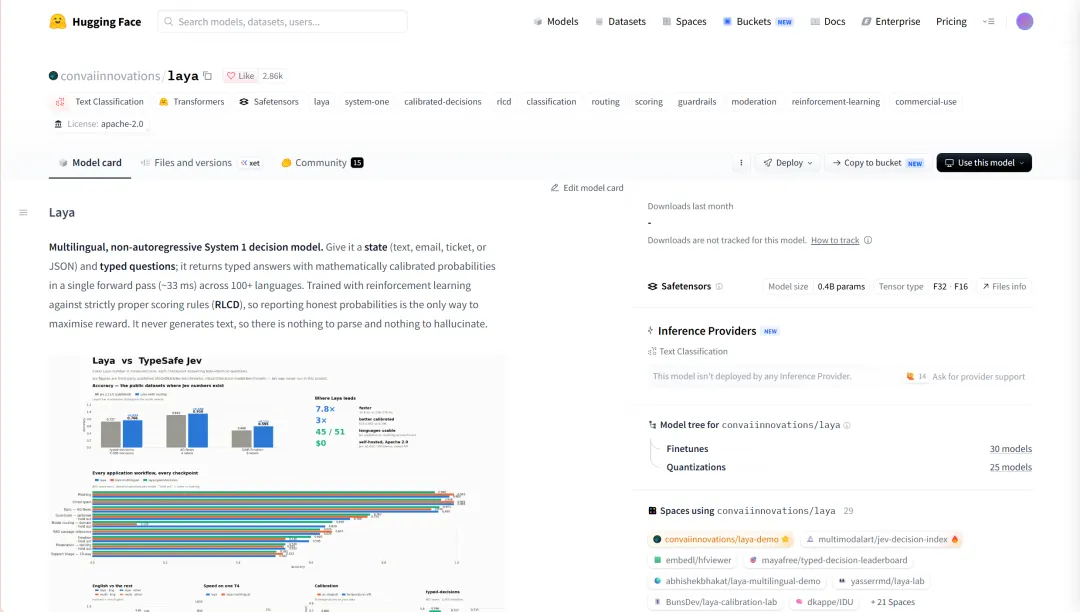
convaiinnovations/laya-multilingual 的 HuggingFace 卡片。底座換成 mmBERT-base,卡片明確寫著除英文之外的場景都用這個權重。
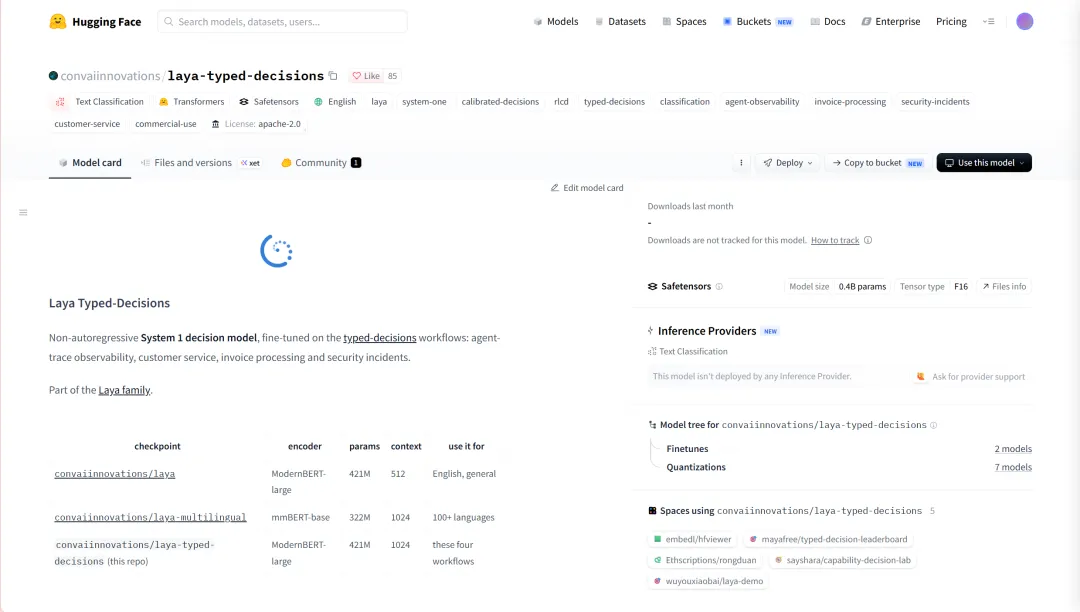
convaiinnovations/laya-typed-decisions 的 HuggingFace 卡片。它在主模型基礎上針對工作流可觀測性、客服、發票處理和安全事件四類場景微調。
04. 實驗倉庫與原始碼
文中的安裝命令、驗證指令碼和測試過程都收錄在開源實驗倉庫,直接 clone 就能跟著跑,不用逐段複製。
git clone https://github.com/li-xiu-qi/XiaokeAILabs.gitcd XiaokeAILabs/experiments/test_jev_open_source/laya
目錄裡除了最小指令碼 test_laya.py,還有幾個專用指令碼:laya-verify.py 匯出四種題型的完整協議結構,laya-latency.py 記錄冷啟動、多題合併與視訊記憶體佔用基準,laya-direct.py 和 laya-pin.py 對應上一節的兩組實測,laya-zh-en.py 跑 20 組雙語平行對照,laya-scale.py 是 1 到 256 題的合併擴展基準,laya-common.py 是模型架構與置信度演算法的本地復刻。指令碼的原始終端輸出都在 docs/logs/ 下,文中每個數字都能回溯到日誌。
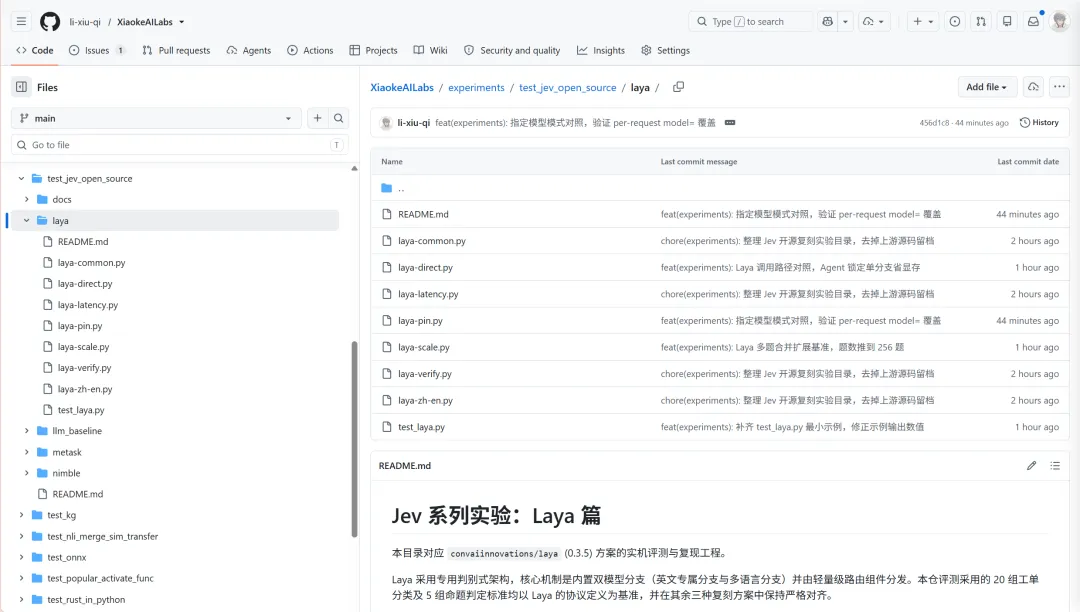
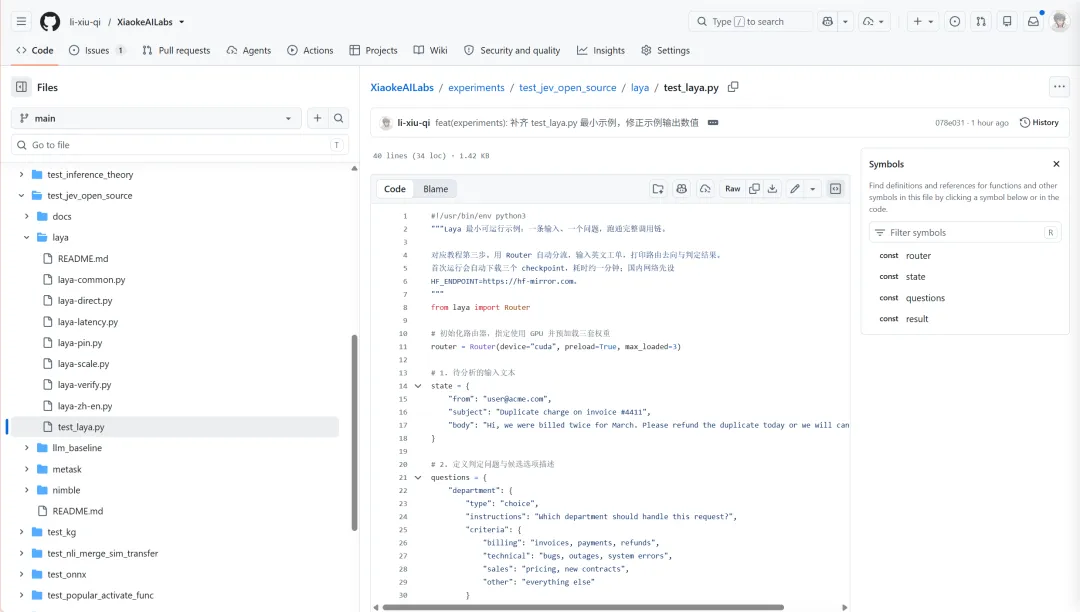
不想 clone 整個倉庫、只想跑最小指令碼的,可以直接打開單檔案頁面複製。
https://github.com/li-xiu-qi/XiaokeAILabs/blob/main/experiments/test_jev_open_source/laya/test_laya.py(https://github.com/li-xiu-qi/XiaokeAILabs/blob/main/experiments/test_jev_open_source/laya/test_laya.py
05. 中文場景的注意事項
整理中文測試集並做中英雙語對照時,有四點經驗可以在落地時參考。
1. 分類精準度基本過關:客服場景的 20 組中英雙語平行測試中,多語言版本的中文分類精準率為 95%,和英文主模型持平,日常工單分發能夠勝任。
2. 多語言版本置信度容易偏高:實測中文樣本的平均置信度為 0.866,高於英文樣本的 0.506,個別分類錯誤的樣本也給出 0.90 以上的高分。設計自動放行邏輯時,中文場景的攔截閾值建議提到 0.95 以上。
3. 是非題建議改成單選題:當前版本的 boolean 題型處理中文時,機率值會向中間壓縮,容易漏判。二元判定需求可以直接定義成提供正反兩個選項的單選題(choice),判定更穩健。
4. 服務啟動後先預熱:模型剛載入視訊記憶體後的第一次前向受底層 CUDA 初始化影響,首條耗時可能達到 1.9 秒。業務接流量前先傳一條測試文字空跑,後續請求就進入毫秒級。
06. 寫在最後
搭 Agent 流水線時,不是每個節點都需要自回歸大模型。意圖分類、參數分流、輸入合規這類標準明確的判斷,交給判別式輕量模型,可以把局部響應壓到十幾毫秒,也能省下 Token 開銷。先把環境搭好、最小指令碼跑通,再回頭看它和大模型的分工邊界,會清楚很多。 (Datawhale)