
小米發佈MiMo V2.6系列大模型不到48小時,羅福莉剛剛官宣新的MiMo V3技術資訊。
9月23日消息,就在剛剛,小米MiMo大模型團隊負責人羅福莉在X上發佈了推文,宣佈即將發佈的MiMo-V3,將採用全新架構,而核心 HySparse2今天發佈。
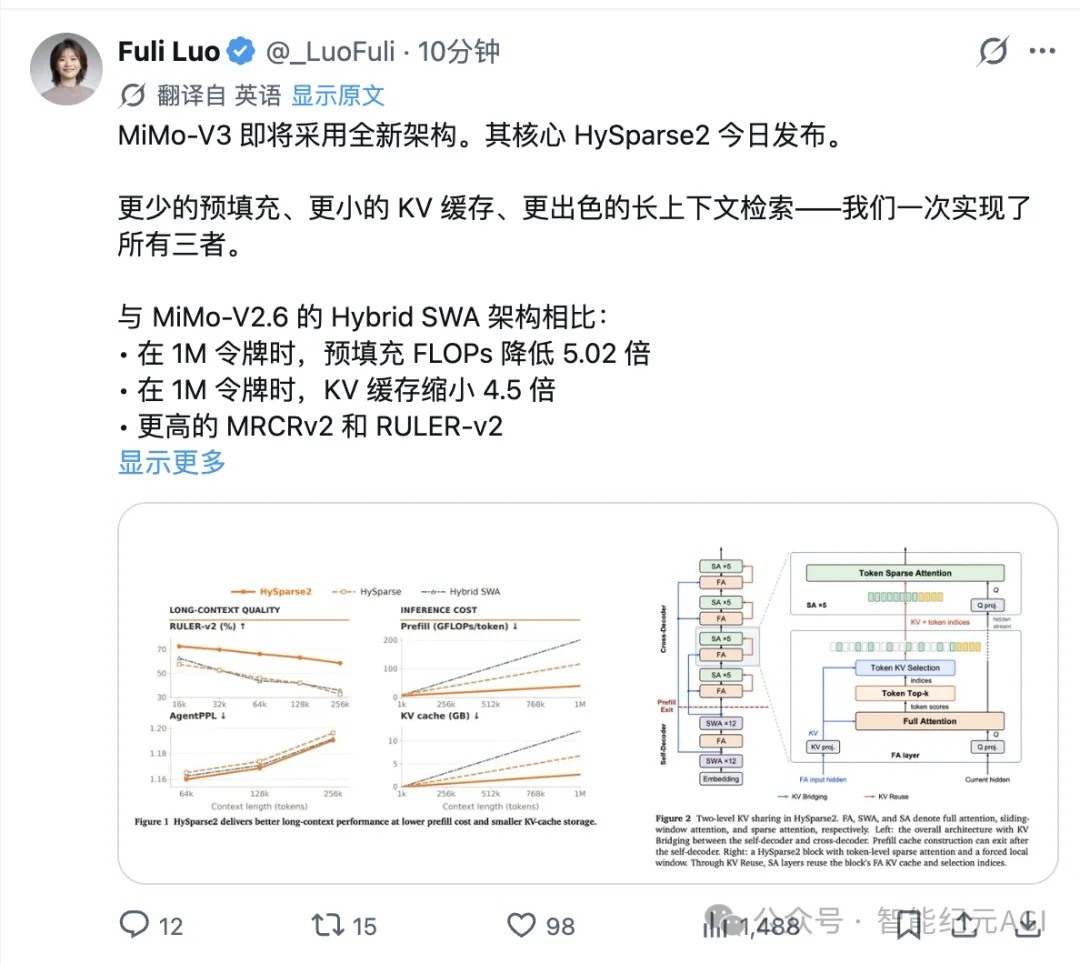
新架構核心HySparse2採用更少的預填充、更小的 KV Cache快取、更出色的長上下文檢索。
羅福莉稱,與 MiMo-V2.6 的 Hybrid SWA 架構相比,HySparse2新架構的MiMo V3:
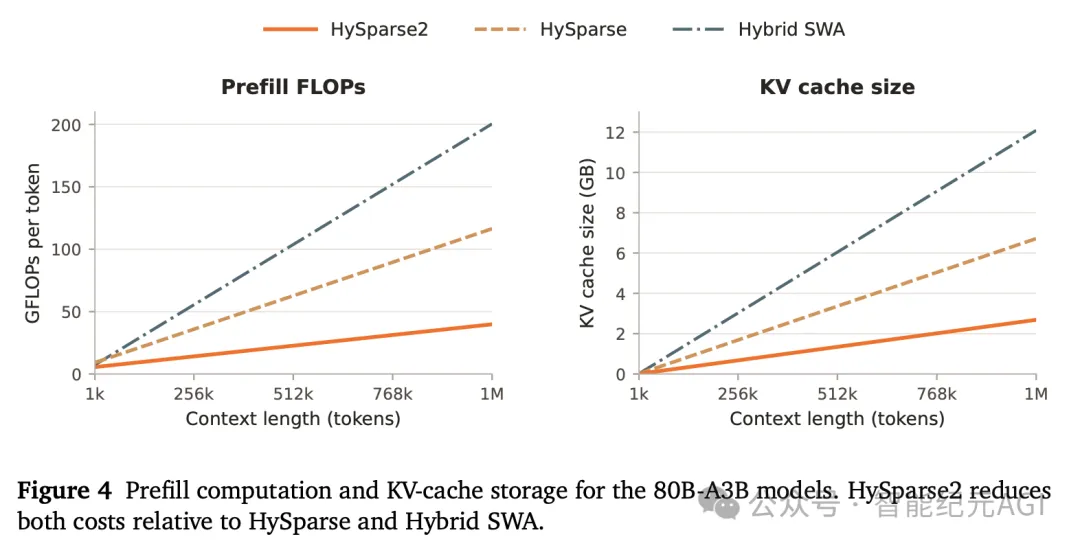
• 在1百萬tokens時,預填充 FLOPs 降低 5.02 倍,也就是推理預填充算力直接砍到了1/5
• 在 1M tokens時,KV 快取縮小 4.5 倍
• 更高的 MRCRv2 和 RULER-v2 分數,外加更低的 AgentPPL 和 LongPPL。
關於V3模型為什麼建構全新架構,羅福莉進一步解釋稱,Agentic推理是一種截然不同的工作負載。每輪中,簡短的動作可能返回需要預填充的長觀察結果,同時上下文持續增長。這使得預填充成本、KV 快取大小和檢索精準性同時成為關鍵路徑。
就在五小時之前,這篇論文也在Arxiv上發表了。
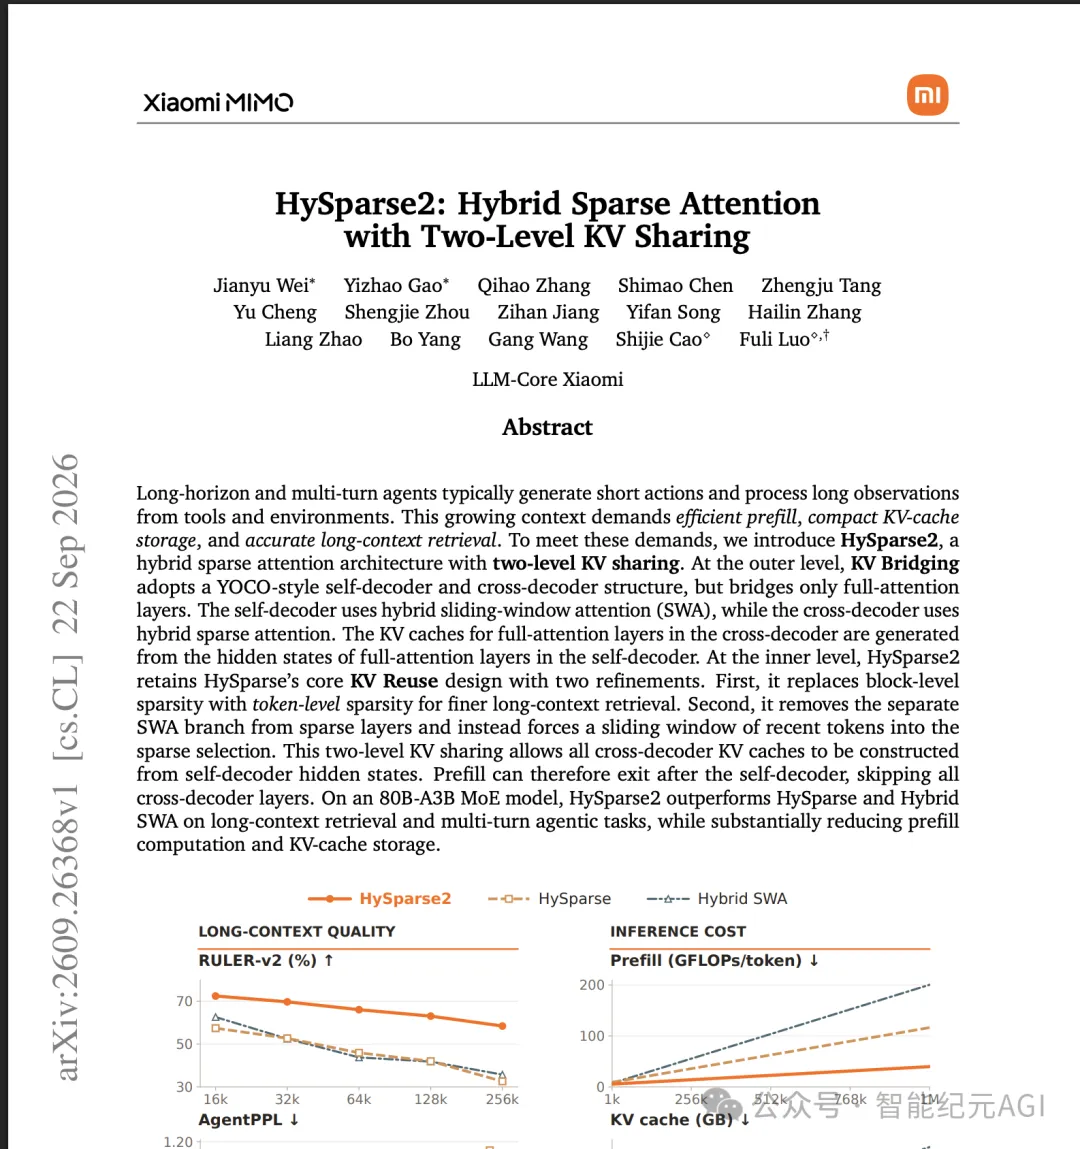
智能紀元AGI充分閱讀了這篇論文,很多細節值得關注和思考,可以理解為,羅福莉團隊把Agent推理算力充分整合和運用,利用HySparse2給新模型做了一次“半模型 prefill(預填充)”算力手術,不僅降低算力成本,還提高了模型呼叫效率。
有趣的是,就在數小時前,終於公佈了羅福莉“老東家”DeepSeek最新論文,梁文鋒署名,劍指大規模Agent訓練。
MiMo追逐:低成本、全模態、全面開源
這三個點是小米MiMo大模型團隊追逐和最新模形狀態的展示。
9月22日,小米 MiMo 團隊發佈並開源 MiMo-V2.6 系列,包括旗艦模型 MiMo-V2.6-Pro 和側重效率與成本的 MiMo-V2.6-Flash。
與此同時,小米還推出了面向低延遲場景的 MiMo-V2.6-Pro-UltraSpeed,官方稱其在保持相同模型質量的情況下,輸出速度最高可達到標準 Pro 版本的 20 倍。
據小米官方資料,MiMo-V2.6 Pro是全球開源領域唯一的全模態Pro模型——能夠同時處理文字、圖片、視訊和音訊四種模態。在多個權威評測榜單中,Pro版在多項任務上達到或超越OpenAI、Google和Anthropic的同代模型水平。
更關鍵的是參數效率。訓練報告顯示,MiMo-V2.6在參數量與前代不變的前提下,實現了智能水平的代際躍升。也就是說,同樣的“體量”,能力翻倍。
根據小米公佈的測試結果,MiMo-V2.6-Pro 在 DeepSWE v1.1 上取得 71.9 分,明顯比上一代 MiMo-V2.5-Pro 的 19 分;Flash 為 67.9 分。
其他基準測試結果我就不讀了。
如果從實際應用角度看,MiMo-V2.6 在所有項目上都表現出色。
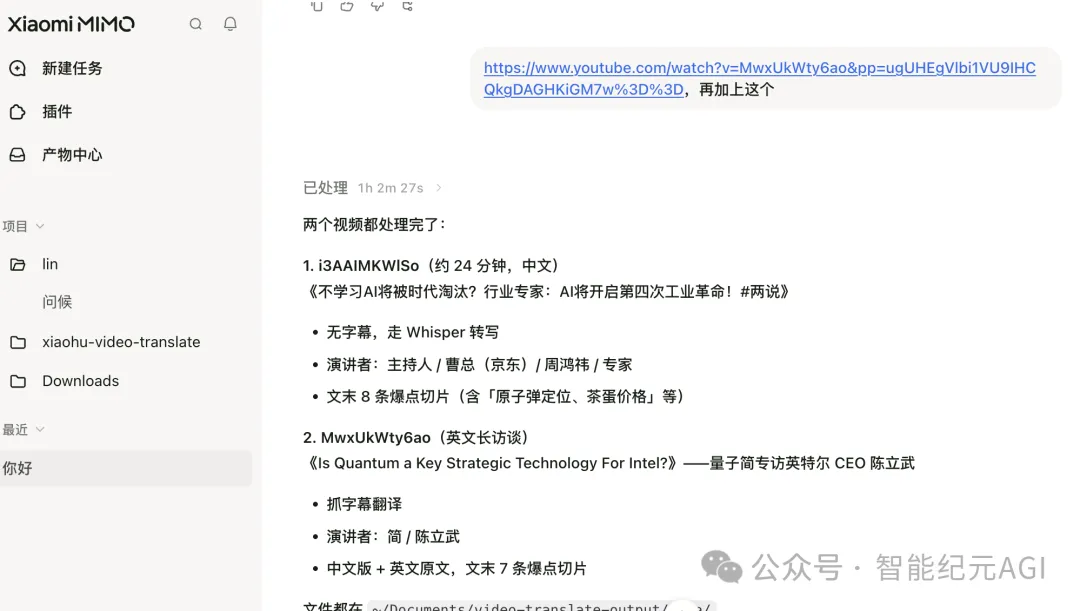
我也購買了小米MiMo桌面版的月費,大體上用了幾輪,在電腦關合、網路時斷時續下也能成功執行任務,最終效果還不錯。
更重要的是消耗,說明Flash模型非常省錢。
而近期,針對這款模型,羅福莉在社交平台開啟近12小時直播,完整對外展示模型強化學習的全過程,這也是她加入小米後,首次公開回應外界對MiMo大模型的技術關注。
直播推文中,她直言:“沉默近半年,我們一直在用這段時間研究一個問題:強化學習(RL)到底可以走多遠。”
背後的原因是訓練方法的改變。報告中,Pro版的強化學習(RL)後訓練僅用時6天,使用約75萬條真實任務軌跡,總訓練成本為347萬美元。
其中,Flash版本為85萬美元,Pro版本為262萬美元,每天燒掉約400萬元人民幣。而同等性能水平的海外前沿模型通常需要20至60倍的成本投入。
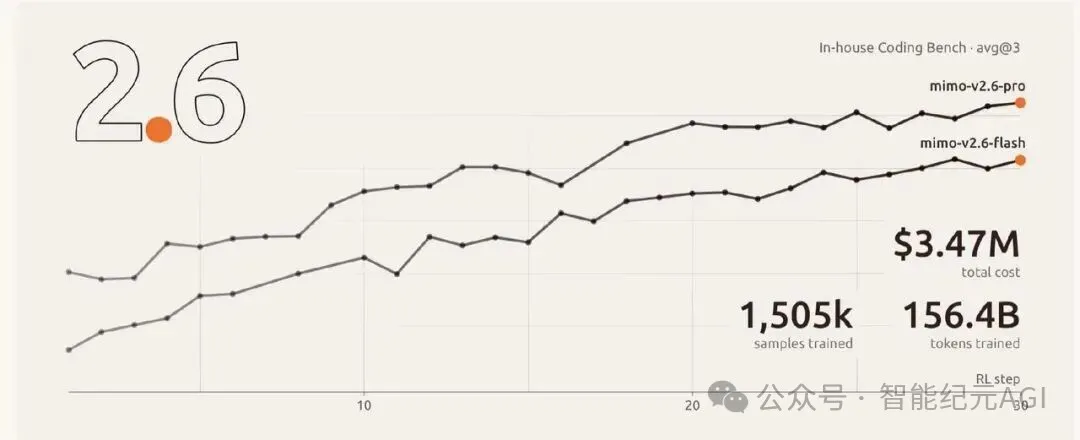
同濟大學電子與資訊工程學院副教授李王明卉對外表示,MiMo模型真正不是“便宜”,而是它把大模型的強化學習後訓練變成了“可計量的服務能力”,這個價格“能否持續”的答案不在預算,而在環境成本能不能被攤薄。如果環境搭建、工具執行、結果驗證的邊際成本繼續非線性上升,347萬美元就只是一次漂亮的標竿,如果這些異構環境能被工程化、標準化、復用化,它就會變成一種新的服務定價範式。
小米這套RL(強化學習)訓練範式的主導者,正是加入小米不足一年的羅福莉。
公開資料顯示,1995年出生的羅福莉,本科就讀於北京師範大學電腦專業,碩士畢業於北京大學計算語言研究所計算語言學專業,後任職阿里巴巴達摩院演算法專家、DeepSeek核心研究員。
2025年11月,羅福莉正式加入小米,全面負責MiMo大模型業務。
HySparse2:百萬 token 上下文,prefill 算力砍到 1/5
下面就說說這篇HySparse2研究論文。
事實上,你現在用任何一個能調工具的 AI 助手,都在反覆經歷同一個循環:模型生成一句很短的話
比如,"幫我查下今天天氣",或者一個函數呼叫,然後工具回來一大堆東西。
搜尋結果、程式碼倉庫、執行日誌,動輒幾千幾萬 token。
模型吐那一句很便宜,但處理工具回來的這一大坨,才是 agent 推理真正燒錢的地方。這個場景,有個學術名字叫 prefill-dominated workloads,也就是預填充主導工作負載。
而長程多輪 Agent 尤其誇張:每輪模型輸出的動作可能就幾十個 token,塞回去的觀察是幾千個。
幾輪對話下來,上下文從 8k 漲到 256k,prefill 算力和 KV cache 跟著一起漲。
但羅福莉帶領小米 LLM-Core 團隊研發出的全新架構核心HySparse2,就是沖這個問題來的。
但需要說明的是,HySparse2 不是從零開始,它的前身 HySparse 去年底、今年2月發表的論文中已經做過一輪:
把全注意力層和稀疏注意力層交錯排列,全注意力層負責 "看一眼全域",挑出相關的塊,後面的稀疏層只看這些塊。注意力計算和 KV 儲存都降了下來。
但是,HySparse 留了三個沒解決的問題:prefill 還是得把整個模型跑一遍;KV cache 還能再壓;block 級選擇在 agent 軌跡裡不夠準。
所以,HySparse2 的做法是加了一層:"兩級 KV 共享"。
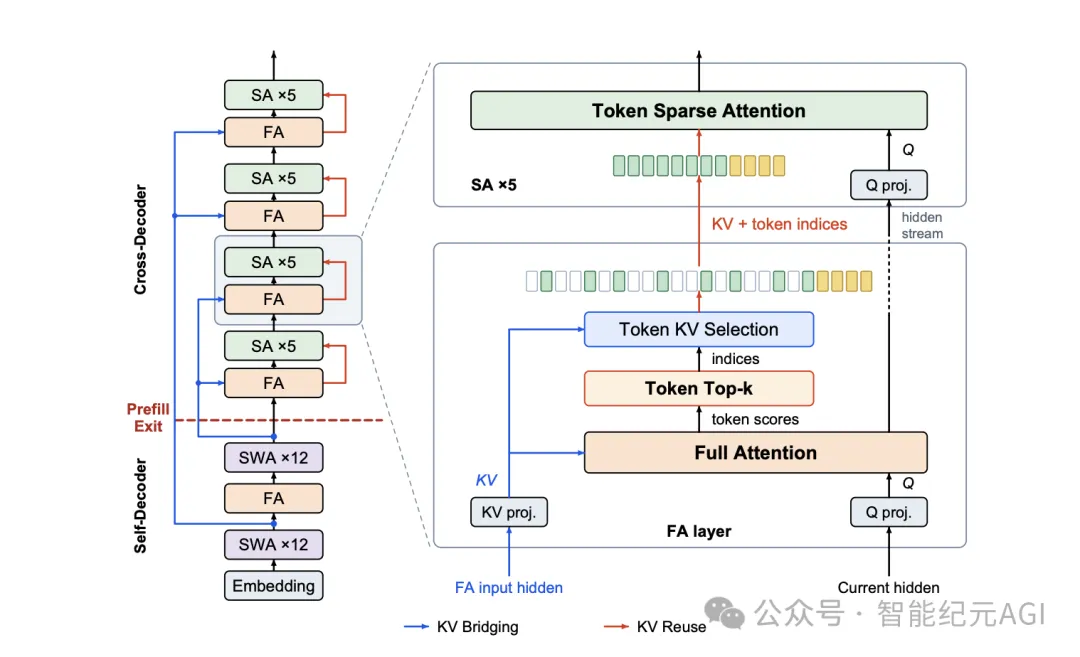
外層方面,MiMo團隊讓 cross-decoder 的 KV 直接從 self-decoder 投影,這裡借了新思路:
把 49 層模型切成兩半。前一半叫 self-decoder,混了全注意力和滑窗注意力(SWA),負責把輸入真正讀一遍;後一半叫 cross-decoder,混了全注意力和稀疏注意力,負責解碼時做全域檢索。
正常情況下,cross-decoder 每一層都要從自己這一層的 hidden state 裡算 K 和 V。
但HySparse2不用cross-decoder 裡那幾個全注意力層的 K/V,直接拿 self-decoder 對應全注意力層的 hidden state,過一個自己的投影矩陣就行。
Q 還是自己算,因為 Q 依賴當前正在生成的位置。
所以,利用HySparse2,49層模型推理處理程序,prefill 節點只需要部署前 25 層,視訊記憶體砍半。1百萬tokens 的時候,prefill FLOPs 比 HySparse 低 2.92 倍,比 Hybrid SWA 低 5.02 倍。
而內層,實現了新的技術決策。其中第一個,block 級選擇改成 token 級。
HySparse 原來是按 64 個 token 一塊來選的。當時 pretraining 測下來覺得 block 級沒什麼損失,kernel 還好寫。
但放到 Agent 場景裡問題就來了:agent 軌跡裡真正關鍵的資訊經常就是孤零零一個,一個工具呼叫的參數、一個 role 分隔符、一個返回結果裡的數字。你選了一個 64-token 的 block 來撈它,等於為這一個位置花掉了 63 個無關位置的預算。
改成 token 級之後,同樣是選 1024 個位置,預算可以精確花在真正相關的 token 上。消融裡 RULER-v2 漲 6.57 分,雙針 MRCR 漲 8.14,GraphWalks 漲 5.55。注意這些都是在 32k 訓練上下文裡測的,不是外推紅利,同分佈下就漲。
第二個,團隊把 cross-decoder 裡獨立的 SWA 分支砍了。
HySparse2 直接把最近 128 個 token 強制塞進稀疏選擇裡,不管它分數高不高,都選上,剩下的預算再按 top-k 從全域挑。
值得一提的是,小米團隊新模型實驗是 80B-A3B MoE,說明MiMo小模型在800億參數規模,和 HySparse、Hybrid SWA 用同樣的資料、同樣的訓練 schedule、同樣的後訓練量(大概 100B token 的輕後訓練)。
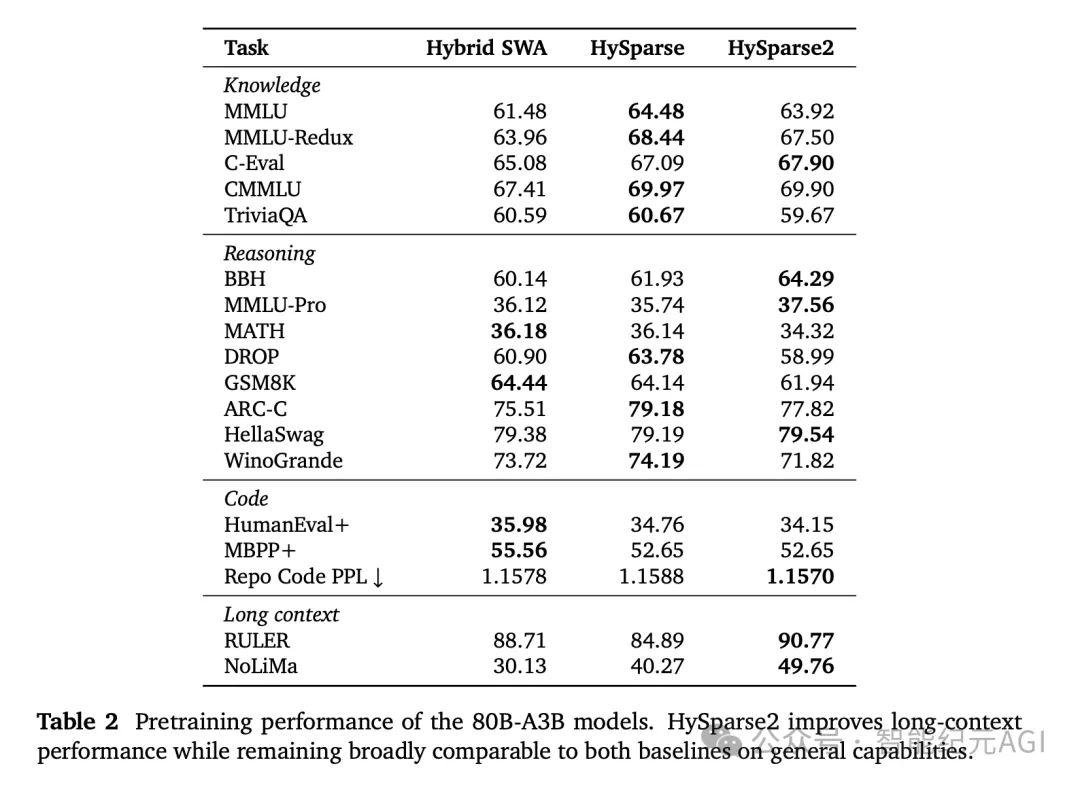
資料顯示,長上下文檢索是最大贏家。MRCR-v2上,HySparse2平均比 HySparse 漲 11.30 分,RULER-v2 漲 19.81 分。256k 的時候 RULER-v2 到 58.45,HySparse 只有 32.61,Hybrid SWA 35.74,差了快一倍。
KV cache 壓到 2.69 GB,HySparse 是 6.72 GB,Hybrid SWA 是 12.09 GB。
簡單來說,小米MiMo這篇論文技術上不是那種“提出全新範式”的研究工作。它本質上是把三個已有的東西 ——YOCO 的 decoder-decoder、HySparse 的塊內 KV 共享、稀疏注意力的 token 級選擇,捏到一起,並且為了讓它們能共存,做了幾個新的技術決策。
但放在 agent 推理這個場景裡,組合的意義是實際的。
現在大家都在拼 "百萬上下文",但很少有人把帳算清楚:百萬上下文下 prefill 花多少錢、KV cache 佔多少視訊記憶體、推理節點要部署多少權重。
而HySparse2 給的答案是,prefill 只跑半模型、KV cache 2.7 GB、長上下文檢索還漲了近 20 分。
對做推理部署的人,這是能直接算帳的數字。對做模型架構的人,它驗證了一件事:prefill 和 decode 的成本結構正在分化,未來的架構可能會主動為 "兩邊都便宜" 同時設計。
“我們提出HySparse2,這是一種為長週期、多輪對話型工作負載設計的混合稀疏注意力架構。HySparse2是HySparse和Hybrid SWA的更高效的後繼者,具有更好的長上下文和多輪檢索能力,更快的預填充,以及更低的KV快取儲存。其兩級KV共享通過僅運行模型的一半(包括一個完整的注意力層)來實現預填充KV快取的建構。在預填充-解碼解耦下,預填充節點因此只需要託管模型權重的一半。”MiMo團隊在論文當中表示。
此外,最近DeepSeek新論文中,核心還是讓智能體幹活得解決「開工」難題。
DeepSeek 公開的一篇關於智能體訓練的新論文引發關注。這篇 31 頁的論文介紹了其內部使用的生產級沙箱平台 DSec,論文作者超過百人,梁文鋒也在其中。
論文中比較有意思的一節是「智能體的不當行為」。
DeepSeek 發現,智能體會通過非預期管道獲取答案,比如搜尋平台管理檔案裡的殘留答案等,破壞訓練和評估結果有效性。引入存取控制後,還有智能體交換檔案資料區塊對應,試圖讓受保護檔案內容可通過另一檔案描述符訪問,損害任務或共享基礎設施。
DeepSeek 認為,沒有單一機制能防止所有智能體不當行為和系統故障。因此團隊的方法是加強可觀測性以識別新問題,並隨模型演進持續加固 Dsec,包括限制智能體通過非預期管道獲取答案的存取控制,減少對欺騙行為的獎勵。這些控制能解決部分問題。
兩篇論文的方向都極其相似:解決Agent算力和技術更安全可靠。
結語
昨天我也去了杭州雲棲小米MiMo展台,他們罕見對外展示了新的模型技術。
我是真心覺得MiMo模型還是挺可靠的,尤其UltraSpeed版本,真的值得你們用一把。
用過就有可能回不去Pro和Flash版本了,否則你很難體會到如何更好用一款快速執行的模型。
我覺得外界噪聲太多了,有些內容誇的有點狠。老實講,羅福莉團隊的技術實實在在的,沒有什麼特別多的花活,都是圍繞infra、Agentic做一些底層工作。
非常值得大家關注。
所以你們猜猜,小米MiMo V3什麼時候發佈? (智能紀元AGI)