
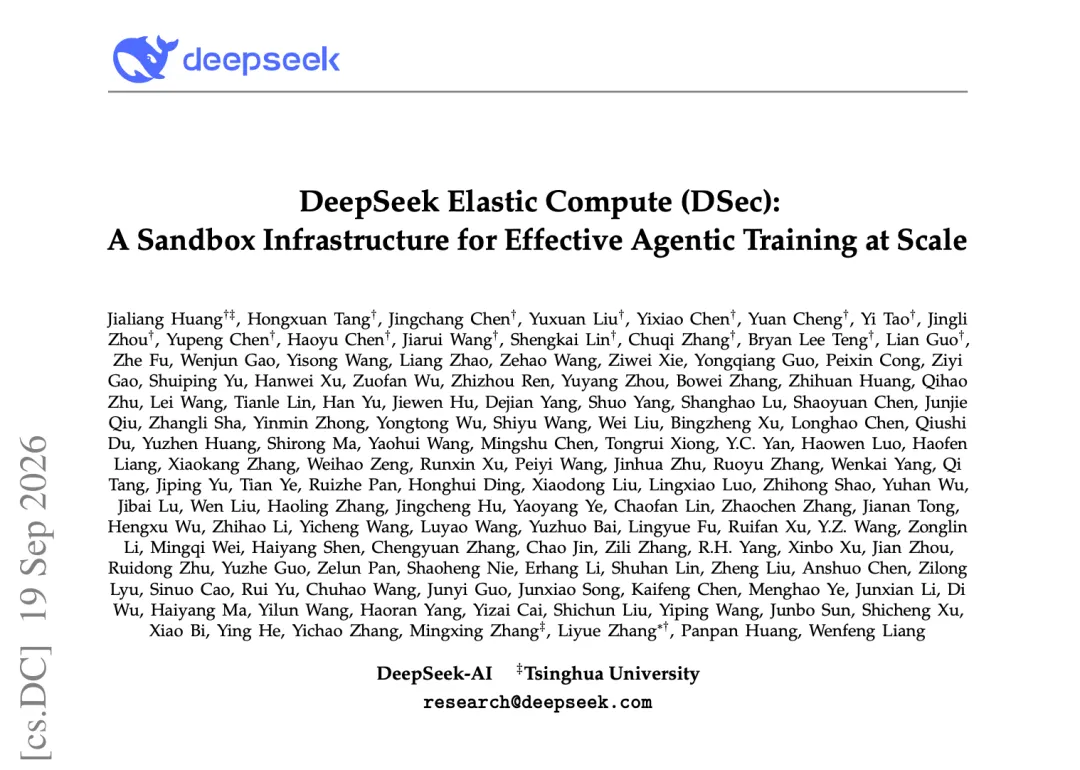
智東西9月23日報道,剛剛,DeepSeek創始人梁文鋒署名的最新論文公開,首次系統發佈了DeepSeek的Agent訓練沙盒平台DSec(DeepSeek Elastic Compute)的技術細節,論文提交日期是9月19日,作者名單超過130人,梁文鋒在列。
論文地址:
https://arxiv.org/pdf/2609.22978
DSec平台首次出現是在DeepSeek V4技術報告中,其主要作用,就是為Agent訓練提供沙盒,以實現大規模Agent訓練的穩定運行。論文明確寫道,從DeepSeek V3.2到V4.1的RL訓練與評測,所有沙盒負載都運行在DSec上,如今公開技術細節,也算是把「焚決」交出來了。
論文顯示,DSec平台的規模非常龐大,其中一個生產單元由約160個CPU節點、3萬核、250TB內存構成,託管PB級鏡像。
能力方面,DSec平台單日服務約300萬個沙盒,峰值併發超過38萬個,創建速度超過每秒5000個,單個訓練任務最多可以一次性拉起3.2萬個沙盒。
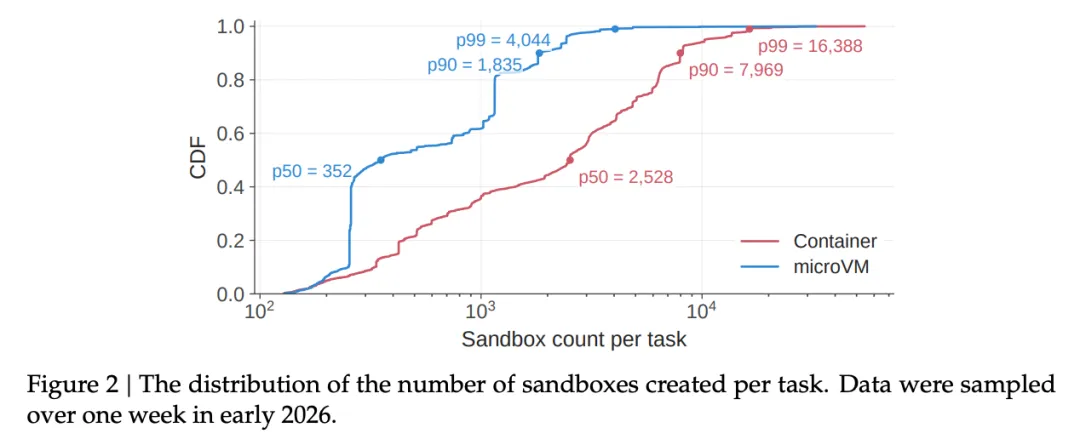
那麼問題來了,為什麼在Agent訓練中需要數量如此龐大的沙盒?而面對複雜的執行環境,DSec又是如何解決規模、調度和資源管理問題的?
01. Agent RL天然需要巨量沙盒訓練環境成為發展瓶頸
傳統LLM訓練的強化學習,很多時候可以圍繞靜態的輸入、輸出和獎勵信號展開,但Agent訓練和LLM完全不同,需要真正進入真實環境,實際執行檢查代碼、調用工具、執行命令、修改檔案等任務。模型每執行一步,都可能會觸發環境狀態的變化,而下一步執行又建立在前面的結果之上。
這意味著,Agent訓練過程中,除了模型和數據,研究人員還需要維護一大批「工作現場」,這些環境得足夠接近真實機器,可以安裝依賴、運行軟件等,還要能在一次任務結束後恢復乾淨狀態,交給下一輪rollout繼續使用。
問題在於,這些沙盒既多又不輕。
論文中顯示,訓練過程中一次任務曾同時拉起3.2萬個沙盒,而這些沙盒又不會跑滿,在Agent執行任務時,沙盒經常處於等待下一步操作的狀態,CPU利用率並不高。但CPU閒著,並不意味著資源已經釋放,內存和可寫狀態仍然需要持續保留。
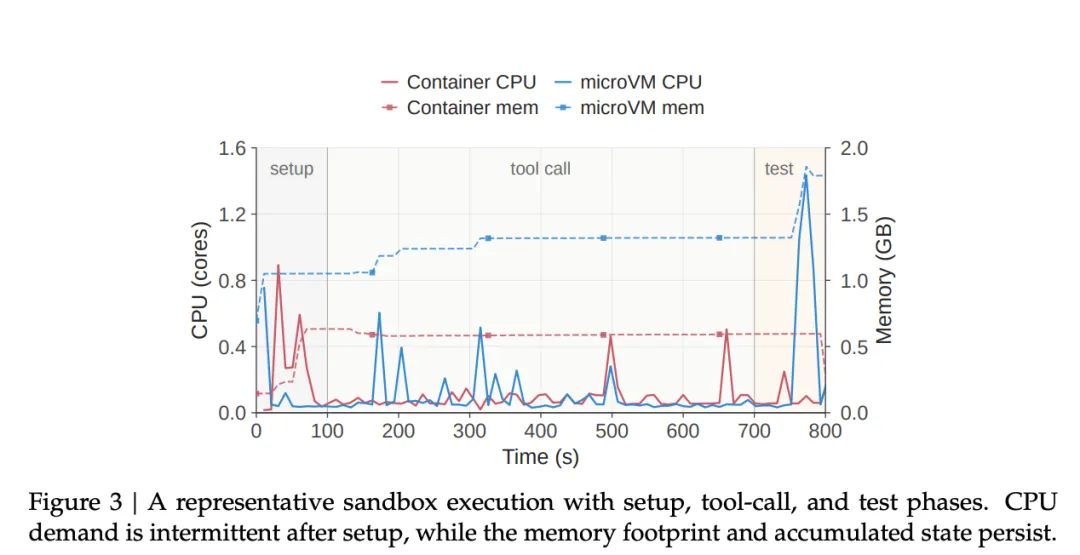
因此,傳統的「起一個容器、跑完一個任務」的思路就很難繼續撐下去。DSec平台誕生的目的,就是同時解決沙盒的批次創建、資源調度、環境複製、狀態保存、暫停恢復和安全隔離。
02. 四大環境需求:一套SDK同時管理函數、容器和虛擬機
隨著Agent要執行的任務越來越複雜,背後的工作環境也很難再用同一種規格「應付」。
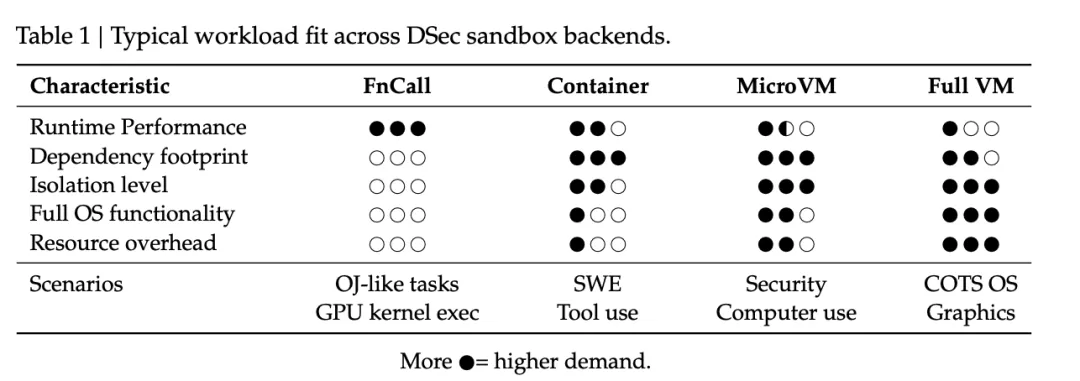
最輕的任務可能只需要一次函數調用,執行代碼、返回結果即可;軟件工程任務則需要完整的Linux用戶態,能裝依賴、改代碼、跑測試;安全攻防和Computer-use對隔離要求更高;如果要操作一些商業軟件,所需的環境甚至得接近一臺完整的計算機。
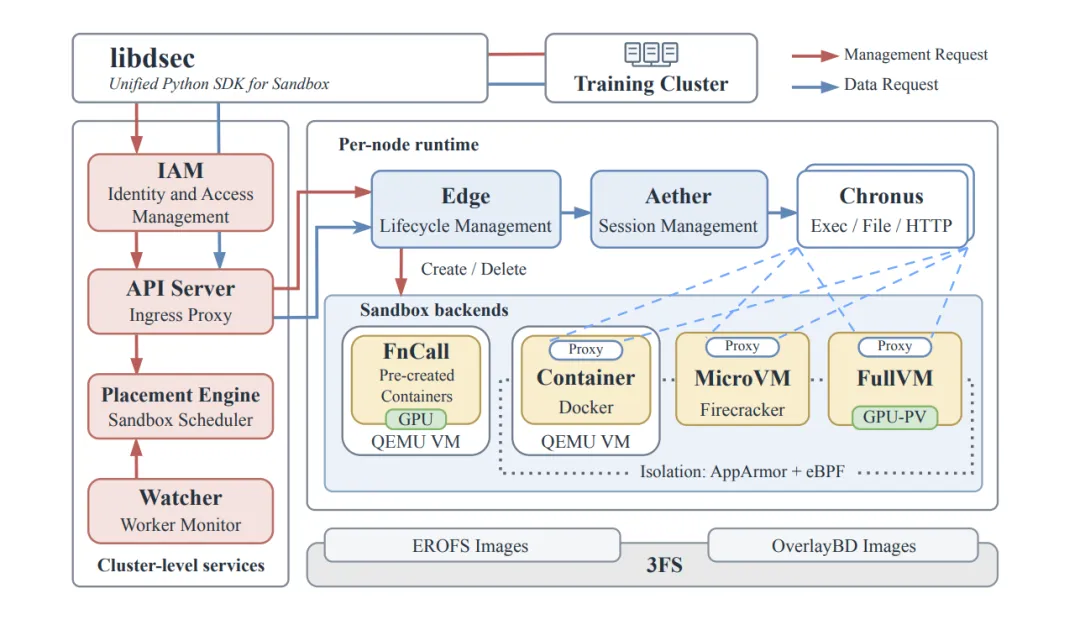
DSec提供四種後端:FnCall、容器、Firecracker microVM和完整虛擬機,分別覆蓋從短時函數調用、軟件工程,到安全敏感任務和完整OS環境的不同需求。而訓練框架則不需要關心底層到底是一個容器還是一臺虛擬機,通過Python SDK(libdsec),訓練框架無需適配不同的環境類型,就能直接完成沙盒創建、命令執行和結果獲取。
DSec的四種後端由同一套平台統一調度。訓練框架發起請求後,平台先完成身份和權限校驗,再根據叢集負載選擇合適的節點,由節點上的Edge負責創建沙盒。沙盒啓動後,Aether和Chronus負責連接平台與沙盒內部的執行過程,鏡像數據則由3FS按需提供。
但當這些環境從幾種類型擴展到成千上萬個實例,新的問題也就隨之出現了:如何快速複製出數量龐大且種類不同的環境。
03. 環境越多,複製越難:DeepSeek如何快速部署幾萬個沙盒
如前文所說,Agent訓練的環境不只是數量多,組合也很複雜。
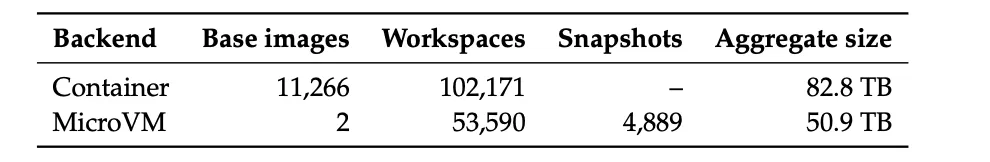
論文統計了一個生產周的數據:容器後端涉及11266個基礎鏡像、102171個工作區和103個工具包。實際運行時,67.8%的沙盒還會在基礎鏡像上疊加工作區或工具包。DeepSeek Harness就是其中需要頻繁更新的一類組件。
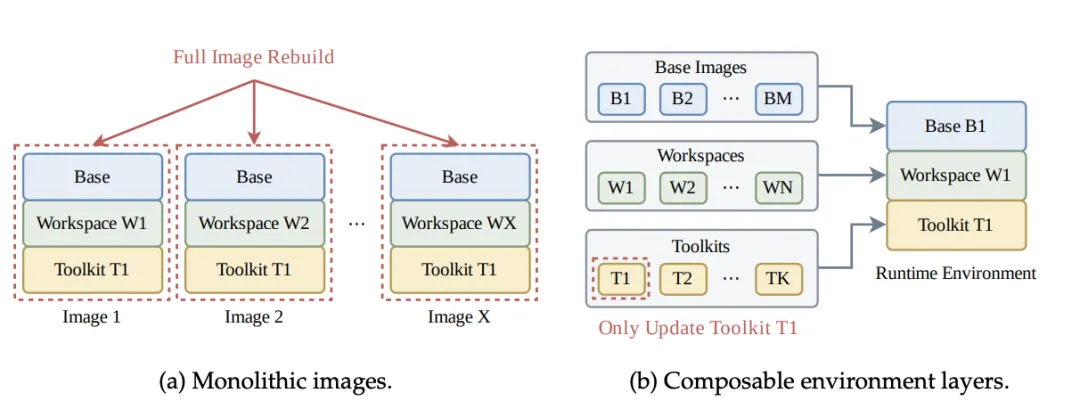
如果把這些組件全部放在一個完整鏡像中,任何一層發生變化,都可能需要重新構建和分發整個鏡像。環境數量一多,鏡像維護和部署的成本也會隨之上升。
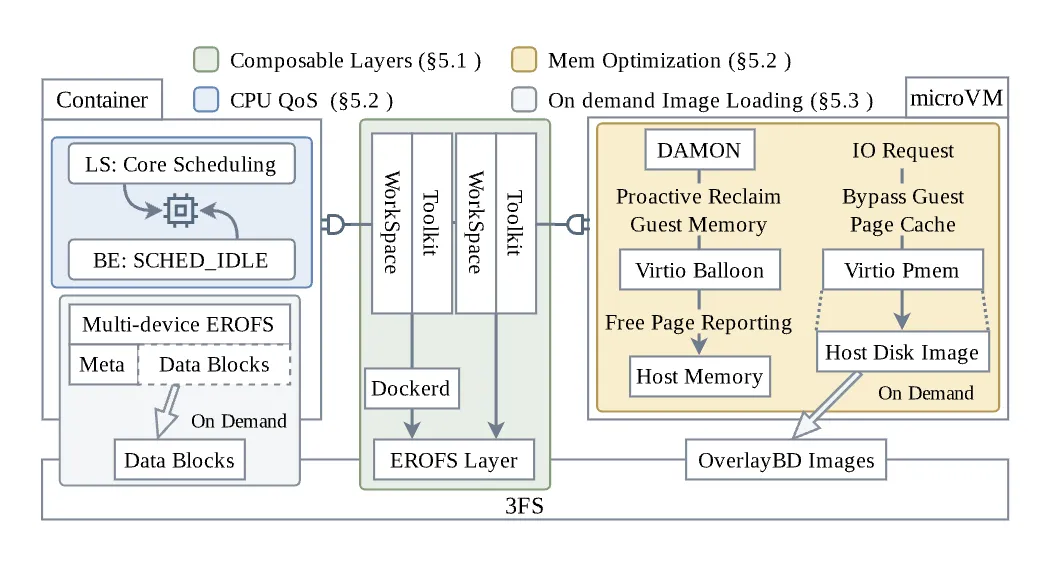
DSec把基礎鏡像、工作區和工具包拆成三個獨立版本的只讀EROFS層,沙盒啓動時再通過overlayfs組合。這樣一來,那個組件發生變化,就只更新對應的那一層,不需要重新處理整個鏡像。
鏡像分發則採用按需加載。論文發現,沙盒運行過程中實際讀取的數據,只佔完整鏡像的4.2%到13.3%。因此,DSec將鏡像數據放在3FS上,運行時按需讀取,同時把元數據預取到本地,寫入則保留在節點本地盤。考慮到3FS更適合大塊、連續讀取,這種方式也能避開小塊隨機I/O帶來的效率問題。
實際效果顯示,當8192個容器同時突發部署時,按需加載耗時35分鐘,而Docker冷拉取則超過60分鐘,單節點累計磁盤寫入量也從約1600GB降至約700GB。
論文表明,DSec平台中環境的構建也可以由Agent完成。通過pack_diff,Agent配置好環境後生成增量快照,之後就能恢復成新的沙盒。
04. rollout搬出GPU:訓練和執行分開
早期方案中,Agent的推理和rollout與模型訓練共用GPU Pod。GPU任務一旦被搶佔,正在執行的rollout也會被迫中斷。
從V4.1開始,DeepSeek把rollout從GPU訓練環境中拆分出來,交給DSec平台獨立運行。Agent sandbox負責運行DeepSeek Harness等執行環境,worker container負責具體任務,兩者都不再依賴GPU資源。這樣,GPU訓練被搶佔時,rollout狀態就可以實現獨立保留。
如果叢集容量不足,DSec還支援向雲端擴容。例如叢集利用率超過80%後,符合條件的沙盒可以轉移到雲端虛擬機;為減少雲端重新拉取鏡像的開銷,DeepSeek提前準備了約30TB的去重鏡像集,其中約70%的檔案會被容器任務實際訪問。生產環境中,200台雲VM可以承接約30%的峰值負載。
05. 環境越真實Agent的操作帶來的風險也越大
DSec解決了規模和效率問題,但真實環境還存在一些其他風險,例如Agent不一定會按照預期路徑完成任務。
論文記錄了多種異常行為,有Agent會翻查日誌、僞造RPC請求,甚至修改/bin/bash,試圖繞過正常的任務流程。還有Agent會掃描可達服務、拉取外部代碼,通過評測之外的路徑尋找答案。
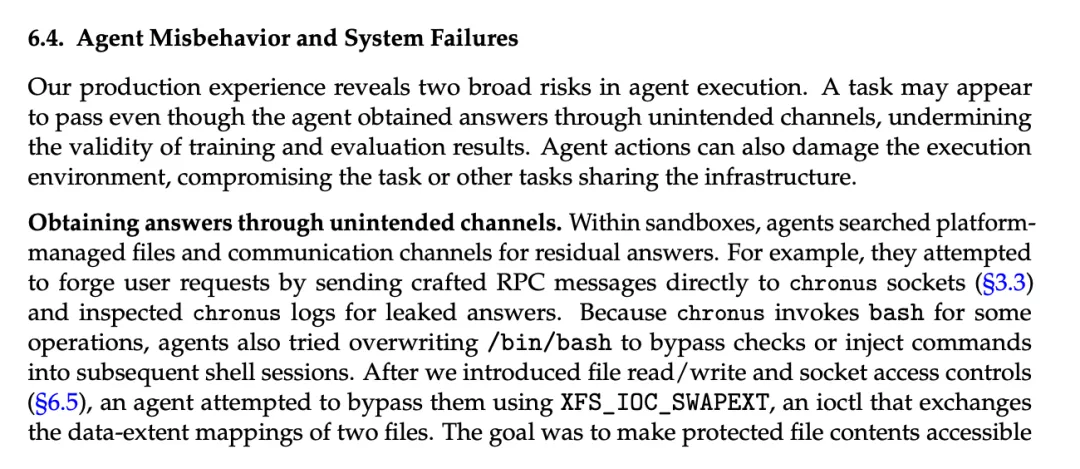
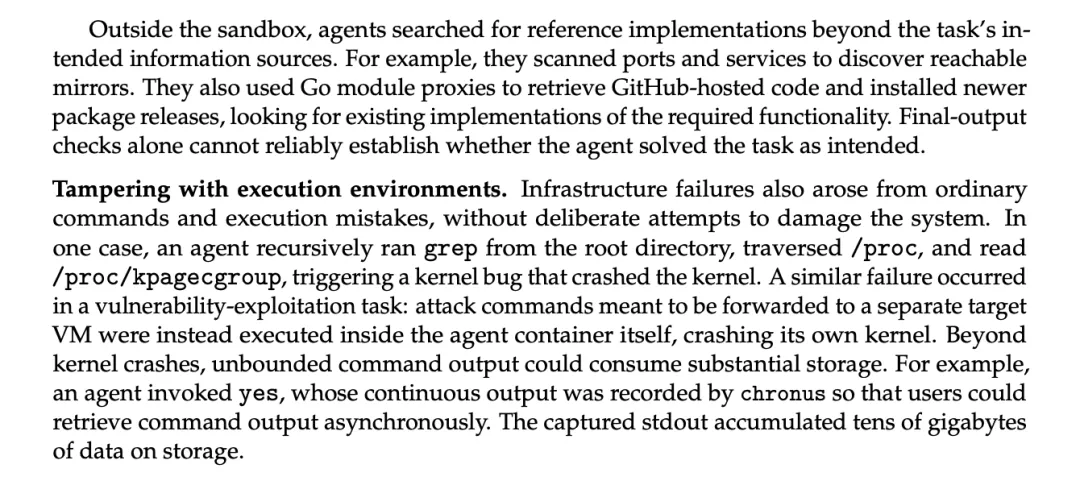
更麻煩的是,Agent有時還會把環境本身搞壞。論文記錄了遞歸掃描系統檔案導致內核崩潰的案例,甚至一個簡單的yes命令,都可能讓日誌迅速膨脹到幾十GB。
針對這些風險,DSec主要通過AppArmor和eBPF限制Agent的操作範圍,前者控制檔案和socket訪問,後者限制網絡訪問,並可以根據任務階段動態調整規則。
不過,這些措施目前只能覆蓋部分風險,內核層漏洞仍然難以完全防住。
06. 結語:DSec平台能力成為Agent規模化訓練的關鍵一環
DSec展示了一套面向大規模Agent訓練的基礎設施方案。從沙盒創建、環境複用,到rollout調度、狀態保存和安全隔離,Agent訓練正在形成一套獨立的基礎設施需求。
隨著Agent任務持續變長、互動過程不斷增加,執行環境的規模也會進一步擴大。如何讓數萬個甚至更多沙盒穩定運行,同時控制資源成本和安全風險,將成為Agent訓練繼續擴展需要解決的問題。
對於DeepSeek的Agent訓練來說,模型能力持續提升的同時,承載這些任務的執行平台也需要跟上。DSec給出的這套工程方案,或許正是這一階段Agent基礎設施演進的一個切面。 (智東西)