
MiMo-V2.6剛發佈,羅福莉就開始劇透MiMo-V3了。
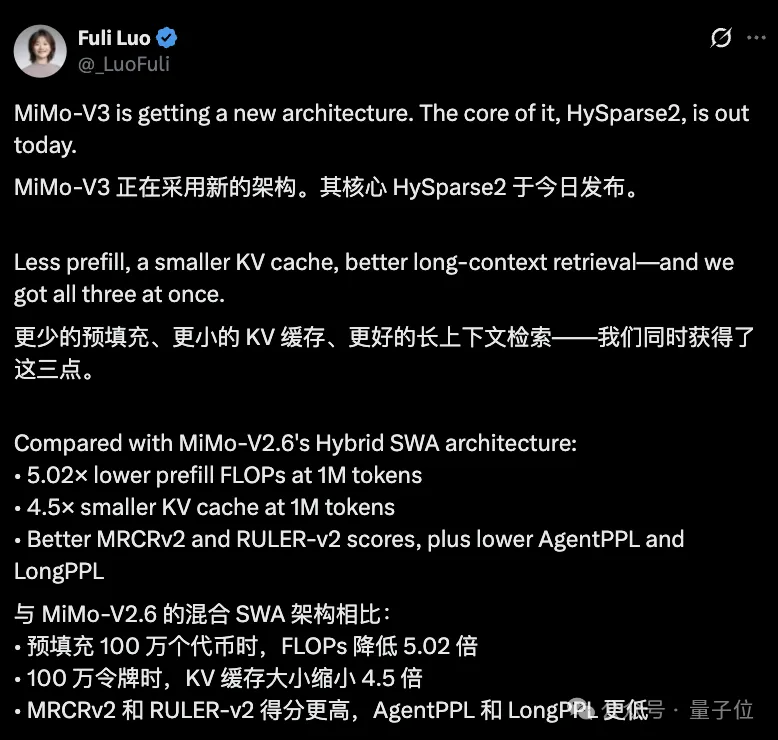
MiMo-V3將採用新架構,核心是HySparse2,是Agent執行長任務時越來越重的輸入處理。
Agent生成一次工具呼叫可能只需幾十個token,搜尋結果、網頁、程式碼和執行日誌卻能一口氣回來幾萬字。
模型讀完繼續操作,每一輪結果都要進入上下文;
輪次增加後,模型既要處理新輸入,也要保留足夠的歷史資訊供後續檢索。
所以團隊想讓模型少花力氣處理輸入、少佔記憶體保存歷史,同時還能從很長的記錄裡找準線索。
在80B總參數、每個token約啟動3B參數的MoE模型配置下,到了100萬token上下文,HySparse2的預填充計算量約為Hybrid SWA的1/5.02;
KV Cache從12.09GB降至2.69GB,約縮小4.5倍。
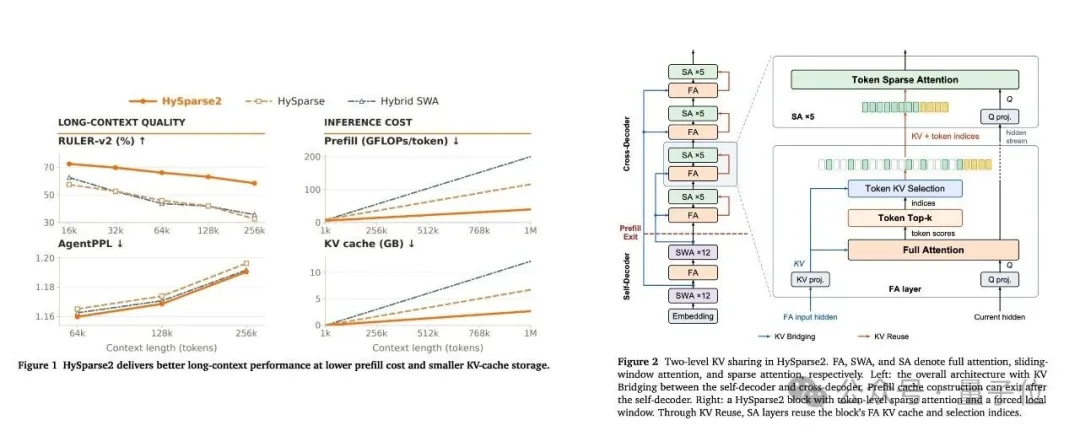
省下來的不只是資源,在多輪檢索測試中,它找歷史資訊的成績也更好。
預填充只走前半程
首先說說Agent為什麼會被“讀材料”拖住。
比如讓模型修一個程式碼問題,它會先查檔案,再運行程序;程序返回報錯,它會繼續查相關程式碼,修改後重新測試。
Agent每一步生成的指令可能很短,但工具返回的檔案、日誌卻很長。
這些內容進入上下文後,模型得先處理輸入,建立後續生成要用的KV Cache,才能決定下一步怎麼做。
這個處理階段叫預填充(Prefill)。
在多輪Agent任務中,工具返回的內容通常遠長於Agent發出的指令,因此預填充成本會隨著任務推進持續累積。
小米此前的HySparse已經用上稀疏注意力,讓少量全注意力層查看更完整的歷史,再由後續的稀疏層復用它選出的內容和快取。
比起讓每一層都從頭看遍長上下文,這能省下不少注意力計算。
但長輸入在預填充階段仍需經過所有模型層。
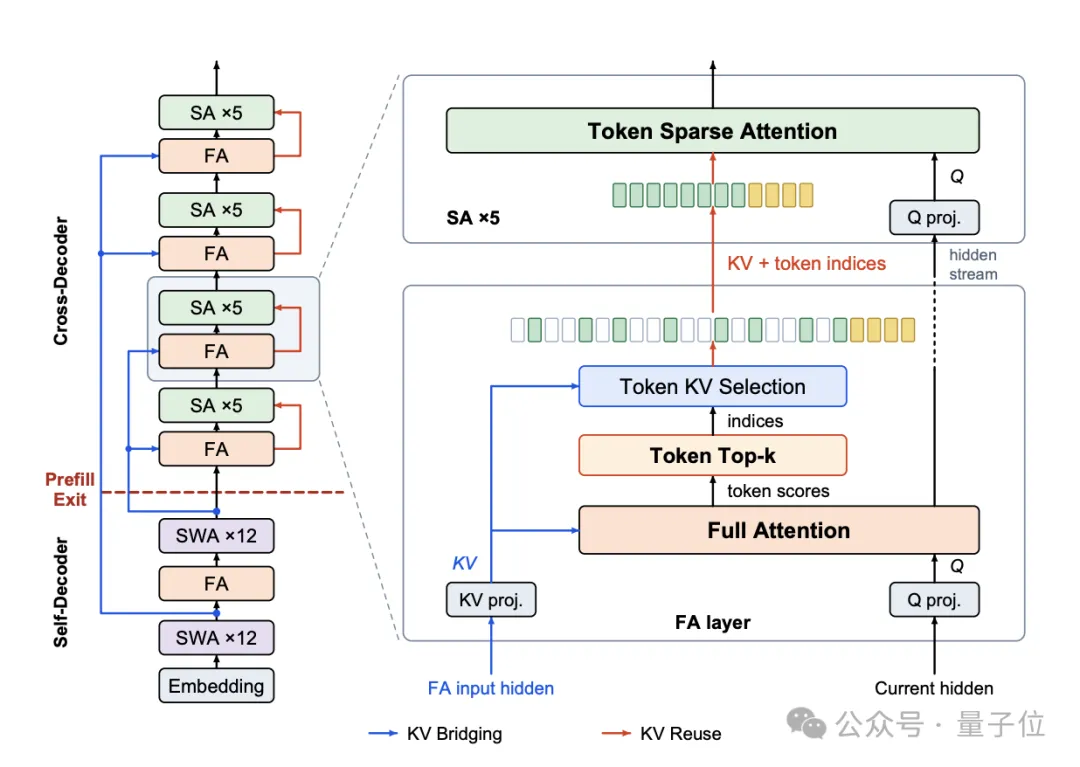
HySparse2進一步調整了模型的層間依賴,讓預填充可以在中途結束。
具體來說,模型被劃分為前後兩段,前段是self-decoder,後段是cross-decoder。
前半段結合全注意力與滑動窗口注意力,後半段結合全注意力與稀疏注意力。
兩段之間的KV Bridging只連接全注意力層:
後半段全注意力層從前半段對應層的隱藏狀態生成K和V,同時保留各自獨立的投影參數。
後半段內部的KV Reuse則讓稀疏層復用同一混合模組中全注意力層的KV Cache和token選擇結果。
有了這座橋,一批新材料進來時,預填充走完前段,就能停下,不必再讓整段輸入逐層跑完後段。
到了模型繼續生成內容的時候,後段仍正常參與計算。
論文標題所說的兩級KV共享,指的就是這兩處設計。
僅有跨層共享還不夠。
上一代設計中,稀疏層另設一條滑動窗口注意力分支;這條分支的快取依賴後半段逐層計算得到的隱藏狀態。
如果保留它,長輸入仍需進入後半段建構快取,預填充就無法完全提前退出。
所以HySparse2拿掉了這條獨立分支,改為強制將最近的token納入稀疏選擇。
局部資訊仍被保留,但與遠處選出的token使用同一套共享KV Cache。
於是,後半段需要的快取都可以從前半段的狀態建構,長輸入的預填充走完self-decoder即可結束;模型隨後生成token時,cross-decoder仍正常參與計算。
論文展示的模型共有49層,採用預填充與生成分開部署的方案時,預填充節點只需放前25層和相關投影模組,所需模型記憶體接近減半;
在這套配置裡,預填充階段執行全注意力的也只有一層。
檢索精確到token
減少輸入計算之後,長歷史中的資訊能否被精準找回,取決於稀疏層如何選擇內容。
上一代HySparse按“塊”挑內容。
一個64-token的塊裡即使只有少量內容相關,整塊也會佔用選擇預算。
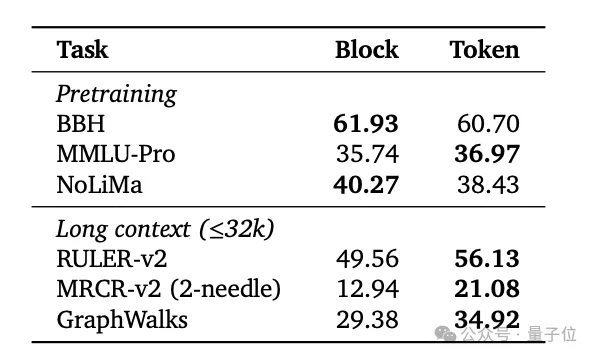
論文指出這種方式在早期預訓練評估中沒有表現出明顯劣勢,但面對跨越多輪工具呼叫的Agent任務,檢索精度不足的問題變得突出。
所以HySparse2把選擇粒度改到了單個token。
論文中的配置是挑選1024個全域token,再強制保留最近128個token。
這樣既能去較早的歷史裡找分散的線索,也不會漏掉眼前剛收到的工具結果。後續稀疏層繼續復用這些選中位置及其快取。
對需要跨越多輪工具呼叫找證據的Agent來說,有限的注意力名額究竟給誰,會直接影響它能否把前面的線索接到當前任務上。
消融實驗裡,在保持骨幹結構和注意力預算一致,僅比較按塊選與按token選的情況下,在32k及以下的長上下文測試中,按token選擇讓RULER-v2提高6.57個百分點,雙線索MRCR-v2提高8.14個百分點,GraphWalks提高5.55個百分點。
當然,HySparse2也沒有完全撤掉全注意力。
團隊認為,少量全注意力層既有助於維持模型能力,也能用完整的注意力分數,幫後面的稀疏層選出值得看的token,就無須再單獨訓練一個檢索模組。
架構改了這麼多,最終還得看模型能不能把事做對。
小米團隊用相同的資料和訓練安排,對比了HySparse2、HySparse,以及Hybrid SWA三種注意力設計。
預訓練後的普通知識、推理和程式碼項目中,HySparse2的成績有升有降,整體與對照模型大致可比;優勢主要出現在長上下文能力上。
加入Agent資料、再經過後續訓練後,差距變得更明顯。
HySparse2在論文評估的各個上下文長度上,MRCR-v2和RULER-v2檢索成績均領先兩個對照架構,Agent軌跡與長距離依賴相關的困惑度也更低。
到了256k上下文,HySparse2在RULER-v2拿到58.45,上一代HySparse是32.61,Hybrid SWA是35.74。
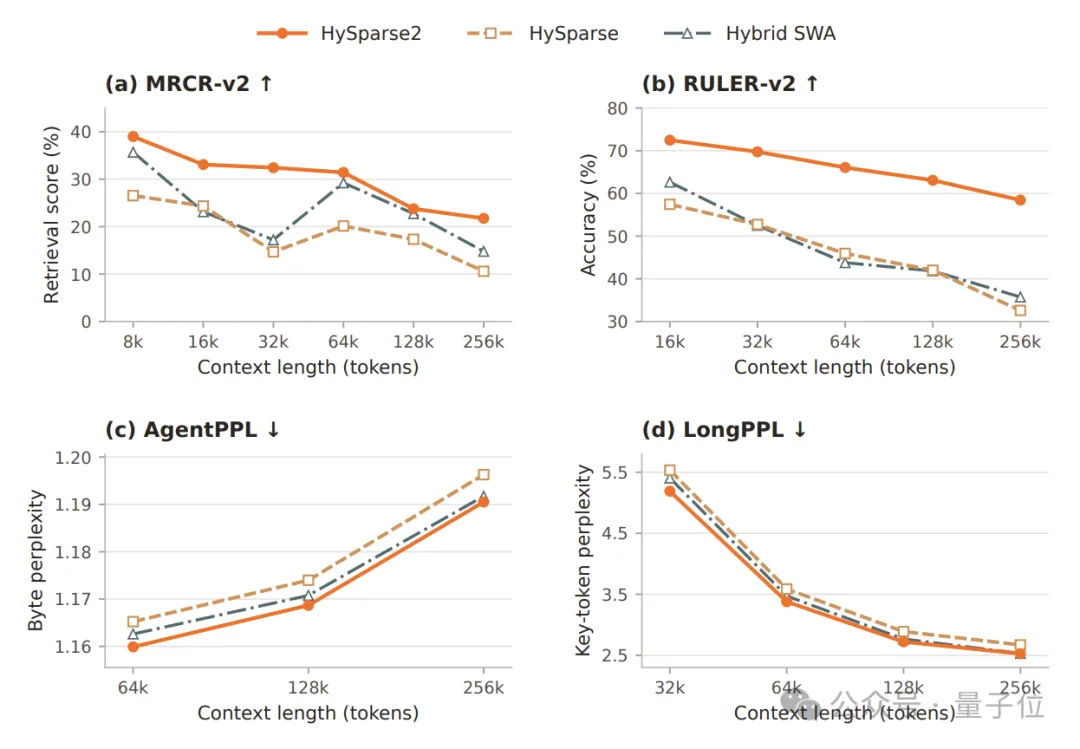
按測試長度取平均,它的MRCR-v2和RULER-v2成績比HySparse分別高11.30和19.81個百分點。
成本上,在100萬token處,論文分析得出的預填充計算量,HySparse2比HySparse降低約2.92倍,比Hybrid SWA降低約5.02倍。
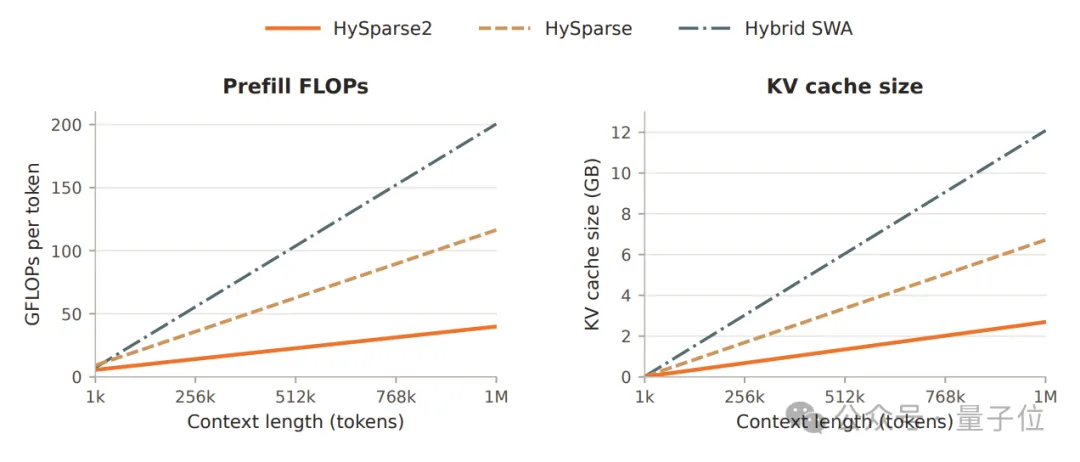
採用FP8快取時,三者的KV Cache佔用分別為2.69GB、6.72GB和12.09GB。
但5.02倍比較的是預填充計算量,不是實際響應速度;論文的長上下文能力測試評估到256k,100萬token對應的是計算量與快取分析。
MiMo-V3尚未發佈,實際產品裡的延遲與任務表現,還要等模型落地後再看。
不過,HySparse2的取向已經很清楚——
Agent執行任務時,工具會不斷送回大量新內容,歷史裡的關鍵線索又不能丟。
MiMo-V3能把論文裡的改進帶進多少實際任務,將是接下來更值得關注的結果。
參考連結:https://x.com/_LuoFuli/status/2102766365190901957?s=20
論文地址:https://arxiv.org/pdf/2609.26368 (量子位)