
在邊緣計算與大模型融合的浪潮下,晶片行業正經歷一場深刻的架構變革。長期以來,為了應對圖像渲染、語音識別、電腦視覺及神經網路推理等多元化任務,晶片廠商往往傾向於在SoC中不斷疊加專用的加速模組——CPU、GPU、DSP與NPU各司其職。
但問題也由此產生。“每一個加速器都能很好地解決一個問題,但每一個加速器也會創造一個依賴。”
在Imagination Technologies日前舉行的媒體開放日活動上,公司CEO Markus Mosen將這種代價形象地稱為一筆“邊境稅”:不同計算單元像一座座孤島,資料要不斷經過外部記憶體在GPU、NPU、DSP、CPU之間搬運,每跨過一次邊界,都要同時付出三種成本——能耗、時延,以及工程師的開發和維護時間。
對此,Imagination想做“減法”。讓GPU從單純的圖形處理器,進一步成為圖形、通用計算和AI之間的“融合加速器”。近日,Imagination正式公佈其最新的E系列GPU IP的計算性能資料,顯著的性能提升進一步強化了其GPU-First的戰略,E系列採用一顆處理器、一套架構和一套軟體棧,同時處理圖形、計算和AI工作負載。
碎片化架構的“邊境稅
”與GPU的重心崛起
從終端使用者的角度看,一部手機、一輛汽車、一個機器人或者一台工業攝影機,其實並不會把“感知、建模、推理、決策、渲染”看成五件毫不相關的事情。它們發生在同一條資料鏈路里,面對同一個響應時間,共享同一塊電池,也共享同一個記憶體和功耗預算。
現在的問題是,工作負載已經融合,硅片架構卻沒有完全跟上。
傳統異構SoC往往由CPU、GPU、NPU和DSP分別承擔不同任務,每個處理器又擁有自己的本地記憶體和軟體環境。中間結果不得不反覆進出DRAM。Markus認為,這些“邊界”本身就是成本。
資料搬運消耗的是納焦耳,任務切換增加的是毫秒,而驅動、工具鏈、安全模型和軟體維護最終消耗的,則是以“工程師年”來計算的研發資源。Imagination因此提出,與其不斷增加新的專用計算島,不如儘可能建立一個共享、可程式設計的計算中心。
融合已經在發生,誰最適合成為這個計算重心?Imagination的判斷是GPU。
理由並不只是GPU算力高,而是它同時具備幾個已經存在的基礎:高度可程式設計、大規模部署、成熟的驅動和工具鏈、標準API以及龐大的開發者生態。更重要的是,對於手機、PC和數字座艙等視覺裝置來說,GPU本來就是無法被拿掉的處理器。
按照Markus所說:“計算的重心正在往GPU轉移,圖形和AI靠得更近,需要統一記憶體、統一調度、統一軟體棧。”這一切歸根到底就是兩個字——效率,既是客戶開發的效率,也是產品跑起來的效率。要最好地解決效率,方向就是GPU。
E系列:把AI真正嵌進GPU
“GPU是使用者體驗的核心”Imagination首席營收官Jake Kochnowicz先拋出了這樣一個判斷。
無論手機、平板、PC還是數字座艙,只要裝置擁有螢幕,最終呈現在使用者眼前的每一個像素,幾乎都繞不開GPU。與此同時,經過幾十年的發展,GPU已經從單純的圖形處理器變成高度可程式設計的平行計算平台。DirectX、Vulkan、OpenCL等行業標準,以及圍繞GPU形成的驅動、工具鏈和開發者生態,也早已相對成熟。
因此,在Jake看來,當AI開始越來越深地介入使用者體驗,GPU其實是最自然的承載者之一。圖像超分、神經渲染、生成式AI、語音助手、生產力工具乃至本地大模型,都需要大量平行計算。而在很多SoC中,GPU本身已經是面積和計算能力最大的處理單元之一。
過去給SoC增加AI能力,一個很直接的辦法是再加入一個NPU。雖然每個處理器都能在自己的領域獲得更高效率,但代價是晶片內部形成越來越多的“計算孤島”:GPU處理圖形,NPU處理AI,CPU負責調度,不同計算單元擁有不同的資料路徑和軟體環境。
E系列選擇的是另一條路。不是繼續增加新的計算島,而是把AI矩陣計算能力直接融入GPU原有的資料路徑。
E系列最核心的一項架構變化,是矩陣加速能力與GPU執行單元的深度耦合。Jake介紹,E系列將矩陣乘法能力直接放進GPU內部,緊鄰現有圖形計算單元。“這意味著AI能把GPU現成的一整套東西都用上:暫存器、控制、快取、韌體、驅動、工具鏈,還有圍繞GPU的整個生態,這是對既有投資極高的槓桿利用。”
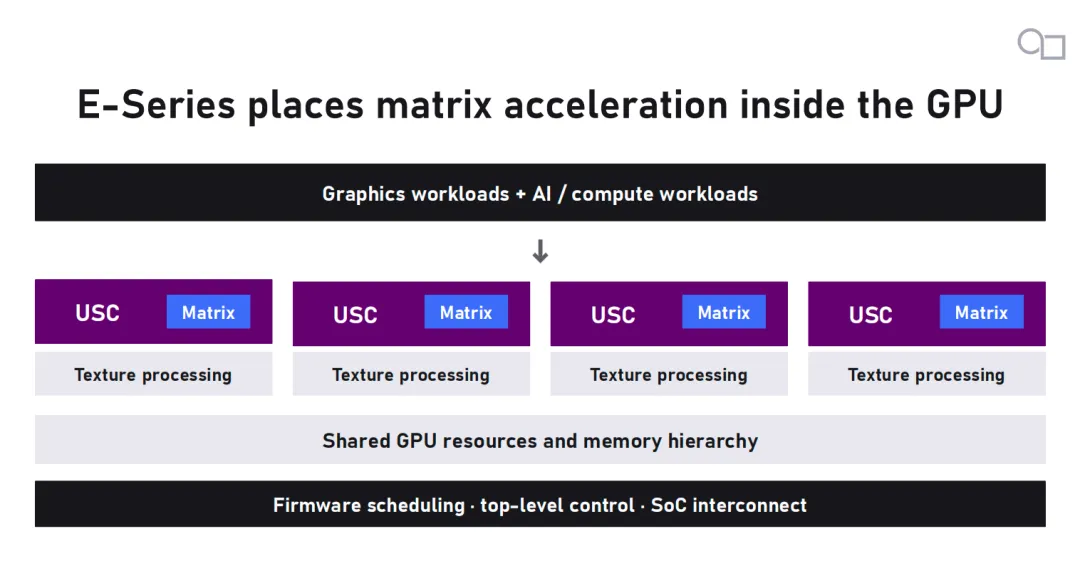
從性能上來看,在1GHz下,E系列單核心FP32算力達到2 TFLOPS;矩陣計算方面,FP16/BF16可達到16 TFLOPS,INT8/FP8達到32 TOPS。最大四核組態下,FP16矩陣性能超過100 TFLOPS,FP8則超過200 TFLOPS,相比D系列提升超過4倍。
但Imagination反覆強調,GPU不能只看TOPS和FLOPS,它還得能塞進真實系統,給系統設計者留足選擇。E系列核心從單核到四核可擴展,峰值組態下可定址記憶體1TB,峰值讀頻寬768GB/s,通過AXI能接HBM、LPDDR、GDDR或者統一記憶體任意一種。不同產品規模可以變化,但背後使用的仍然是同一套IP和軟體棧。
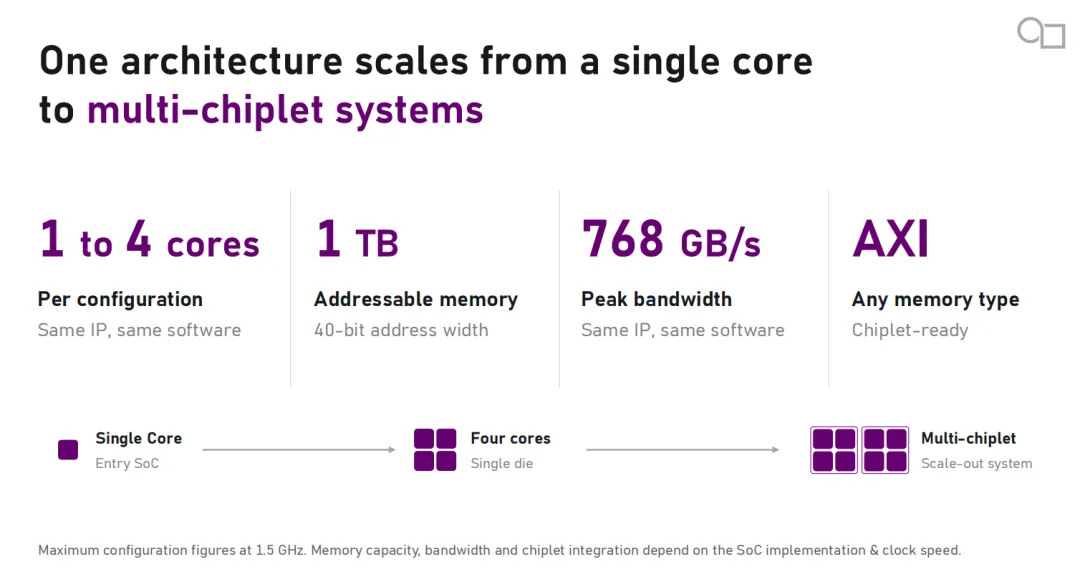
這或許也是Imagination所謂“融合”的真正含義:並不是所有任務都必須由GPU完成,而是儘可能讓不同任務共享同一套底層計算資源和軟體基礎。
圖形與AI的融合典範:
神經超解析度NSR
此次媒體開放日中發佈的NSR神經超解析度,最能體現這種融合價值的一個應用。
今天AI超分已經不是新鮮概念。輝達有DLSS,AMD有FSR,移動GPU廠商也在陸續把AI引入圖形渲染。
但Imagination給NSR找到的切入口並不是單純追求更高畫質,而是資料搬運效率。
傳統GPU+NPU方案中,GPU先完成渲染,再把結果寫入DDR;NPU重新讀取資料完成超分,然後再寫回記憶體。Jake強調到,在任何裝置裡去記憶體取數都可能極貴,資料搬得越遠越耗時越耗電。神經渲染就是展示這種距離成本,以及“融合”為什麼有價值的最好例子。
E系列的做法則是將圖形Shader和矩陣計算放得足夠近,使圖形與AI可以在同一套GPU執行環境裡完成。這與Imagination長期採用的TBDR(分塊延遲渲染)架構也形成了結合:不是等完整一幀圖像全部生成後再處理,而是以Tile為單位進行渲染和計算。
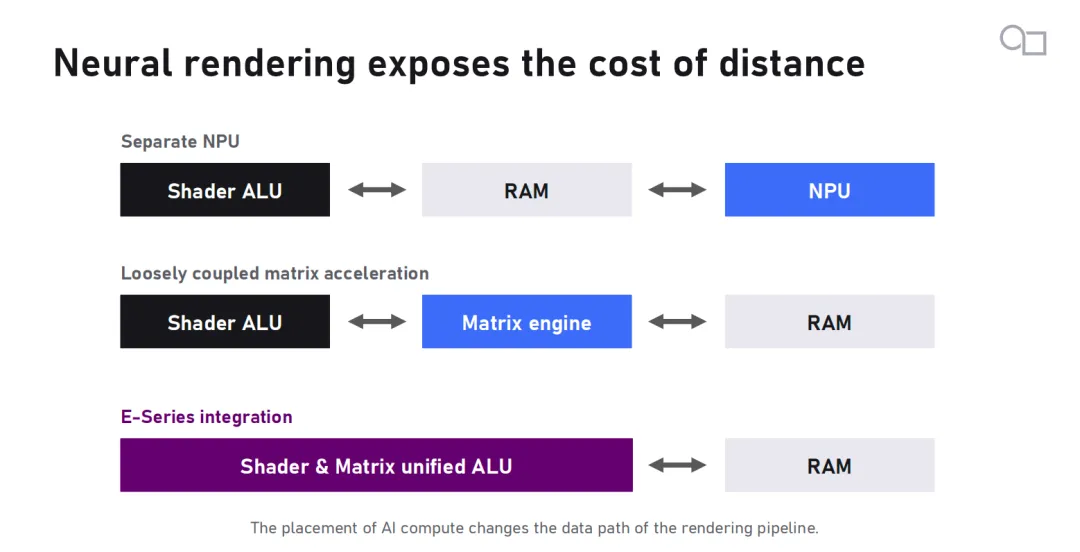
這非常符合移動和邊緣裝置的特點。因為與擁有獨立視訊記憶體和巨大視訊記憶體頻寬的桌面GPU不同,手機、汽車、機器人SoC上的GPU往往需要和CPU、ISP等模組共享系統記憶體,每一次額外的資料搬運都更加昂貴。
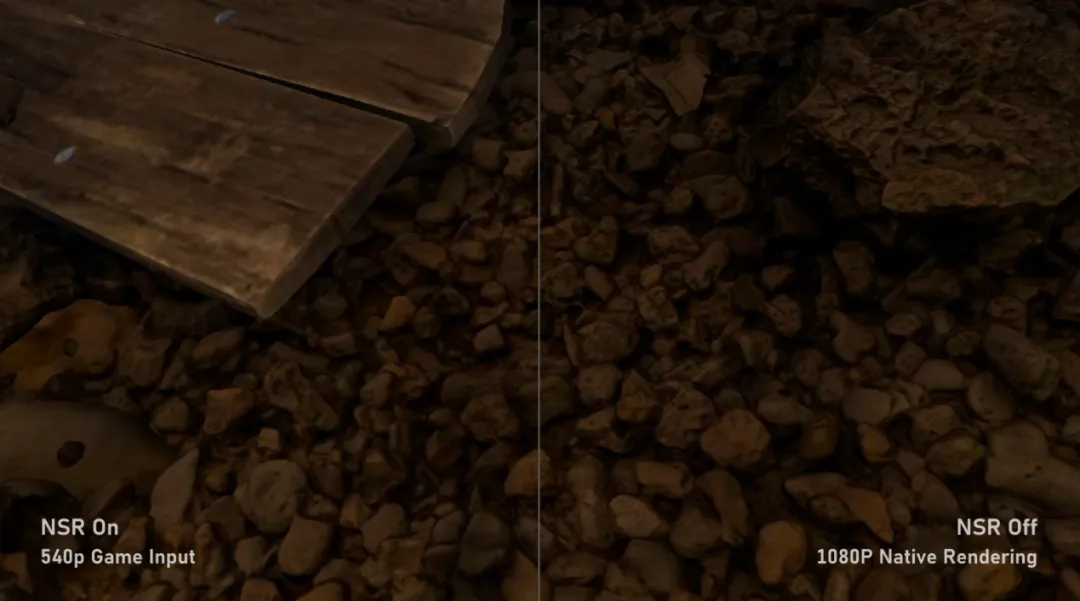
NSR採用單次處理網路,並結合Imagination的網路自壓縮技術,可移除約65%的冗餘權重。在1GHz單核E系列GPU上,將540p畫面提升至1080p僅需2.3毫秒;從1080p提升至4K時,頻寬消耗最高可降低54%,影格率提升2.5倍。
向AI擴展,並不意味著Imagination放棄GPU最傳統的圖形能力。圖形仍是基本盤。
E系列也在明顯向更高性能的圖形市場擴張。
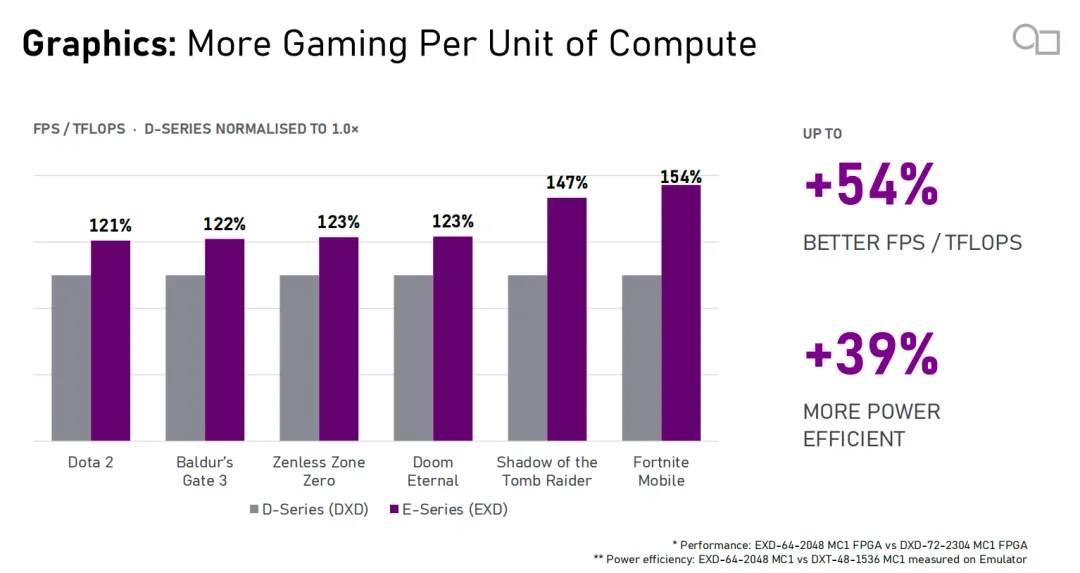
按照Imagination公佈的資料,四核E系列運行《博德之門3》時可以超過60fps,《古墓麗影:暗影》《毀滅戰士:永恆》等PC遊戲也已完成展示。相比上一代D系列,其每TFLOPS對應的影格率最高提升54%,能效最高改善39%。這一提升的核心之一,同樣是減少無效的資料移動和提高計算資源利用率。
E系列裡整合了Imagination自研的高性能RISC-V韌體處理器,在GPU架構上把圖形和計算工作平行調度。底層最多支援4核、16台虛擬機器,帶高品質服務、工作負載優先順序和記憶體隔離,雲遊戲、雲桌面這類場景都能撐住。
從神經渲染走向端側大模型,
全端AI推理最佳化
圖形只是第一步。從神經渲染繼續向前,E系列瞄準的是更廣泛的端側AI,並重點強化了兩類基礎計算:矩陣乘法和摺積。
Jake表示:“如果矩陣乘法代表推理和思考,那麼摺積就是感知。”
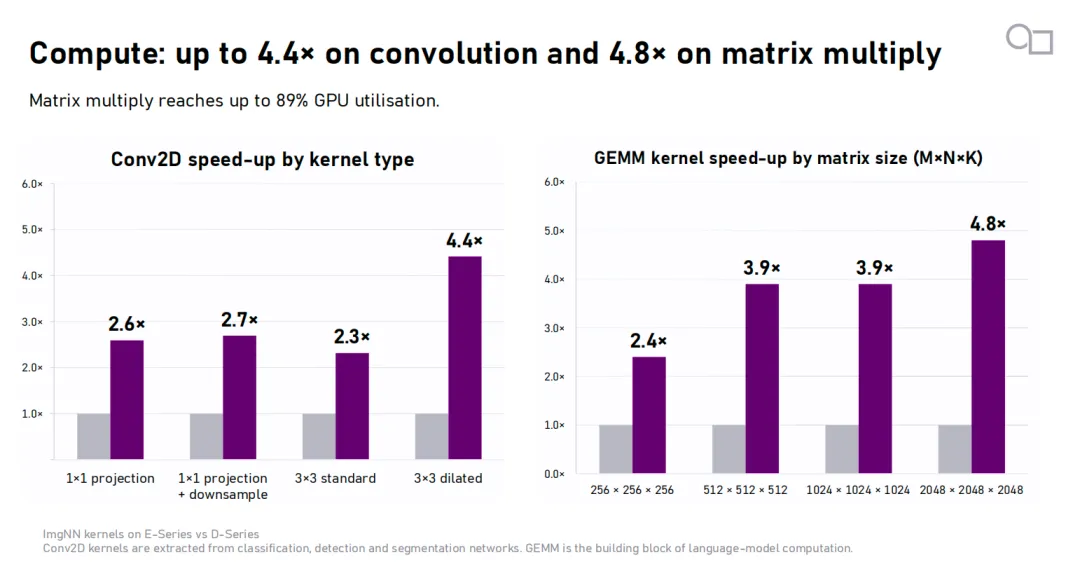
E系列矩陣乘法性能最高提升4.8倍,摺積性能最高提升4.4倍,分別對應語言模型和視覺感知等不同AI工作負載。
到了大語言模型,Imagination將LLM推理拆成兩個階段:prefill(預填充,就是“問”)和decode(解碼,就是“答”)。從工作負載複雜度和使用者體驗看,最難、最重要的是prefill——要在儘量短的時間裡給大模型處理海量資料,衡量指標是time to first token(TTFT),也就是處理器聽懂你的問題、開始吐第一個token要多久。E系列把prefill性能提升了4.7倍,這對好幾個場景都很關鍵:手機上讓大模型做摘要,你希望幾乎秒回;車或者機器人看到資料,必須以足夠高的影格率處理圖像。
Decode階段(每秒多少token)則取決於系統頻寬,也就是片上記憶體給的頻寬,每個token都要搬資料、多載權重。我們在工具和軟體上投入,幫客戶把模型量化到低位寬還保住精度。但要說清楚,AI不只是看TOPS——系統頻寬受限時,更多TOPS解決不了系統問題。E系列的目標,是把開發者需要的算力給足,讓系統整合商能專心去做他們終端產品的整套系統。
實際測試中,車機行程規劃可實現約0.2秒TTFT、150 tokens/s;智能眼鏡環境描述約0.25秒、153 tokens/s;郵件解讀和摘要約0.86秒、126 tokens/s。對於輕量化端側模型而言,首Token時間已經可以壓到1秒以內。
這種能力在Agentic AI時代尤為重要。現場Demo通過Llama.cpp連接OpenCode智能體框架,模型在輸出第一個Token之前,需要先完成工具呼叫、資料收集和推理。對於程式碼Agent等長上下文場景,檔案越多、工具呼叫越複雜,對Prefill性能的要求也越高。與此同時,端側運行還能降低雲端呼叫成本,並減少程式碼、資料等敏感資訊離開裝置的風險。
除了算力,E系列也在資料精度上進一步向AI靠攏,支援BF16、mxFP8、mxFP4等格式。不同場景可以在精度、頻寬和模型容量之間進行取捨:自動駕駛等場景更強調高精度,而消費級邊緣裝置受記憶體和頻寬限制,更低精度的資料格式則有助於降低資源佔用。
從矩陣計算、摺積,到Prefill、Decode,再到資料精度和軟體棧,Imagination試圖做的並不是單純給GPU增加AI算力,而是圍繞端側AI推理進行一整套系統級最佳化。
統一軟體棧的重要性
對於GPU而言,硬體性能只是基礎,真正決定能力能否落地的,很大一部分還在軟體。
Imagination在圖形側支援DirectX 12、OpenCL、Vulkan,可運行於Linux、Android和Windows;AI與計算側則進一步支援ONNX、PyTorch,並持續向Llama.cpp等開放原始碼專案貢獻最佳化。同時,公司還提供自有計算庫、開發工具和分析器,幫助開發者完成從開發、最佳化到部署的完整流程。
Jake特別強調,E系列始終建構在統一的軟體棧上。客戶針對某一代GPU所做的軟體最佳化,不會因GPU產品換代而付諸東流,而是能夠一代一代、持續沿用。
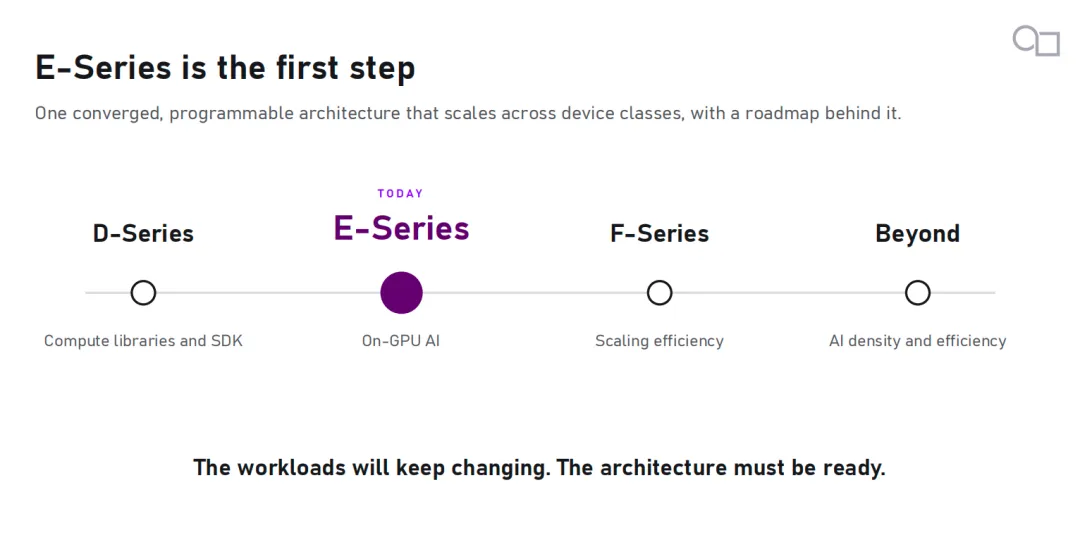
E系列也只是第一步。Imagination給出的路線圖是:D系列開始建構計算庫和SDK;E系列正式把AI計算引入GPU;下一代F系列繼續提升規模擴展效率;再往後的產品,則進一步提高AI計算密度和能效。
中國市場:
從重要客戶市場走向共同創新
近期,Imagination完成中國區管理團隊調整,任命謝巍出任執行副總裁兼中國區總經理,宣雄文出任中國區銷售副總裁,並繼續強化北京、上海、深圳等地的客戶支援和銷售網路。
這一調整背後,也與中國市場對GPU能力提出的更高要求有關。Jake Kochnowicz在媒體問答中表示,相比部分海外市場更側重汽車等深度嵌入式應用,中國客戶對於更高性能、更完整功能集以及圖形與計算融合能力的需求更加突出,而且往往出現得更早。“中國對圖形和計算的需求非常強,現在跟中國客戶的互動,正在幫助我們創新,把GPU IP的能力邊界繼續往前推。”
從業務進展來看,Imagination也在進一步加碼中國市場。Markus Mosen透露,公司今年已經獲得國內重要戰略客戶的授權;未來還希望與中國客戶建立更緊密的合作關係,包括探索聯合實驗室等模式。不過現階段的重點,仍是持續加強研發和本地支援,把更先進的GPU IP帶給中國客戶。
謝巍則表示:“中國一直是Imagination非常核心的戰略市場,中國的開發生態和出貨量這幾年都在飛速發展。並透露確認今年中國桌面級市場相關出貨正在接近百萬台量級。”
在他看來,下一階段的機會也不僅限於桌面GPU。隨著AI智能體和邊緣AI發展,E系列GPU IP將面向汽車、邊緣計算、具身智慧型手機器人等場景。Imagination希望通過更深入的客戶走訪、更完善的本地技術支援和開放的軟體生態,把中國市場的需求更快反饋到產品和技術路線中。
中國對於Imagination的價值正在發生變化:不僅是一個規模龐大的GPU市場,也開始成為高性能GPU需求、AI應用創新以及產品路線演進的重要推動力。
寫在最後
回顧晶片發展史,計算架構一直在“專用化”和“通用化”之間擺動。早期PC時代,大量2D、視訊等專用功能最終被更可程式設計的GPU逐步吸收。今天,邊緣AI似乎又來到類似節點。
E系列的意義,就在於嘗試把一部分AI計算重新收攏到GPU內部,讓圖形、計算和AI共享更統一的資料路徑和軟體基礎,從而降低那筆“邊境稅”。
這不意味著GPU會取代CPU或NPU。AI系統設計沒有唯一正確的答案,而Imagination認為,E系列在所有方案中都能勝任:可以採用GPU-only,也可以採用GPU+NPU、NPU+GPU,或者兩者相對均衡的架構。但隨著神經渲染、端側大模型和Agentic AI不斷進入終端,幾類處理器之間原本清晰的邊界正在變得越來越模糊。
E系列並不只是Imagination的一次GPU升級,更代表了它對未來端側AI架構方向的一次押注。 (EDA365電子論壇)