
華為昇騰960搶發:一場“系統級突圍”的宣言國慶前夕,華為扔出了一枚重磅炸彈。
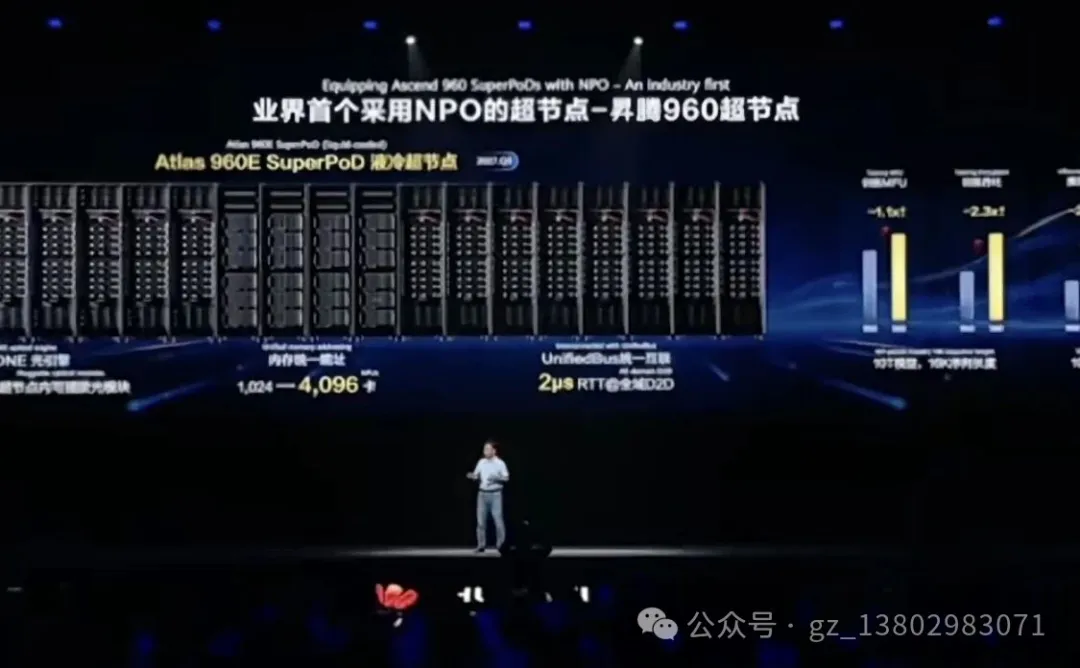
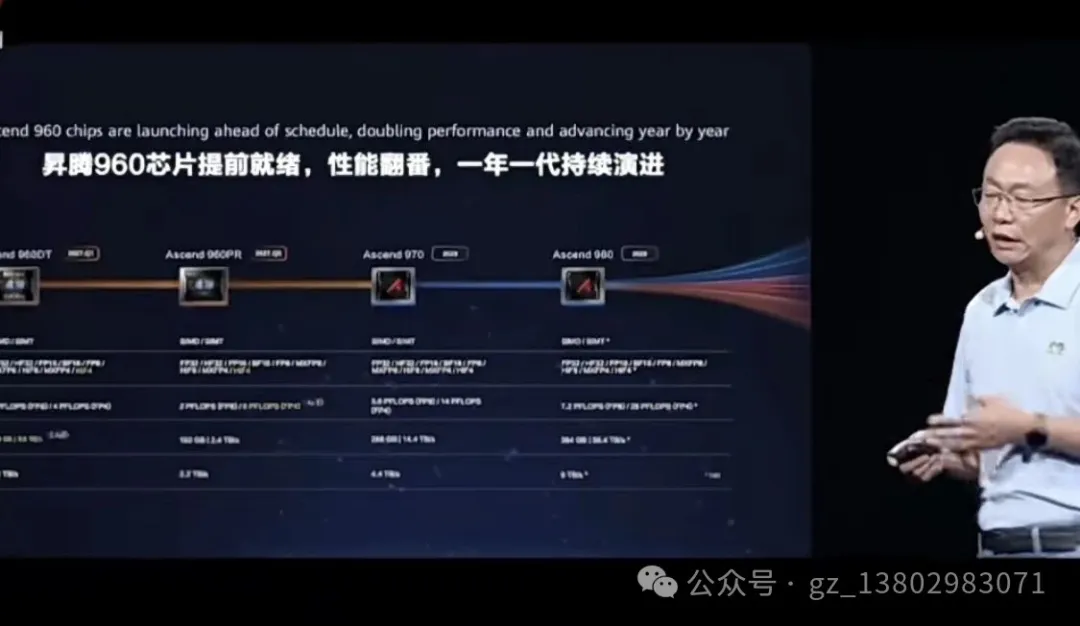
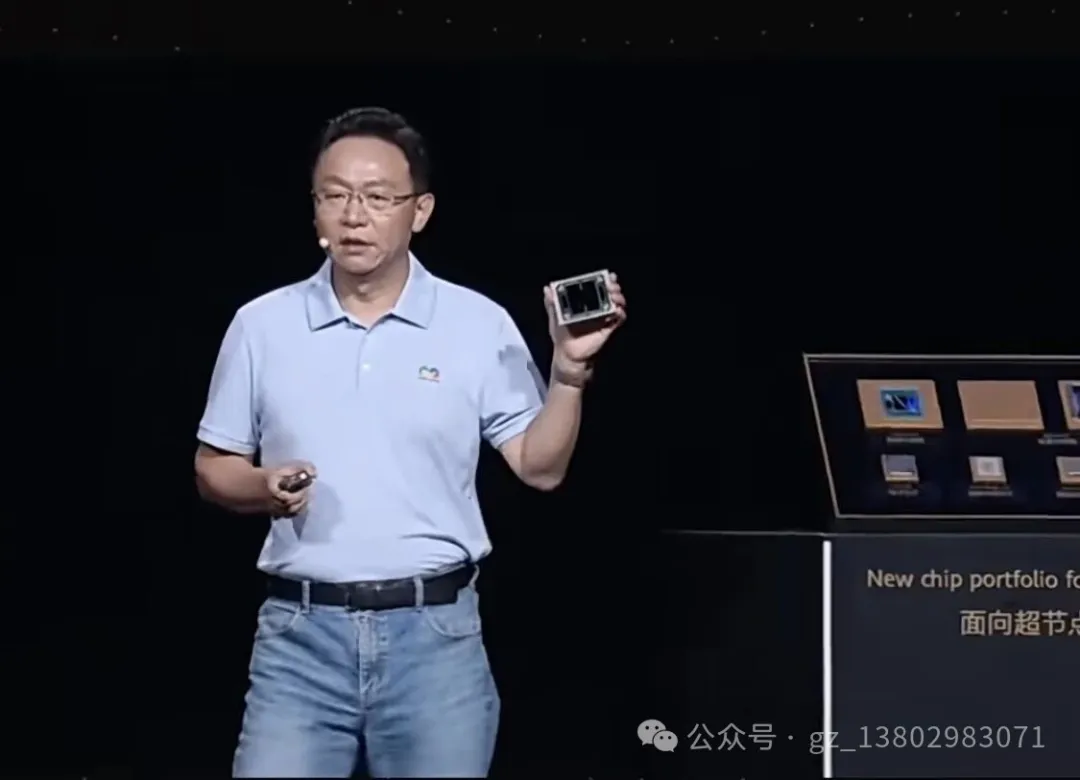
9月底,華為輪值董事長徐直軍正式宣佈,昇騰960DT訓練晶片提前三個季度發佈。更令人震撼的是他的另一句話:昇騰在中國市場的份額,已經超過輝達。
這不是一次普通的產品迭代。這是一個訊號——在美國持續加碼的算力封鎖下,中國AI產業正在用自己的方式,砸開一條路。
一、美國在封鎖什麼?
過去兩年,美國對華AI管制的核心邏輯,已經從“卡晶片”升級為“斷迭代”。
從最初的限制高端晶片出口,到後來將“遠端算力訪問”也納入管制,再到穿透式審查中資企業的海外子公司——美國的目標很明確:不僅要卡住你的單卡性能,還要封死你通過任何管道獲取算力的可能。
邏輯很簡單:AI大模型的訓練需要海量算力,算力不夠,迭代就慢;迭代慢,差距就拉大。
但他們忽略了一件事。
二、華為在做什麼?
華為選擇的,是一條“以系統補單點”的路。
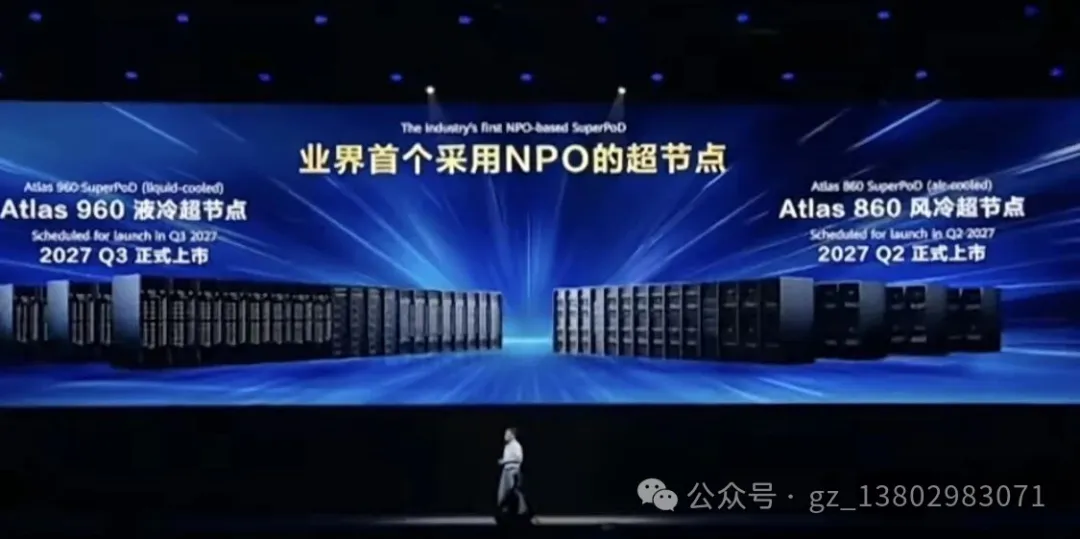
單顆晶片的製程,受限於光刻機等裝置,短期內難以追趕。但華為用自研的“靈衢”互聯協議,將數千甚至上萬張算力卡高效地組織在一起,形成一個超級計算叢集。
這個思路的核心是:我不跟你比單顆晶片的極限性能,我跟你比整個系統的算力輸出效率。
昇騰960DT的提前發佈,證明了這條路是走得通的。通過叢集互聯和系統級最佳化,即便單卡有差距,依然能支撐起兆級大模型的訓練需求。
更重要的是,華為宣佈:昇騰在中國市場的份額,已經超過了輝達。
這意味著,在管製造成的“真空期”裡,中國國產算力生態已經具備了獨立閉環的能力。
三、這背後,是一條產業鏈的集體突圍
華為的突破,不是一個孤立的奇蹟,而是整條中國國產算力產業鏈集體突圍的結果。
算力晶片是“矛尖”。無論是昇騰、還是其他中國國產CPU/DCU,都在加速迭代,試圖在單點性能上縮小差距。
高速互聯是“命脈”。萬卡等級的叢集,需要海量的高速互聯晶片來協調計算與記憶體之間的資料搬運。這是叢集效率的關鍵瓶頸。
先進封裝是“底座”。當單晶片性能提升遇到物理極限,通過2.5D/3D封裝將多顆晶片整合在一起,成為提升算力密度的必然選擇。
這三個環節,構成了中國國產算力基礎設施的“鐵三角”。任何一個環節的突破,都會帶動其他環節的需求;任何一個環節的短板,都會制約整個系統的上限。
四、這對我們意味著什麼?
對於投資者而言,這件事的意義不在於某一隻股票的漲跌,而在於它驗證了一個產業趨勢:
中國AI產業正在形成一套不依賴美國的、從晶片到叢集到軟體生態的完整閉環。
這個閉環一旦形成,就不會輕易被外部力量打斷。它意味著:
•中國國產算力的需求是剛性的,不因短期市場情緒而改變。
•產業鏈各環節的協同是必需的,單點突破無法形成戰鬥力。
•自主可控的處理程序是不可逆的,越封鎖,越加速。
五、寫在最後
國慶前夕的這條消息,像一份無聲的宣言。
它告訴我們:真正的突圍,從來不是在某一個點上超越對手,而是建構一套完整的、屬於自己的系統。
系統一旦建成,就再也無法被輕易封鎖。 (奇聞說今古. 曉汕)