
「CPO=下一個HBM」?
輝達CPO正式量產:下一個「HBM級」產業機會來了?
如果說過去三年的AI硬體戰爭,最重要的關鍵詞是GPU和HBM,那麼2026年,一個新的關鍵詞正在快速衝到台前:
CPO。
更準確地說,是整個光互連產業。
一個非常明顯的訊號是,今年無論OFC還是深圳光博會,產業討論的重心都在發生變化。
過去大家最關心的是800G什麼時候放量、1.6T什麼時候接棒;現在越來越多人開始討論矽光晶片、CW Laser、光引擎、NPO、CPO以及光電共封裝。
原因其實可以濃縮成一句話:
GPU越來越快之後,AI遇到的問題正在從「算不動」,變成「搬不動」。
而2026年真正具有標誌性意義的變化,是CPO已經不再停留在PPT、樣機和技術路線圖上。
它開始量產了。
一、2026年,CPO跨過量產臨界點
過去幾年,CPO一直是光通訊產業最熱門、也最容易被質疑的技術之一。
幾乎每一年,都有人說「CPO元年到了」。
但真正的大規模商業化始終比預期慢。
原因並不複雜。
傳統可插拔光模組已經擁有非常成熟的產業鏈,壞了可以直接拔掉更換,升級也非常方便。而CPO要把光學器件進一步靠近交換ASIC,甚至把光引擎與交換晶片整合到同一個封裝體系中,對矽光、耦合、封裝、散熱、測試、良率和可靠性的要求都大幅提高。
所以過去產業一直面臨一個問題:
CPO技術很好,但到底什麼時候真正量產?
2026年,這個問題終於出現了一個比較明確的答案。
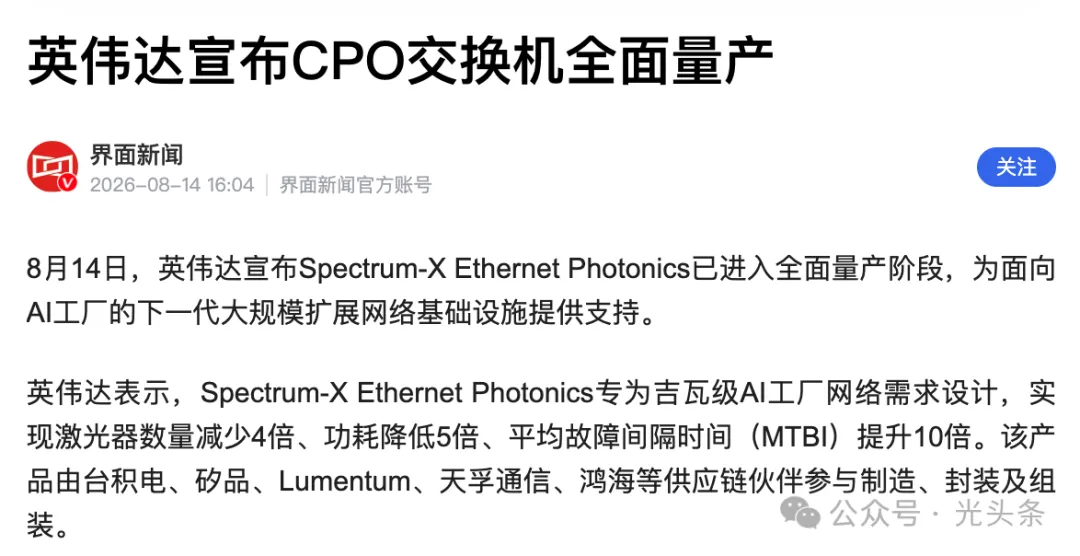
TrendForce今年7月披露,輝達已經開始向部分合作夥伴出貨新一代Spectrum-X CPO交換機,博通51.2T Bailly CPO交換機也在持續小量出貨。TrendForce因此判斷,CPO已經正式邁入量產階段。
這件事情的重要性,可能比輝達第一次發佈CPO產品還要大。
因為發佈產品代表技術路線成立,而進入量產意味著產業鏈開始真正產生訂單、產能和供應鏈需求。
輝達自己的資訊更加明確。
今年5月,輝達宣佈Vera Rubin進入全面量產時,明確表示Spectrum-X Ethernet Photonics已經進入production。這套系統採用CPO,將矽光技術直接引入Spectrum-X交換體系,用於支撐未來百萬GPU級AI Factory。
也就是說:
CPO已經開始從「下一代技術」變成「這一代產品」。
這可能就是2026年光互連產業最重要的分水嶺。
二、為什麼GPU越強,反而越需要光?
理解CPO之前,首先要理解一個正在發生的AI基礎設施變化。
過去我們習慣於把AI算力理解為GPU性能。
一張GPU算力更強,就意味著AI性能更強。
但當資料中心從幾千張GPU擴張到幾萬張、幾十萬張,甚至未來向百萬GPU叢集演進之後,真正決定整個系統效率的已經不只是單顆GPU。
還有GPU之間能不能快速交換資料。
可以把AI資料中心想像成一個巨大的工廠。
GPU就是工廠裡的工人。
過去工人數量少的時候,提高每一個工人的工作效率最重要;但當工廠裡出現幾十萬甚至上百萬個工人以後,如果物流系統跟不上,再強的工人也只能站在那裡等原料。
AI叢集也是一樣。
訓練大模型時,大量GPU需要不斷交換參數、梯度和中間資料。GPU數量越多,需要搬運的資料就越龐大。
於是一個非常現實的問題出現了:
晶片越來越快,但晶片之間的連接沒有那麼快。
這就是所謂的「頻寬牆」。
TrendForce指出,隨著AI訓練和推理規模擴大,AI資料中心正在向更高功耗、更高密度和更大規模叢集發展,資料搬運產生的能源消耗已經讓雲服務商開始把互連技術提升到與計算晶片接近的戰略位置。
這也是為什麼AI時代正在重新定義「算力」。
未來真正的算力可能不再只是:
GPU × 單晶片性能。
而是:
GPU × HBM × 網路 × 光互連 × 軟體效率。
任何一個環節跟不上,都可能讓昂貴的GPU等待資料。
從這個角度來看,光互連不是GPU的配角。
它正在成為AI算力本身的一部分。
三、銅為什麼開始不夠用了?
現在伺服器和交換機內部仍然大量使用銅互連。
原因非常簡單:
便宜、成熟、可靠。
短距離通訊中,銅一直具有極強的競爭力。
但問題在於,隨著SerDes速率不斷從100G/lane向200G/lane甚至400G/lane推進,銅互連面臨越來越嚴重的訊號損耗。
距離越長、速率越高,問題越明顯。
為了讓高速電訊號繼續跑下去,系統必須增加Retimer、DSP等器件進行訊號補償。
結果就是:
功耗增加。
成本增加。
散熱壓力增加。
系統複雜度也增加。
TrendForce指出,當資料速率從100Gbps/lane升級到200Gbps/lane,並繼續向400Gbps/lane演進時,傳統銅互連在訊號損耗、補償成本和功耗方面的限制會越來越明顯。
這也是整個行業為什麼開始把「光」不斷向晶片靠近。
傳統架構大致是:
ASIC → PCB電訊號 → 可插拔光模組 → 光纖。
問題就在ASIC到光模組這一段。
隨著速率越來越高,這段PCB上的高速電訊號越來越難跑。
於是產業開始嘗試縮短它。
LPO進一步降低DSP帶來的功耗。
NPO把光引擎搬到ASIC附近。
CPO則更激進:
直接把光學系統搬到交換ASIC旁邊。
光離晶片越來越近。
最終目標其實只有一個:
儘可能減少高速電訊號需要行走的距離。
四、CPO到底改變了什麼?
這也是為什麼CPO被認為可能成為AI資料中心的重要技術拐點。
傳統可插拔光模組的邏輯是:
交換晶片負責處理資料,光模組負責把電訊號轉換成光訊號,兩者相互獨立。
CPO則改變了這種結構。
它把矽光光引擎直接放到交換ASIC附近,通過先進封裝實現更緊密的光電整合。
這樣做最大的好處,就是大幅縮短高速電訊號傳輸距離。
輝達披露,其CPO架構可以把相關光鏈路損耗從傳統架構的大約22dB降低到約4dB,並顯著改善訊號完整性。
最終帶來的結果是:
更低功耗、更高頻寬密度、更好的訊號完整性,以及更適合超大規模AI叢集的網路架構。
博通對CPO的判斷也類似。其官方資料稱,相較傳統方案,CPO可實現超過3.5倍的功耗節省、約40%的每位元光學成本下降,並提供超過1Tbps/mm的頻寬密度。
這也是為什麼CPO並不是簡單地把「光模組拆開」。
它實際上重新定義了交換晶片和光通訊系統之間的邊界。
過去交換晶片是交換晶片,光模組是光模組。
未來,兩者可能逐漸變成一個高度融合的系統。
五、輝達為什麼一定要做CPO?
這裡才是整個故事最值得關注的地方。
輝達並不是一家傳統光通訊公司。
它為什麼突然深度進入矽光和CPO?
答案還是AI叢集規模。
輝達下一代AI基礎設施的目標已經不是簡單連接幾千張GPU,而是向幾十萬甚至百萬GPU級AI Factory演進。
當GPU叢集達到這種規模之後,網路功耗、故障率、布線密度以及交換機數量都會成為巨大的工程問題。
Spectrum-X Ethernet Photonics就是為此出現的。
根據輝達公佈的資料,Spectrum-X Photonics中的SN6810可以提供102.4Tb/s頻寬,而SN6800最高可以達到409.6Tb/s,支援512個800Gb/s連接埠,或者2048個200Gb/s連接。
更重要的是功耗。
輝達稱,相比傳統可插拔方案,其Spectrum-X Ethernet Photonics可以實現大約5倍的網路功耗效率提升,同時提高網路可靠性。
對於普通資料中心而言,這可能只是節省一些電費。
但是對於未來百萬GPU規模的AI Factory而言,完全是另一回事。
假設每一個連接都能節省幾瓦甚至幾十瓦,當連線量擴大到數十萬、數百萬級時,最終節省的就是兆瓦級甚至更大的資料中心電力。
這也是為什麼輝達把CPO直接放進Vera Rubin體系。
它已經不再把網路視為GPU外部的配套裝置。
網路本身正在成為AI超級電腦的一部分。
六、真正值得關注的,是CPO背後的產業鏈
因此,輝達CPO量產之後,真正值得資本市場和半導體產業關注的問題已經發生變化。
過去大家問:
「CPO什麼時候量產?」
現在應該問:
「CPO量產以後,誰來供貨?」
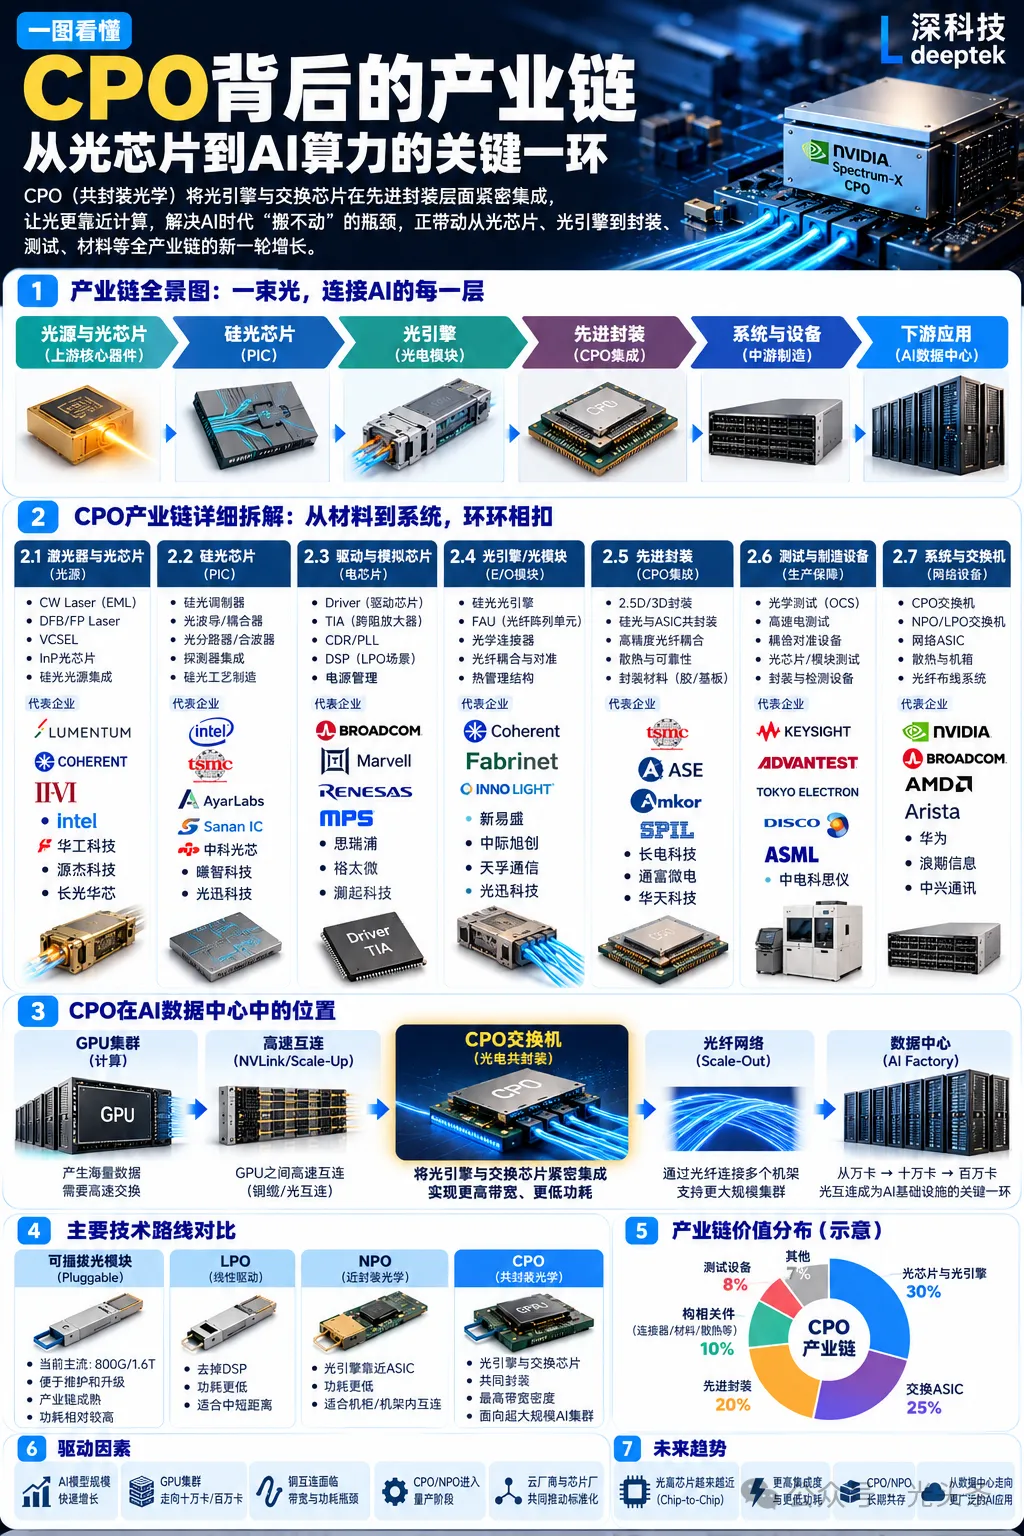
答案涉及一條非常長的產業鏈:
雷射器 → InP光晶片 → 矽光PIC → Driver/TIA → 光引擎 → FAU → 光纖連接 → 光學封裝 → 先進封裝 → 測試裝置。
這也是CPO最像HBM的地方。
HBM真正爆發以後,受益的並不只有SK海力士、美光和三星。
TSV、先進封裝、測試、材料、裝置、載板等整個產業鏈都被重新定價。
CPO也可能出現類似現象。
TrendForce已經指出,輝達和博通開始推動CPO量產以後,真正限制擴產速度的因素正在轉向光引擎、矽光晶片以及先進封裝能力。
這句話非常關鍵。
因為產業真正的大機會,往往不是「需求有沒有」。
而是:
「需求已經出現以後,那裡最缺?」
如果CPO繼續擴大部署,首先需要解決的可能不是交換ASIC。
而是如何生產足夠多、良率足夠高、可靠性足夠好的光引擎。
這意味著未來幾年,光通訊產業的價值量可能繼續向上游遷移。
七、台積電為什麼也進入這場戰爭?
另一個容易被忽略的變化,是先進封裝正在成為光互連產業的核心技術之一。
CPO並不是簡單把幾個光器件粘在交換晶片旁邊。
真正實現大規模商業化,需要解決光、電、晶片、封裝、散熱、耦合和測試的一系列問題。
因此CPO實際上正在把兩個過去相對獨立的產業連接起來:
光通訊和半導體先進封裝。
TrendForce稱,輝達Spectrum-X CPO交換機由輝達與台積電合作開發,並採用台積電COUPE先進封裝技術。
輝達公佈的矽光生態夥伴名單中,同樣出現了台積電、Coherent、Corning、Lumentum、Fabrinet、Foxconn、SPIL、Sumitomo Electric等企業。
這說明一個非常重要的趨勢:
未來光通訊和半導體封裝之間的邊界可能越來越模糊。
CoWoS解決的是GPU和HBM如何高密度連接。
而下一步,先進封裝可能還需要解決:
GPU、交換ASIC和光如何連接。
從這個角度看,CPO很可能成為先進封裝的下一塊重要戰場。
八、為什麼說2026年是光互連真正的拐點?
如果只是輝達一家做CPO,還不足以說明產業趨勢。
真正值得注意的是:
整個AI產業都在向光遷移。
2026年3月,一個非常有代表性的組織成立——Optical Compute Interconnect MSA。
創始成員包括AMD、博通、Meta、微軟、輝達和OpenAI。
它們希望建立面向AI Scale-Up光互連的開放標準和多供應商生態。
這個名單本身已經說明問題。
GPU公司來了。
ASIC公司來了。
雲端運算公司來了。
AI模型公司也來了。
這意味著光互連正在從「光通訊公司的事情」,變成整個AI基礎設施產業共同解決的問題。
與此同時,不同廠商也不一定都會直接跳向CPO。
TrendForce認為,NPO仍然可能是很多CSP中短期的重要過渡路線。阿里巴巴、騰訊正在推動NPO相關開放標準,Meta和微軟也在推動開放光互連生態。
因此未來幾年很可能不是:
CPO取代所有技術。
而是:
可插拔光模組、LPO、NPO和CPO長期共存。
不同距離、不同功耗、不同維護要求,對應不同技術。
真正確定的趨勢只有一個:
光離計算晶片越來越近。
歡迎報名:全光升級,算力落地!10月14日上海國芯展,與產業大咖共話矽光未來,立即報名參會!(最新|上海「矽光」產業研討會!)
九、一個390億美元的新市場正在形成
資本市場為什麼突然開始重新關注矽光、CPO和光晶片?
因為市場規模正在發生變化。
根據TrendForce今年6月發佈的預測:
2025年全球CPO/NPO市場規模大約只有1億美元。
到2030年:
可能超過390億美元。
五年接近390倍。
當然,這只是機構預測,並不意味著最終市場一定會嚴格按照這一數字增長。
但它反映出的產業方向非常清楚。
過去光互連更多解決的是:
伺服器與伺服器之間的通訊。
未來光互連可能進一步進入:
機架之間、機架內部、晶片附近,甚至最終走向Chip-to-Chip。
光正在一步一步逼近計算核心。
於是一個巨大的產業鏈正在重新形成:
GPU/XPU
↓
HBM
↓
交換ASIC
↓
矽光晶片
↓
光引擎
↓
雷射器
↓
先進封裝
↓
光纖
如果說過去幾年AI硬體最大的增量來自GPU和HBM,那麼接下來幾年,市場可能開始尋找:
「誰是光互連時代的HBM?」
十、下一個HBM,可能不是一家公司
不過需要強調一點。
把CPO稱為「下一個HBM」,更多是在描述它的產業地位,而不是說CPO市場一定會複製HBM的增長路徑。
HBM是一種相對明確的產品。
CPO卻是一個系統工程。
它背後涉及矽光晶片、CW Laser、InP、光引擎、Driver/TIA、光纖連接、耦合、封裝、測試等大量環節。
因此真正的產業機會可能不會集中在某一家公司。
它更可能是一條產業鏈。
而且真正值得關注的,也未必是今天收入最大的公司。
反而可能是那些掌握關鍵卡點的企業:
誰能做高速矽光晶片?
誰能穩定供應高功率CW Laser?
誰能把光引擎良率做到足夠高?
誰掌握InP核心器件?
誰能解決光纖陣列和矽光晶片之間的高精度耦合?
誰擁有成熟的CPO先進封裝能力?
誰能夠把這些器件真正做到百萬級甚至千萬級量產?
這些問題,可能比「那家光模組公司訂單最多」更加重要。
因為AI硬體產業正在經歷一個非常典型的變化:
GPU解決計算。
HBM解決記憶體頻寬。
光互連開始解決資料搬運。
當GPU叢集從萬卡走向十萬卡,再向百萬卡演進以後,決定AI Factory性能的已經不再是一顆晶片。
而是整個系統。
這也是為什麼2026年,輝達、博通、AMD、Meta、微軟、OpenAI以及越來越多的半導體和雲端運算巨頭,突然集體湧向光互連。
不是因為光通訊突然變成了一門性感的生意。
而是因為AI算力繼續擴張之後,產業已經繞不開它。
過去三年,市場不斷問:
「誰能造出更快的GPU?」
接下來幾年,一個同樣重要的問題可能是:
誰能讓數十萬乃至上百萬顆GPU真正連成一台電腦?
答案正在越來越清晰。
光。
而輝達CPO進入量產,可能只是這場390億美元光互連戰爭真正開始的第一槍。(光頭條)