
“10分鐘內,拉起1萬個沙箱。”
在Intel Connection 2026期間,英特爾提出了這個數字。每個沙箱的建立時間不能超過60毫秒,沙箱不是空殼,它要承載一個完整的運行環境,包括鏡像、檔案系統和隔離空間。這個需求不是實驗室裡的假設,它來自真實客戶的生產環境。而它也指向一個具體的問題:當智能體從聊天演進到幹活,資料中心到底需要變成什麼樣?
英特爾資料中心集團副總裁、中國區總經理陳葆立在大會主題演講中這樣判斷:預計到2026年底,超過80%的企業應用將至少嵌入一個AI智能體;到2031年,中國企業場景中的活躍智能體數量將達到3.5億個。中國大模型每天的Token呼叫量已增至2024年初的5000倍,而且還在持續增長。這些數字背後,是資料中心算力結構正在發生的一次深層調整。
01. AI進入第三階段,CPU回到舞台中央
陳葆立在接受採訪時詳細拆分了智能體的工作流程:一個Agent接到任務後,先做任務規劃,把目標拆解成若干步驟,然後呼叫工具執行。執行過程中產生的中間結果需要被保存下來,供後續步驟參考。如果任務複雜,還會啟動多個子Agent平行協作,每個子Agent有自己的執行環境和需要記住的上下文。他舉了一個日常的例子:使用者讓Agent每天早上8點蒐集前一天的AI新聞並總結。Agent需要上網找資料,拿回來的內容可能是網頁、PDF報告或視訊,各種格式的資訊需要先提取、處理,才能交給大模型分析。這些預處理工作,有不少適合由CPU承擔。而且一次模型呼叫往往還不夠,Agent要拆解任務、呼叫工具,再根據結果決定下一步怎麼做。
他把驅動智能體發展的軟體工程演進歸納為四個階段:從Prompt Engineering到Context Engineering,再到Harness Engineering,最後到Loop Engineering。每一步都在減少人工干預,讓Agent更自主地完成複雜任務。而這些軟體機制中,很多工作適合CPU來執行。陳葆立說,“這也是為什麼在過去一年時間裡,AI智能體的興起會帶來對CPU的巨大需求。”
市場預期也隨之大幅重估。針對2030年CPU市場規模的預估,短短半年內,就從2月預測的590億美元上調至8月的2100億美元,約為原先預期的3.6倍。資料中心AI負載佔比預計將從2025年的40%提升至2030年的80%。英特爾CEO陳立武在2026年第一季度財報電話會議上曾提到,AI工作負載重心由訓練轉向推理,CPU與GPU配比正從過往1:8向1:1演進。到本次Connection大會,這一趨勢得到進一步印證:部分複雜智能體場景,甚至需要更高密度的CPU。陳葆立也在採訪中透露了一個來自客戶的真實資料:某國內領先的大模型廠商,從去年到今年CPU需求提高了5倍。
02. 智能體的“草稿紙”與“隔離間”
智能體的工作記憶,可以被理解為一張草稿紙。智能體在推理、統籌、規劃和對話過程中,需要把中間結果留存下來,這就是KV Cache。問題在於,上下文越來越長,這張草稿紙的數量正在爆炸式增長。Kimi的一篇論文顯示,在Agent場景下KV Cache的命中率可以達到50%到70%。這意味著快取機制確實有效,但同時也意味著記憶體壓力巨大。陳葆立給了另一組數字:一個235B參數的模型,如果給它100萬token的上下文窗口,產生的KV Cache大約300GB,已經超過許多GPU的HBM容量。這要麼放不下,要麼不划算,所以必須把KV Cache從HBM視訊記憶體分層解除安裝到DDR記憶體甚至SSD。
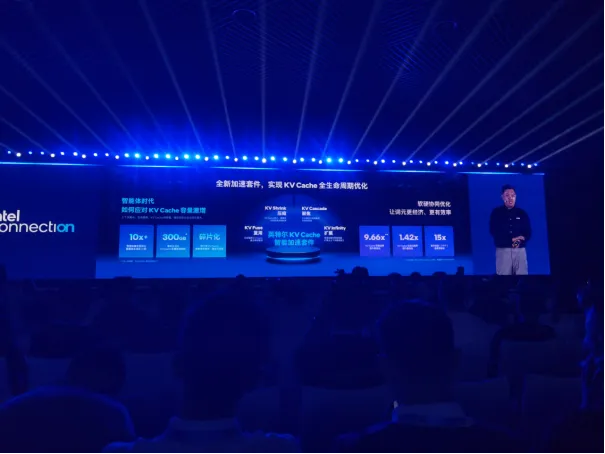
英特爾的解法是KV Cache智能加速套件,核心元件叫KV Shrink,這套方案由三層結構組成。第一層是資料搬運,通過DSA加速器實現視訊記憶體與系統記憶體之間的高效複製,性能是CUDA方案的近10倍。第二層是壓縮,QAT引擎可以實現KV Cache資料50%以上的壓縮率,無失真壓縮也能達到1.42倍,原本300GB的KV Cache,落盤之前可以壓縮到200GB左右。第三層是系統最佳化和調度,讓每一層的解壓與上一層的計算平行起來,把延遲隱藏在重疊的流水線裡。客戶的驗證資料顯示,KV Cache智能加速套件能夠將KV Cache傳輸速率最高提升達9.66倍,首字時延性能最高提升達15倍。它支援兩種部署模式:一種是直接放在AI伺服器的頭節點中,把視訊記憶體裡的KV Cache解除安裝到系統記憶體,做壓縮甚至記憶體,需要時解壓再送回視訊記憶體;另一種是用RDMA把視訊記憶體裡的KV Cache傳送到遠端伺服器。
另一個技術元件是沙箱。沙箱的本質是輕量化虛擬機器,MicroVM,對作業系統鏡像和檔案系統做了裁剪和定製,目標是快、輕量、佔用更少記憶體。它要保護兩件事:Agent自己的敏感資訊不被其他負載看見,以及系統不被Agent執行的不確定程式碼所影響。沙箱的核心KPI是高並行、低延遲。在滿足200毫秒啟動時延的約束條件下,單顆至強6+最多可支援350個沙箱並行建立,是某款同類產品的1.46倍。單顆處理器最高可支援超過1000個智能體的穩定部署,靠的是CPU超配,一個核心同時部署多個Agent,分時復用系統資源。
至強6+在這兩個場景中的表現,指向CPU的密集執行能力。它在系統多載時不降頻,200多個核心同時工作,性能交付幾乎線性。這是沙箱高密度部署的基礎。從微架構層面看,Agent的呼叫行為是間歇性的,發起一次呼叫後等待結果,然後再發起下一次。這種模式下,資料可能在快取中,但指令已經因為間歇而被換出。英特爾在Cache設計上採取多核共享大容量L3/L2的策略,L2 Cache是4核共享4MB,單核可達4MB,80%的指令在L2命中。
03. 至強6+的架構選擇
面對這些需求,英特爾給出的技術回應集中在至強6+上。至強6+是首款基於Intel 18A製程的資料中心CPU,最高配備288顆能效核,提供高達8000 MT/s的DDR5記憶體頻寬和576MB末級快取。Intel 18A已經進入量產階段,高性能版本18A-P也推進至風險試產環節。
但更值得關注的是架構選擇。行業裡有另一種思路:用通用CPU配合外接加速卡,或者讓GPU承擔更多CPU的工作。英特爾選擇把QAT(資料保護與壓縮加速技術)、IAA(記憶體分析加速)、AMX(AI 矩陣運算加速)等加速引擎全部整合到CPU內部。當問及英特爾為何選擇這條路時,陳葆立解釋到:“如果加速能力外接,資料在CPU與加速卡之間的往返開銷會抵消掉解除安裝本身節省的成本。”
在KV Cache的場景裡,這個邏輯很清晰。QAT是內建的壓縮引擎,可以在不佔用GPU資源的情況下完成KV Cache資料的壓縮和解壓。DSA像一個內建的DMA控製器,負責視訊記憶體與系統記憶體之間的高效複製。AMX則用於AI資料預處理和向量資料庫加速。這套方案的核心設計是流水線重疊:每一層的解壓與上一層的計算平行起來,讓壓縮解壓的延遲隱藏在計算之後。陳葆立在主題演講中還展示了AMX在資料預處理場景中的效果。他以AI蒐集財經新聞並總結為例:Agent需要從網頁、PDF、視訊等不同格式的資料中提取文字,才能輸入大模型分析。借助AMX等加速能力,向量化和重排序性能分別達到對比基準的2倍和4倍。在GPU方面,英特爾發佈了新一代GPU Crescent Island,基於全新Xe3P架構,面向AI推理和Agentic AI場景設計。其特性之一是大視訊記憶體,通過LPDDR5x技術可配備128G、256G甚至480G的大容量記憶體,用於AI推理和KV Cache記憶體。
04. 從一顆晶片到一整個機櫃
陳葆立把未來資料中心概括為三類協同的叢集:CPU伺服器或CPU叢集負責智能體執行和工作編排,GPU伺服器承擔模型推理,記憶體叢集承載長對話、文件、合同等不斷增加的資料。“這三類叢集有一個非常重要的共同點,就是都需要CPU來做資料調度。AI工廠不再以單純的Token產出為衡量標準,而是轉向以任務為導向,通過系統級協同最佳化,實現更低資源消耗、更高運行效率。”
為什麼需要整機櫃?因為當智能體數量從一百個擴展到一千個,瓶頸就不再是單顆處理器的核心數,而是記憶體容量、節點間通訊、供電和散熱的系統級平衡。沙箱超配的極限不在CPU核心數,而在記憶體容量。以一個128核系統、1:2的核記憶體比、4倍超賣計算,一個節點就需要1TB記憶體。在採訪中,陳葆立進一步解釋了Agent帶來的記憶體挑戰。傳統模式下,一個虛擬機器記憶體容量2GB,幾個核對應一個虛擬機器,每個CPU核用不了幾百兆。現在反過來,一個核要承載四五個Agent,每個Agent都要2GB。“雖然它不是每時每刻都在跑,但是它每時每刻都吃你的記憶體容量。”這要求在有限的CPU邊沿下,每個通道能插兩根DIMM而不只是一根,同時插兩根時還要保持更高的頻寬。
我們也看到,英特爾在大會現場聯合產業夥伴發佈了開放Agent整機櫃平台規範,讓更多廠商能夠基於這套標準打造自己的整機櫃產品。衡量整機櫃可交付智能體數的框架是:理論值乘以三個係數,暨CPU調度有效性、資源平衡度和計算解除安裝效益。在資源平衡度方面,測試發現每個Agent的記憶體頻寬需求不超過1GB/s,建議每個Agent至少配置2GB記憶體。相比I/O,記憶體更容易成為限制;而在記憶體容量和頻寬之間,容量更值得關注。英特爾至強6和至強6+提供了基於CXL的Flat Memory Mode,通過CXL擴充記憶體,硬體在擴充記憶體和本地記憶體之間管理資料放置,對作業系統和應用透明,應用不需要做任何改變。
05. 算力帳本正在被重寫
把以上技術細節放回產業語境,一個更宏觀的變化正在發生。
衡量AI基礎設施的標準在變。過去看的是能產生多少Token,現在看的是穩定完成多少有效任務。這個轉變把CPU推向了系統中樞的位置。任務拆解、工具呼叫、沙箱調度、上下文管理、資料預處理,這些工作GPU做不了,也不該做。英特爾在Connection大會上做的事情,是在為這個轉變鋪設硬體底座。至強6+的加速引擎全內建,是為了讓資料搬運和壓縮不離開CPU的調度範圍;KV Shrink的分層解除安裝,是為了讓有限的HBM視訊記憶體承載更多的並行任務;開放Agent整機櫃平台規範,是為了把單晶片的能力擴展為系統能力。
這個底座還有一個容易被忽略的支撐點,是生態。陳葆立舉了一個他自己的案例:他裝了一個桌面智能體,讓它把照片背景摳掉。Agent發現電腦上沒有摳圖軟體,就上網去找PyTorch的開放原始碼,下載下來自己寫了一個摳圖程序。“AI學習的路徑上,所有的執行都是CPU在做。”他補充說,那個PyTorch程式碼可能是過去三五年有人寫的,極大可能是X86架構。“過去10年、20年,開源社區裡很多功能都是基於X86寫的。所以在Agent時代,用X86去做智能體是非常有優勢的。”
回到開頭那個問題:當智能體從聊天演進到幹活,資料中心到底需要變成什麼樣?英特爾的答案是,它需要從一個以Token產出為衡量標準的計算設施,變成一個圍繞智能體任務節奏重新組織的系統。晶片的定位在變,記憶體的角色在變,機櫃的設計邏輯在變,而CPU重新回到了這個系統的調度中樞。陳葆立在採訪最後判斷:“未來五年,資料中心裡每一顆晶片的定位都會被重新討論。”這個討論的核心問題,不是誰的算力更強,而是誰更適合智能體時代的任務分工。從目前的產業動向來看,英特爾正在用自己的方式給出答案。 (EDA365電子論壇)