
🔷告別傳統正面供電,PowerVia通過nano-TSV直達電晶體
🔷供電、訊號首次真正“分家”,Intel 18A重構晶片互連體系
這篇文章,小編想帶大家真正“拆開”英特爾最新一代 Panther Lake,看看被寄予厚望的 Intel 18A 到底做到了什麼。相比單純討論“幾奈米”,我更關注的是18A背後的幾項關鍵變化——RibbonFET全環繞柵極電晶體、PowerVia背面供電、全新的前後端互連體系,以及Foveros-S先進封裝。從實物拆解來看,Panther Lake更像是Intel先進製造的一次集中“交卷”:它不僅要證明18A能夠真正走向商業化,更要回答一個關鍵問題——在TSMC N3E、三星SF2已經進入先進節點競爭的背景下,Intel能否依靠“電晶體+背面供電+Chiplet+先進封裝”重新建立自己的技術優勢?
一、這份材料真正想說明什麼?
通過晶片實物拆解、截面分析、電晶體測量和版圖分析,深入驗證 Intel 18A 工藝第一次大規模進入消費級產品後的真實技術水平。整篇報告圍繞 RibbonFET、PowerVia 背面供電、互連體系、標準單元密度、SRAM、GPU、Chiplet 與 Foveros-S 封裝展開,並與三星 SF2、TSMC N3E 等先進節點進行橫向比較。報告最終想回答的問題可以概括為:Intel 18A 到底是不是一次真正意義上的先進製程回歸,以及 Intel 能否借 Panther Lake 重新證明自己的製造能力。
二、Panther Lake是Intel 18A真正走向商業化的“試金石”
Panther Lake 最重要的意義,並不只是新一代移動處理器,而是它首次把 Intel 18A 的幾項核心技術同時帶入商業產品,包括 RibbonFET GAA電晶體、PowerVia背面供電以及先進Chiplet封裝。從報告拆解結果來看,Panther Lake 並不是一顆完全由 Intel 18A 製造的單片SoC,而是延續 Intel 的分解式架構:Compute Tile採用Intel 18A,GPU根據配置分別採用Intel 3或TSMC N3E,I/O Tile則採用TSMC N6,再通過Foveros-S進行整合。
這體現了 Intel 當前非常明確的戰略——最先進工藝優先用於CPU計算核心,把GPU、I/O等模組交給更成熟或更適合的節點製造。 因此 Panther Lake 本質上也是 Intel “先進製程+Chiplet+先進封裝”路線的一次系統級驗證。
三、18A真正的核心突破之一,是PowerVia背面供電
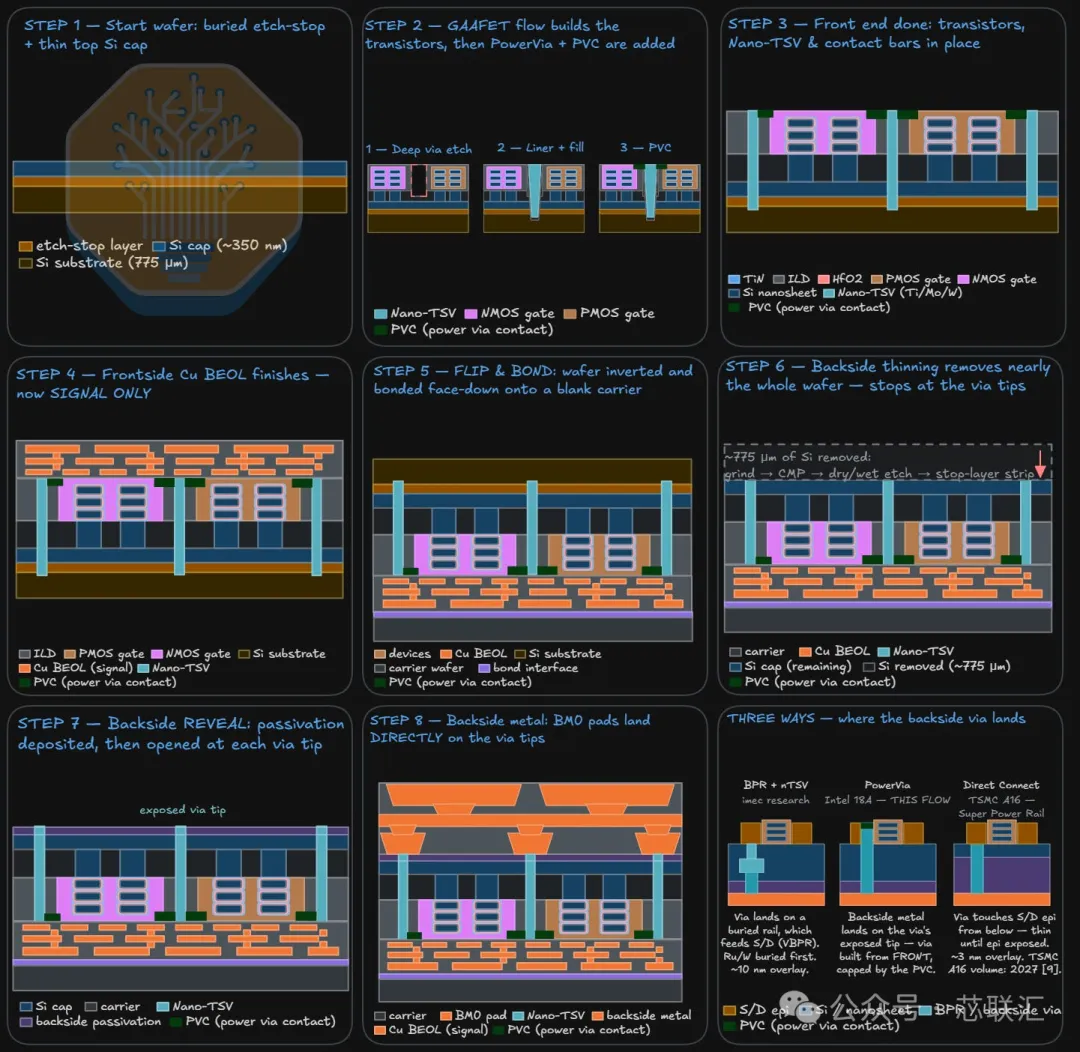
報告花了大量篇幅拆解 PowerVia(BSPDN,Backside Power Delivery Network),這也是 Intel 18A 與傳統先進節點最大的結構差異之一。
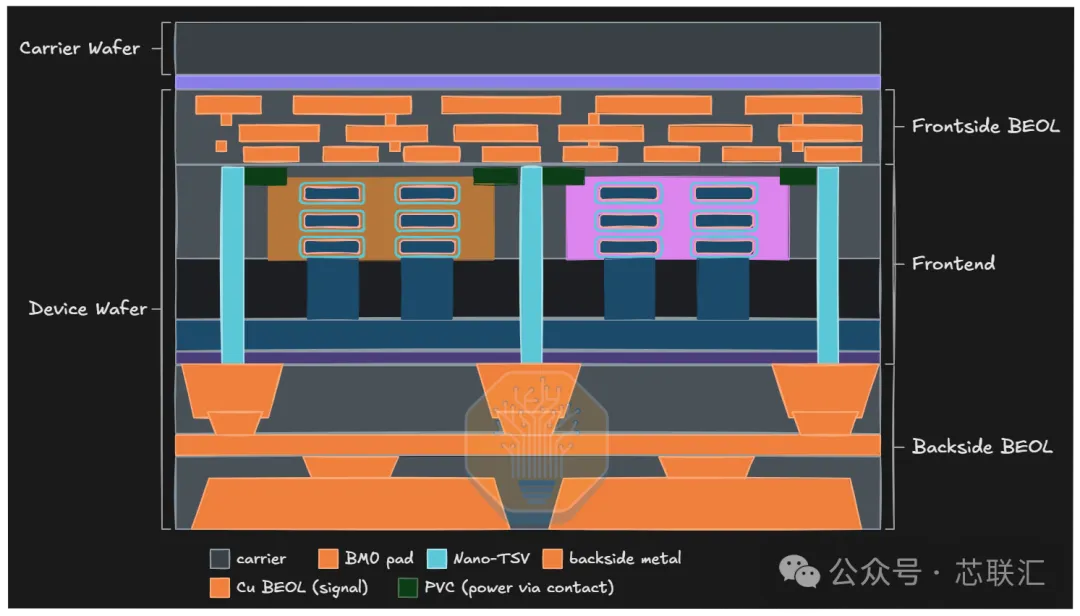
傳統晶片的電源和訊號都需要從晶圓正面金屬層布線,隨著電晶體越來越密集,電源線和訊號線會爭奪有限的布線資源。Intel 18A 則把主要供電網路轉移到晶圓背面:正面主要承擔訊號互連,背面負責電源輸送,再通過 nano-TSV 將電力直接送到電晶體附近。
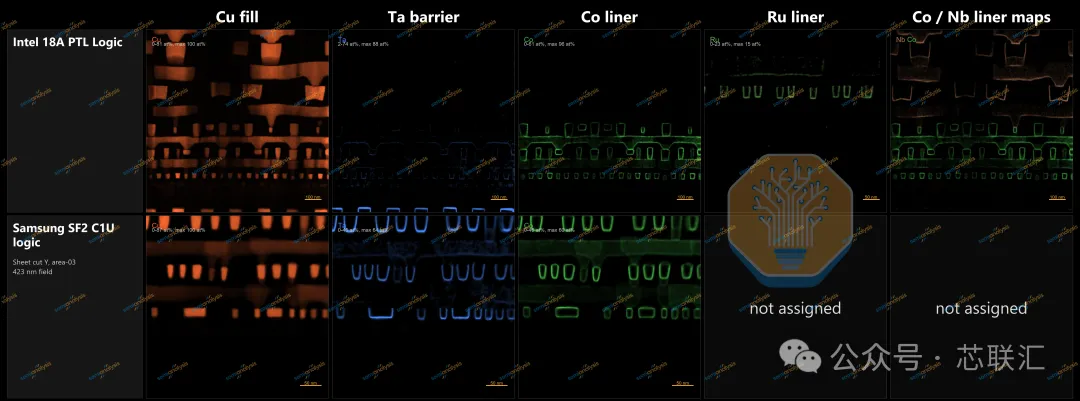
這樣做帶來的價值並不只是“換一個地方布電源線”,而是可以釋放正面金屬層布線資源、縮短供電路徑、降低電阻壓降,同時讓標準單元進一步壓縮。報告還詳細分析了 BM0-BM5 背面金屬層,以及 nano-TSV、Mo/W等材料體系,說明 PowerVia 已經不是實驗室概念,而是真正進入量產晶片的完整製造體系。
四、RibbonFET意味著Intel正式完成FinFET→GAA的電晶體架構切換
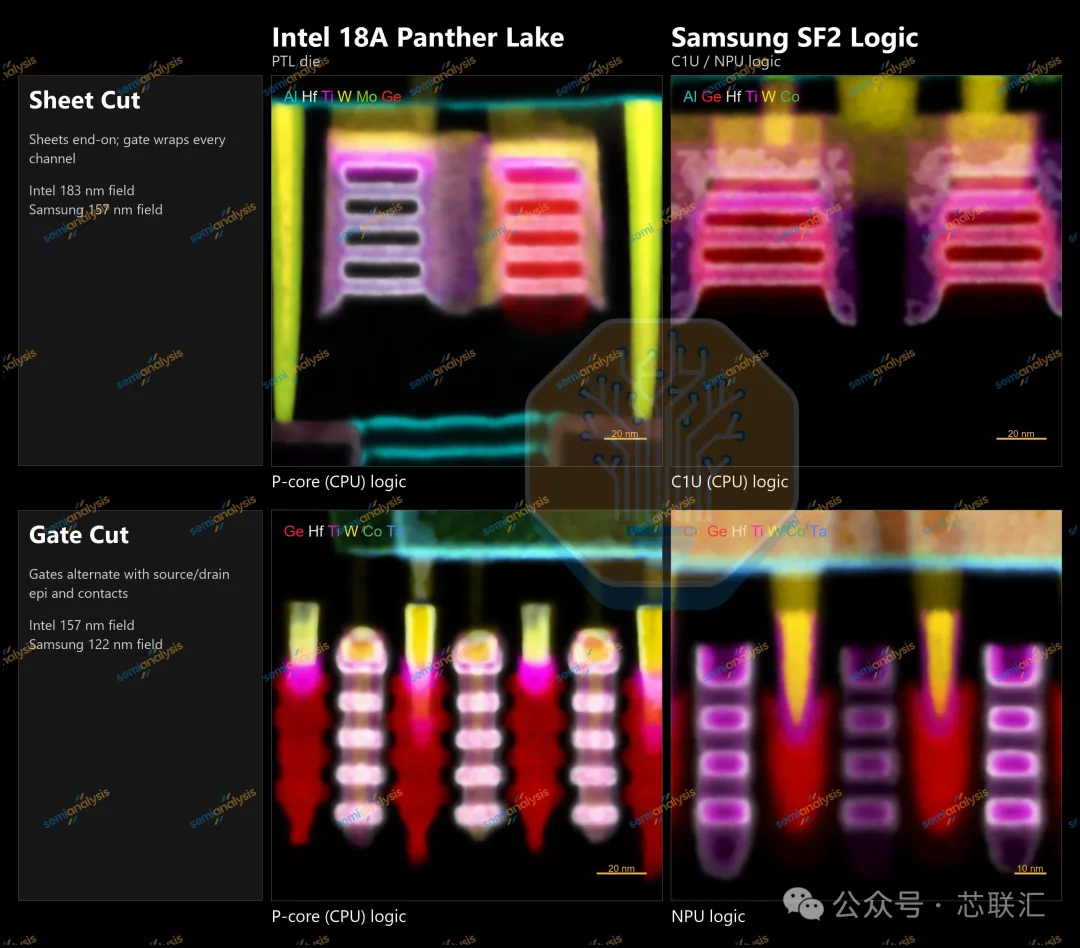
Intel 18A 的另一個核心是 RibbonFET。它本質上屬於 GAAFET(Gate-All-Around FET),通過多層水平奈米片構成溝道,使柵極可以從四周包圍溝道,相比 FinFET 能夠獲得更強的靜電控制能力。
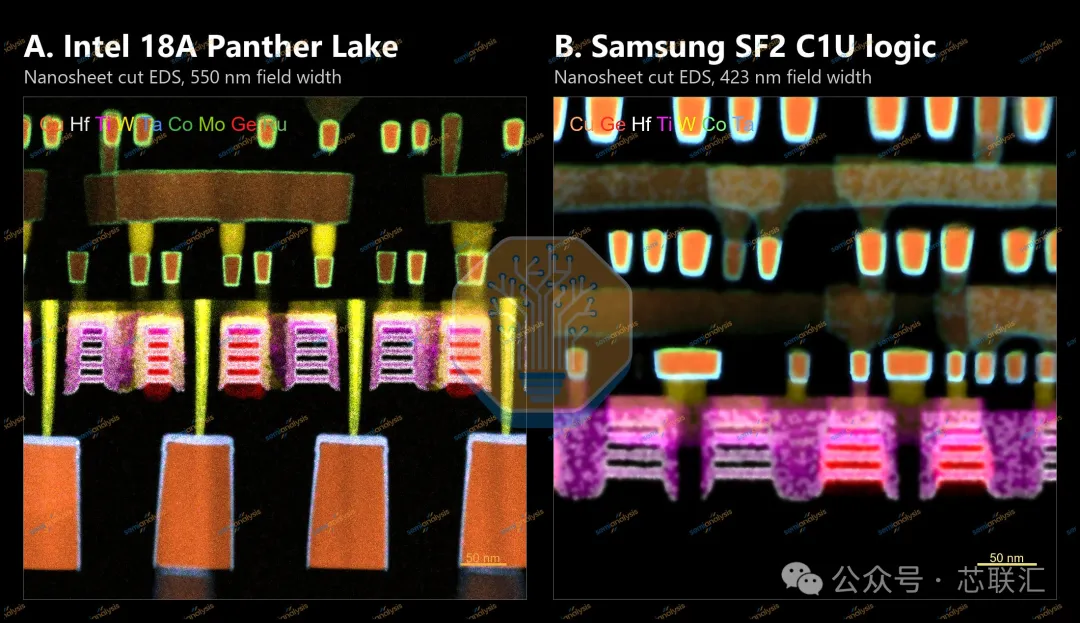
拆解顯示,Intel 18A RibbonFET採用四層奈米片結構,而報告拿三星 SF2 的 MBCFET 與其進行了直接比較。三星採用三層 nanosheet,而 Intel 使用四層 ribbon。這裡不能簡單理解成“四層一定比三層先進”,因為奈米片的寬度、厚度、溝道面積、應變工程以及閾值電壓設計都會影響最終性能。
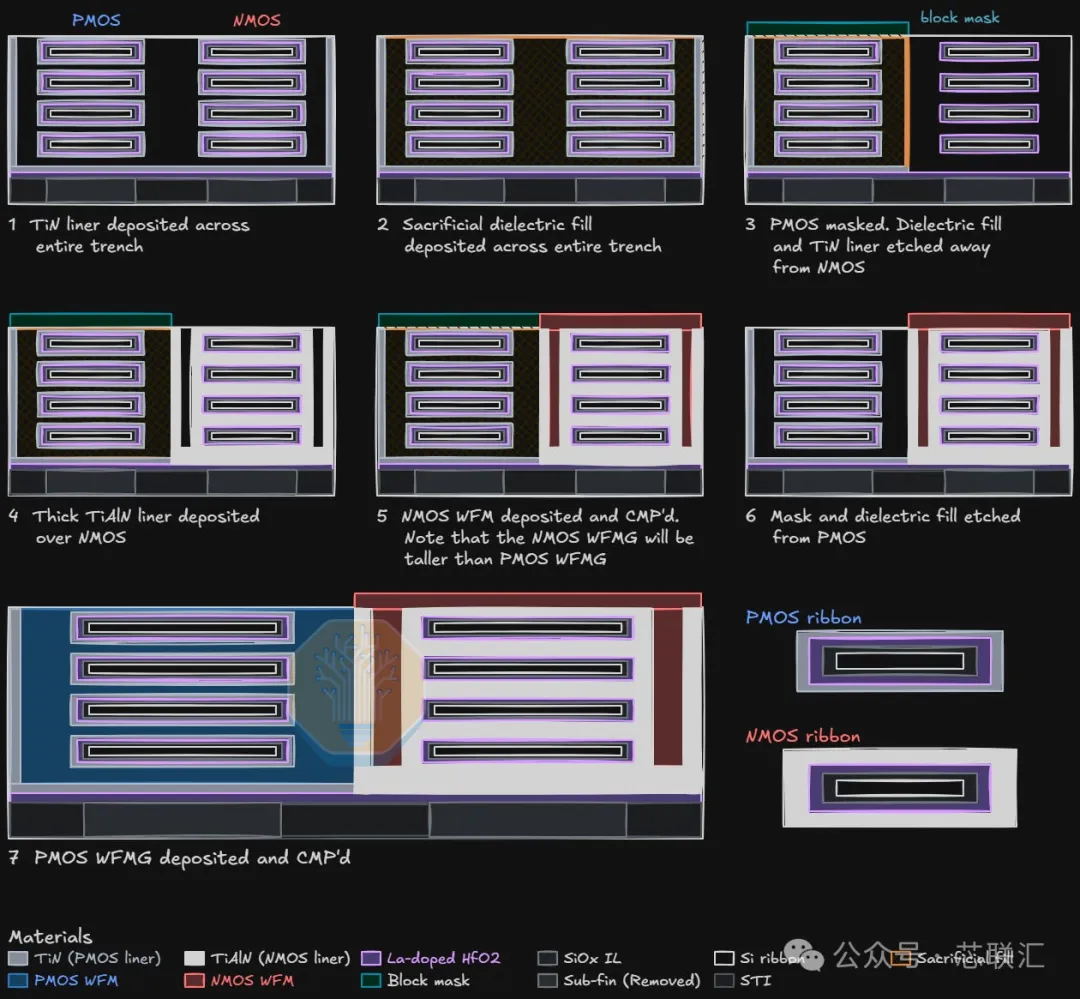
更重要的是,RibbonFET讓Intel能夠通過調整奈米片寬度來改變電晶體驅動能力,而不像FinFET那樣只能以增加或減少整個Fin的方式進行較粗粒度的調整。這對於邏輯單元和SRAM設計尤其重要,可以在性能、功耗、面積和穩定性之間進行更加細粒度的最佳化。
五、18A並沒有在所有維度“碾壓”TSMC,但PowerVia改變了密度最佳化方式
這是報告裡非常值得注意的一點,並沒有簡單得出“Intel 18A全面領先TSMC N3E”的結論。
實際測量顯示,在代表性邏輯單元中,Intel 18A與TSMC N3E GPU邏輯的Gate Pitch非常接近。報告甚至指出,兩者代表性模型中的柵極間距基本相同,因此真正造成邏輯密度差異的重要因素之一是標準單元高度,而不是單純Gate Pitch。
Intel 18A 的優勢在於 PowerVia 把電源軌移到背面之後,可以使用更緊湊的標準單元高度,同時給M0等局部互連保留更大的幾何空間。也就是說,Intel沒有單純追求“所有線都做得更細”,而是通過電晶體架構+背面供電+互連設計協同最佳化獲得面積和性能收益。
這反映出先進製程競爭正在發生一個非常重要的變化:節點競爭已經從單純的電晶體尺寸縮放,轉向電晶體、互連、供電和設計技術協同最佳化。
六、Panther Lake證明“先進節點”越來越不是一顆晶片全部使用同一種工藝
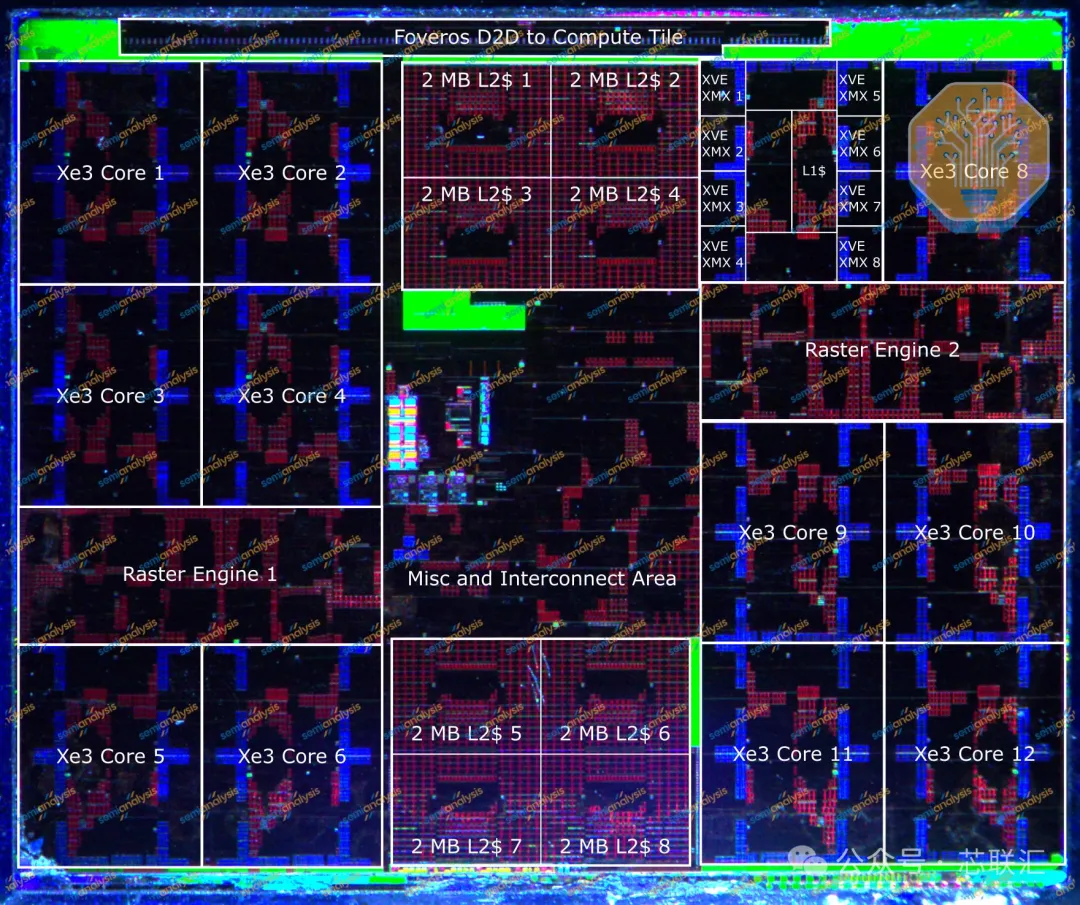
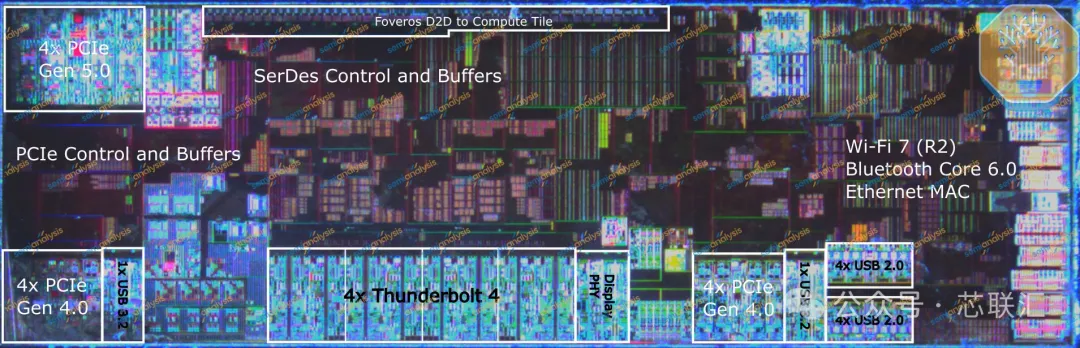
報告後半部分從晶片平面圖進一步拆解了 Panther Lake 的 CPU、NPU、GPU 和 I/O。
Compute Tile 內部包含 P-core、LP E-core、NPU、DDR PHY、媒體引擎等模組,其中CPU核心採用18A;GPU則出現非常有意思的雙工藝路線:較小GT1 GPU採用Intel 3,而更大的GT2 GPU採用TSMC N3E。報告借此直接比較了不同節點下Xe3 GPU的面積、快取和邏輯佈局。
I/O部分則繼續使用 TSMC N6。這種設計說明 Intel 已經不再追求“所有模組全部放在最新工藝”,而是根據不同模組的性能、成本、面積和模擬特性選擇節點。尤其I/O、PHY等電路,本身並不一定能從最先進節點獲得與數字邏輯同等程度的收益。
因此 Panther Lake 更像是一個多節點異構SoC平台:18A負責最需要性能和能效的CPU計算部分,Intel 3/N3E負責GPU,N6負責I/O,再由封裝技術完成系統整合。
七、Foveros-S把Intel的“製程優勢”進一步擴展到系統級整合
最後一個重要主題就是 Foveros-S先進封裝。
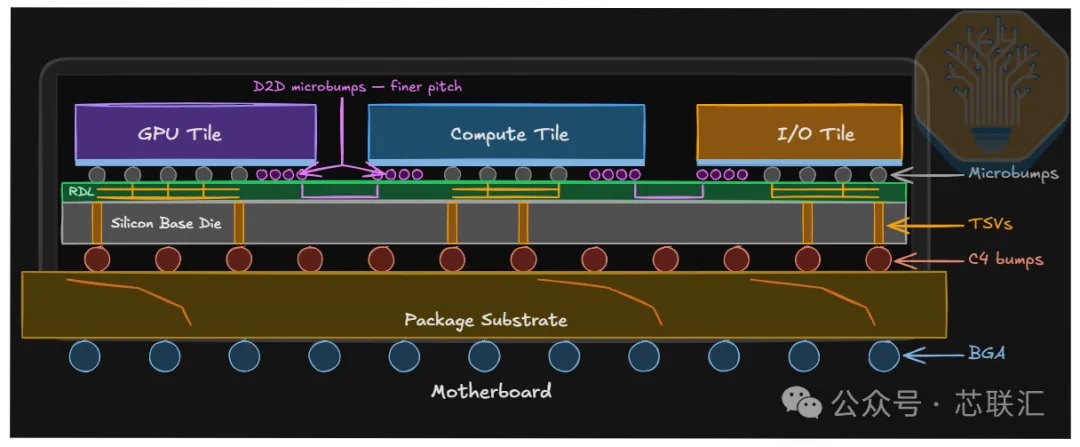
Panther Lake 將 Compute Tile、GPU Tile 和 I/O Tile 分開製造,再安裝在一個被動矽基底(passive silicon base)上,通過微凸點和TSV實現互連。報告實際測得局部 microbump 間距約 25.24 μm,說明 Intel 已經把較高密度的die-to-die互連真正用於消費級處理器。
這種架構的意義非常大:未來Intel不需要讓一顆超大SoC全部承擔先進節點的成本和良率風險,而可以把最先進節點集中在真正需要它的模組上。更小的die也意味著缺陷導致整顆晶片報廢的機率下降,同時不同模組可以獨立迭代。
因此 Panther Lake 展現的並不是簡單的“18A CPU”,而是一套完整的平台:RibbonFET解決電晶體繼續縮放的問題,PowerVia解決供電與布線問題,Chiplet解決不同模組工藝選擇問題,Foveros-S解決不同芯粒之間的高速互連與系統整合問題。
小編總結
Panther Lake真正重要的不是一次普通CPU升級,而是Intel首次把RibbonFET、PowerVia、18A先進製程與Foveros-S Chiplet封裝完整組合進商業消費級晶片,標誌著Intel的競爭方式正在從單純追趕電晶體製程,轉向“電晶體+背面供電+互連+Chiplet+先進封裝”的系統級技術競爭。(芯聯匯)