
測算方法
極限實測 Anthropic、OpenAI、Meta、SpaceXAI、MiniMax、月之暗面(Moonshot)、智譜、Cursor 以及 Cognition 的各項 AI 訂閱方案
Max Kan 與 Dylan Patel 著。訂閱方案目前仍是消費者和小企業為 AI 付費的主要方式。儘管正如我們此前在6月所解釋的那樣,這些方案享受著高額補貼,但作為強大的獲客與行銷工具,它們在經濟層面依然合理。例如,OpenAI 慷慨的額度重設機制所建立的使用者好感,促成了近期 Codex 採用率的激增,並迫使 Anthropic 多次撤回原定的訂閱額度削減計畫,以避免在輿論層面遭受重創。
此外,由於訂閱方案享有極高的補貼,即便它們在總營收中僅佔較小比例,也會對利潤率以及每兆瓦(MW)營收產生顯著影響。以 Anthropic 的大致資料為例。
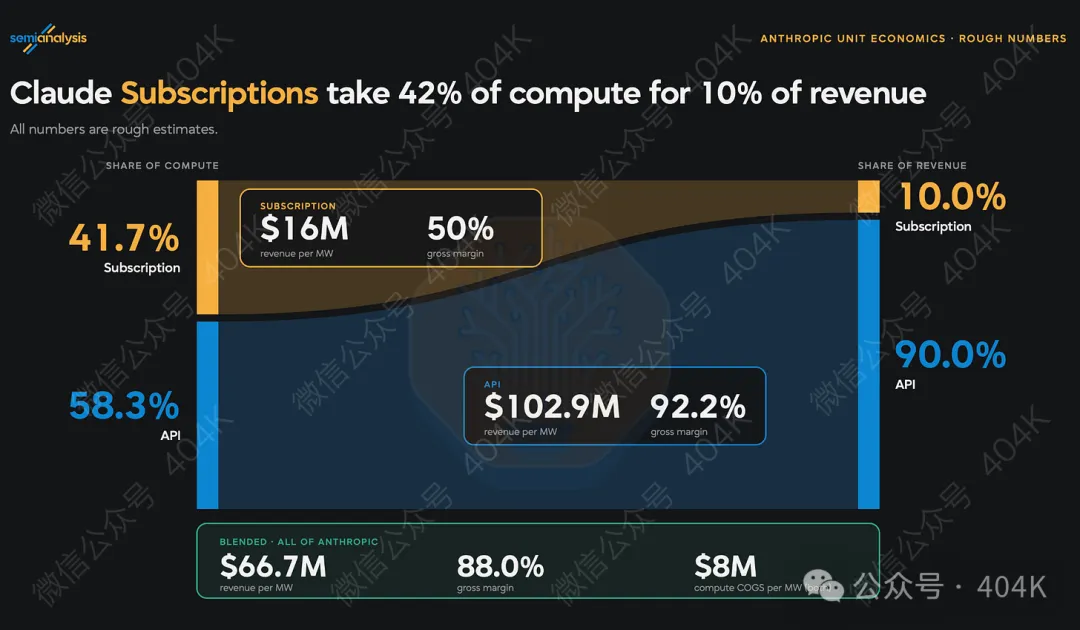
訂閱收入雖僅佔其總營收的 10%,卻可能消耗超過 40% 的推理算力,並將每兆瓦綜合營收拉低約 3600萬美元。對 OpenAI 而言,訂閱方案的重要性更為突出,因為訂閱在其總營收中佔據了更高的份額。
換言之,若想精確建模頭部 AI 實驗室的財務狀況,就必須深入理解其訂閱限額機制。
那麼,限額機制究竟是如何運作的?理解訂閱方案的方式在於:使用者每月支付的費用會換取一定數量的“額度積分(credits)”。每個“模型與 Token 類型”組合消耗的額度積分各不相同。由於額度積分消耗比例與 API 價格比例可能存在巨大差異,同一方案的“實際價值”會根據所運行的模型及工作負載類型發生變化。換言之,孤立地斷言某個方案價值多少美元毫無意義,必須結合“方案、模型、工作負載”這一完整三元組來綜合評估。
以下是每月 200 美元的 Claude 方案在不同模型與工作負載下的等效 API 價值變化情況。
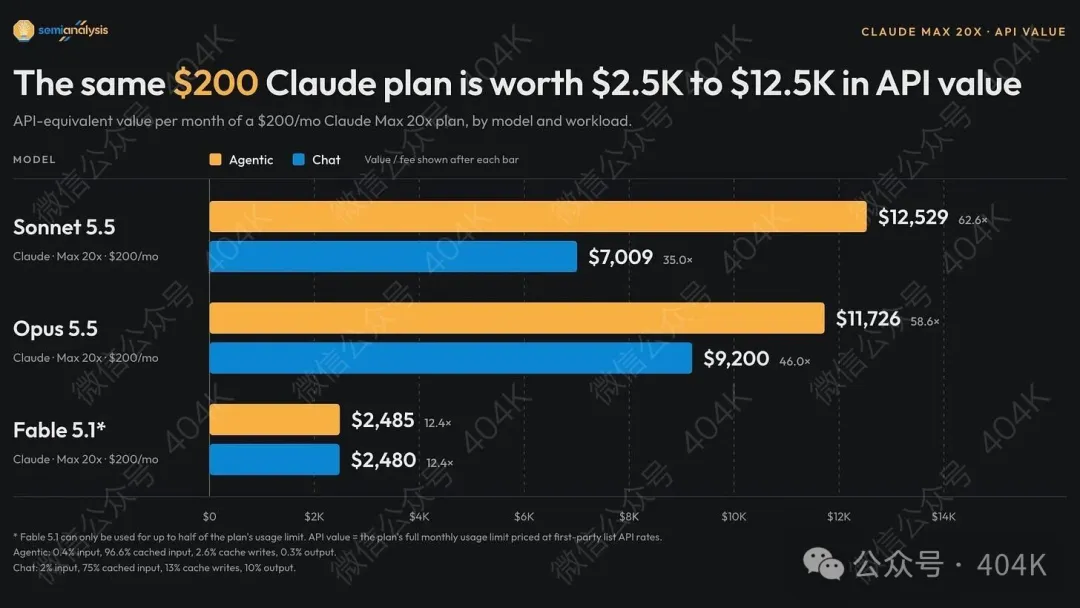
單一時點的靜態截面資料同樣不夠。各大實驗室經常隨促銷活動和新模型發佈而公開調整限額,還可以隨時通過微調額度積分消耗成本來悄然改變限額。最理想的方式是每天重新核驗每個“方案、模型、Token 類型”的消耗成本,以便即時發現任何變化。
這正是 SemiAnalysis 全新訂閱儀表板所做的工作。除 OpenAI 和 Anthropic 的所有訂閱方案外,我們還追蹤 Meta、SpaceXAI、Cursor、Cognition、智譜、MiniMax 和月之暗面(Moonshot)。
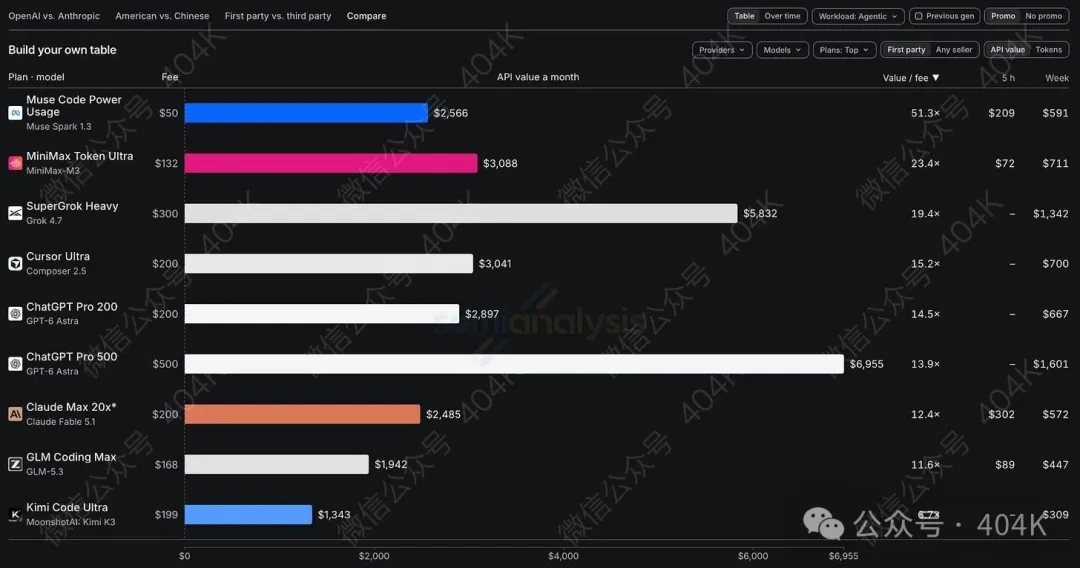
隨著新廠商、新方案和新模型的推出,儀表板將第一時間予以收錄。本文其餘部分將對各廠商當前的限額情況進行全面概述。除非另有說明,下文涉及的所有 Token 數量與金額均基於智能體(agentic)使用場景測算。
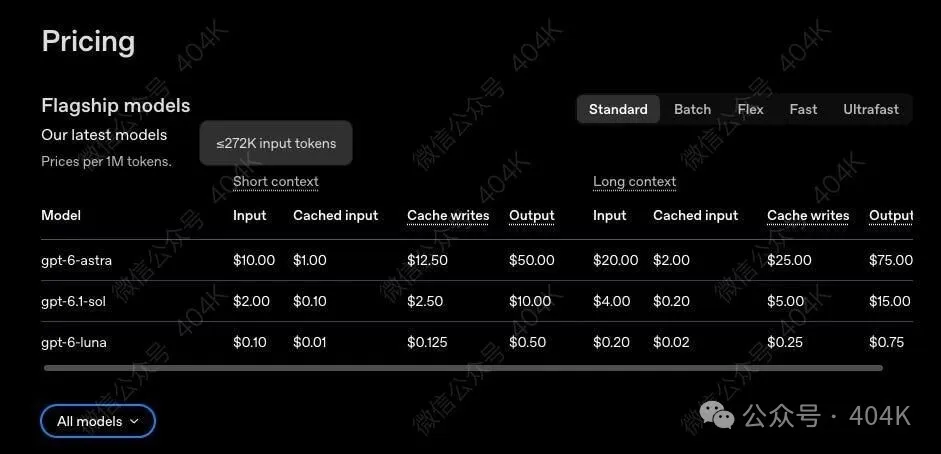
Token 通常按每百萬 Token(MTok)計價,主要分為以下幾種類型:
1.輸入(Input):加入到大語言模型上下文窗口且未被快取的新 Token。
2.快取寫入(Cache write):在多輪對話中被快取的輸入 Token,通常比常規輸入 Token 略貴。
3.快取讀取(Cache read):對話中已在前序輪次被快取的 Token,相較於未快取的 Token 通常極為廉價。
4.輸出(Output):由模型生成的 Token,屬於價格最高昂的 Token 類型。
此外,部分模型對於超出特定上下文窗口長度的 Token 會收取更高費用。這些模型通常會在達到昂貴的上下文長度閾值之前進行壓縮,因此我們的測算也保持在該閾值以下。
訂閱方案並不會公開這種精細化的計價細節。相反,它們通常只在 5 小時和 7 天的時間窗口內提供一個 0% 至 100% 的簡易用量計量表,有時還會為 Fable 等特定模型單獨設定計量表。不同訂閱層級僅通過相對於該廠商自身其他方案的用量倍數來進行區分。例如,OpenAI 過去曾在其 20 美元的 Plus 方案中宣傳“擴展 Codex 用量”,在 100 美元的 Pro 方案中宣傳“用量為 Plus 的 5 倍”,在 200 美元的 Pro 方案中宣傳“用量為 Plus 的 20 倍”,直到他們將 200 美元方案的用量削減一半,並從定價頁面上移除了所有相對用量表述。
實驗設定
我們通過逐一隔離測試單一 Token 類型並觀察模型廠商用量計量表變動幅度的方式,測算出每個“方案、模型、Token 類型”三元組的訂閱消耗速率。單次實驗包含多次重複呼叫,使用特定提示詞在最大化某一種 Token 類型的同時將其他類型最小化。
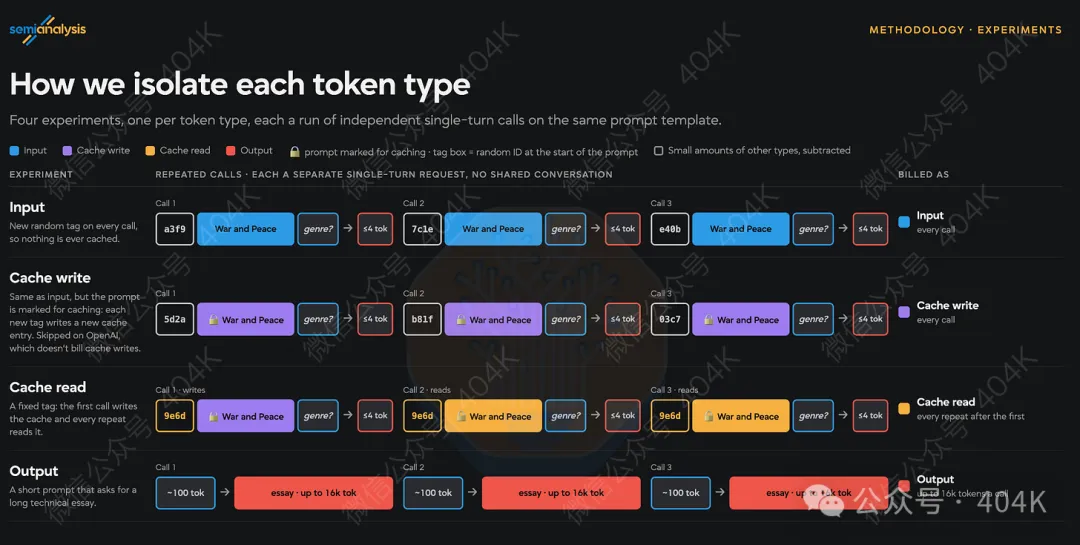
輸入、快取寫入和快取讀取共享相同的提示詞範本。由於部分模型在面對大段亂碼時會拒絕響應,我們擷取了《戰爭與和平》的部分文字作為測試內容。對於輸入 Token 實驗,我們在每次呼叫時附加一個隨機標籤,以確保不會觸發快取;快取寫入實驗採用相同方式,但將提示詞標記為快取,從而使每個新標籤都強制生成一個新的快取條目;快取讀取實驗則使用固定標籤,首輪呼叫寫入快取,隨後的所有重複呼叫均讀取該快取。
對於輸出 Token 實驗,我們使用了一篇技術短文來引導模型生成長文字輸出,因為模型通常會拒絕“重複 SemiAnalysis 10 萬次”這類機械式提示詞。
結果測算
在每次呼叫中,我們記錄兩項資料:廠商計費的各類 Token 數量,以及用量計量表的讀數。將這些資料轉化為等效價格需要經過以下三個步驟。
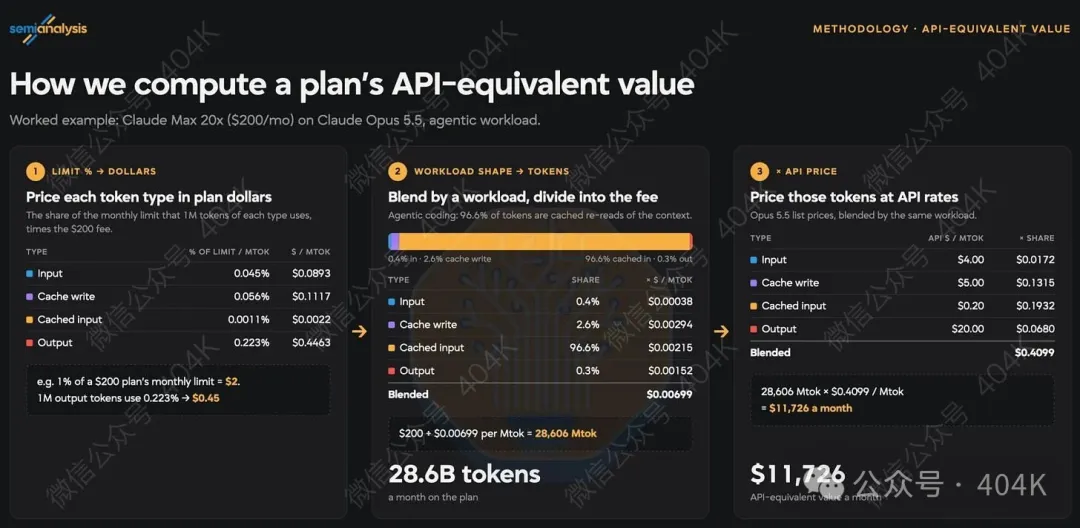
1. 測算各 Token 類型的消耗速率
廠商通常以固定步長變動的計量表來呈現用量,例如一個完整的百分點、一個額度積分或一分錢等。單次請求往往根本不會引起計量表變動,因此無法直接測算單個請求的成本。
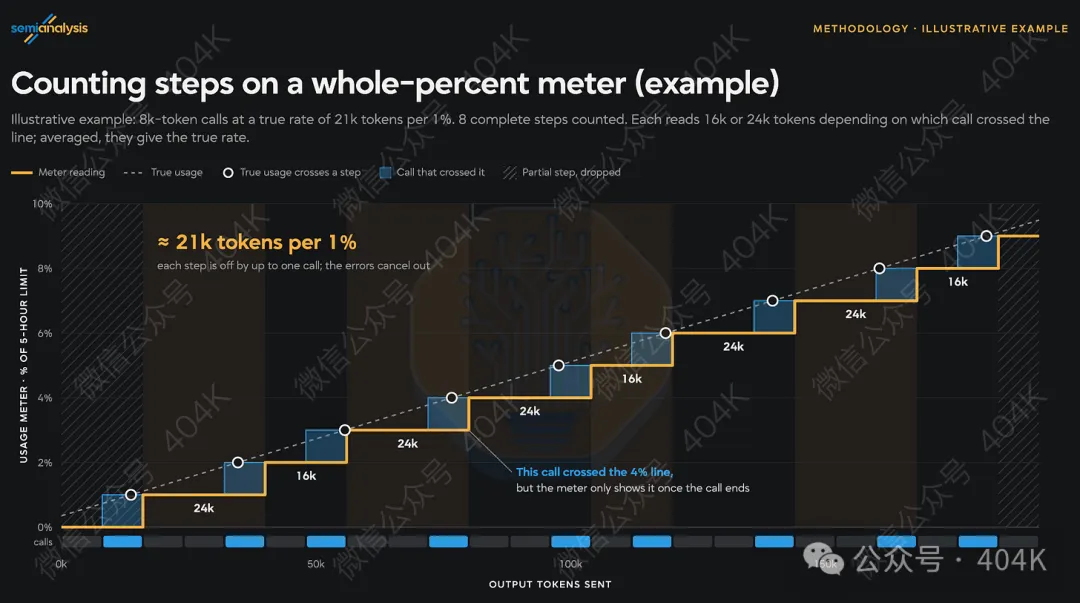
為此,我們採用步進法進行測量。隨著請求的持續運行,我們累計記錄消耗的 Token 總量;每次計量表讀數上升時,便記錄下當前的累計值。兩次計量表變動之間所消耗的 Token 數量即構成一個“步長(step)”,代表計量表移動一個單位所需的 Token 成本。
我們會剔除兩個不完整的步長:在測試剛開始時,計量表往往已處於通往下一個變動點的中間狀態,因此首次變動前消耗的 Token 少於一個完整步長,若計入會導致測得的消耗速率偏高;而在最後一次變動之後消耗的 Token 尚未走完一個完整步長,因此同樣予以剔除。
為了得出精準的速率,我們將所有完整步長內計量表的累計變動幅度相加,除以期間消耗的 Token 總量。由於廠商對輸入、輸出和快取 Token 的收費標準各不相同,我們針對每種類型分別計算速率。
注意事項:
1.由於我們每次請求只能讀取一次計量表,單個步長可能存在最多相當於單次請求的誤差。這種誤差不會隨連續步長的增加而累積,因此我們追蹤的是一個區間而非單一數值;計入的步長越多,該區間就越窄。我們持續增加步長,直至誤差區間縮小至 ±5% 以內,隨後報告所有步長的綜合速率。
2.沒有任何單次請求只包含單一類型的 Token。例如,部分方案在每次請求中都會強制附帶一組系統指令,我們會利用已測得的其他類型價格扣除該額外開銷。
3.在部分方案中,快取讀取幾乎不產生成本,甚至可能完全不推動計量表變動。如果在消耗 5億個快取讀取 Token 後計量表仍無變動,我們即推定快取讀取完全免費。
2. 將速率換算為各時間窗口及每月的 Token 容量
我們在每次請求後讀取方案所展示的所有計量表。這可能包含 5 小時限額、周度限額,以及針對 Fable 等模型的專屬周度限額。因此,每種 Token 類型在每個計量表上都會對應一個消耗比例,即每百萬 Token 佔用該限額的百分比。根據這一比例,我們即可推算出總容量,例如若 100 萬 Token 消耗 5% 的限額,則該限額總量即為 2000 萬 Token。
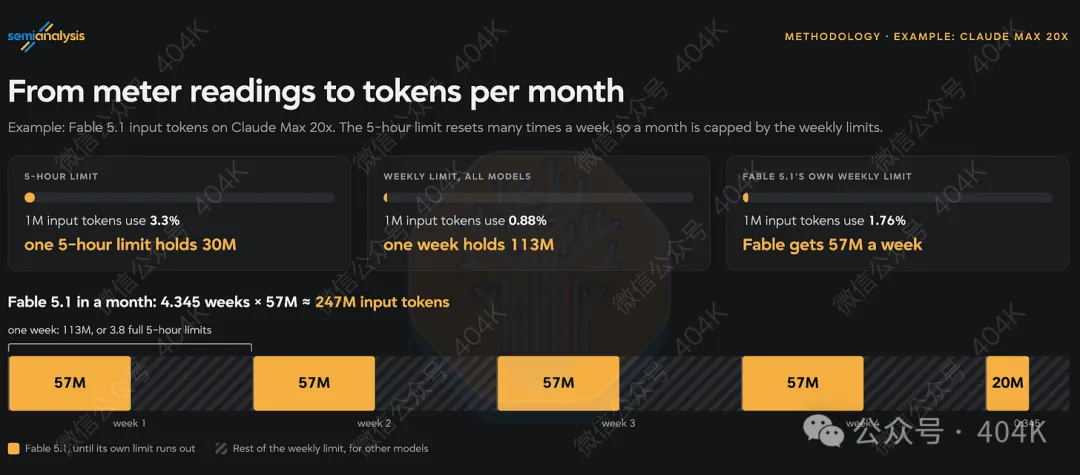
5 小時限額在單周內會多次重設,因此月度總上限實際上受制於周度限額。
3. 等效定價測算
最後,我們通過將每百萬各類 Token 消耗的限額百分比轉化為金額,來計算等效 API 價值。例如,若消耗了 200 美元月度方案中 1% 的限額,即相當於 2 美元。
隨後,我們設定具體的工作負載構成比例,並據此測算各方案在相應比例下所能提供的 Token 總量。對於智能體工作負載,我們採用了 9 月在 Tokenomics 模型中披露的自身實際使用比例。
最終,將 Token 總量乘以按 API 價格計算的每百萬 Token 綜合價格,得出等效 API 價值。
捕捉廠商的 A/B 測試
在完善測算方法的過程中,我們曾遇到一個令人困惑的情況:在針對某廠商同一訂閱方案測試的 3 個帳號中,恰好有 1 個帳號的限額比另外 2 個低了約 20%。這個“運氣不佳”的帳號恰好註冊時間明顯更早,我們一度擔心該廠商存在某種根據帳號註冊時長調整訂閱限額的機制。
幸運的是,在與該廠商溝通後,我們確認事實並非如此,該帳號只是被捲入了他們正在針對限額進行的“規模極小”的 A/B 測試中。此外,該廠商特別強調他們“並非直接一刀切地調降限額”,而是在測試“如何更好地平衡使用者觸及限額時的體驗”。
這一結論具有兩層重要意義:
1.它證實了廠商可以隨時暗中調整訂閱限額;
2.我們的測算方法具備足夠的靈敏度,能夠精準捕捉到這些微小變動!
OpenAI 對比 Anthropic
AI 訂閱領域最受關注的核心問題,在於 Anthropic 的限額與 OpenAI 相比究竟如何。需要注意的是,OpenAI 上周對其訂閱體系進行了大幅調整,將 200 美元方案的等效 API 價值直接減半,並推出了全新的 500 美元檔位。以下資料呈現了 OpenAI 與 Anthropic 當前的對比現狀。隨後,我們將對 OpenAI 近期的調整展開深入剖析。
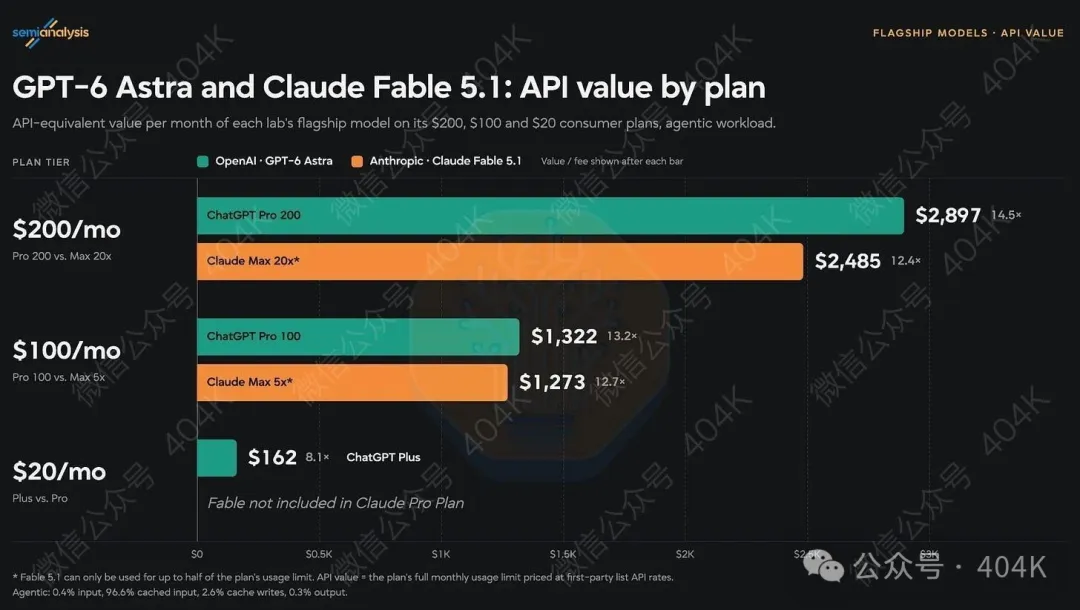
在 GPT-6 Astra 與 Fable 5.1 的對比中,兩者的限額整體上十分接近,但需注意 Fable 最多隻能佔用總限額的 50%。換句話說,在 Anthropic 的 200 美元方案中消耗價值 2485 美元的 Fable 5.1 之後,使用者仍剩餘 50% 的額度;而 OpenAI 的同檔位方案在消耗 2897 美元的 Astra 後就會徹底耗盡。
當我們進一步對比 Opus 5.5 與 GPT 6.1 Sol 時,這剩餘的 50% 額度就變得極為關鍵。
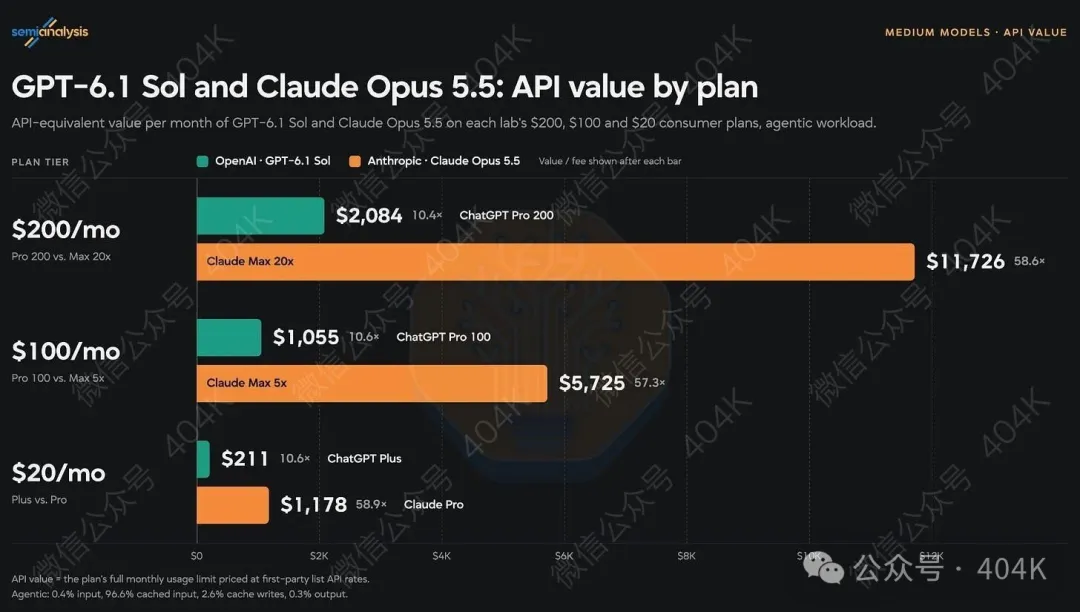
在這一中端主力模型層級(兩家公司均將其定位為面向多數使用者的日常主力模型),Anthropic 展現出壓倒性的性價比優勢,其等效 API 價值全面達到 OpenAI 的約 5 倍。有人可能會辯稱這對 OpenAI 不公平,因為 6.1 Sol 的單 Token API 價格遠低於 Opus 5.5;但即便直接對比可呼叫的 Token 絕對數量,兩者之間的差距依然巨大。
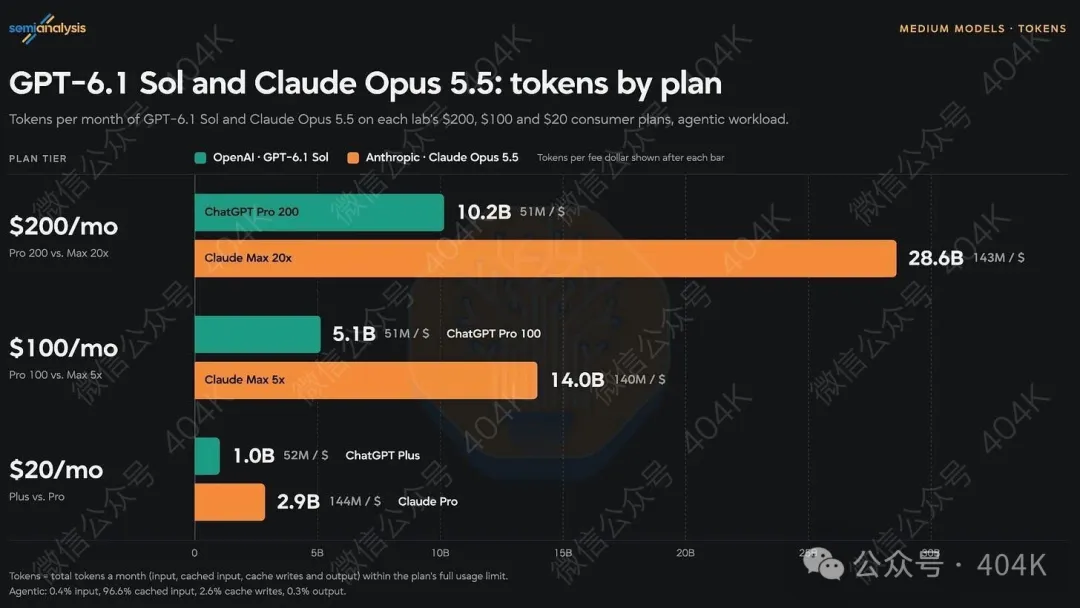
總體而言,我們認為等效 API 價值是衡量訂閱方案“實際價值”的最佳單一指標,但在某些情況下,原始 Token 數量可能更為適用。例如,如果某個模型在 API 定價上性價比極低(或極高),那麼等效 API 價值難免會產生誤導。
OpenAI 全新 500 美元方案與大幅削減限額
我們的追蹤監測證實了 Tibo 所披露的 OpenAI 200 美元方案價值遭腰斬的情況。在削減前購買的 200 美元方案可在 10 月 29 日之前繼續享受原有的較高限額,但新購買的方案將立即執行下調後的低限額。
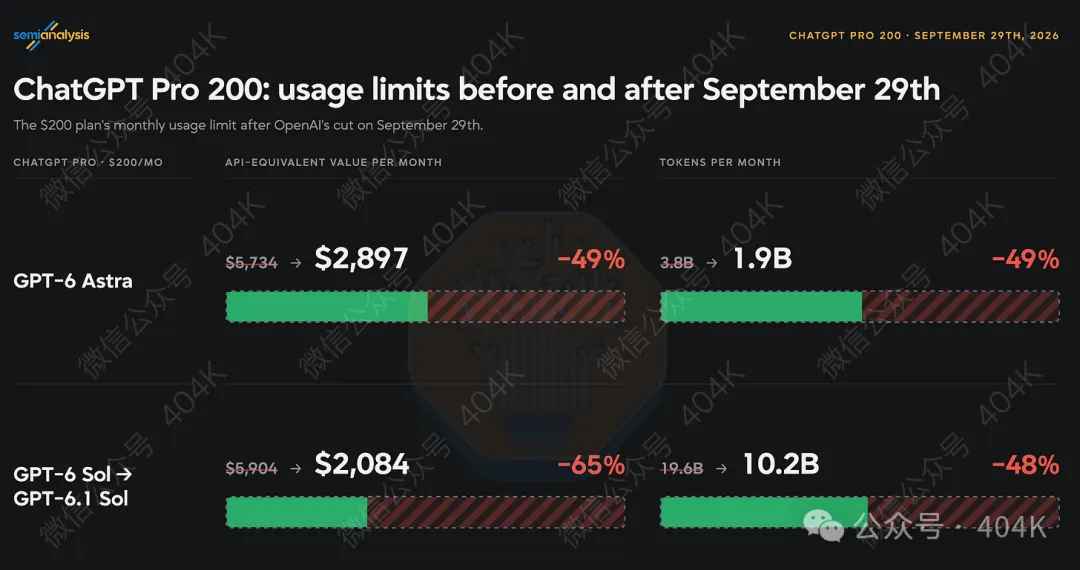
可以看到,OpenAI 明確將各模型層級所能獲取的 Token 數量砍半。這導致 Sol 等級模型的等效 API 價值降幅超過 50%,因為 OpenAI 同時下調了 6.1 Sol 的快取輸入 Token 定價。
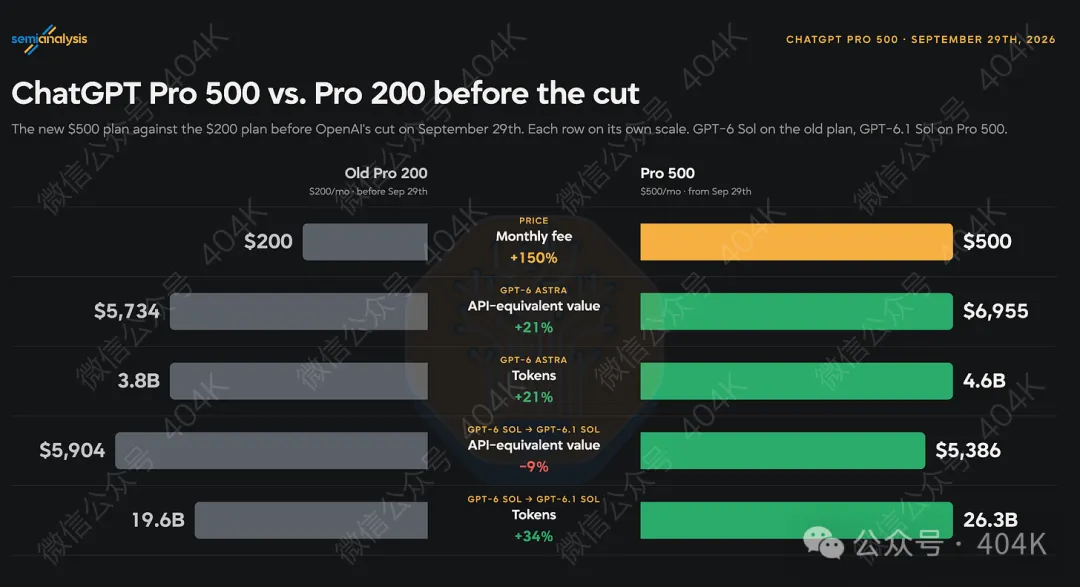
全新的 500 美元方案所提供的 Astra 用量僅比原先的 200 美元方案多出 21%。有趣的是,由於前述 6.1 Sol 降價的影響,Sol 等級模型的等效 API 價值反而有所下降。
同時,我們也在積極測試在 Devin 等第三方應用中使用 ChatGPT 訂閱時的限額表現。
此外,過去每月 200 美元的方案享受的補貼力度顯著高於 OpenAI 的其他訂閱層級。如果我們將每個“方案、模型”組合歸一化為每美元等效 API 價值和每美元 Token 數量,可以發現:在 Astra 模型上,100 美元的 Pro 方案每美元價值約為 Plus 方案的 2 倍;而在所有模型上,200 美元的 Pro 方案每美元價值又在 100 美元 Pro 方案的基礎上再高出約 2 倍。
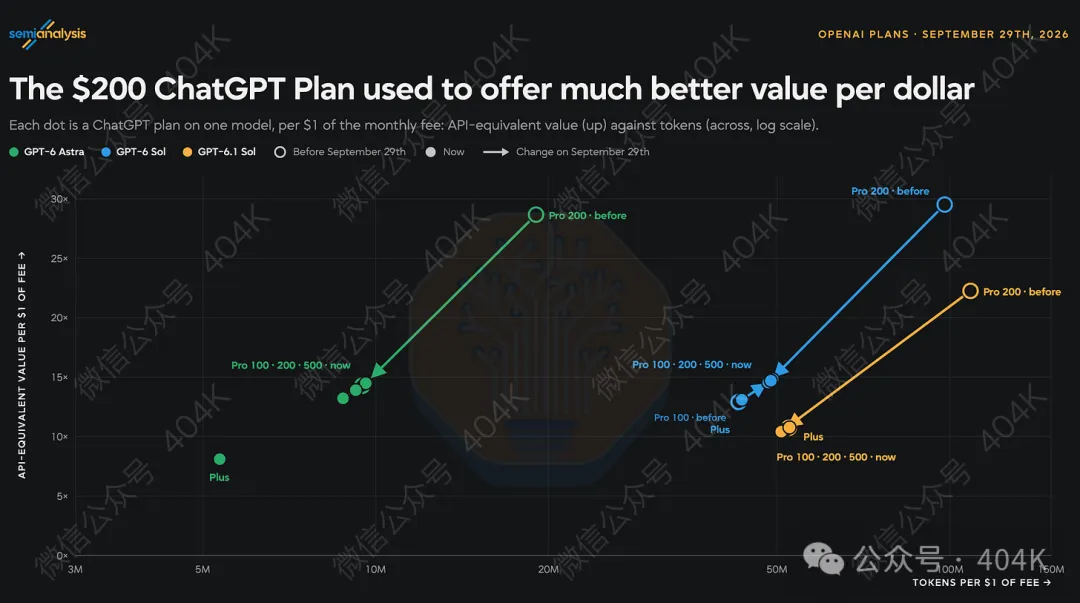
經過上周的削減後,100 美元、200 美元與 500 美元的 Pro 方案在每個模型上提供的每美元 Token 數量已完全一致。Plus 方案在 Sol 模型上的性價比與它們相當,但在 Astra 模型上的性價比相對更低。
相比之下,Anthropic 原先在所有訂閱層級上就已經保持了相同的每美元價值,目前在性價比上對 OpenAI 形成了全面壓制。
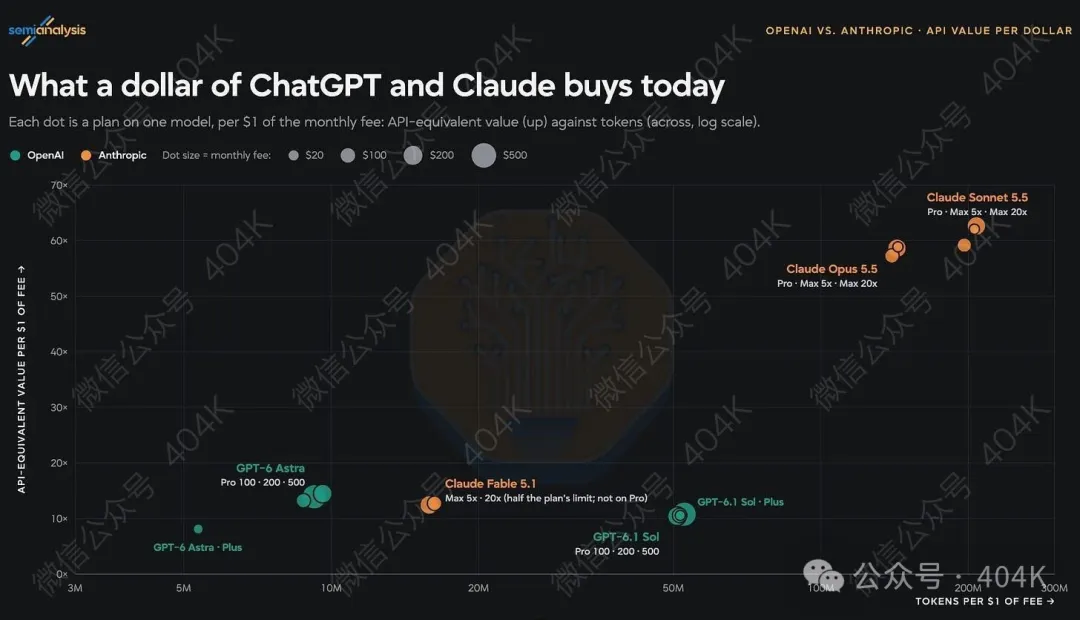
過去,OpenAI 曾因相較於 Anthropic 更為慷慨的訂閱限額而廣受獨立開發者讚譽,但如今這一局面已徹底逆轉。在任何 Claude 訂閱方案中運行 Opus 5.5,其性價比都遠超 OpenAI 的任何產品。
唯一有利於 OpenAI 的抗辯在於:其所有 Pro 方案均未設定 5 小時限額,這使得使用者更容易消耗掉月度總限額中更高比例的額度。然而,我們認為這根本無法彌補 Claude 方案中 Opus 5.5 所提供的約 4 倍等效 API 價值優勢。
實驗室是否會根據 API 降價相應調整訂閱限額?
近期,Anthropic 與 OpenAI 旗下模型經歷了一系列大幅降價:
1.Fable 5.1 的快取讀取價格較 Fable 5 下調了 75%;
2.Opus 5.5 的輸入和輸出 Token 價格較 Opus 5 下調了 20%,快取讀取價格下調了 60%;
3.GPT 6.1 Sol 的快取讀取價格較 GPT 6 Sol 下調了 50%,而此前 GPT 6 Sol 的價格已比 5.6 Sol 便宜了 60% 至 67%。
一個關鍵問題在於:各實驗室在 API 降價後是否會同步上調 Token 限額,以維持訂閱方案的等效 API 價值不變?
我們前文已展示過,OpenAI 在發佈 6.1 Sol 時並未調整每月 200 美元方案中的 Sol Token 限額,導致其等效 API 價值縮水約 30%。
Anthropic 在推出 5.1 時同樣完全沒有上調 Fable 的 Token 限額,但隨著 5.5 降價,他們確實提高了 Opus 的 Token 限額。
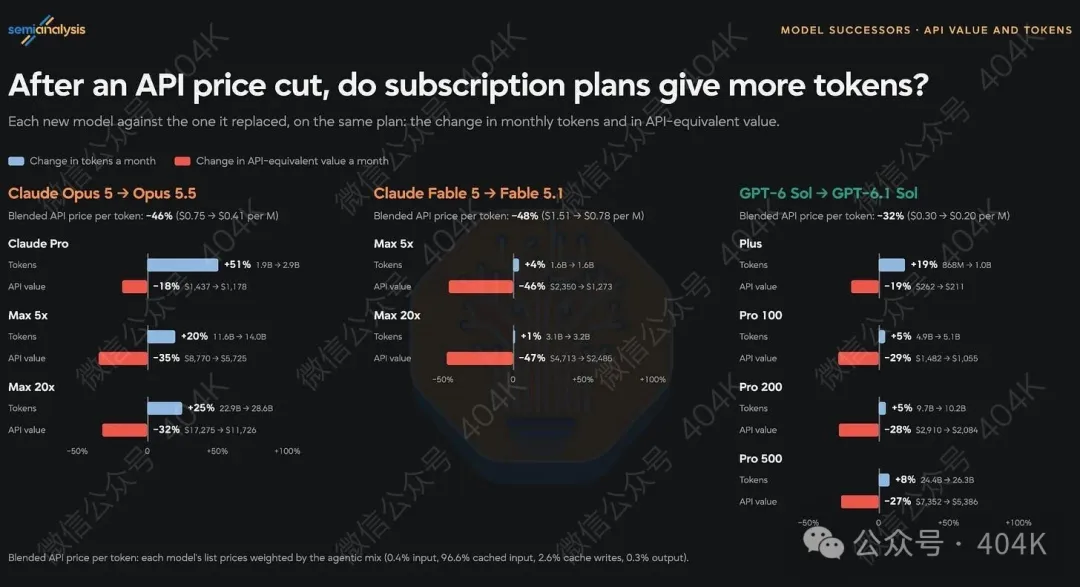
然而,Max 方案約 20% 的 Token 上調幅度以及 Pro 方案約 50% 的上調幅度,均不足以完全抵消 API 降價帶來的等效價值稀釋。
提高訂閱利潤率的兩種不同路徑
正如我們在本文開頭所述,訂閱業務的毛利率遠低於 API 業務,並顯著拉低了 OpenAI 與 Anthropic 兩家公司的每兆瓦(MW)營收。兩家公司對此心知肚明,但為削減對訂閱使用者的補貼,它們選擇了截然不同的策略。
在特定方案下,Anthropic 會對更高階的模型調低等效 API 價值。Sonnet 5.5 與 Opus 5.5 之間的降幅尚屬溫和,但在 Fable 5.1 上降幅變得極其顯著。
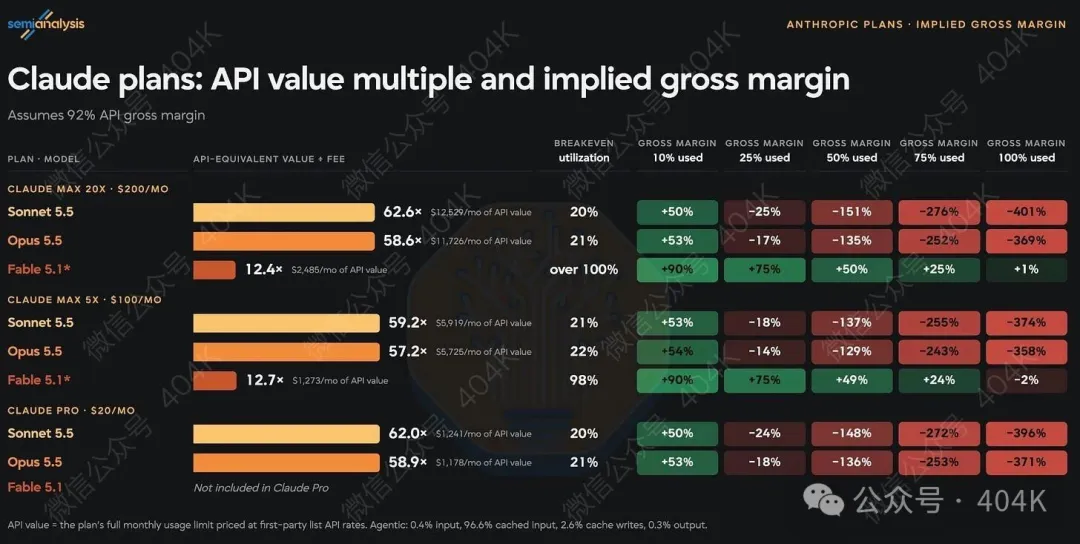
隨著性能更強、掛牌價更高的模型推出,逐步調降等效 API 價值是一種更為隱蔽的削減訂閱補貼方式。假設使用者使用率為 100%、API 毛利率為 92%,頂格用滿 Opus 5.5 與用滿 Fable 5.1 所對應的毛利率分別為 -369% 和 1%;若採用更為貼近實際的 20% 平均使用率,兩者的毛利率則分別上升至 6% 和 80%。
換言之,如果所有使用者都僅使用 Fable,Anthropic 的訂閱業務可能早已具備類似純軟體的高毛利率。隨著 Anthropic 探索出模型輕量化方案,Opus 等級模型的推理服務成本將隨時間推移持續降低;而定位高於 Fable 的全新模型層級,其訂閱限額預計將進一步降低(假定它們還會被納入訂閱方案的話)。
相比之下,OpenAI 則採取了“核爆級”的極端手段:直接在全線模型上一刀切地將限額砍至類似 Fable 的極低水平。
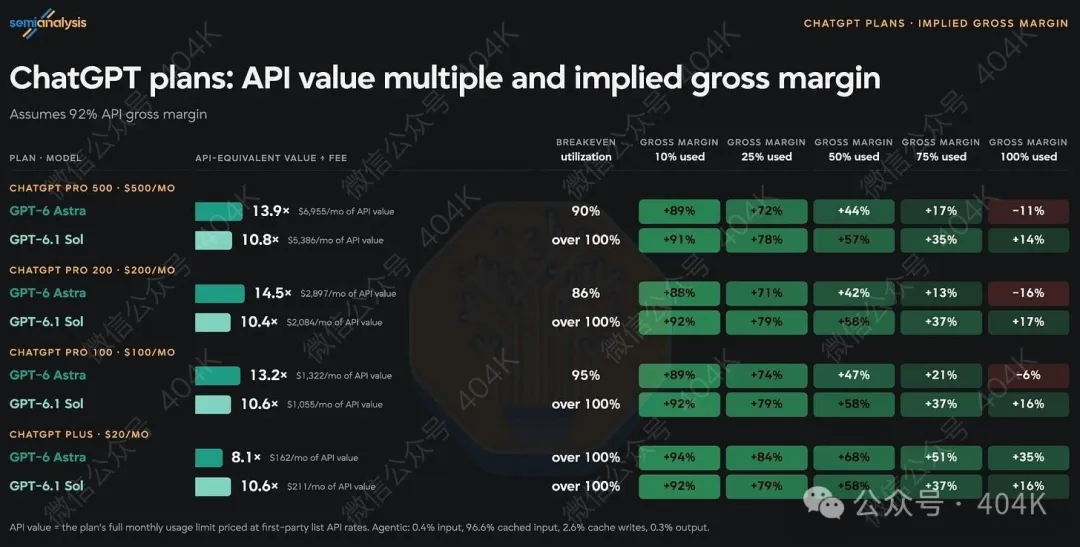
這種做法本應招致公眾的強烈反彈,但 OpenAI 卻不知何故幾乎完全避開了輿論風暴。這很可能是因為 DevDay 開發者大會鋪天蓋地的正面公關掩蓋了前一天的負面消息,同時為存量訂閱使用者保留了一個月的過渡寬限期。
中國大模型訂閱方案仍具性價比
儘管面臨算力受限的挑戰,中國的大模型廠商依然提供補貼性訂閱方案,但不同模型之間的補貼力度差異極大。
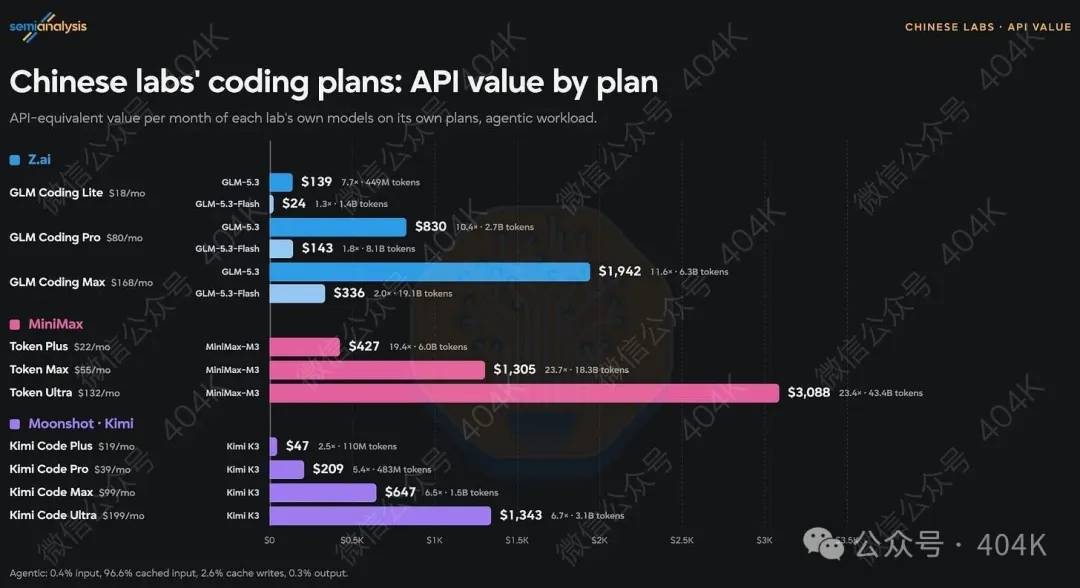
以下是按每美元歸一化後,它們與 OpenAI 和 Anthropic 的對比情況。
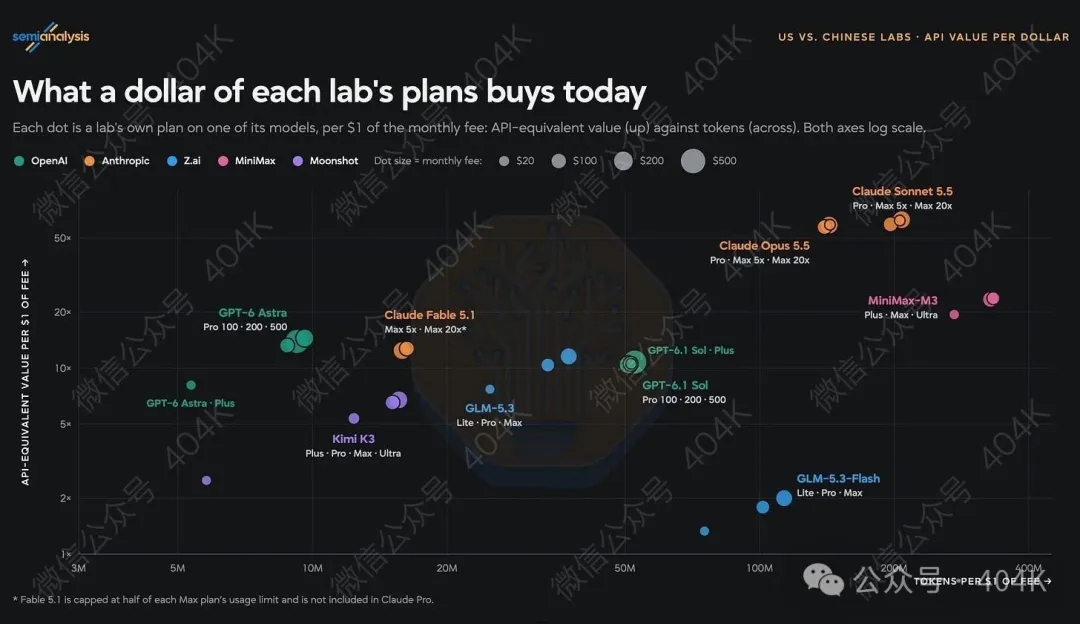
在購買中國廠商更高檔位的訂閱時,每美元所獲得的價值隨之提升。平均而言,其每美元等效 API 價值略低於從 OpenAI 獲得的約 12 倍水平。
第三方方案性價比低於官方原生方案
我們最後要對比的,是在官方原生方案中使用 OpenAI 與 Anthropic 模型,與在 Cursor 及 Cognition(Devin)等第三方套殼工具中使用兩者的差異。
正如所料,官方第一方方案在限額上要慷慨得多。
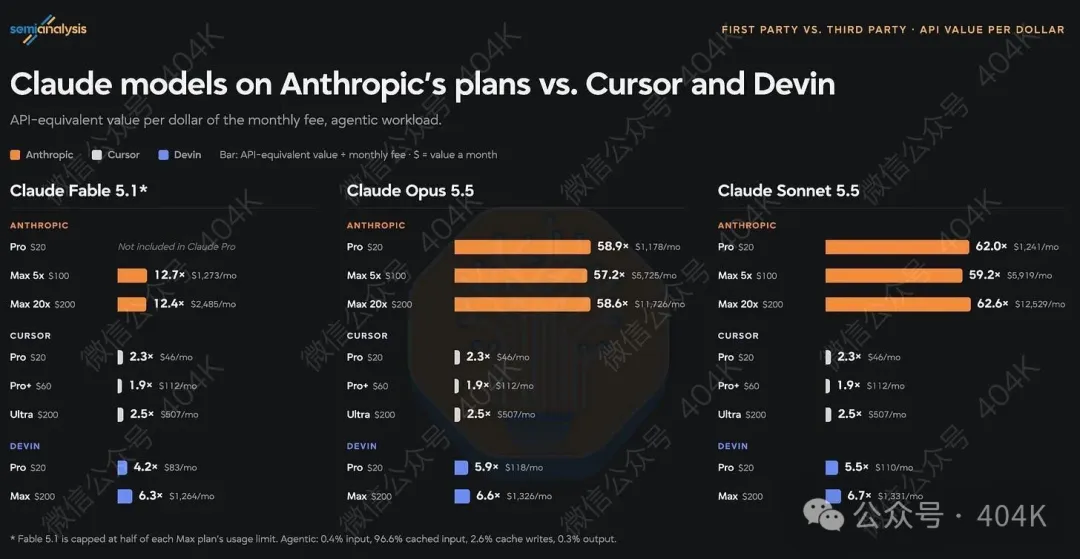
耐人尋味的是,儘管 Anthropic 提供的限額比第三方高出 9 倍以上,其訂閱毛利率很可能仍大幅高於 Cursor 與 Cognition。這就是自主掌控底層模型、而非僅僅充當他人 API 轉售套殼方的巨大威力。
由於 OpenAI 最新模型已不再向 Cursor 提供,此處僅展示 OpenAI 與 Cognition 的對比情況。
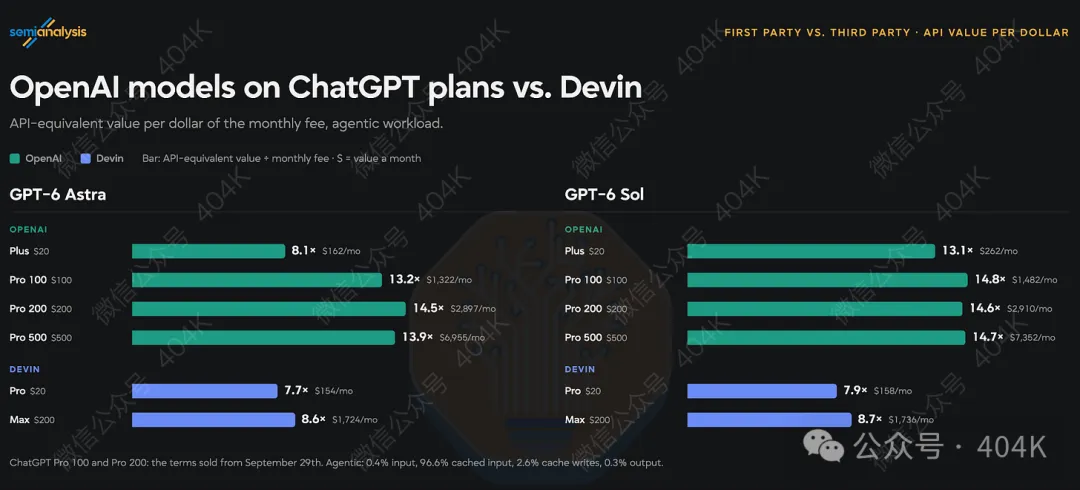
值得玩味的是,此處的差距明顯縮小,部分原因在於 Cognition 對 OpenAI 模型提供了更慷慨的額度(可能協商獲得了更高的企業折扣),但更主要的原因在於 OpenAI 自身訂閱方案所提供的每美元價值已遠低於 Anthropic。
最後,以下是在每月 200 美元的 Cursor 方案中,使用者所能獲得的 Composer 與 Grok 4.7 的等效價值。
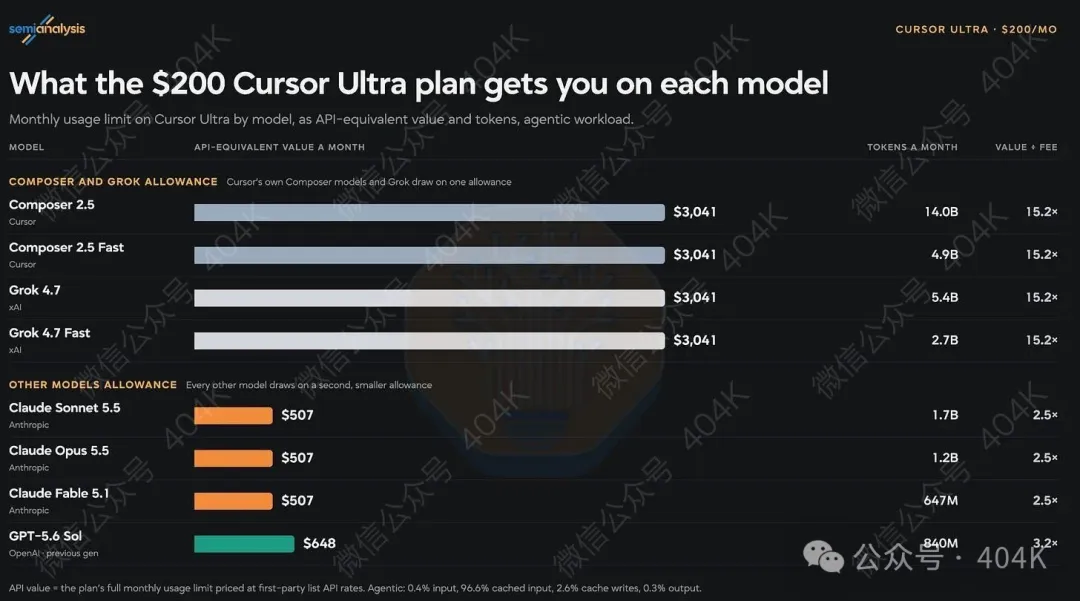
其每15.2美元倍的等效 API 價值僅略高於 OpenAI 的 Pro 方案,而正如預期,這一數值遠高於 Cursor 為第三方模型提供的額度價值。
有關 Meta 和 SpaceXAI 訂閱方案的更多資料,以及各廠商發佈新模型或調整限額時的即時動態更新,可參考 Tokenomics 相關模型。 (404K)