
剛剛,Google CEO 劈柴哥 Sundar Pichai 和 Google DeepMind 同時官宣,開源 EmbeddingGemma 2。
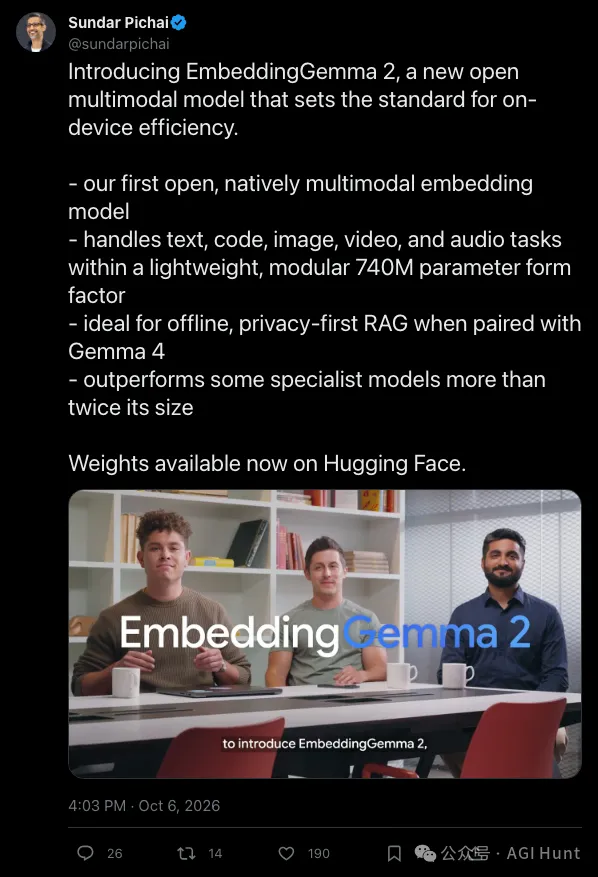
按劈柴哥的說法,這是Google第一個開放原始碼的、原生多模態的 Embedding 模型。
文字、程式碼、圖片、視訊、音訊這五類任務,全都被裝進了一個 740M 參數的小模型裡,權重也已經放上了 Hugging Face。
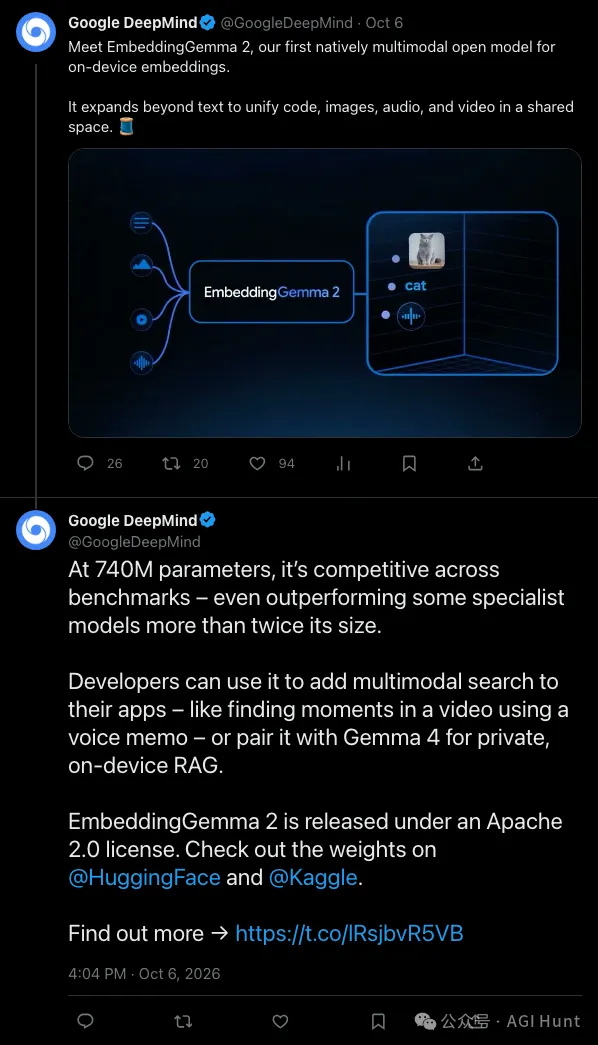
DeepMind 也發了條帖子,解釋它具體是做什麼的:
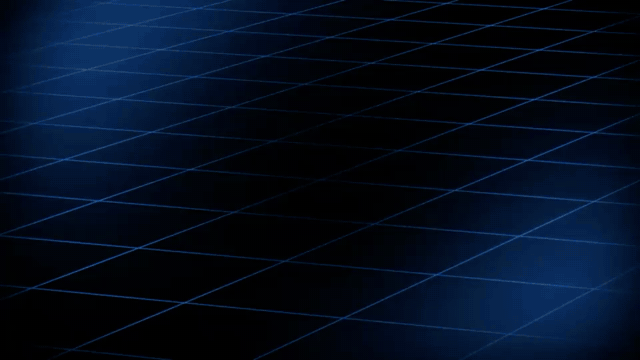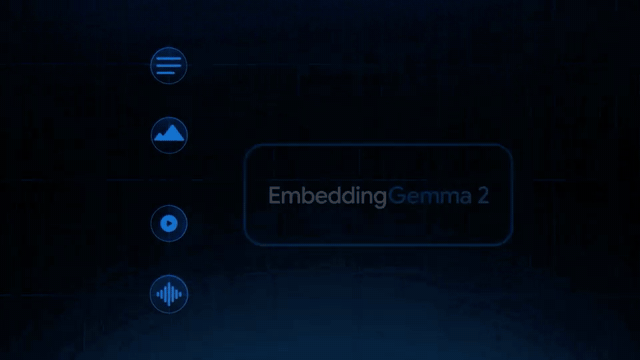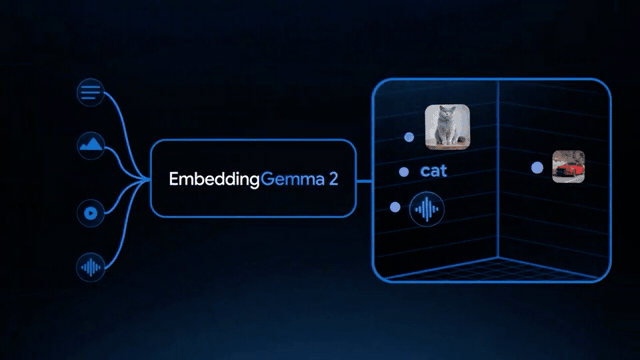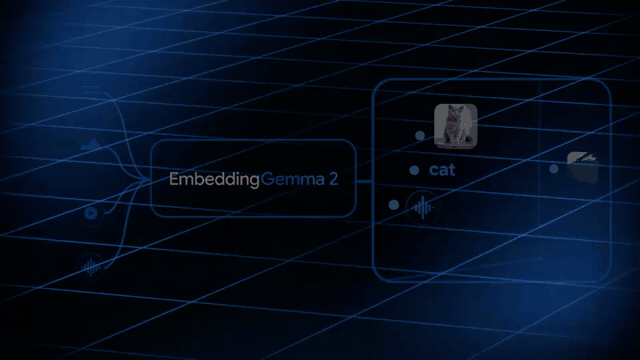
一張貓的照片、「cat」這個單詞、一段貓叫聲,經過 EmbeddingGemma 2 之後會落進同一個向量空間,而且挨得很近,一輛紅色的車則被放到了遠處。
以前要做這種跨模態的檢索,得是文字一個模型、視覺一個模型、音訊再來一個模型。現在一個就夠了,而且是能在手機上跑的那種。
DeepMind 還補充說,協議是 Apache 2.0,Hugging Face 和 Kaggle 上都能下載了。
01 模型結構
740M 是全模態加在一起的數字,它其實是由三塊拼起來的。
文字主幹有 270M(130M 的 transformer 加 140M 的 embedder),視覺編碼器 170M,音訊編碼器 300M,其中後兩塊可以不載入,所以實際跑起來有四種大小:
如果只做文字檢索,270M 就夠了。
它是在 Gemma 4 的架構上做的,和 Gemma 4 共用同一套文字 tokenizer 和音訊編碼器,兩個模型放在一起跑本地 RAG 的時候,總的記憶體佔用還能再省一些。
其他幾個參數:
• 輸出 768 維向量,支援 100 多種語言
• 上下文 8K token,是上一代的 4 倍,一次能放進 5.5 分鐘的音訊、29 張圖片或者 58 幀視訊(默認每秒抽 1 幀),也可以混著放
• 支援 Matryoshka 表示學習,768 維的向量可以截到 512、256、128 維,向量庫的記憶體最多能降到原來的六分之一
• 文字輸入可以帶一個任務前綴(搜尋、問答、程式碼檢索、分類、聚類等),讓同一段文字針對不同任務給出不同的向量
量化之後放到 Pixel 11 Pro 上跑,官方給的資料是純文字只佔約 191MB 記憶體,全模態約 567MB。
模型卡里還寫了兩個容易踩的坑。
一個是截維度。截到 256 維基本不掉分,但到了 128 維,多模態的分數會掉得很厲害(MMEB v2 從 59.01 掉到 45.65),官方建議 128 維只用在純文字上。
另一個是精度,不要用 float16 來跑。
它的啟動值超出了 float16 能表示的範圍,結果會變成 NaN 或者悄悄變差,而且還不報錯……官方讓用 bfloat16 或者 float32。
02 跑分
模型卡中的成績單(768 維,全精度):
多語言文字的成績和上一代基本持平,漲得最多的是程式碼檢索,從 68.76 到了 78.68,將近 10 分。
給本地程式碼庫建索引、給 coding agent 做檢索,也是Google這次專門點了名的用法。
圖片、視訊、音訊這幾行上一代是空的,因為上一代只支援文字。
劈柴哥帖子裡說的「超過一些比自己大兩倍多的專用模型」,對應的是官方部落格裡的三張散點圖,橫軸是模型大小,縱軸是分數。
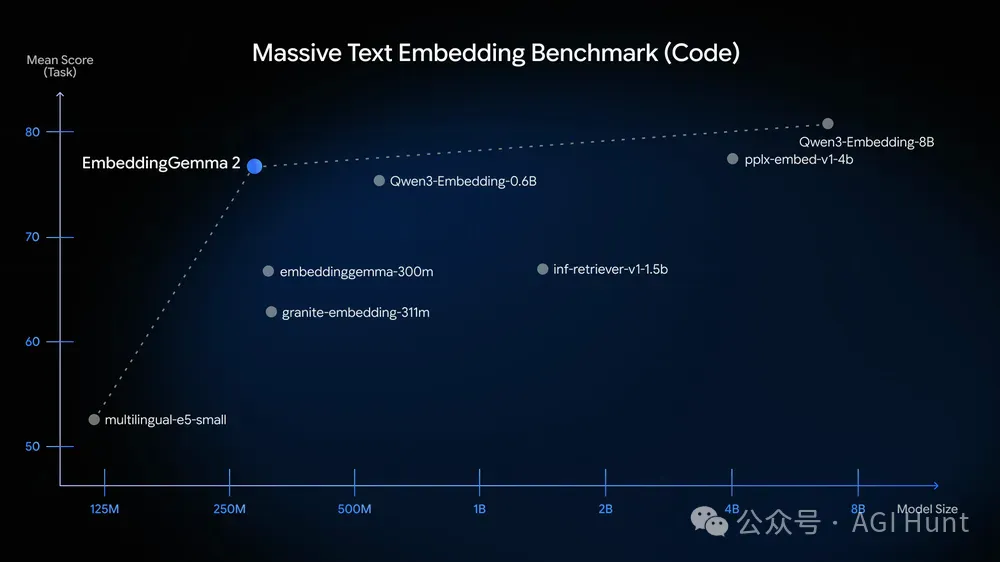
程式碼檢索只用得上那 270M 的文字部分,按這個大小算,它壓過了體積是自己兩倍多的 Qwen3-Embedding-0.6B,和 4B 的 pplx-embed-v1 差不多在一個水平,最高的還是 Qwen3-Embedding-8B。
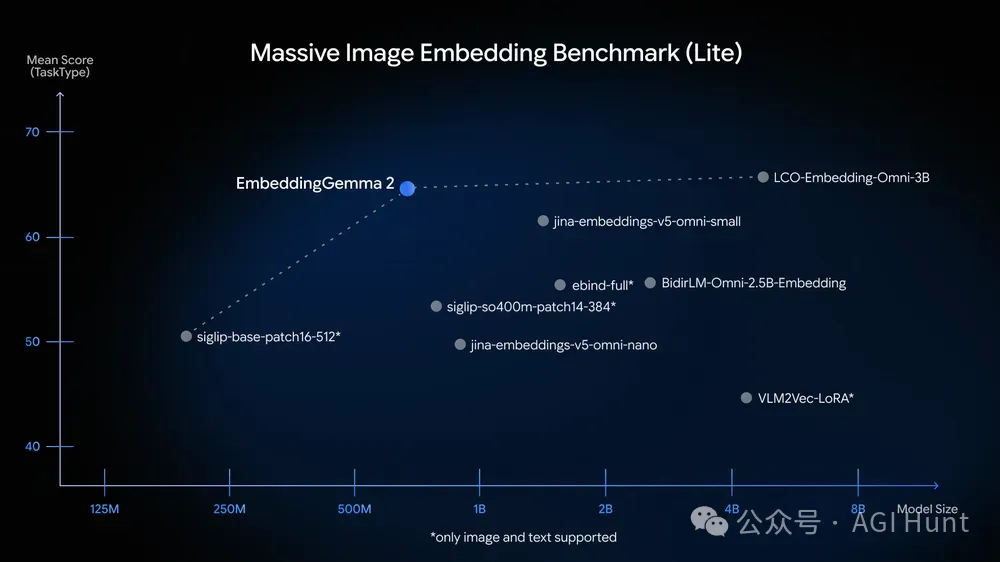
圖片方面,它和 3B 的 LCO-Embedding-Omni 只差 1 分左右,jina-embeddings-v5-omni-small、SigLIP 這些都排在它的下面。
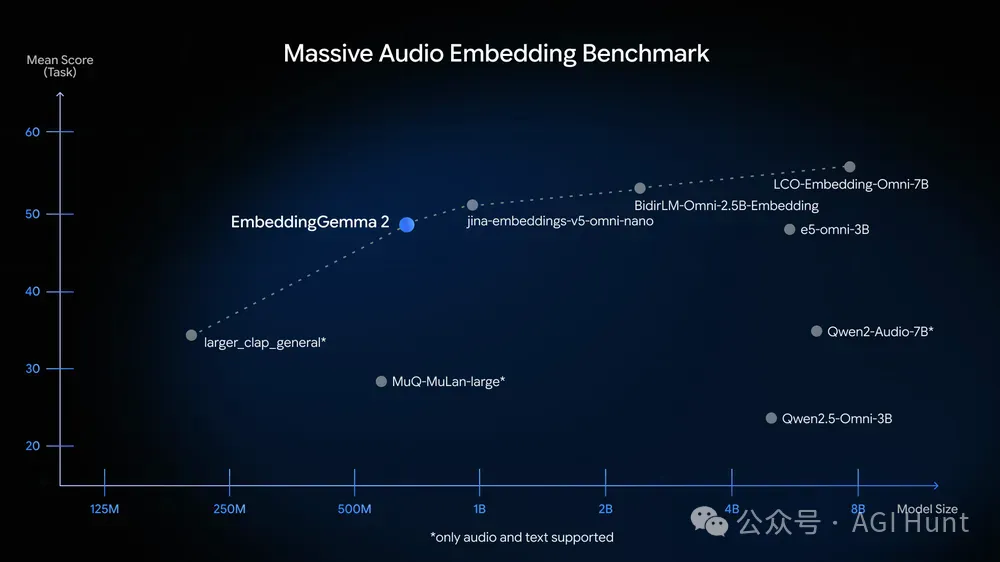
音訊上它比 jina-embeddings-v5-omni-nano 略低一點,而 7B 的 Qwen2-Audio 和 3B 的 Qwen2.5-Omni 則被它落下了一大截(這兩個本來也不是專門做 Embedding 的)。
官方自己的定位是:1B 以下最強的多模態 Embedding 模型之一。
03 對比友商千問、OpenAI
那它和千問、和 OpenAI 的 Embedding 等友商相比如何呢?
千問現在有兩條 Embedding 線,也都是 Apache 2.0。一條是去年 6 月的 Qwen3-Embedding,純文字,有 0.6B、4B、8B 三個尺寸。
另一條是今年 1 月的 Qwen3-VL-Embedding,支援文字、圖片和視訊,有 2B 和 8B 兩個尺寸。
OpenAI (對外)在用的還是 2024 年 1 月發的 text-embedding-3 系列,純文字,只有 API。
把大家放在一起來看:
(千問和 OpenAI 的分數取自千問的模型卡,EmbeddingGemma 2 的取自Google的模型卡,兩邊的評測口徑可能會有細微出入)
和千問相比,單論分數的話,EmbeddingGemma 2 是打不過的。
純文字上它比 Qwen3-Embedding-0.6B 低了 3 分,多模態的 MMEB-V2 比 Qwen3-VL-Embedding-2B 低了 14 分,而 8B 的版本更是到了 77.8。
但兩邊關注的地方不一樣。
Qwen3-VL-Embedding 最小也有 2B,而且不支援音訊。EmbeddingGemma 2 全模態加起來才 740M,奔著的是手機和筆記本。
而 OpenAI 的 text-embedding-3-large 的 MTEB 多語言是 58.93,被 EmbeddingGemma 2 那個 270M 的文字部分超了 2 分多。
模態上它肯定是更全的,OpenAI 的 Embedding 到現在還只能支援文字。
而很關鍵的一點是,它是開放原始碼的。
Google自己也有閉源的 Gemini Embedding 系列,需要走 API,官方說 EmbeddingGemma 2 和它用的是同一套技術。
04 四個 demo
官方這次配了四個 demo,你可以帶著問題往下看:我可能用來做些什麼?
第一個是 Google AI Edge Gallery 裡的 Instant Media Search,在手機相簿裡打字搜圖,或者舉起相機,拿眼前的東西去搜相似的照片:
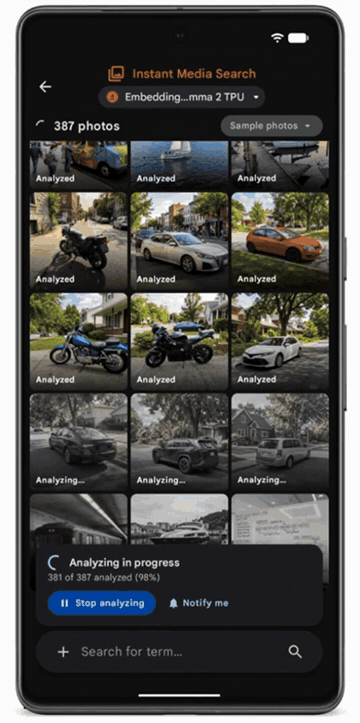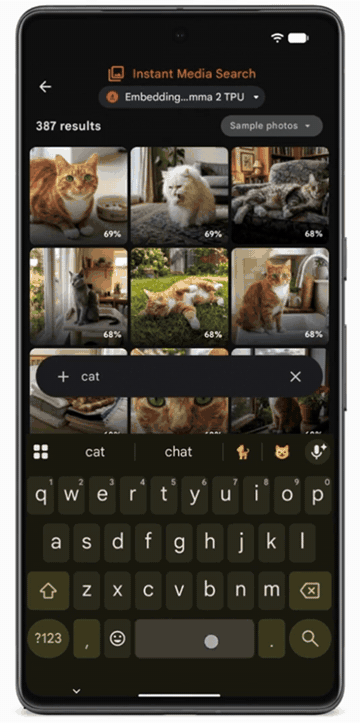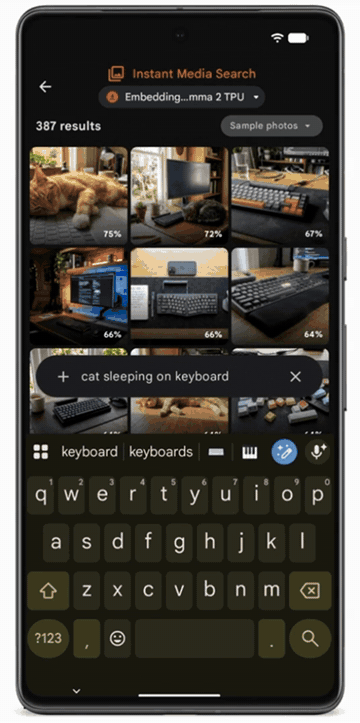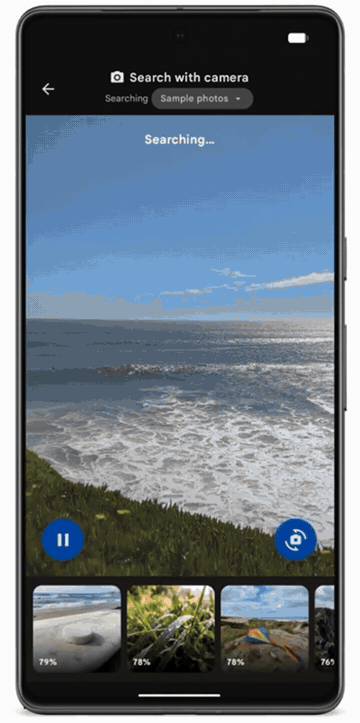
輸入「cat sleeping on keyboard」,搜出來的便是趴在鍵盤上睡覺的貓。
第二個是 Video Moments Finder,在一段視訊裡搜「Turtle eating」,海龜吃東西的那幾段就在進度條上被標了出來:
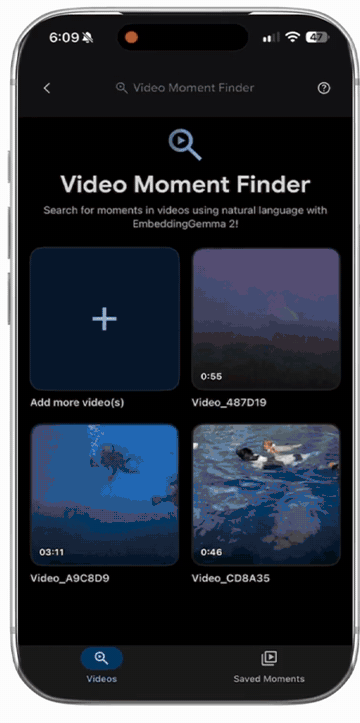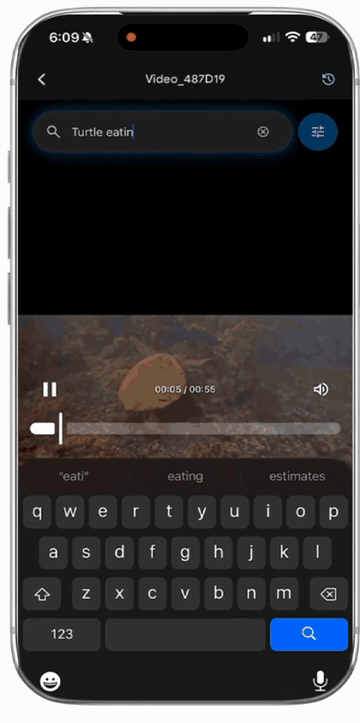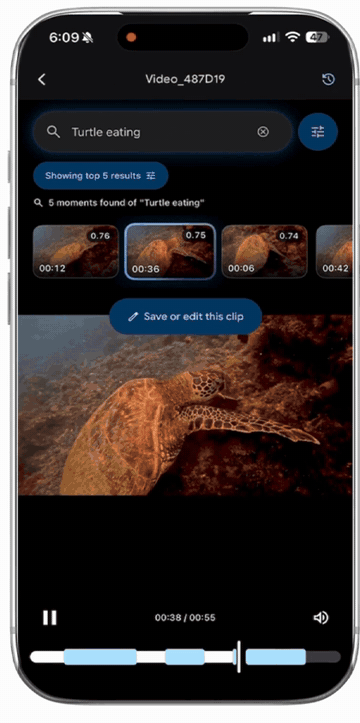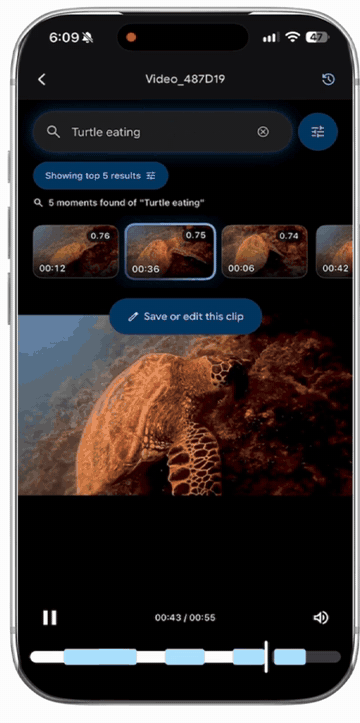
查詢也可以換成一段音訊,DeepMind 帖子裡說的「用一段語音備忘去找視訊裡的某個瞬間」,就是它。
第三個是 Google AI Edge Foresight,由 EmbeddingGemma 2 負責在本地檔案裡檢索,Gemma 4 負責回答。
開會時有人問了個問題,答案和出處就自己出現在側邊欄裡了:
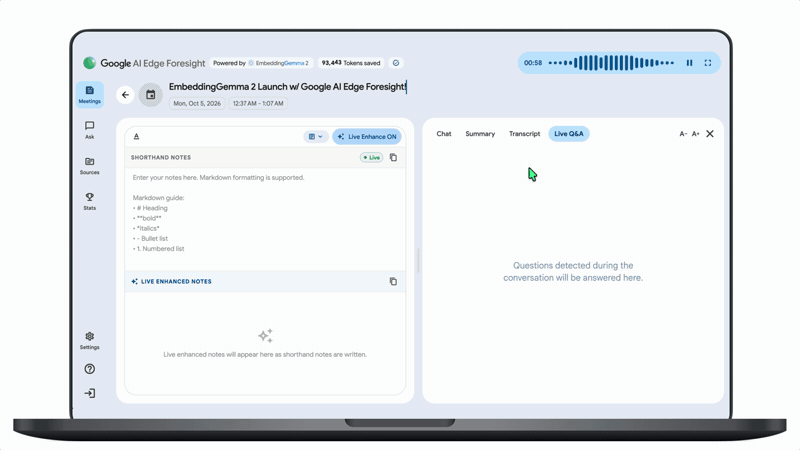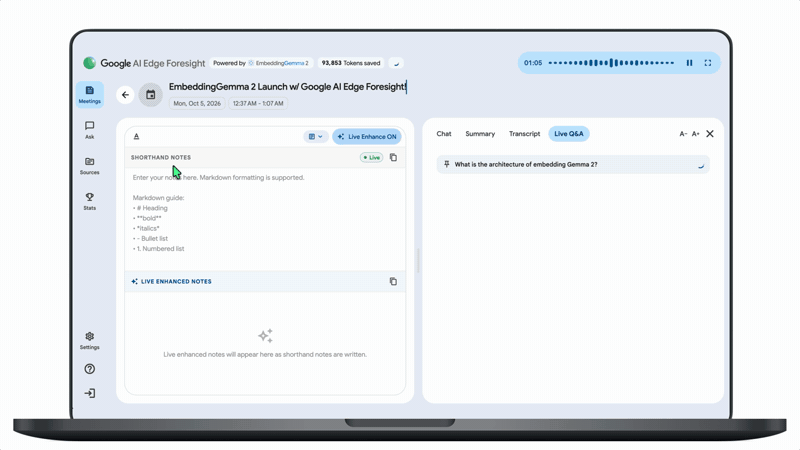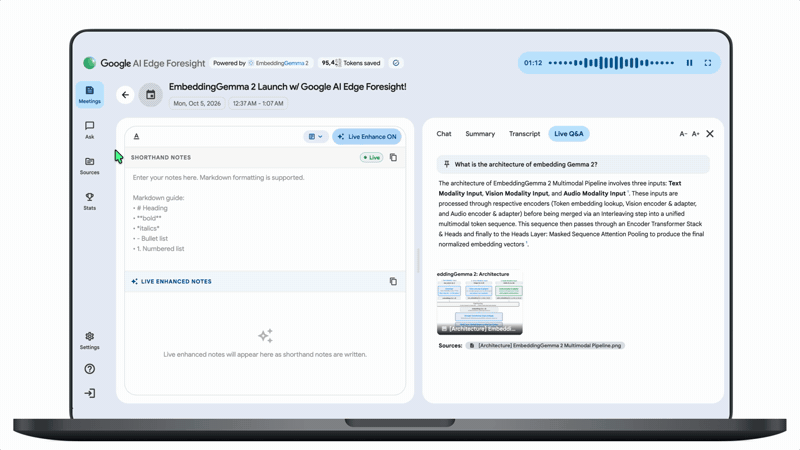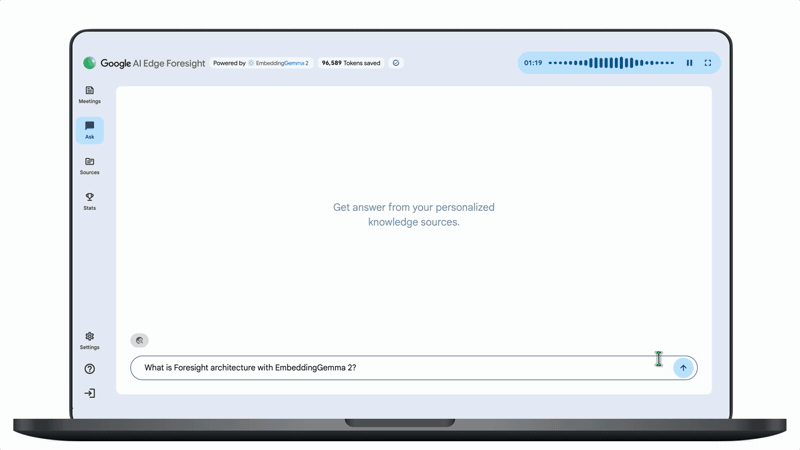
第四個是拿它來做即時決策的 MediaPipe Decision Task API,演示是一個仿 Chrome 小恐龍的跑酷遊戲(這是要 PK 一下 Jev 啊)。
上面一條跑道,由 270M 的 EmbeddingGemma 2 在瀏覽器裡判斷該跳、該蹲還是該衝刺,下面一條跑道則交給了普通的 LLM:
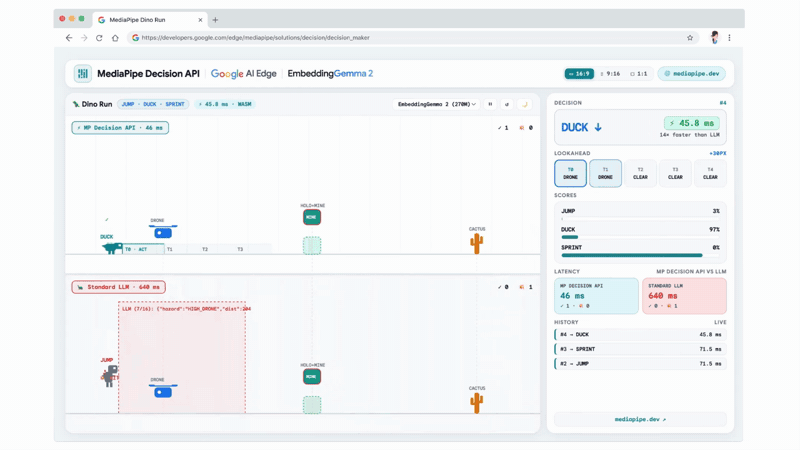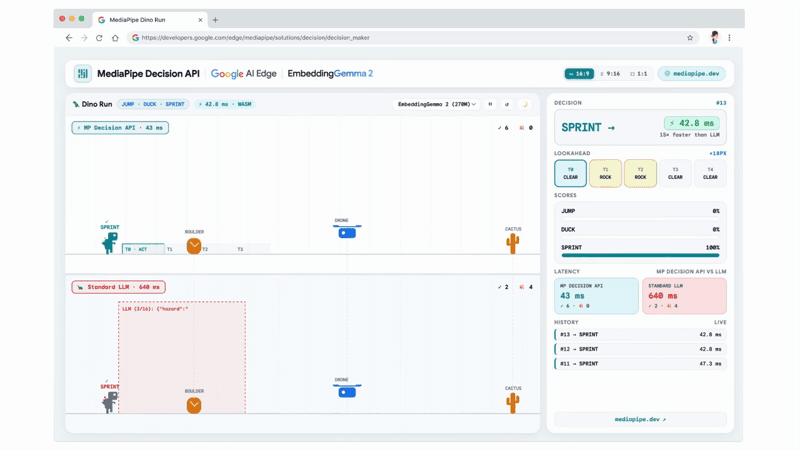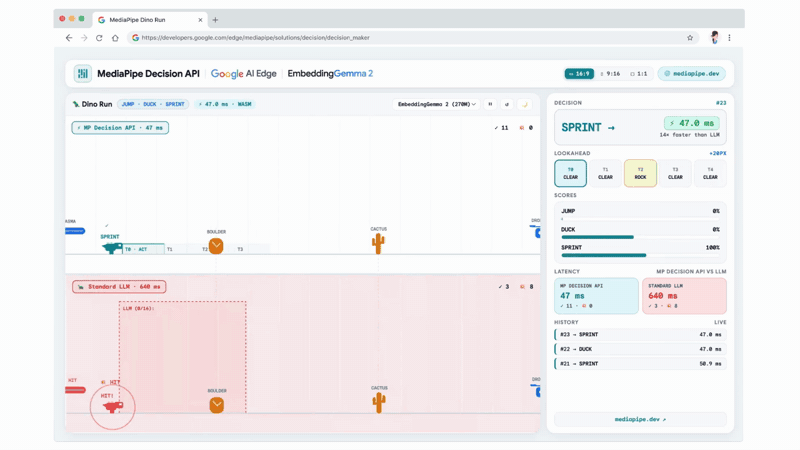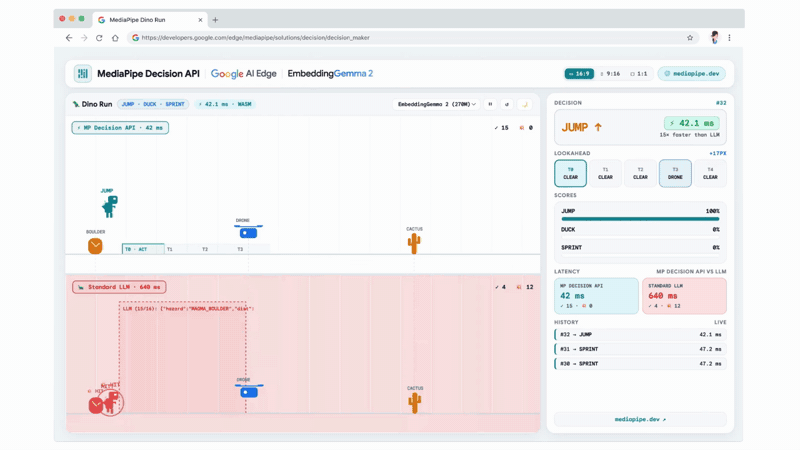
前者一次決策 43 毫秒,後者要 640 毫秒。
等 LLM 把那段 JSON 吐完,恐龍已經撞上去了……
工具鏈方面,transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama、LM Studio 都已經支援。
瀏覽器裡可以用 transformers.js 或 WebGPU,Unsloth 也給出了微調的教學。
用 sentence-transformers 的話,可以參考下面的程式碼:
●●●from sentence_transformers import SentenceTransformer
model = SentenceTransformer("google/embeddinggemma-2")
query_emb = model.encode("What causes the northern lights?", prompt_name="SearchQuery")
doc_emb = model.encode("The northern lights are caused by charged particles from the sun.", prompt_name="Document")
print(model.similarity(query_emb, doc_emb))
05 相隔一年
Google今年在開源上其實一直有些動作。
4 月的 Gemma 4 第一次把協議換成了 Apache 2.0,6 月又補了一個 Gemma 4 12B,夏天還陸續放出了 TimesFM 3.0、TabFM 等模型。
但 Embedding 模型的上一次更新還是去年 9 月的初代 EmbeddingGemma,308M、純文字,用的也還是Google自家的 Gemma 協議。
到這次的第二代,中間隔了 13 個月,協議也跟著換成了 Apache 2.0。
官方部落格裡說,初代的下載量已經超過了 2000 萬次。
06 OpenAI 的烏龍
說到 Embedding 和開源,還有個小插曲。
今年 4 月 22 日,OpenAI 給開發者群發了一封模型下線通知,官方的 deprecations 文件也同步更新了。
名單裡就有 text-embedding-3-small,按當時開發者們轉述的說法,它排在 10 月 23 日下線的那一批。
Embedding 模型下線,和聊天模型下線不是一回事。聊天模型換個型號接著用就行,Embedding 模型一換,庫裡存著的所有歷史向量都得重新算一遍。
很快就有開發者在官方社區發帖,問 OpenAI 能不能在下線之後把它開源出來:
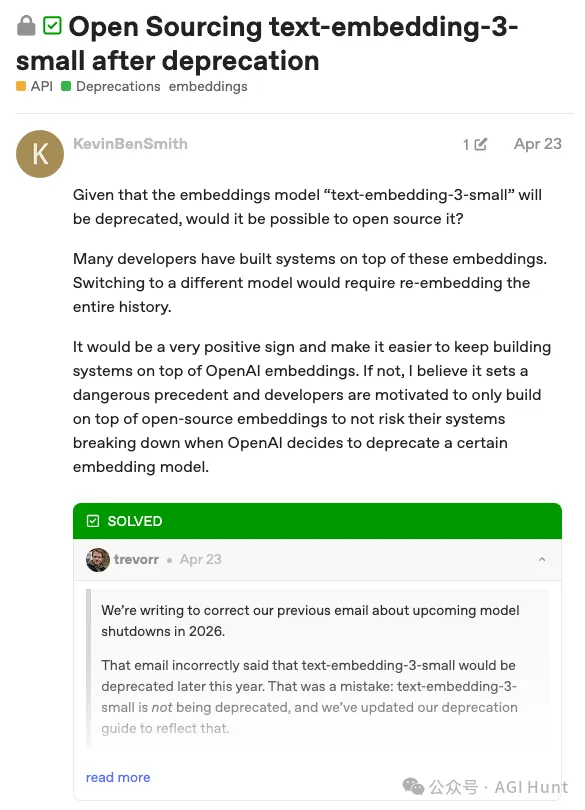
如果不行,這就開了一個危險的先例。開發者只會更願意把系統建在開放原始碼的 Embedding 上,免得那天 OpenAI 決定下線某個模型,自己的系統也跟著垮掉。
這封烏龍郵件,我也有收到。
我當時還慌了,我好多資料都在用 OpenAI 的 Embedding,那我是不是得考慮遷移了?
幾個小時之後,文件裡的那一行先不見了。隨後 OpenAI 又發了一封更正郵件,說上一封寫錯了,text-embedding-3-small 並不會下線。
總算是虛驚一場,我目前就也沒動。
不過要是當初沒有這封更正,按那個日期算,再過兩個多星期,它就該停掉了。
而 EmbeddingGemma 2 的權重下到自己硬碟上之後,就沒有誰能給你發這種郵件了。 (AGI Hunt)