
剛剛,Anthropic 發佈了 Claude Haiku 5.5,官方稱這是他們迄今為止最便宜、最快、能力也最強的小模型。
Haiku 5.5 的平均運行成本,比上一代的 Haiku 4.5 低了約 75%。
而在便宜了這麼多的同時,它在編碼、computer use 和知識工作上的分數,又都比 Haiku 4.5 高出了一大截。
Anthropic 這次還一併宣佈了另外兩件事,一是 Sonnet 5.5 的快取讀取價格減半,二是 Claude Max 和 Team 訂閱使用者每個月會多出一筆 API 額度。
跑分
先來看官方給出的成績單。
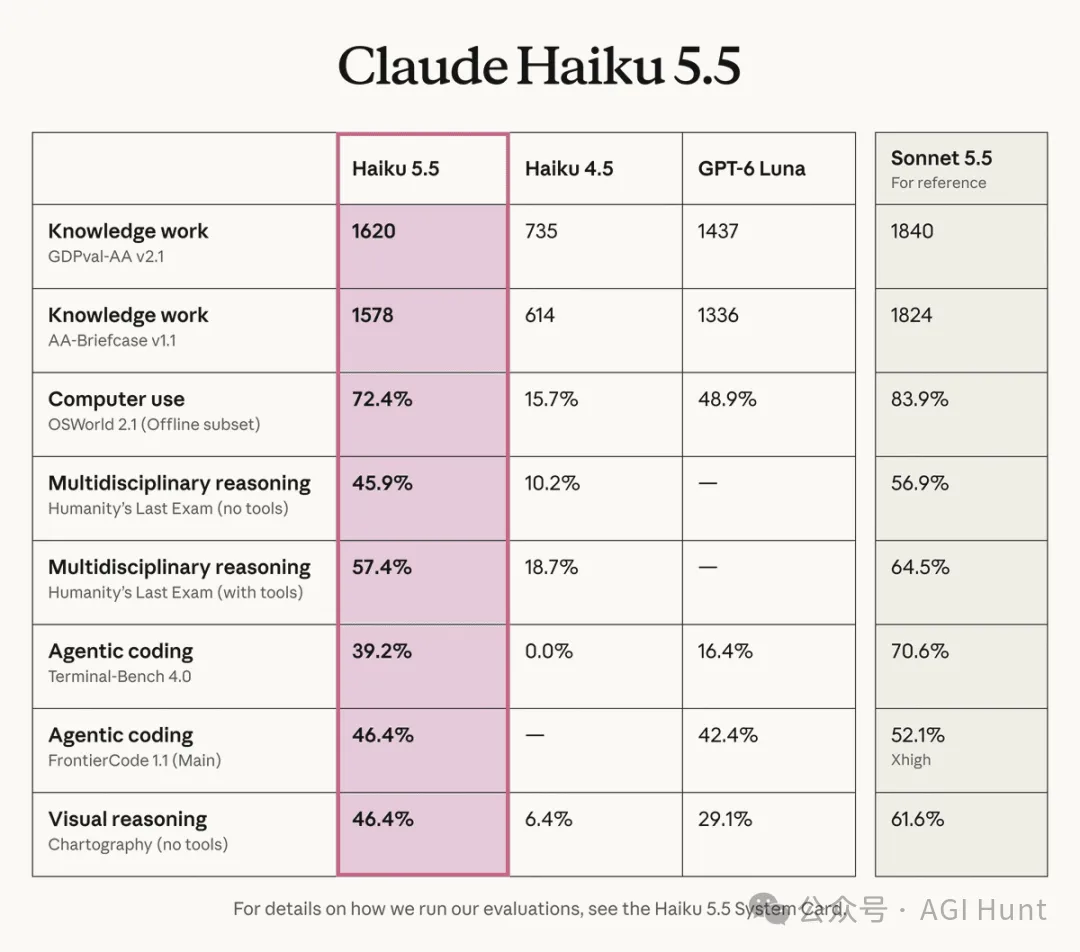
表裡除了上一代的 Haiku 4.5,還拉來了 GPT-6 Luna 進行鞭打,最右邊的 Sonnet 5.5 則僅供參考。
提升最大的是 computer use。在 OSWorld 2.1(離線子集)上,Haiku 5.5 拿到了 72.4%,而 Haiku 4.5 隻有 15.7%,GPT-6 Luna 則是 48.9%。
Agentic coding 方面,Haiku 4.5 在 Terminal-Bench 4.0 上是直接交了白卷的,0.0%……而 Haiku 5.5 做到了 39.2%,GPT-6 Luna 為 16.4%。
Humanity's Last Exam 上,Haiku 5.5 不帶工具時是 45.9%,帶工具則有 57.4%,而上一代分別只有 10.2% 和 18.7%。
知識工作的 GDPval-AA v2.1 和 AA-Briefcase v1.1 兩項,Haiku 5.5 分別拿了 1620 分和 1578 分,都是 Haiku 4.5(735 和 614)的兩倍還多。
視覺推理的 Chartography 上,也從 6.4% 漲到了 46.4%。
當然,它和 Sonnet 5.5 之間還是有差距的。Terminal-Bench 4.0 上 Sonnet 5.5 是 70.6%,比 Haiku 5.5 高了三十多個點,複雜的 Agent 編碼任務還是該交給 Sonnet 5.5 和 Opus 5.5。
Haiku 5.5 適合的是範圍更窄一些的活,比如上下文壓縮、摘要和 subagent,這些任務放在以前用 Claude 來跑,成本根本劃不來。
可調 effort
Haiku 5.5 是第一個帶 effort 設定的 Haiku 模型,一共有 Low、Med、High、Xhigh、Max 五檔。
和 Claude 的其他模型一樣,每個任務是要省錢還是要智能,都可以自己來定了。
官方放出了三張各檔位的「分數 / 成本」曲線圖。
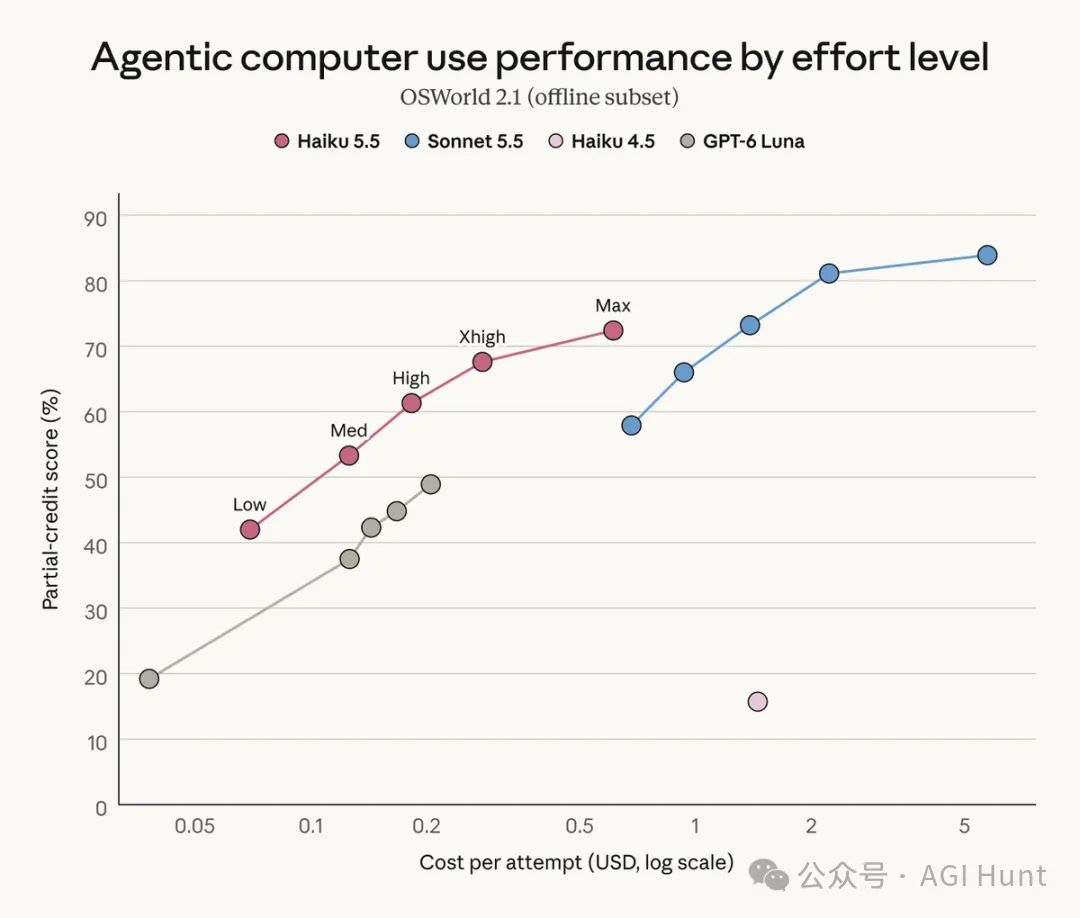
OSWorld 上,Haiku 5.5 開到 Max 檔之後是 72.4%,已經比 Sonnet 5.5 最低的那兩檔都要高了,而單次任務的花費還要更少一些。
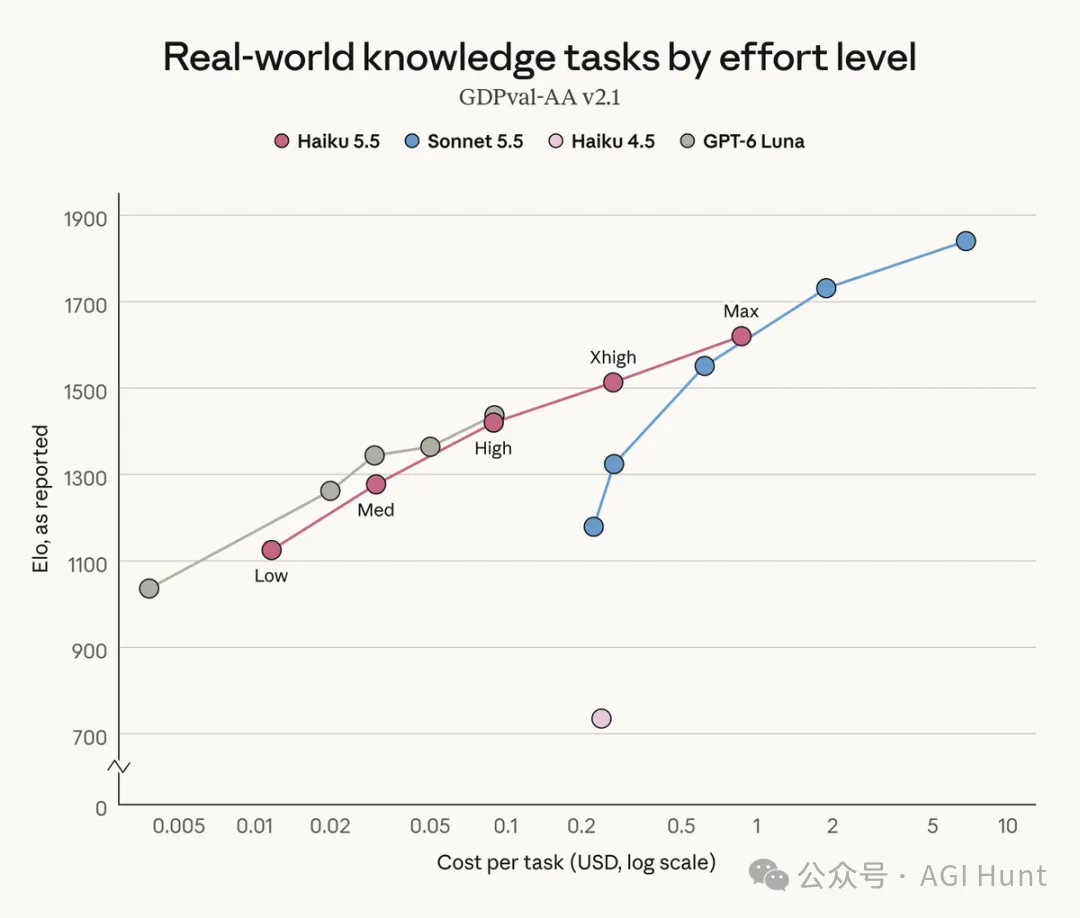
GDPval-AA 上就沒有這麼好看了。在便宜的那幾檔裡,GPT-6 Luna 花同樣的錢拿到的分數還要略高一點,Haiku 5.5 是靠著 Xhigh 和 Max 兩檔才把分數給拉上去的。
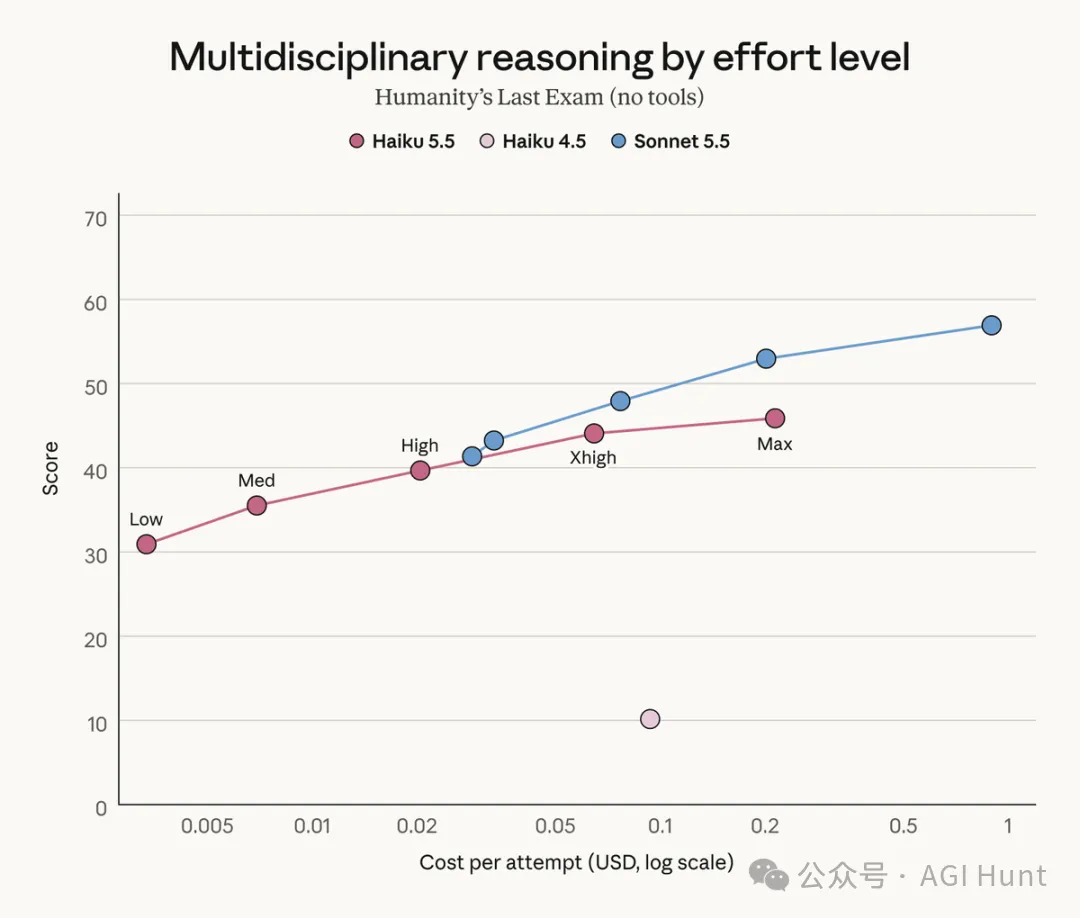
Humanity's Last Exam 上,從 Xhigh 再往上加到 Max,分數就漲不太動了。
價格
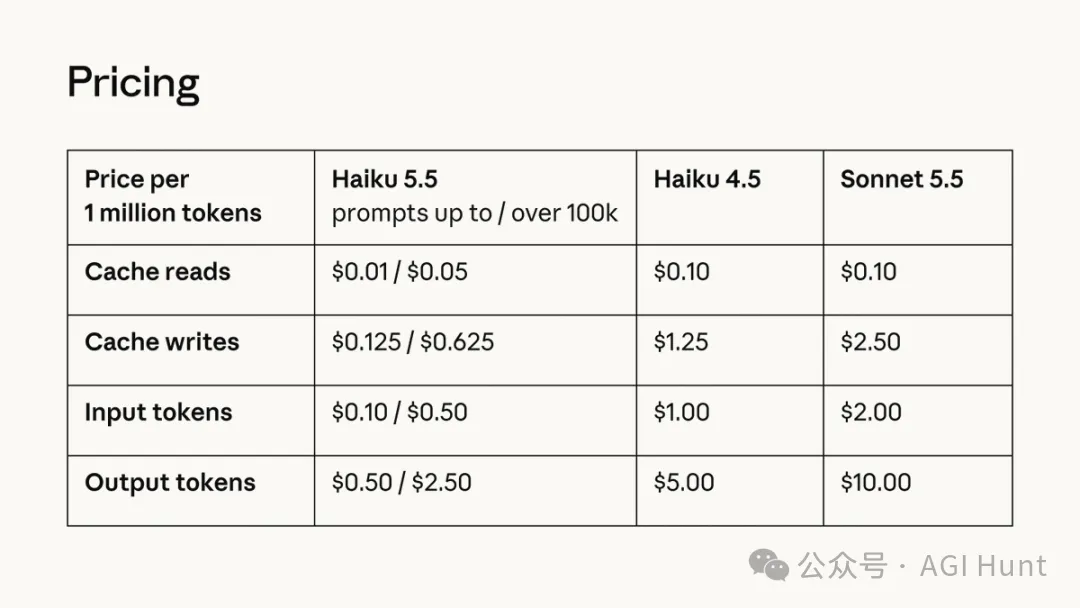
Haiku 5.5 的定價按 prompt 長度分成了兩檔,以 10 萬 token 為界。
算下來,10 萬 token 以內的請求便宜了 90%,超過 10 萬 token 的便宜了 50%。
而在 Haiku 4.5 上,大約有 90% 的請求都落在 10 萬 token 以內。
那為什麼平均下來只有 75% 呢?
官方在腳註裡解釋,這個平均數還把 token 用量的變化也算了進去。Haiku 5.5 換上了和 Sonnet 5.5、Opus 5.5 類似的新 tokenizer,干同樣一件事會多用掉一些 token。
再和 Sonnet 5.5 比一下,後者的輸入是 $2.00、輸出是 $10.00。
10 萬 token 以內的 Haiku 5.5,輸入和輸出的價格都只有它的二十分之一。
使用場景
Haiku 5.5 同時也是 Claude 目前最快的模型。不過腳註裡也註明了,這是按各個模型的標準速度來比的,Opus 開了 Fast Mode 之後還是要更快。
官方給它安排的活,主要有這麼幾類。
• 摘要、上下文壓縮、資料庫查詢、分類這種量大且重複的任務
• 編碼時給 Opus 5.5 和 Sonnet 5.5 當 subagent
• 即時客服、瀏覽器操作這類對速度敏感的場景
幾家提前拿到模型的公司也給出了各自的資料。
Asana 拿自家 Agent 產品 AI Teammates 的評測集跑了一遍,和他們現在在用的模型相比,任務完成的延遲降了 30% 以上,單輪推理速度最高是原來的 2.5 倍。
HubSpot 用模擬的 CRM 環境來測模型,Haiku 5.5 三次平均拿到了 92.8%,是這套評測上出現過的最高分。
AlphaSense 的文件問答功能,每周在生產環境裡要呼叫約 800 萬次。他們跑了 400 條查詢,Haiku 5.5 得分 0.84,Haiku 4.5 是 0.76。
Box 的早期測試裡,Haiku 5.5 比 Haiku 4.5 高了 11 分,延遲則只有一半左右。
Cognition 則把它加進了 Devin Fusion 的 sidekick 陣容。有 Haiku 5.5 當副手,Fusion 的 FrontierCode 得分還能保持在 66.2,成本和延遲也都降了下來。
現在在 Devin CLI 裡就可以用上這個組合,由 Opus 5.5 來主導。
Rogo 的 Alex Wang 表示:
更大的模型在做 deck 的時候,一個 Haiku 5.5 subagent 就鑽進 10-K 裡,把 deck 要用的分部營收那一行給找出來。它足夠準,我們敢把這活交給它;也足夠快、足夠便宜,可以大量地跑。
安全
對齊評測上,Haiku 5.5 相比 Haiku 4.5 幾乎是全面改進,失當行為少了很多,配合濫用的意願也更低了。
防護措施方面,它在網路安全上比 Haiku 4.5 管得更嚴,但比近期的其他模型要鬆一些。
和 Sonnet 5.5 相比,它放行的防禦類任務要更多一些,而滲透測試等更可能被攻擊者用到的技術,仍然會被攔下。
生物方面的防護,則與 Sonnet 5、Sonnet 5.5 和 Opus 5 保持一致。
Sonnet 降價與 API 額度
Sonnet 5.5 的快取讀取價格,從每百萬 token $0.20 降到了 $0.10。
快取讀取在 Agent 任務的 token 消耗裡佔了很大一塊,所以降價之後,Sonnet 5.5 跑大多數 Agent 任務的成本會下降約 20%。
訂閱使用者專屬的是,所有 Max 和 Team 訂閱本周起每月會多一筆 API 額度,可以在 Claude Platform 上使用。
Max 5x 每月有 $100,Max 20x 每月 $200,Team 則是最高 $500,由團隊成員共用。
這筆額度所有模型都能用,Anthropic 希望大家拿它來試著做些呼叫 API 的工具、應用和 Agent。
就是特麼的不知道會不會封號,我剛封一個……
現在可用
Haiku 5.5 現在已經在所有平台上線,包括 AWS、Google Cloud 和 Microsoft Azure。
Claude Platform 上的模型 ID 是 claude-haiku-5-5。(AGI Hunt)