
HBM4的貴,不只是一顆晶片的定價問題,而是整個DRAM產能體系在AI時代被重新分配的結果。
一條價格曲線正在陡峭抬升。HBM4 12層產品的單價,正從2026年下半年的約2美元/Gb,向2027年的4至5美元/Gb快速攀升——漲幅100%到150%。換成單顆產品更直觀:一顆12層36GB的HBM4堆疊,價格預計從2026年的約600美元翻倍至2027年的約1300美元。
三星已啟動與主要客戶的2027年供應合約談判,報價鎖定在4至5美元/Gb區間的中高位——至少4.5美元/Gb,是當前HBM3E約1.5美元/Gb的三倍以上。
兩代產品之間,不是簡單的"漲價",而是一次系統性的成本重構。核心追問隨之而來:HBM4憑什麼這麼貴?這些額外的成本到底花在了那裡?
一、供給端:HBM如何"以更少的位元吃掉更多產能" ★
晶圓投入佔比的加速提升。TrendForce的資料給出了一條清晰的曲線:全球三大HBM供應商的HBM晶圓投片量佔整體DRAM晶圓投片量的比例,2025年底約18%,2026年底約22%,2027年底將升至約30%。
三星電子執行副總裁Kim Taewoo在2026年9月公開確認了這一趨勢——預計明年HBM將佔DRAM廠商晶圓總產能的近30%。據行業估算,三星的HBM月均晶圓投入量正計畫從2026年的約18萬片增至2027年的約25萬片。
東吳證券的測算口徑略有不同但趨勢一致:HBM產能佔DRAM總產能的比重從2024年的12.3%升至2025年的17.1%、2026年的20.8%、2027年將達22.5%。
"三倍吞噬"的數學表達。關鍵反差點在口徑之差。按位元供給口徑,HBM佔DRAM位元供給的比例僅為8%、9%到13%。但按晶圓口徑,這個比例要高得多——HBM單位位元所需的晶圓產能約為常規DDR5的2.5至3倍。
這意味著:HBM用不到13%的位元供給,吃掉了將近30%的晶圓產能。每增加一片HBM晶圓投入,就意味著減少約三片通用DRAM晶圓的產出。美光在Hot Chips 2026上給出的官方口徑印證了這一點:HBM相對DDR5的矽片損耗約3倍,且"每一代還在擴大"。
供給端的連鎖反應。摩根大通的測算顯示,2025至2028年DRAM新增產能中有58%將投向HBM製造(註:這是四年累計口徑,非單一年度),HBM佔用DRAM總產能比例將從19%提升至31%。
HBM4的貴,首先不是因為"製造工藝更複雜",而是因為它在物理上佔用了更多晶圓產能。這決定了HBM4的價格天花板不由技術決定,而由DRAM總產能的物理邊界決定。
二、技術溢價的第一層:定製邏輯基底 ★
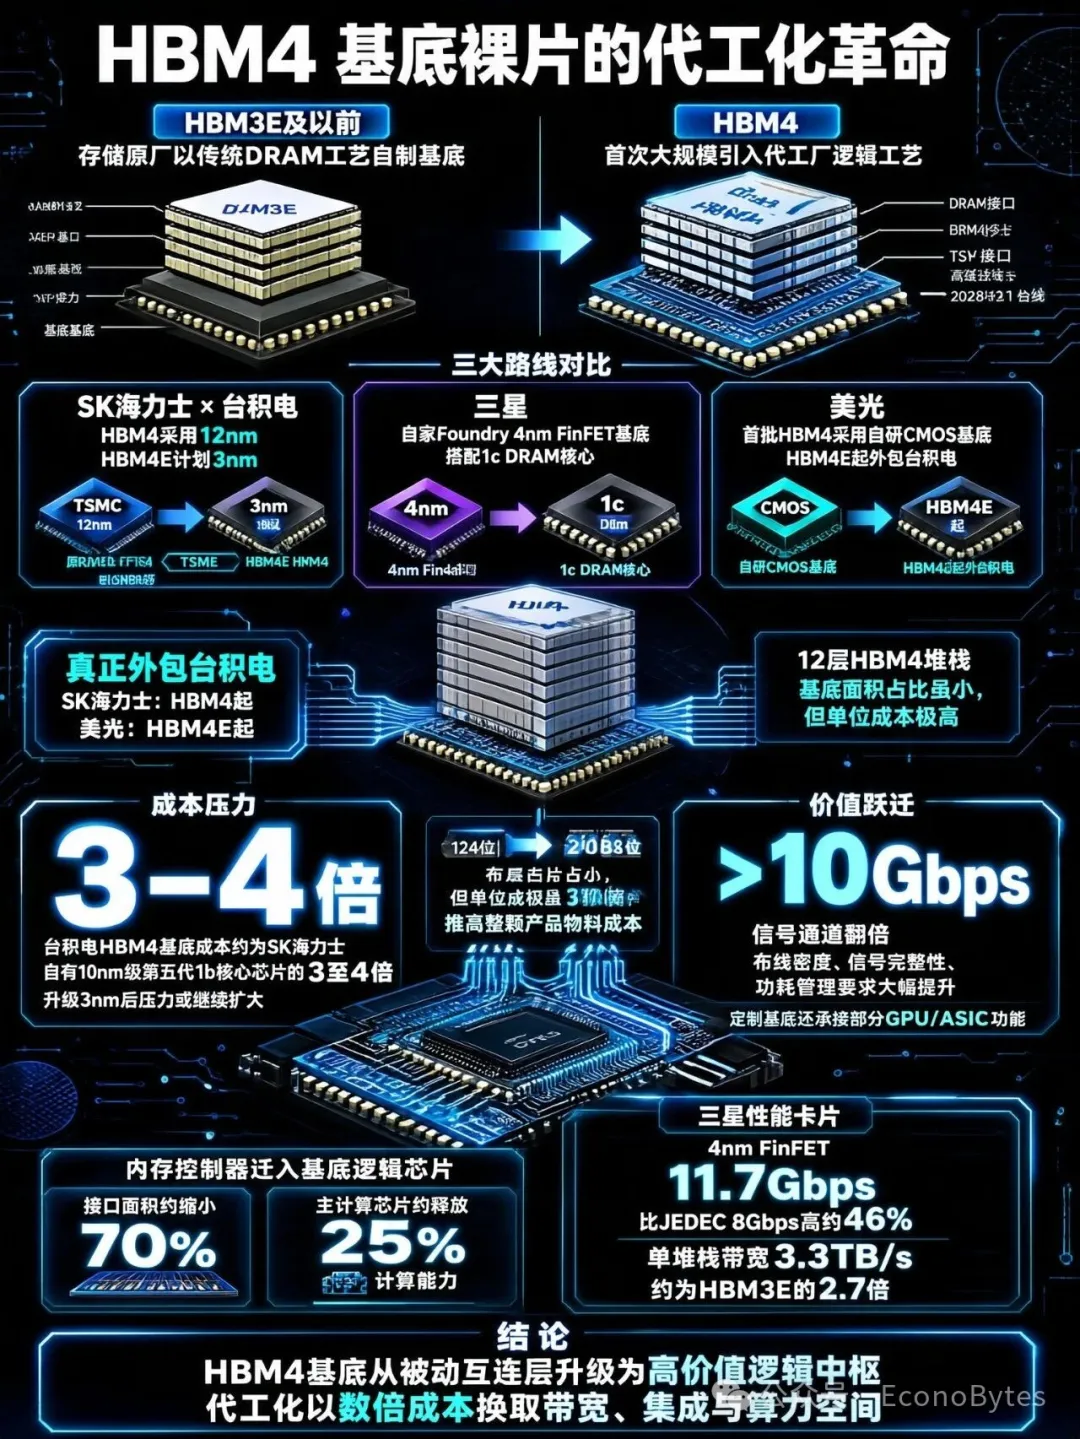
HBM4基底裸片的"代工化"革命。HBM3E及之前的基底裸片由記憶體原廠自行製造,採用傳統DRAM工藝。HBM4首次大規模引入代工廠邏輯工藝。
三條技術路線各有不同:SK海力士與台積電結盟,HBM4基底裸片採用台積電12nm工藝;三星採用自家Foundry的4nm FinFET邏輯工藝搭配1c DRAM核心裸片;美光首批HBM4使用自研CMOS基底晶片。嚴格來說,真正把基底外包給台積電的,目前只有SK海力士(自HBM4起)和美光(自HBM4E起)。
代工基底的成本代價。台積電生產的HBM4基底晶片,成本約為SK海力士自身10nm級第五代1b工藝生產的核心晶片的3至4倍(韓媒與業界估算口徑)。SK海力士HBM4E計畫升級至台積電3nm工藝,成本壓力預計進一步擴大。
這意味著,僅基底裸片一項,成本就增加了數倍。對於一顆12層HBM4堆疊而言,基底裸片雖然只佔總面積的一小部分,但單位成本極高,直接拉高了整顆產品的物料成本。
基底裸片為什麼值這個價。HBM4將介面位寬從HBM3E的1024位翻倍至2048位,引腳速率目標超過10Gbps。2048位介面意味著基底裸片需要承載比上一代多一倍的訊號通道,對布線密度、訊號完整性和功耗管理的要求呈指數級提升。
定製基底還承擔了部分原本由GPU/ASIC承擔的功能。據Marvell資料中心記憶體解決方案副總裁Khurram Malik的表述,將記憶體控製器遷移至基底邏輯晶片後,可使介面面積縮小約70%,為主計算晶片釋放約25%的計算能力。
三星的HBM4基底採用4nm FinFET工藝,引腳速率達11.7Gbps(較JEDEC 8Gbps標準高出約46%),單堆疊頻寬達3.3TB/s,約為HBM3E的2.7倍。
關鍵洞察:HBM4的基底裸片不再是一塊"介面板",而是一顆需要先進邏輯工藝製造的晶片。這意味著HBM4的成本結構中,首次出現了"邏輯代工成本"這一全新科目。
三、技術溢價的第二層:16層堆疊與MR-MUF的工程極限
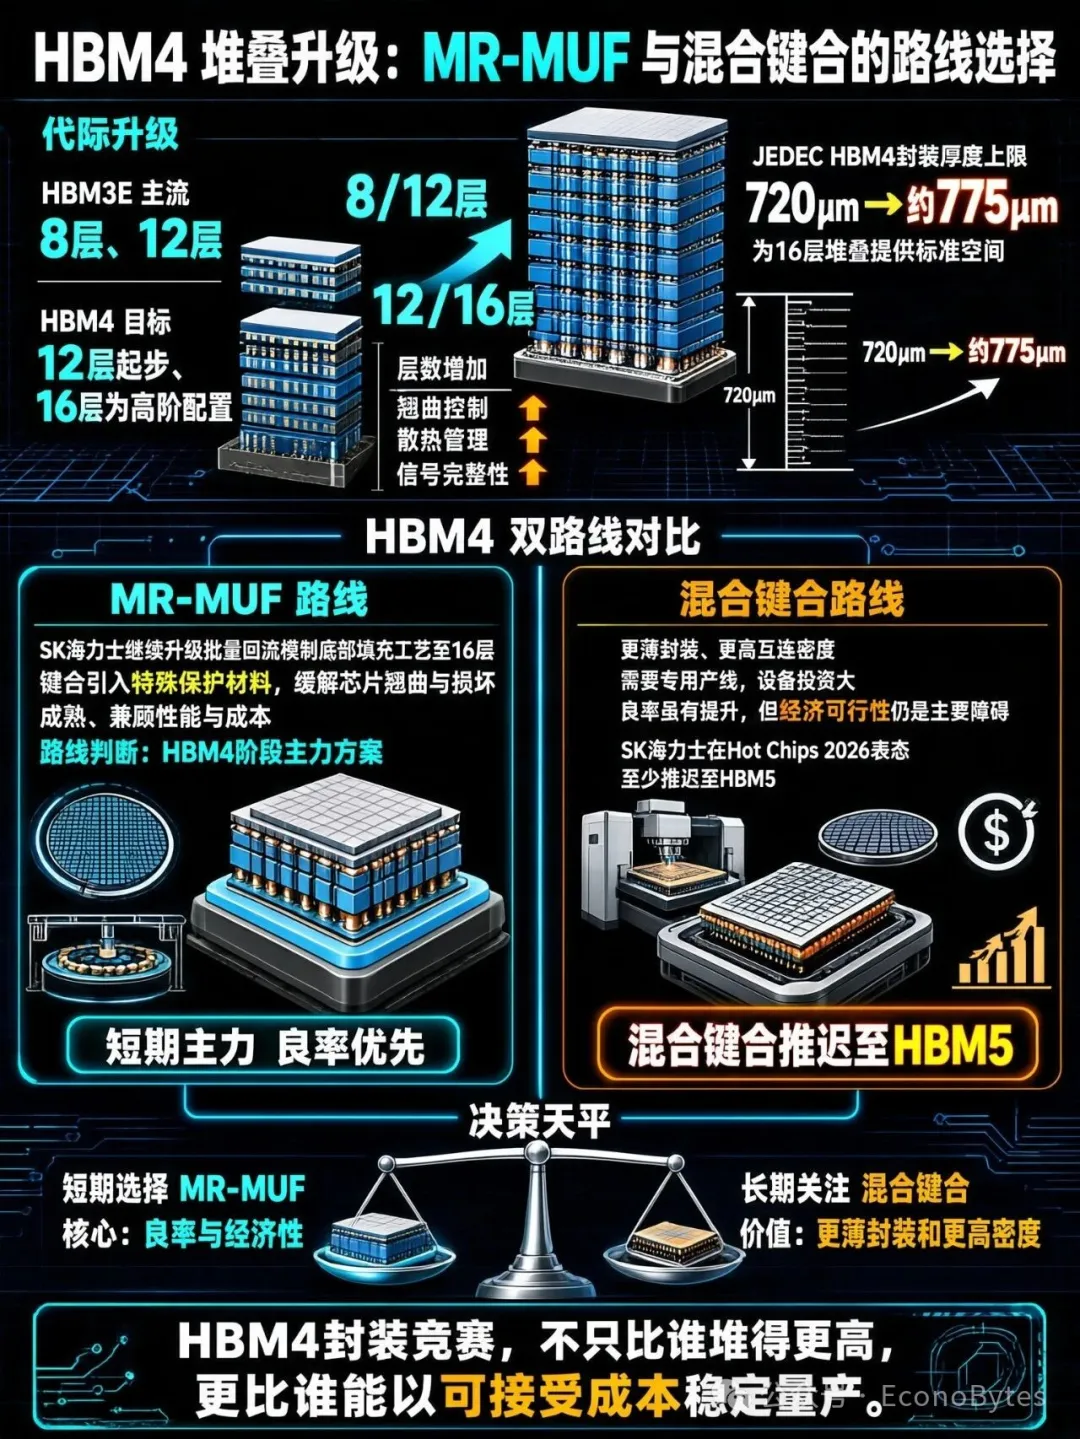
HBM3E主流為8層和12層堆疊,HBM4目標是12層起步、16層為高階配置。JEDEC已將HBM4封裝厚度上限從720µm上調至約775µm,為16層堆疊提供標準空間。堆疊層數每增加一層,翹曲控制、散熱管理和訊號完整性的難度都在上升。
MR-MUF vs 混合鍵合的路線選擇。SK海力士選擇繼續升級MR-MUF(批次回流模製底部填充)工藝至16層,以優先確保良率。MR-MUF通過在鍵合過程中引入特殊保護材料,有效緩解了晶片翹曲和損壞問題,是目前兼顧性能與成本的成熟方案。據SK海力士在Hot Chips 2026上的表態,混合鍵合至少推遲到HBM5。
混合鍵合雖能實現更薄的封裝和更高的互連密度,但需要建設專用產線,裝置投資壓力大。SK海力士技術負責人金鐘勳曾表示,混合鍵合良率較兩年前有所提升,但"經濟可行性仍然是主要障礙"。
良率的經濟學。SK海力士在2026年第二季度業績會上表示,HBM4當前量產良率與品質已達到接近上一代成熟產品HBM3E的水準(注意:官方口徑是"接近",未披露具體數值)。
但16層堆疊的物理複雜度遠高於12層。即便單層良率達到極高水平,16層堆疊後的綜合良率仍面臨乘法效應的考驗。TrendForce指出:HBM3E剛推出時的溢價比例約為20%,而製造難度更高的HBM4溢價幅度預期突破30%。
關鍵洞察:16層堆疊不是"多貼四層"那麼簡單。每一層增加都會放大翹曲、散熱和訊號衰減問題,而MR-MUF工藝的改進空間正在逼近物理極限。
四、技術溢價的第三層:2048位介面與系統級重構
介面位寬翻倍的系統性影響。HBM4將介面位寬從1024位翻倍至2048位,這不是簡單的"通道增加"。更多的通道意味著基底裸片上需要更多的TSV(矽通孔)、更密集的布線、更複雜的電源分配網路。
對GPU/ASIC側而言,HBM4的介面變化也要求晶片設計同步升級。輝達Rubin Ultra平台已從原定的HBM4e 12層方案,轉向平行評估HBM4e 8層、HBM4 12層、HBM4 8層等多種配置——這正說明介面變化帶來的系統適配複雜度。
定製化HBM的產業含義。三星HBM4基底裸片採用4nm FinFET工藝,是記憶體原廠首次將代工級邏輯工藝引入HBM製造。美光的定製NVHBM(為輝達共同開發)則將基底裸片改由外部代工生產——美光認為,雖然增加了代工成本,但這仍可帶來更高平均銷售價格和更好的利潤表現。
定製基底的產業含義在於:HBM正在從"標準品"變成"定製品"。不同客戶可以要求不同的介面規格、不同的頻寬配置、不同的功耗特性——但每一項定製都意味著額外的工程投入和更高的單價。
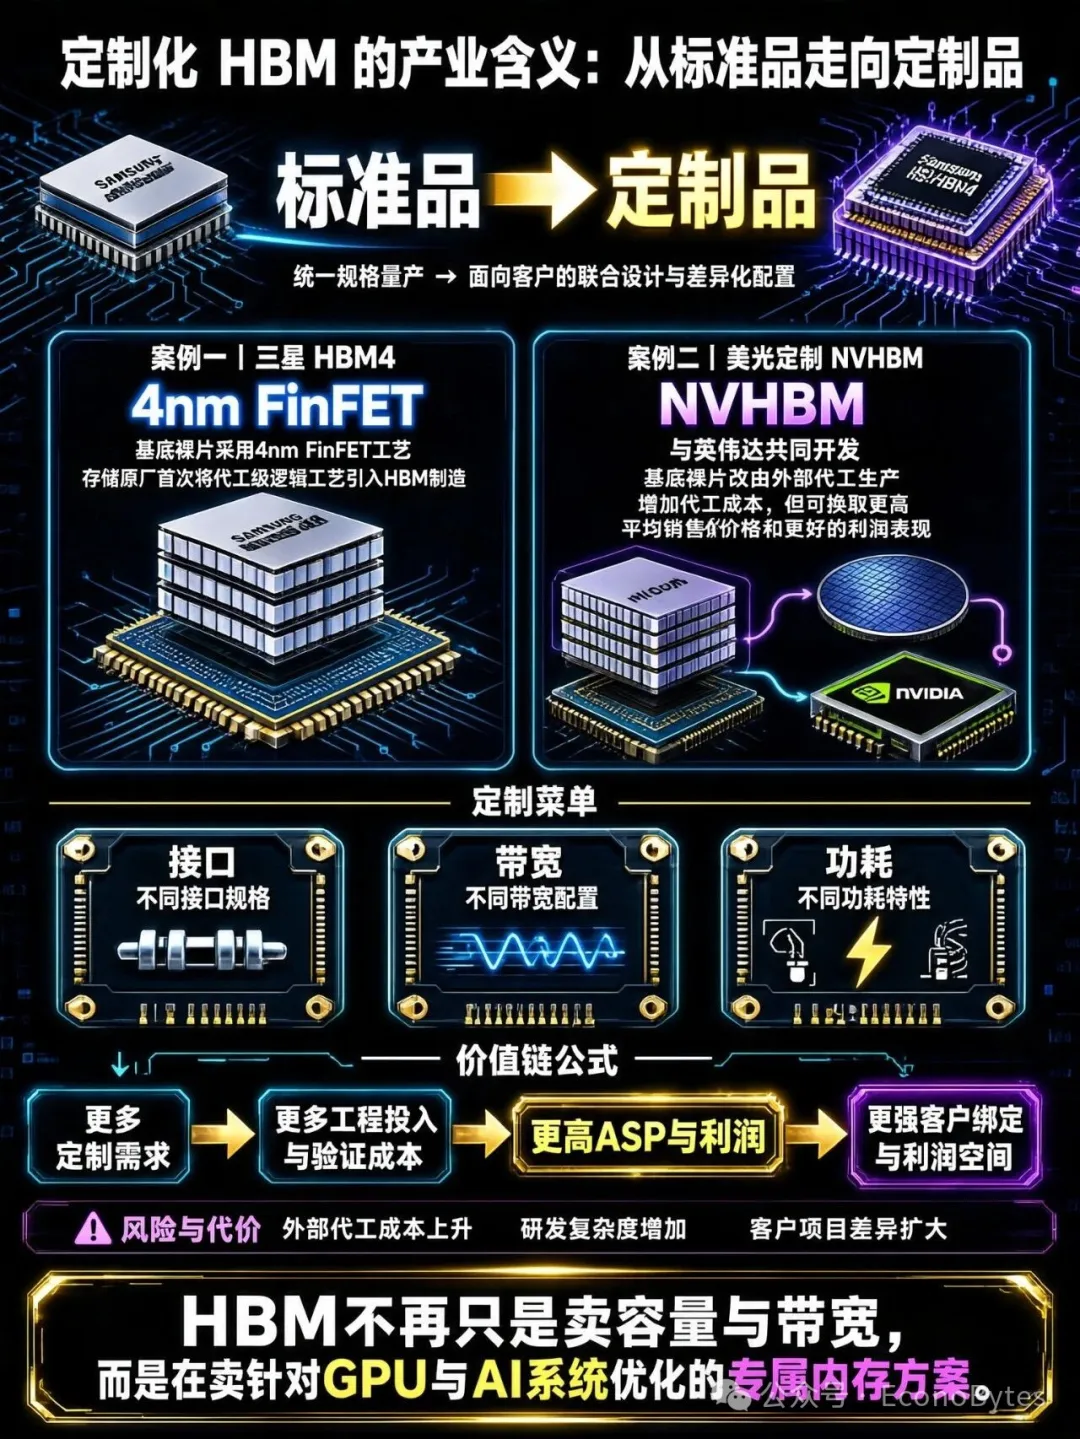
關鍵洞察:HBM4的定製化不是在"賣晶片",而是在"賣系統級的記憶體解決方案"。這解釋了為什麼基底裸片要用代工級工藝——因為它的角色已經從"介面板"變成了"記憶體控製器晶片"。
五、量產進度:三巨頭的賽跑
SK海力士(領跑者的節奏)。2025年9月12日,SK海力士全球率先完成HBM4開發並建構量產體系:頻寬較HBM3E翻倍、能效提升40%、運行速度達10Gbps。HBM4於2025年第四季度開始出貨,2026年第二季度啟動對核心客戶的批次供貨,顯著放量自2026年9月起。HBM4E方面,SK海力士於2026年6月18日向主要客戶供應12層HBM4E樣品(引腳速率最高16Gbps、能效提升20%以上),較原計畫提前。良率方面,SK海力士表示HBM4當前量產良率已接近HBM3E水平。
三星(產能擴張最激進)。三星HBM4自2026年2月全球率先量產出貨,約4個月後(2026年6月)累計銷售額突破10億美元,成為業內首家HBM4銷售額突破10億美元的廠商。2026年5月29日,三星率先向主要客戶交付業內首批12層48GB HBM4E樣品,引腳速度穩定14Gbps、可擴展至16Gbps,性能較HBM4提升20%以上。公司計畫後續推出32GB(8層)和64GB(16層)版本。產能方面,三星HBM整體月均晶圓投片量計畫從2026年的約18萬片增至2027年的約25萬片(增幅近40%)。
美光(爬坡速度最快的追趕者)。美光12層HBM4於2026年第一季度開始量產並出貨,首批為36GB的12層堆疊版本,專為Vera Rubin平台打造;頻寬超2.8TB/s、能效比HBM3E高20%以上。HBM4累計出貨營收已突破10億美元,12層HBM4量產爬坡速度達到上一代HBM3E 12層的兩倍。
關鍵洞察:量產進度的競爭正在從"誰先做出來"轉向"誰做得快、做得多、良率高"。HBM4的競爭本質上是一場產能競賽——誰能更快地把晶圓變成可出貨的堆疊,誰就能在供不應求的市場中拿到最大的份額。
六、需求端:為什麼2027-2028年仍供不應求
高盛的量化判斷。高盛在2026年2月的報告中,將2026、2027年HBM市場規模上調至540億、750億美元,並預計2026-2027年供需缺口保持在5.1%、4.0%的高位。需要說明的是,該機構2026年5月底已進一步將2026/2027/2028年HBM TAM上修至約560億/1160億/1680億美元(三個數字並非出自同一次調整,"2027年750億"為2月舊值,5月已上修至約1160億)。
花旗的判斷更激進:HBM位元需求2027年同比增長62%、2028年增長69%,供需缺口由2027年的-21%擴大至2028年的-36%。
需求驅動力。輝達Rubin Ultra平台的HBM配置,曾在規劃中指向單顆GPU 384GB;但據SemiAnalysis 2026年9月的報導,該配置已從"原規劃的HBM4E 12層384GB"下調至HBM4 8層192GB。Google TPU等AI ASIC的顆數成長,也在放大對HBM位元的需求。美光管理層表示,客戶需求2027-2028年仍遠超供應能力,HBM總潛在市場將從2025年的約350億美元增至2028年的約1000億美元(該里程碑比此前預期提前兩年)。
價格可持續性的判斷框架。花旗認為,HBM4 12hi價格從2026年約2美元/Gb升至2027年4至5美元/Gb,是"反映嚴重供不應求"。三星報價至少4.5美元/Gb,是HBM3E當前價格的三倍以上。HBM4e預計於2027年下半年逐步放量,將進一步抬高加權均價。
關鍵洞察:HBM4的價格曲線不由成本決定,而由供需決定。成本上升解釋了"為什麼貴",但供需缺口解釋了"為什麼能一直貴"。
結語:一道"產能約束下的工程溢價"
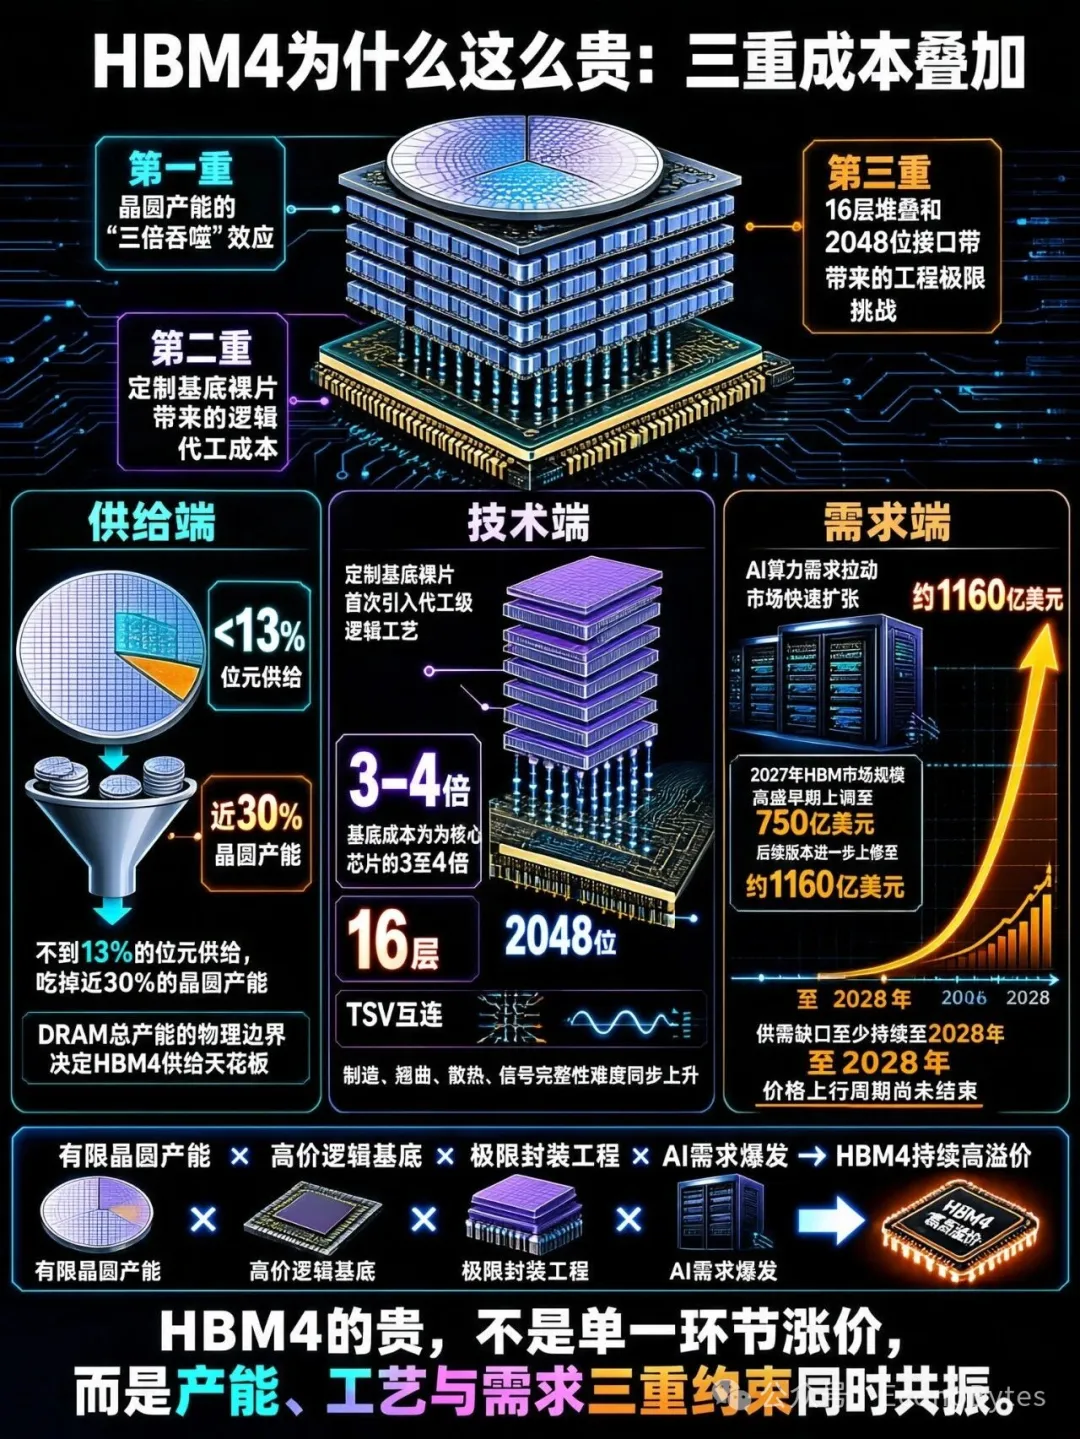
HBM4的貴,是三重成本疊加的結果——晶圓產能的"三倍吞噬"效應、定製基底裸片帶來的邏輯代工成本、16層堆疊和2048位介面帶來的工程極限挑戰。
供給端。HBM以不到13%的位元供給吃掉近30%的晶圓產能,DRAM總產能的物理邊界決定了HBM4的供給天花板。
技術端。定製基底裸片使HBM4首次引入代工級邏輯工藝,基底成本為核心晶片的3至4倍;16層堆疊和2048位介面進一步推高製造難度。
需求端。高盛將2027年HBM市場規模上調至750億美元(後續版本已上修至約1160億美元),供需缺口至少保持至2028年,價格上行周期遠未結束。
對讀者的啟示:跟蹤HBM4的價格,不能只看"漲價幅度",要看三個變數——HBM晶圓投入佔比的提升速度、基底裸片代工成本的下降空間、以及16層堆疊良率的爬坡節奏。這三個變數決定了HBM4的溢價能走多遠。
HBM4的貴,不只是一顆晶片的定價問題,
而是整個DRAM產能體系在AI時代被重新分配的結果。(EconoBytes)