
矽谷大模型不裝了。
過去兩年,說起大模型的“價格屠夫”,沒人會想到Claude。
DeepSeek把百萬tokens的價格打到幾毛錢,逼著國內廠商一輪輪跟降,讓“大模型用不起”成了舊聞,便宜也幾乎成了國產模型的集體人設。Claude則一直站在價格表的另一頭,上一代Haiku 4.5每百萬tokens輸入1美元、輸出5美元,在不少開發者眼裡,屬於好用但不便宜的那一檔。
10月8日凌晨,位置換過來了。Anthropic推出了一款主打日常簡單任務、走低價路線的輕量級模型Claude Haiku 5.5,10萬tokens以內的請求每百萬tokens輸入0.10美元、輸出0.50美元,單價只有上一代的1/10,甚至比國內同為小模型的DeepSeek-V4.1-Flash還便宜。
幾乎同一時間,OpenAI宣佈GPT-6全量上線,付費使用者可使用GPT-6 Sol,免費使用者也能用上GPT-6 Luna。有網友調侃,OpenAI這是要“變豆包”了。
一家降到地板價,一家直接免費,海外兩大巨頭同時對價格動了手。它們圖什麼?0.1美元的Claude、免費的GPT真的好用嗎?當便宜不再是國產大模型的專屬,DeepSeek們手裡還剩什麼牌?
01. Claude比DeepSeek還便宜,是真的
本輪模型廠商的價格戰重心,集中在小模型身上。
旗艦模型通常承擔著模型廠商的品牌與技術上限,定價不宜大改。而小模型以有限的推理成本承接高並行、輕量化任務,是爭奪開發者的入口,也最適合拿來打價格戰。
小模型中,當前最具可比性的三個樣本是DeepSeek-V4.1-Flash、Claude Haiku 5.5與GPT-6 Luna。AI軟體工程師覃相告訴「AIX財經」,三者在設計理念、目標場景與成本結構上高度相似,適合直接對比。
先看定價。
API方面,Claude Haiku 5.5與GPT-6 Luna同價:輸入在10萬以內,每百萬tokens輸入0.10美元、輸出0.50美元。橫向對比DeepSeek-V4.1-Flash,兩家海外廠商在輸入與輸出端均價格更低,即便以後者五折後的非高峰檔計算,結論依然成立。
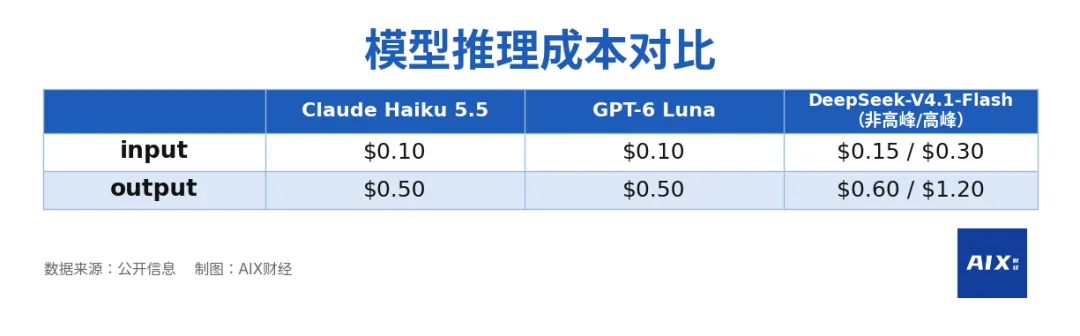
GPT-6 Luna在此基礎上更進一步,OpenAI已將其下放至ChatGPT免費層,C端使用者可零成本使用。
需要說明的是,Haiku 5.5的低價有一個前提,每次傳送的內容不超過10萬tokens。超過這條線,輸入輸出價格均漲為原來的五倍(0.50/2.50美元)。DeepSeek-V4.1-Flash則是一百萬tokens容量內統一計價,不分長短。
如果同一份材料要反覆使用,DeepSeek-V4.1-Flash的快取價0.003美元也低於Haiku 5.5的0.01美元。
我們以一份4萬tokens的產品文件為例,置頂後連續追問,每輪新增提問500tokens、回答300tokens,均按非高峰價計算。
第一輪,文件要寫入快取。按Anthropic的快取寫入價(保留5分鐘為0.125美元/百萬tokens),加上回答,Claude合計約0.52美分;DeepSeek無寫入溢價,約0.63美分。Claude花費更低。
從第二輪起,雙方的文件部分都進入快取價,這時DeepSeek更便宜。同樣一輪,Haiku5.5約0.06美分,DeepSeek約0.04美分,每輪便宜約0.02美分。首輪攢下的優勢,追問幾輪就被追平了。
也就是說,如果是輕度使用,隨手問幾次,Claude是便宜的。如果是重度復用,把文件當知識庫反覆查,DeepSeek的快取價會更有優勢。
帳算清楚了,剩下的問題是:這麼便宜,好用嗎?
Haiku 5.5的定位是執行層模型,摘要、壓縮、分類、資料庫查詢,以及作為大模型的子代理執行子任務,均在其設計範圍內。按Anthropic公佈的基準,其各項維度的表現均強於同等級的GPT-6 Luna。
DeepSeek-V4.1-Flash的發佈基準則集中在另一個方向,DeepSWE v1.1(多檔案軟體工程)74.2、Terminal-Bench 2.1(終端任務)90.6,官方稱在其選定的Agent基準上超過了自家上一代旗艦V4-Pro。
需要注意的是,這些成績都是廠商自報,DeepSeek的成績基於最高推理強度,兩家用的也不是同一套測試,三家之間目前沒有可以直接橫向比較的官方資料。但大模型從業者雲中江樹做過簡單任務的實測,他的感受是,三家小模型水平相似,拉不開差距,能感知的差別在複雜指令上。
綜合現有資訊,可以下一個結論,三家小模型能力差距不大,均能勝任其目標場景。價格上,在“短上下文、API裸價”口徑下,Haiku 5.5與Luna的價格確實降至DeepSeek之下,且Luna對C端免費。
值得一提的是,Anthropic為這一低價設定的適用範圍,恰好是其過往請求分佈的主體,按官方口徑,約90%的Haiku請求傳送內容不超過10萬tokens。也就是說,絕大多數日常用量都落在優惠區裡,0.10美元是Anthropic算過帳的入口價。至於入口之外從那裡賺錢,就要從它的整張價格表來找答案。
02. 把價格打到0,圖啥?
同一張價格表上,一家公司最便宜和最貴的模型,跨度巨大。OpenAI的GPT-6分三檔,最貴的Astra輸入10美元,比Luna貴出百倍。Anthropic也類似,旗艦Fable 5.1輸入10美元,主力檔Opus 5.5輸入4美元,均比Haiku 5.5高出不少。0.1美元與10美元之間,賣的是不同的東西。
先看Anthropic。
第一筆是入門價,不求賺錢。覃相的判斷是,小模型這一檔大機率是微利或保本,但它不是虧錢引流的工具,而是整個商業生態的流量引擎與生態建構抓手。單次呼叫可以不賺錢,但只要呼叫量足夠大、開發者足夠多,使用者就留在這個生態裡,後面訂閱、長文、企業服務這些更貴的收入,才有機會發生。0.1美元/百萬tokens的輸入價格,買的是這張入場券。
第二筆才是收入。入門價讓出去的部分,要靠更貴的檔位賺回來。Haiku 5.5超10萬tokens後,輸出價漲為原來的五倍;Opus一檔的輸入單價是Haiku低價檔的40倍,承接的是長文件、複雜任務這些帳單膨脹的場景。
同一天,Anthropic還宣佈Sonnet5.5的快取讀取價從0.20美元砍至0.10美元。這一刀“砍下去”,主要是為了留存,Claude Code等Agent應用中,系統提示、工具定義與歷史上下文每輪均需重複讀取,快取讀取佔輸入的大頭。對靠它寫程式碼的團隊來說,Agent每跑一輪,這些固定內容都要重新讀一遍,一個月下來,快取讀取往往超過新增內容本身。這次砍的正是帳單裡佔比最大的那塊。低價吸進來的新客要接住,已在付費的老客也要留住。
Anthropic敢這麼降,是因為它的基本盤不在token差價上。它的收入主要是Claude Code帶動的開發者訂閱與企業席位,入門檔就算不賺錢,也能用存量帳戶補回來。
OpenAI的帳,演算法不同。
它是真免費,但有條件。ChatGPT的免費版從來都有,過去跑的是上一代模型,旗艦升級、免費層接舊型號。而這一次,免費使用者拿到的是與旗艦同代發佈的Luna,免費與付費的代際差被抹平了。但成本是可控的,免費層有次數限制,跑的又是小模型,成本壓在低位,卻能拉來使用者。同時,Luna API照收0.10美元的輸入價,說明免費只限於C端,免費使用者消耗的算力,OpenAI可以記在獲客成本裡。
這套分層定價,已經成了海外大模型公司的共識。Google動手最早,旗艦Gemini 3.1 Pro(輸入2美元、輸出12美元),小模型是Flash家族,免費端為Flash-Lite。也正因為有這套多層結構托底,各家才不怕0.1美元的API不賺錢。
國內的情況不太一樣。“國內旗艦雖然也不是完全不收錢,GLM、Kimi這些也賣會員(每月幾十塊),但付費滲透率很低,撐不起營收主體。C端訂閱只是零花錢,主要收入是API與ToB。”覃相表示。
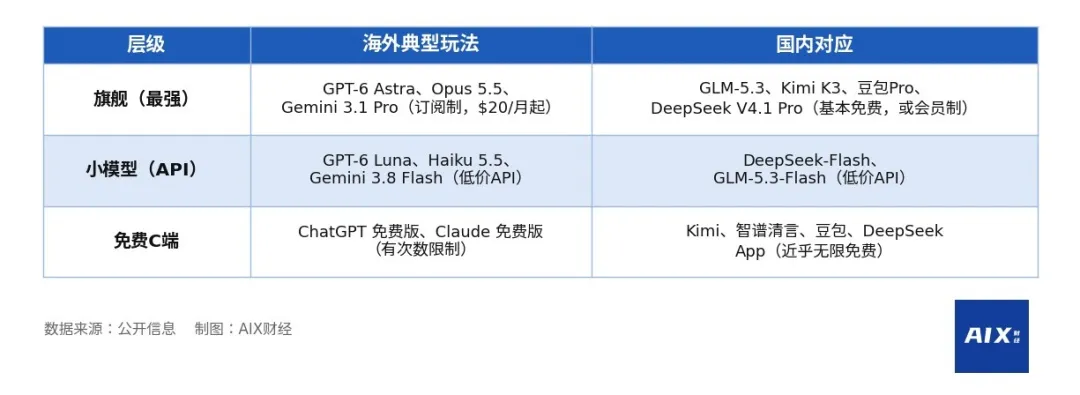
對Anthropic和OpenAI來說,0.1美元是門檻,門檻後面還有別的收入。但到了國內廠商這裡,能不能也成“門檻”,取決於除了裸價之外,它們手裡還有沒有別的牌。
03. 海外低價潮下,國內頭部模型怎麼接?
綜合幾位從業者的判斷,牌有沒有,要分國內、海外兩個市場來看。
在國內,影響有限。價格只是使用者決策的一個因素,海外低價能奪走的,主要是價格敏感型使用者。
多位從業者表示,DeepSeek在國內的地位短時間內不會被動搖,原因有三點。一是中文語境的優勢;二是Claude在中國境內未提供服務,接入不穩定,實際使用成本遠高於官網標價;三是國內企業大量需求是私有化部署與微調定製,這是閉源模型進不來的市場。雲中江樹的體驗是,在國內,綜合使用成本更低的仍然是DeepSeek。
國內其他幾家大模型廠商的處境各不相同,短期來看,各有各的壁壘。
千問同走開源路線,是Hugging Face上衍生模型數量最多的開源家族之一,微調、部署的工具鏈最為成熟,開發者生態是它的護城河。豆包背靠字節的流量與廣告變現體系,靠C端免費做到國內使用者規模最大的AI原生應用,免費對它來說本就是獲客手段。Kimi押注長上下文,能讀長文件的心智在國內仍屬獨一份,但如何把這份心智變成收入,是它自己的待解題。智譜深耕ToB,政企客戶與私有化交付構成基本盤,海外閉源廠商降價擠不進這個領域。
但在海外,壓力是真的。
Haiku 5.5會分流一部分原本傾向DeepSeek的開發者。覃相的判斷代表了一部分受訪者的看法,它確實帶來了壓力,但可能沒那麼大,因為海外同樣存在大量私有化部署與定製化需求,開源生態(如DeepSeek開放權重)能承接這部分需求,這是閉源API給不了的護城河。
那麼接下來怎麼接?從業者的答案類似:拼價格意義不大,更重要的是補結構。
一方面是補分層,建立旗艦+小模型+免費端的三層結構,讓旗艦敢於定價、小模型走量、免費端做滲透;另一方面是放大開源。閉源低價不可避免,但開源生態、私有化部署、定製化服務,是國內廠商手裡唯一不依賴裸價的牌。
但國內廠商真要照搬三層結構,也有幾個卡點。
首先是C端很難收費。在國內,免費已經是使用者的默認預期,誰先收費,誰就可能先流失使用者。海外使用者為軟體訂閱付費的習慣更成熟,國內廠商要在先免費鋪開之後再收費,難度大得多。
其次是缺少一個能撐起訂閱的產品。Anthropic敢在小模型上讓利,背後有Claude Code帶來的開發者訂閱和企業席位兜底。國內各家的程式設計工具和會員產品還在起步階段,訂閱收入還托不住入門價的補貼。
各家離補齊的距離也不一樣。
豆包底子最好,C端滲透已經基本完成,且已經在推行會員訂閱;Kimi缺在獨立的輕量模型,7月它用開源旗艦K3打了一輪技術牌,但當對手都在不斷降價,缺乏低價獨立小模型的產品線,可能將大批開發者拒之門外。值得注意的是,小模型並不需要獨立的研發線,行業通行的做法是旗艦蒸餾,邊際成本遠低於一次旗艦迭代,Kimi缺的並非能力,而是優先順序排序。
DeepSeek的API這一層最完整,Flash檔、非高峰半價、開源權重都在,缺的是給C端講一個收費的故事;智譜是另一種情況,免費端有清言、訂閱有會員和Coding Plan、B端有私有化部署,三層都具備,但清言的使用者規模與豆包、DeepSeek存在明顯差距,三者之間沒有形成有效協同。
海外廠商敢把0.1美元當門檻,是因為門檻後面還有訂閱、快取、工具與企業服務這幾份收入。如今小模型變成入口,token差價不再是利潤主體,國內廠商真正要補的,是門檻背後那套收錢的結構。 (定焦One)