
TPU 實測挑戰 Blackwell 推理定價,DeepSeek 衝刺科創板,國產大模型邁入資本化周期
2026-09-13 · 閱讀約 8 分鐘
推理成本 / TPUv7 $0.181 每百萬 token | 每美元產出 vs B300 +96% FP8 · 低並行 | DeepSeek 估值 5,000億 最新一輪 | 中國 AI 模型收入 8,790億 2030E · API+訂閱 |
9 月初,AI 算力市場一件看似純技術性的事悄然發生——獨立第三方機構 SemiAnalysis 通過其 InferenceX 平台,發佈了首份針對Google TPUv7 Ironwood 的第三方推理性能測評。結果指向一個被 AI 圈壓抑許久的問題:輝達主導的推理定價,正在被撬動。
幾乎同期,國內的另一條新聞與這條形成共振——9 月 9 日,DeepSeek 被證實已委託中信證券籌備科創板 IPO,正式進入盡職調查階段。一邊是晶片定價權的悄悄換防,一邊是國產大模型的資本化開閘。兩條看似平行的線,在 2026 年秋天 撞到了同一個交叉點:AI 產業從「燒錢研發」走向「用商業回報證明價值」的拐點。
一、TPU 實測:撬動輝達推理定價的第一份第三方證據
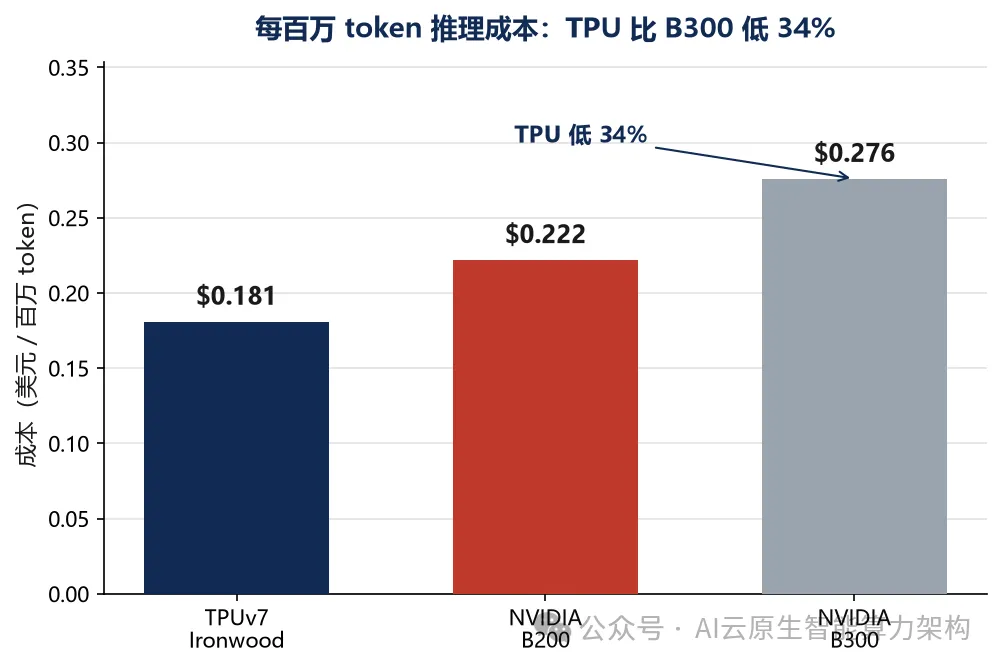
2026 年 9 月 7 日,半導體研究機構 SemiAnalysis 通過其 InferenceX 平台,發佈了首份針對 TPUv7 Ironwood 的第三方推理基準測試。測試模型選用了開放權重的 Qwen3.5 397B FP8,輸入 8K、輸出 1K,Ironwood 與 NVIDIA B200、B300 在外部總擁有成本(TCO)口徑下被逐項對比。
這是 TPU 第一次在公開模型、主流推理框架(vLLM / SGLang)下接受外部獨立測算。在過去十多年裡,TPU 長期只是 Google 內部運行 Search、Ads、YouTube、Gemini 的專用基礎設施,外界既看不到、也很難復刻它的真實推理性價比——而這次的結果,第一次讓市場有了可比的對照系。
1.1 核心資料:每百萬 token 成本、每美元產出、首 Token 延遲
| $0.181 | |||
| 9,364 tok/s | |||
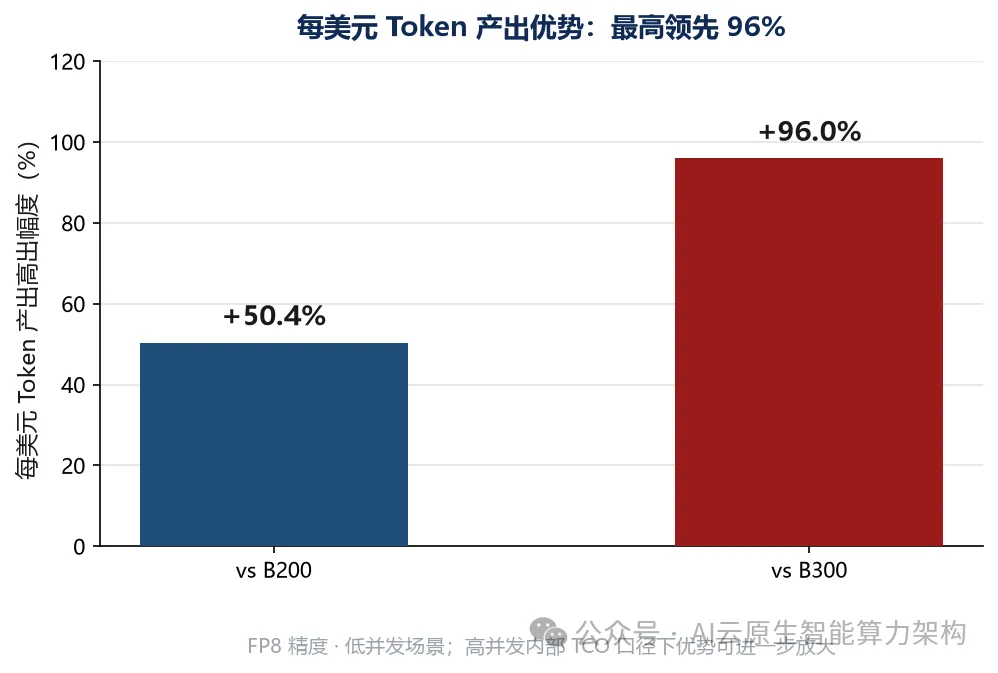
| 基準 | +50.4% | +96.0% | |
| $0.098 | |||
| $1.21 |
表 1 · SemiAnalysis InferenceX 測試核心結果(資料來源:SemiAnalysis,2026-09-07)
1.2 經濟帳解讀:50% 的領先不是來自「更快」,而是來自「每瓦」
如果只看物理算力,Ironwood 並沒有全面壓倒 Blackwell:單晶片峰值 FP8 算力(4.6 petaFLOPS)、記憶體頻寬(7.4 TB/s)、互聯頻寬(9.6 Tbps ICI)大致與 B200 同量級,NVIDIA 仍然在單晶片互聯頻寬上領先(14.4 Tbps NVLink vs 9.6 Tbps ICI)。
真正改變格局的是 每小時晶片成本:在外部 TCO 口徑下,TPU 單顆 $1.21、B200 $1.73、B300 $2.26。Ironwood 的原始吞吐比 B200/B300 高出約 5%,再疊加 低於對手 30%–46% 的單位時間成本,最終在「每美元 Token 產出」這一商業指標上拉開了 50%–96% 的差距。換句話說:這場價格戰的關鍵不在「誰更快」,而在「每美元能買多少 token」。
更激進的邊界測算來自 Google 內部 TCO:若按內部每小時 $1.03 的晶片成本計算,在高並行場景下 Ironwood 對 B200 的優勢可放大到 76.7%,對 B300 可達 130.2%。這一數字意味著,對規模化的推理服務商而言,算力採購合同每延期一年,成本曲線就被對手悄悄拉開一代身位。
但商業判斷不能只看峰值。SemiAnalysis 同時指出三條 「邊界條件」:
第一,Ironwood 尚不支援原生 FP4,在 FP4 精度下 NVIDIA 仍能保持領先;
第二,在高並行 256 的極端場景下,Ironwood 的中位首 Token 延遲被拉到 5.41 秒,而 B300 僅 2.40 秒;
第三,GB300 NVL72 的分離式 Prefill/Decode 服務在中等延遲區間仍有約 30% 的每美元性能領先——而 Google 內部這一能力尚未完整對外。
1.3 軟體棧變數:TorchTPU 與 vLLM/SGLang 的戰線
硬體層之外的真正變數,是軟體棧。AI 開發生態的核心節奏由 PyTorch、vLLM 和 SGLang 共同決定,而 TPU 長期使用 JAX/XLA——舊的 TorchAX 方案需要把 PyTorch 程式碼先翻譯成 JAX 再交給 TPU 執行,多了一層轉換、多了一層模型發佈日(Day-0)適配的延遲。
Google 即將在 10 月開放原始碼的 TorchTPU,把 TPU 直接接進 PyTorch 裝置體系——開發者可以像呼叫 CUDA 裝置一樣,通過 .to("tpu") 直接跑模型,底層仍由 XLA 和 Pallas 接管。這意味著 vLLM、SGLang 在模型發佈當天就能跑在 TPU 上,原來阻礙 TPU 滲透的「接入摩擦」將被顯著壓縮。
但這並不意味著 TPU 「拿來即用」。Ironwood 採用 256×256 MXU 脈動陣列,對模型 Shape 極為敏感——Llama 3 8B 的 Attention Head Dimension 為 128 時,理論矩陣利用率最高也只有 50%。Google 已經用 Qwen3.5 397B 做 TorchTPU 的首發適配,後續計畫支援 Kimi K3、GLM 5.3 和 Gemma4——國產開源模型的適配速度,將直接決定中國大模型客戶向 TPU 遷移的真實節奏。
1.4 Google 的戰略轉身:從「自用」到「對外銷售」
更值得關注的,是這次測評分背後的商業模式切換。Anthropic 已承諾使用超過 100 萬顆 TPU:其中約 40 萬顆直接採購、60 萬顆以上通過 Google Cloud 租賃;預計到 2029 年,Anthropic 的 TPU 使用量將超過 DeepMind 自身。這是 TPU 歷史上第一次出現「外部客戶規模大於 Google 內部」的局面。
而在叢集層面,Ironwood SuperPod 可擴展至 9,216 顆晶片,聚合算力達 42.5 FP8 ExaFLOPS,並通過 3D Torus 網路配合 Optical Circuit Switch 持續擴展。下一代 TPUv8i(代號 Zebrafish) 將原生支援 FP4,並把網路跳數從 16 降到 7、ICI 頻寬翻倍至 19.2 Tb/s、片上 SRAM 翻三倍至 384MB——專門為推理、MoE 和 Agent 設計。這才是 Google 與輝達 Rubin NVL72 對壘的真牌。
故事的底層邏輯也在這一段重新寫:過去十年,輝達的護城河是「晶片性能 × CUDA 生態 × vLLM/SGLang 適配速度」三位一體;今天,Google 第一次在外部推理平台上同時拿出了 「可比的硬體成本 + 原生 PyTorch 接入 + 大客戶背書」 這套組合。輝達主導的推理定價,第一次遇到了體系化的替代者。
二、DeepSeek 衝刺科創板:國產大模型的資本化拐點
9 月 9 日,據 21 世紀經濟報導,DeepSeek 已委託中信證券籌備科創板 IPO。記者從知情人士處獲悉該消息屬實,中信證券已進入盡職調查階段,但雙方尚未簽訂正式的上市輔導協議。這是 國產大模型公司第一次以獨立身份走向公開市場,也是國產 AI 產業資本化處理程序裡極具標本意義的事件。
2.1 一份不算激進的商業底牌
| 約 4.75 億元 | |||
| 44.6% | |||
| 82.9% | |||
| 約 110 億元 |
表 2 · DeepSeek 關鍵商業指標(資料來源:The Information、21 世紀經濟報導)
最值得停留的一行,是 API 業務毛利率 82.9%。在大模型公司普遍燒錢換增長的敘事裡,這是一條反向資料——它意味著 DeepSeek 的「單位 Token 經濟」已經不是 PPT 上的假設,而是已經被 真實的成交訂單 驗證過的財務事實。
但另一面同樣真實:4.75 億元營收對應淨虧損 7.15 億元,AI 基礎設施支出 110 億元遠超同期收入。這是一家「單位經濟成立但規模經濟未達成」的公司——商業邏輯被驗證,規模化還在路上。
2.2 一條特殊的資本通道:科創板第五套標準擴到 AI
DeepSeek 這次能走 IPO 這條路,關鍵不是公司本身,而是 2026 年 6 月 17 日證監會的一次政策鬆綁——陸家嘴論壇上,證監會主席吳清宣佈將科創板第五套上市標準的適用範圍擴大至人工智慧領域,不再要求盈利,也不要求大規模收入。
這一條政策改變的是 AI 公司的估值錨。在過去,資本市場衡量一家 AI 公司,要麼按 PE(淨利潤)要麼按 PS(收入),而 DeepSeek 的現實是——淨虧損 7.15 億元、營收 4.75 億元、估值卻高達 5,000 億元。這種「未來曲線」型的估值,過去在 A 股並不容易找到定價基準。
從時間表上看,輔導備案流程原則上不少於三個月——記者目前尚未在浙江證監局官網查到深度求索的備案資訊。換句話說,DeepSeek 距離遞交 IPO 申請的時間窗口,是以天計的。公司需要在這條政策窗口關閉之前,把材料、估值、合規全部落地。
2.3 融資與估值:一千億資金背後的商業敘事切換
再看 DeepSeek 過去半年的融資路徑:
- 2026 年 4 月啟動首輪外部融資;6 月完成交割,募資超 510 億元,投後估值近 4000 億元。創始人梁文鋒以個人名義出資約 200 億元,是本輪最大單一出資方;騰訊約 100 億元,寧德時代體系約 50 億元,網易、京東、Monolith 礪思資本、IDG 資本各約 30 億元,正心谷、拾象科技各約 15 億元,國家人工智慧產業投資基金約 9.8 億元。
- 2026 年 7 月中旬啟動第二輪融資,擬以 7,400 億元估值尋求籌集 80 億美元;並同步開啟 IPO 籌備對接,新晉入局方包括中芯聚源、博裕資本、合肥國資投資平台等。
兩輪累計,DeepSeek 在公開口徑下已募集超過 1,000 億元。帳上並不缺錢,那 IPO 的動機到底是什麼?路透社與 21 世紀經濟報導給出了三個一致答案:算力基礎設施、模型與晶片自研、核心人才激勵。其中「留人」可能最急——報導披露 DeepSeek 近期持續被字節、小米等資金更厚的對手挖角,300 人團隊一次性擴招 150 個新崗位,相當於現有團隊半數。
2.4 開源生態:把護城河反推到對手那一邊
DeepSeek 選擇的資本化路徑,與 OpenAI、Anthropic 完全不同——它用開源協議 + 高性價比模型 + 開放社區,把「生態鎖定」反推到閉源對手那一邊。當一家中國大模型公司以低於對手 50% 以上的 API 價格對外提供服務,同時讓模型權重和訓練方法在社區裡持續擴散,它建構的護城河不再是「獨門模型」,而是「獨門生態規模」。
這條路徑的產業意義在於:隨著 Qwen、Kimi、GLM 等國產開源模型被全球開發者基於二次開發,「國產大模型」就從「一家公司」變成「一個生態」。下游應用一旦基於國產開源模型建構,從晶片選型到推理框架,從部署工具到社區支援,遷移成本就構成了真實壁壘。
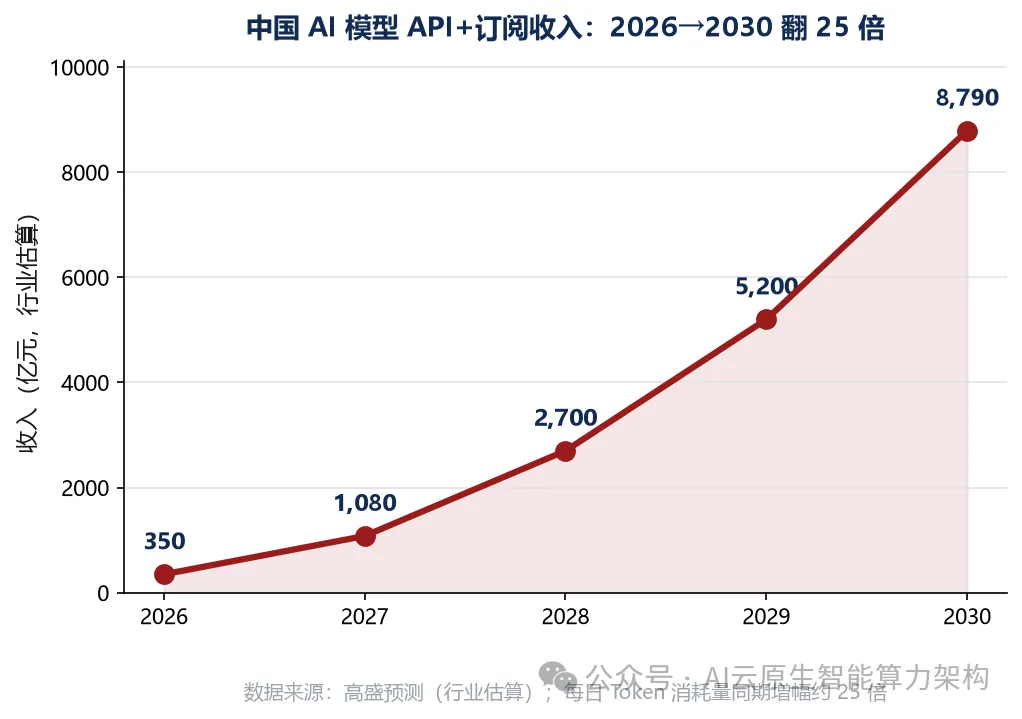
高盛預測給出了這條邏輯的市場規模錨:中國 AI 模型的 API 與訂閱收入將從 2026 年的約 350 億元,增長到 2030 年的約 8,790 億元,每日 Token 消耗量同期增幅約 25 倍。換句話說——「單位經濟已被驗證 + 政策窗口剛剛打開 + 算力成本正在下行」三件事同時發生,國產大模型第一次有了一張可以拿到公開市場上講的「未來現金流折現」的商業故事。
三、商業機遇與挑戰:正反兩面同時展開
3.1 賽道邏輯的四個增量
第一,單位推理成本的下行。TPU 把每百萬 token 成本壓到 $0.181 量級,原本「燒不起」的中長尾應用場景——Agent、客服、辦公協同、行業知識庫——變成了「跑得起」。在 DeepSeek 82.9% 的 API 毛利率背後,是這條成本曲線對商業模型的二次放大。
第二,資本化路徑的打開。科創板第五套標準的擴圍,把 AI 公司從「賭研發投入」拉到了「賭商業化兌現」的賽道上。資本市場將開始用「收入 × 增速 × 毛利率 × 生態繫結」的多維度模型給國產大模型定價,估值錨開始具備工業化的可解釋性。
第三,開源生態的防禦性壁壘。DeepSeek 用開源 + 高性價比組合,把下游應用、晶片適配、社區開發都拉到自己的節奏裡。開放原始碼的護城河不在「程式碼」,而在「開發者心智 + 工具鏈慣性 + 遷移摩擦」。
第四,算力與模型全端國產化的產業級機會。推理市場打開 = 國產晶片、國產雲、國產框架、國產模型、國產應用整條產業鏈都有增量。從底層硬體到上層 Agent 工具,每一個環節都在被重新定價。
3.2 不能迴避的四個風險
第一,商業化變現仍非坦途。DeepSeek 4.75 億元營收對應 7.15 億元淨虧損、110 億元算力投入,意味著商業模型還沒有跨過盈虧平衡線。9 月 10 日即將發佈的 V4.1 Flash,快取命中價降 50%、輸入未命中價降 60%——收入端的邊際價格在快速被壓縮。
第二,行業同質化競爭加劇。智譜、月之暗面、MiniMax、阿里通義、字節豆包、騰訊混元等多家齊頭並進,模型能力差距在公開榜單上持續收斂。當所有玩家的技術指標都接近,差異化路徑越來越窄,價格戰不可避免地向中長尾玩家蔓延。
第三,海外巨頭的體系性競爭壓力。OpenAI、Google、Anthropic 在閉源 + 商業化路徑上仍佔據先發優勢;TPU 的「對外銷售」雖然分流輝達,但同時也在強化「美系算力」的體系性供給。中國大模型的真正護城河,最終要回到「端到端成本 × 場景適配 × 合規與本土化」這一本土化維度上。
第四,資本化預期過熱的回呼風險。5,000 億元估值背後,是市場對「未來現金流折現」的樂觀假設。一旦二級市場情緒轉向——無論是聯準會節奏、A 股流動性、還是國產 AI 營收兌現速度不及預期——估值都會被快速重新定價。DeepSeek 2027 年上市的目標估值區間被機構預測為 1.5 兆至 2.5 兆元,這一區間的兌現,需要未來 18 個月內持續、確定、可被外部審計的商業化資料來支撐。
商業觀察:本輪推理定價權的重新劃分,意味著從「賣算力」到「賣 token」的產業重心轉移。真正能在這一輪吃掉紅利的,是同時具備「晶片級系統能力 + 模型級生態規模 + 商業化兌現速度」三件套的少數玩家。對國產 AI 產業鏈而言,最值得長期跟蹤的不是那家模型榜單分數最高,而是那家能把單位成本、生態規模、商業化進度三項指標同時跑出可見曲線。
四、產業展望:晶片—雲—模型—框架—應用的多層共生
當推理定價權被撬動、當國產大模型走向公開市場,整條 AI 產業鏈正在從「單點巨頭全端」走向「多層共生」。每一個環節的商業邏輯都在被重新改寫:
4.1 上游:算力與晶片的系統級重構
算力晶片層,輝達仍佔絕對領先,但 TPU 第一次在外部推理市場上拿出了體系化的可比方案,國產晶片(華為昇騰、寒武紀、海光、沐曦等)在政策、本土市場需求和國產開源模型的多重推動下加速替代。HBM 與記憶體 隨著推理叢集規模擴大進入持續高景氣階段;互聯與叢集 的邏輯也開始變化——TPU 的 SuperPod 9,216 顆 / 42.5 ExaFLOPS 模式提示整個行業,「系統級算力」正在取代「單晶片峰值算力」成為新的競爭單元。
4.2 中游:雲、模型與框架的標準化
雲服務商的角色正在被重新定義——從單純的 IaaS,走向「模型 + 推理 + 工具鏈」的一體化平台。大模型層 走向開源(DeepSeek、智譜、MiniMax 等)與閉源(OpenAI、Anthropic)的雙軌平行,商業護城河從「模型能力」擴展到「生態規模 × 商業化能力」;推理框架層,vLLM/SGLang 的事實標準化,讓「模型 × 晶片」成為可替換資產——這也是 TorchTPU 一旦開源就能立刻產生影響的根本原因。
4.3 下游:Agent 時代的 Token 消耗結構性擴張
下游場景被算力成本下行持續打開:企業級 Agent、客服、辦公協同、行業大模型(金融、醫療、政務、製造)。當模型從「問答型」擴展到「長任務鏈」,單次任務的 Token 消耗是結構性的躍遷,而非線性的擴張。這意味著算力需求的增長不是周期性的,而是結構性的——它會持續推動上游晶片與中游推理框架同步迭代。
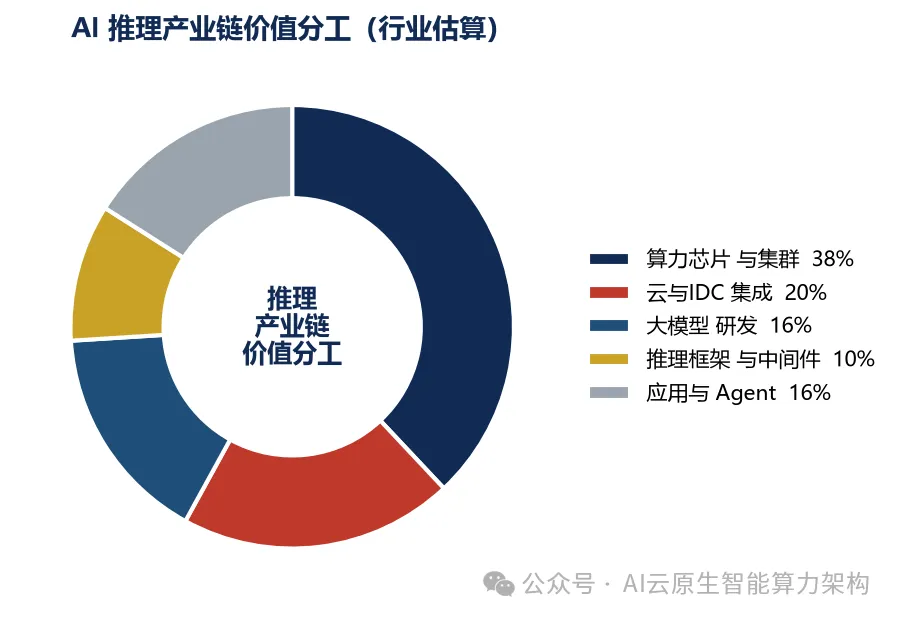
| 算力晶片與叢集 | ||
| 雲與 IDC 整合 | ||
| 大模型研發 | ||
| 推理框架與中介軟體 | ||
| 應用與 Agent |
表 3 · AI 推理產業鏈商業分工(產業分工示例,不構成投資建議)
把這條產業鏈畫清楚,再回頭看本輪兩個事件,含義就會更清楚:TPU 的外部化是在上游重新分配算力定價權,而 DeepSeek 走向 IPO 是在中游為國產大模型提供資本化的標準範式。
兩者並不孤立——它們共同把 AI 產業的商業重心,從「誰能燒得起錢」推向「誰能用更低的單位成本,把 AI 變成一個穩定的、被資本市場認可的商業模式」。
五、寫在最後:從「燒錢研發」到「單位經濟」
在 2026 年的秋天,AI 產業完成了兩個看似不大、實則結構性變化的轉身。一個在晶片端——推理定價權第一次出現「非輝達」的體系化挑戰者;另一個在資本端——國產大模型第一次以獨立的商業化敘事走向公開市場。
把這兩件事放在一起看,傳遞出的產業訊號是一致的:
- AI 產業的競爭,從「參數與榜單」轉向 「單位 Token 經濟(unit economics)」;
- AI 公司的價值評估,從「研發投入與人才密度」轉向 「收入、生態規模與資本結構」;
- AI 產業鏈的分工,從「單一巨頭全端」轉向 「晶片—雲—模型—框架—應用」的多層共生。
這一輪變革不是風口,而是 基礎設施等級的重新定價。當每百萬 token 成本被壓到幾毛錢、當一家大模型公司可以帶著 82.9% 的 API 毛利率走到交易所門口——AI 才真正開始兌現「被講了三年的商業化故事」。
未來五年,看的不是誰家參數更大,而是 誰能用更低的單位成本,把 AI 變成一個穩定的、被資本市場認可的商業模式。推理定價權的換防與資本化拐點的同步發生,已經把這場長跑的賽道規則,重新寫在了 2026 年的這個秋天。 (AI雲原生智能算力架構)