
9月15日,聯發科正式發佈天璣9600 Pro。聯發科首款2nm手機SoC、330億級電晶體、雙NPU架構,直接刷新智能體AI手機體驗上限。
就在天璣9600 Pro發佈會的半個月前,輝達以35億美元認購聯發科可轉債,雙方宣佈將共同打造從邊緣到雲端的AI運算平台。黃仁勳稱這是“輝達規模最大的合作關係之一”,蔡力行則將合作範圍描述為“橫跨超大規模雲端業者ASIC、企業資料中心、新型雲端服務,以及桌上型AI超級電腦”。當一家全球AI算力龍頭用真金白銀確認另一家公司在AI版圖中的位置時,整個行業都會重新打量它。
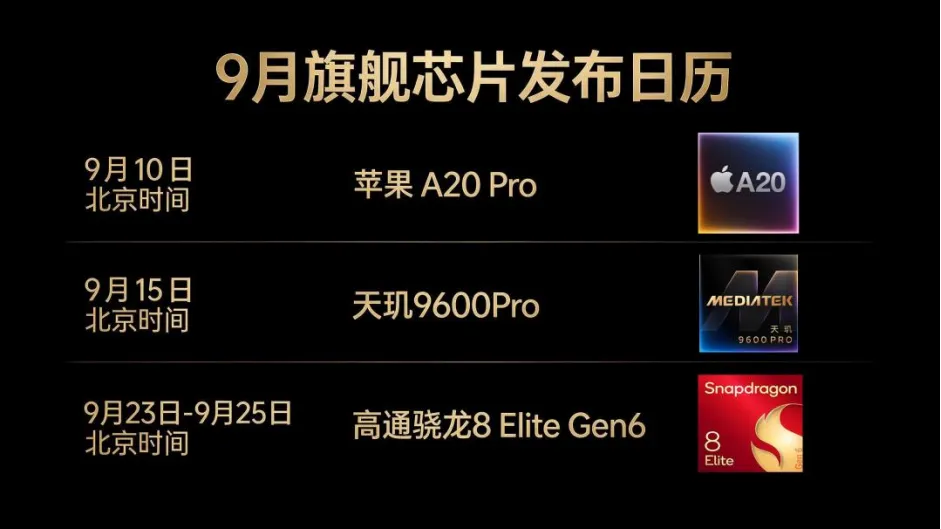
往年的9月,手機圈的聚光燈基本只打向終端廠商。但2026年的秋天不太一樣。這場發佈會的時機很微妙:正值端側AI從概念邁向落地的轉折點。粗略數一下,9月前後確定或大機率亮相的旗艦新機超過十款。多顆旗艦晶片在2nm節點上首次同台,這本身就是個訊號。各自架構不同、設計思路不同,但方向是一致的:峰值性能的差距在縮小,持續性能輸出和整機能耗正在成為新的衡量標準。
天璣9600 Pro的做法是:首款2nm手機SoC把能效拉到一個新高度,雙超大核把多工上限往上頂,神經著色器調度器讓GPU和NPU之間的算力調度不再浪費。三項技術拼在一起,解決的不是某一個單點問題,而是旗艦晶片在高性能和高能效之間怎麼同時做到不妥協。
01 Token經濟爆發前夜,晶片的新考題來了
在發佈會現場,聯發科分享了一個判斷:Token消耗量正在成為衡量AI經濟最重要的指標。2030年,整個Token經濟規模預計達到5000億美元,其中120千兆個Token被消耗。這個數字背後,是三個正在同時發生的變化。
第一,入口在多元化。過去Token主要從雲端送到PC和筆記本,但未來手機和其他終端會越來越多地承擔這個角色。聯發科在發佈會上舉了一個例子:早期網際網路從PC時代轉移到移動網際網路時代,入口從2億台PC擴展到十幾億台手機。入口的多元化,會加速Token經濟的大規模增長。
第二,計算在混合化。過去只有雲端的人工智慧工廠可以產生Token,但接下來,終端和端側產品也會變成人工智慧工廠,加入產生Token的行列。有些Token必須在端側生產,因為傳輸需要時間,也因為有些資料只能留在本地。
第三,使用者群體在擴大。AI使用者正從企業級使用者擴展到普通消費者,從生產力場景擴展到娛樂、社交等更多消費場景。
這三個變化疊加在一起,對晶片提出了一個全新的要求。傳統手機晶片應對的是“使用者點選、應用響應”的一次性算力需求。但智能體AI帶來的是一套完全不同的工作流:感知、記憶、推理、執行,四個環節持續運轉。智能體在後台不間斷運行,任務鏈式展開,頻繁讀寫本地個人資訊,對延遲極度敏感,工作負載還呈現突發性和記憶體密集的特點。這意味著晶片的評價標準變了。從“峰值算力有多高”變成了“多環節協同下延遲有多低、記憶體頻寬效率有多高”。傳統晶片的設計邏輯是“跑分時全力輸出,待機時徹底休眠”,只有兩種狀態。但智能體需要第三種狀態:感知模組一直線上,卻不消耗可感知的電量。
聯發科給出的答案是:手機依然會帶領消費型終端產品實現這場變革。因為手機有替代性優勢、有算力優勢,保有量每年十幾億台,人均使用時長每天五六個小時。但也正因為如此,手機晶片必須為智能體AI從底層重新設計。天璣9600 Pro,正是這一判斷的落地成果。它的核心任務只有一個:為智能體AI在手機上的真正落地,做好硬體層面的準備。
02 AI原生架構,天璣9600 Pro為智能體AI落地做了什麼?
2nm製程的背後,是聯發科與台積電長期的深度協同。但比製程更值得看的,是聯發科在這顆晶片上做了什麼架構層面的設計決策。天璣9600 Pro的核心定義是“全新AI原生架構 重塑智能體驗”。這句話的關鍵詞是AI原生。什麼是AI原生?用聯發科的話說:AI從NPU的一項能力,進入了整個SoC的架構設計。
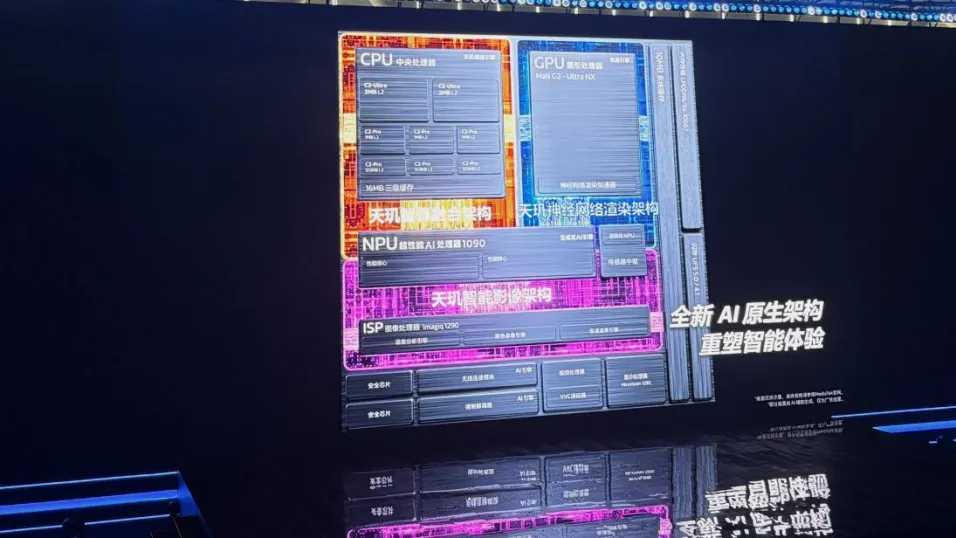
過去,AI是NPU的事,其他模組各幹各的。現在,CPU、NPU、GPU、ISP底層硬體全面升級,NPU參與不同IP的計算,系統級資源協同調度,面向智能體AI重新組織SoC。AI變成了整個晶片的組織原則。而AI原生架構的核心,是雙NPU。兩顆NPU協同,一顆負責高性能推理,一顆負責超低功耗感知,實現功耗與即時響應的平衡。更重要的是,以NPU為核心打通CPU、GPU、ISP等IP之間的隔閡,專為智能體AI重構各IP的協同方式。在這套架構中,NPU主動向CPU請求任務並解讀任務,CPU與NPU共同構成調度核心。
圍繞這個核心,天璣9600 Pro在四個維度上為智能體AI落地做好了準備。
第一個維度是晶片基礎底座。天璣9600 Pro是行業首批採用台積電2nm製程的移動平台,整合330億級電晶體。這個數字對使用者的意義在於:當你依賴手機的隨時感知功能時,電池不會崩。沒有這個能效底座,Always-On就是空談。
第二個維度是CPU架構。天璣9600 Pro採用2+3+3全大核設計,2顆超大核主頻4.55GHz,3顆大核4.35GHz,3顆大核3.1GHz。雙超大核面向AI多載、多工和複雜應用負載。快取總計34.5MB,二級快取較天璣9500提升21%。記憶體和快閃記憶體率先支援LPDDR6和UFS 5.0,LPDDR6性能較LPDDR5X提升33%,UFS 5.0讀寫速度較UFS 4.0提升100%。CPU性能提升的落腳點,不是跑分,而是讓智能體跑得動、跑得穩。
第三個維度是天璣智算融合架構。這是面向智能體AI任務的核心設計,把CPU算力、NPU算力、電源和記憶體統一納入智能調度。算力調度引擎3.0可以預測端側AI的算力需求,動態協調資源,3B大語言模型測試中相同回答出詞速度提升40%。系統級電源管理針對全大核進行微秒級動態電源調度,CPU快開快關速度較天璣9500提升10倍。超級記憶體調度技術支援25個應用加3B大語言模型全保活,3B大模型啟動速度提升27%。
第四個維度是雙NPU。第二代超能效NPU用於智能體AI Always-On、環境感知,功耗較天璣9500降低40%。超性能NPU 1090用於大模型運行與端側推理,大語言模型預填充峰值性能較天璣9500提升51%,支援30B MoE大模型端側運行,ETHZ AI Benchmark 再次登頂霸榜。兩個NPU各司其職,高性能場景全力輸出,常駐感知場景極致省電。配套的天璣智能化AI引擎3.0已經形成“硬體、系統、開發工具、生態”的完整鏈路。
除上述四大維度之外,天璣9600 Pro在GPU、ISP和通訊方面也有明顯升級。GPU方面,G2-Ultra NX旗艦GPU在3DMark Steel Nomad Light同功耗下性能提升18%,峰值功耗下降24%。天璣神經網路渲染架構讓GPU和NPU協同進行AI渲染,《王者榮耀》原生720P可超分至1080P。移動光追方面,第三代光追引擎Solar Bay Extreme光追性能較天璣9500提升18%,行業首發Ray Tracing Pipeline落地。ISP方面,全焦段計算光學影像實現業界首發微單級全景深計算光學影像,60FPS專業運動追焦速度較天璣9500提升2倍。通訊方面,天璣通訊AI開放平台讓AI響應速度提升10倍、功耗降低50%,AI蜂窩選網2.0讓卡頓時長較天璣9500下降30%。
03 跑分榜上的冠軍,用起來也要做冠軍
跑分不等於體驗,這是行業說了很多年卻始終沒有真正解決的問題。每年新旗艦發佈,安兔兔、GeekBench的分數一輪比一輪高,但使用者拿到手之後真正在意的事情是:遊戲會不會掉幀、續航能不能撐住一天、AI助手到底有沒有用?天璣9600 Pro這次給出了一個更徹底的答案:當晶片的製程和架構越來越趨同,真正的分野在於誰更懂“使用者體驗”這四個字。今年聯發科的發佈會,極限性能跑分已經不是特別重點,現場更多的是聊功能、聊場景、聊體驗,相信在這樣爭“體驗之王”的敘事框架下,量產機會最佳化出更優的表現。
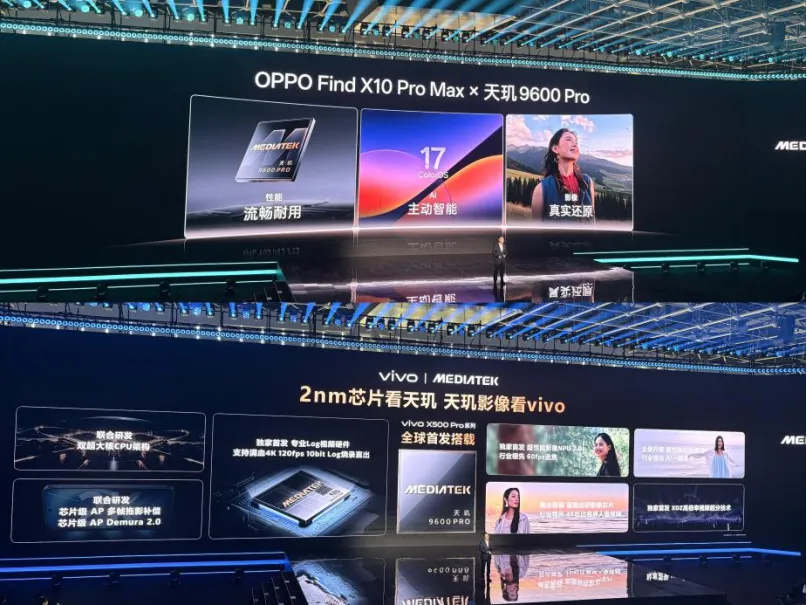
天璣9600 Pro的發佈就是一個訊號。vivo X500系列已確認全球首發,OPPO Find X10系列緊隨其後。兩大頭部廠商的同步匯入,足以說明行業對聯發科旗艦晶片能力的認可。廠商選擇晶片,看中的從來不是跑分數字,而是這些數字最終能轉化成什麼樣的使用者體驗,這種認可最終會落到使用者能真切感受到的場景裡。
遊戲是最直接的檢驗場。雙超大核讓多載場景不再有“卡頓一秒”的等待:雙NPU架構分工協作,一顆負責遊戲主線程渲染,一顆處理後台AI推理或網路同步,互不干擾。天璣9600 Pro在《明日方舟:終末地》中做到平均59fps,相同影格率下功耗較上一代下降30%。這意味著長時間遊戲不再燙手,也不會因為發熱降頻突然掉幀。對於手遊玩家來說,穩定比峰值更重要,而穩定恰恰是跑分測不出來的。
續航是另一個使用者每天都要面對的問題。2nm製程帶來的能效躍遷,讓日常使用下的電池表現有了明顯延長。但更關鍵的是天璣智算融合架構在後台做的調度:它能在你刷短影片時把功耗壓到最低,在你啟動AI任務時瞬間拉滿算力,整個過程不需要使用者感知。晶片的快開快關速度較天璣9500提升10倍,25個應用加3B大語言模型全保活的情況下,大模型啟動速度依然提升27%。在天璣9600 Pro 上,使用者不需要知道這些技術細節,只會感受到後台掛著一堆應用,手機也不會卡。
AI體驗的變化更值得展開。雙NPU和天璣AI智能體化引擎3.0的配合,讓AI助手不再是你問一句它答一句的被動工具。第二代超能效NPU讓AI可以在極低功耗下常駐運行,持續感知環境、理解情境,在合適的時機主動提供服務。具體來看,視訊一鍵高光聯合vivo,利用超性能NPU在端側運行多模態大模型,自動識別視訊中的高光時刻並一鍵生成專屬回憶,使用者不需要自己一幀幀去剪;靈感構圖聯合OPPO,通過低功耗常駐AI即時識別拍攝場景、自動最佳化構圖,讓拍照這件事從你找角度變成它幫你找角度。聯合OPPO,以天璣AI智能體化引擎3.0賦能小布主動識別要緊事並及時提醒,不是等你問,而是它覺得你需要知道。30B MoE數字分身與千問深度合作,依託超性能NPU在端側運行30B MoE大模型,把過去只能在雲端跑的大模型能力搬到了手機上。
這些案例有一個共同點:AI不再是一個需要使用者主動打開的功能,而是變成了手機底層持續運行的能力。使用者感受不到AI在後台做了什麼,但能感受到手機越來越懂自己。這種體驗層面的變化,不會出現在任何跑分榜單上,卻是使用者每天都能感知到的差異。而支撐這一切的,正是天璣9600 Pro從一開始就為智能體AI設計的AI原生架構,不是後來加上去的AI功能,而是從晶片底層長出來的智能體能力。
04 結語:把選擇權交給體驗
旗艦晶片的實力,最終要由終端產品來檢驗。頭部廠商的選擇,比任何跑分資料都更能說明問題。
聯發科在旗艦市場走到今天這一步,靠的不是那一代產品的爆發。天璣9300率先放棄小核的時候,很多人覺得冒險;天璣9500首推雙NPU的時候,也有人觀望。但三代產品走下來,路線圖其實一直很清晰:不跟對手的節奏,按自己對使用者需求的理解來做晶片。這條路走了三代,從“別人不信”走到“別人必須跟隨”。
晶片競爭不再只圍著製程和跑分打轉,製程紅利遞減,跑分的說服力在減弱,峰值性能也難以形成碾壓優勢,對終端需求的理解,才是新的分水嶺。聯發科對這件事的理解,從三年前就開始了,天璣9600 Pro只是途中一站,遠非終點。 (半導體產業縱橫)