
AI算力的競爭,早已不止GPU的比拚。
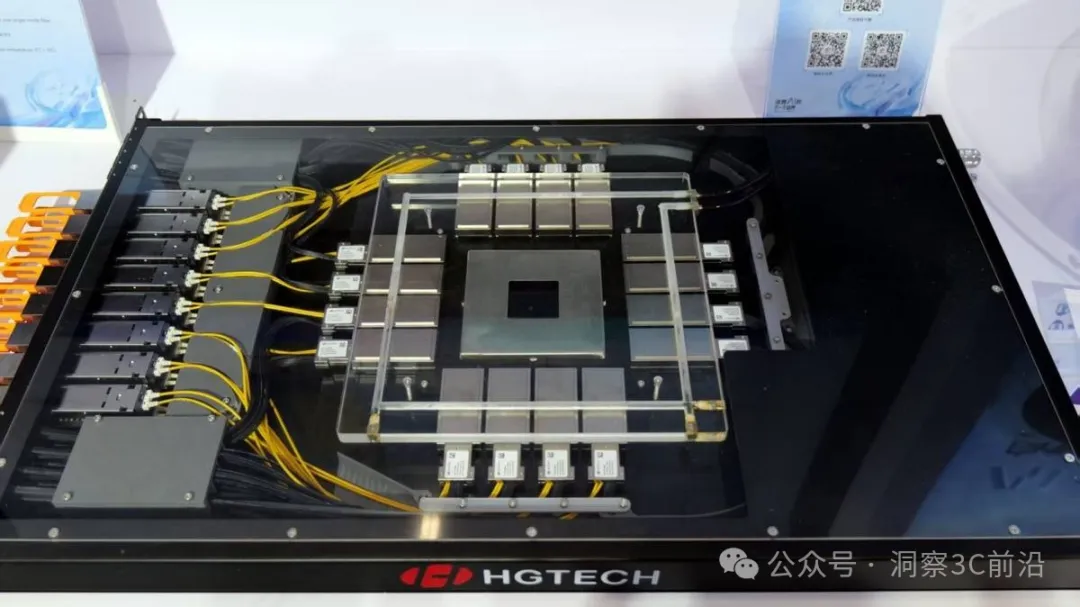
當單卡算力突破瓶頸,晶片與晶片之間、算力叢集之間的高速互聯,成為制約AI訓練、大模型迭代的核心命脈。誰能解決高頻寬、低時延、低功耗的互聯難題,誰就能掌握下一代算力叢集的話語權。
在萬眾期待的CPO共封裝光學技術遲遲難以大規模量產的當下,一條更務實、更落地、更快商用的技術路線強勢突圍——NPO近封裝光學,正式邁入規模商用前夜。
2026年四季度,騰訊、阿里等頭部雲廠商率先啟動NPO超節點試點部署;行業產業鏈明確預判,2027年將成為NPO規模化商用元年,徹底改寫AI光互連行業格局。
01. 介於傳統模組與CPO之間,NPO是最優解
很多人疑惑,既然有更先進的CPO技術,為什麼行業集體押注NPO?
核心答案:CPO是遠期終局,NPO是當下唯一可行的落地方案。
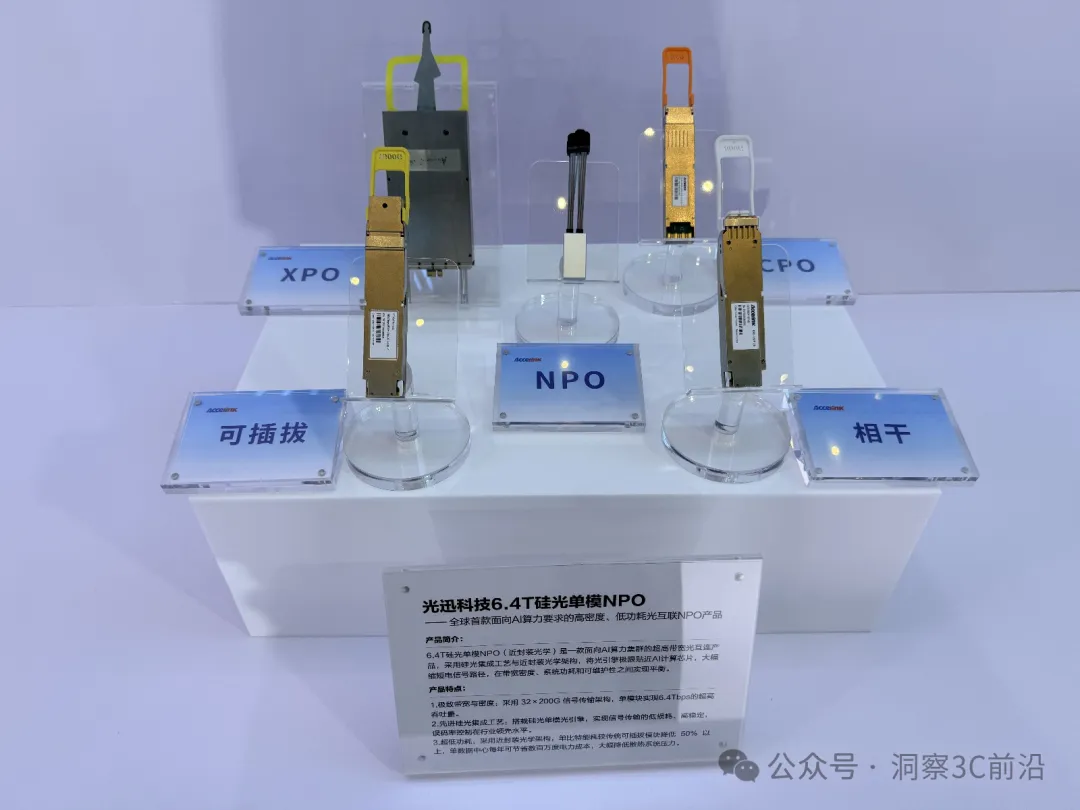
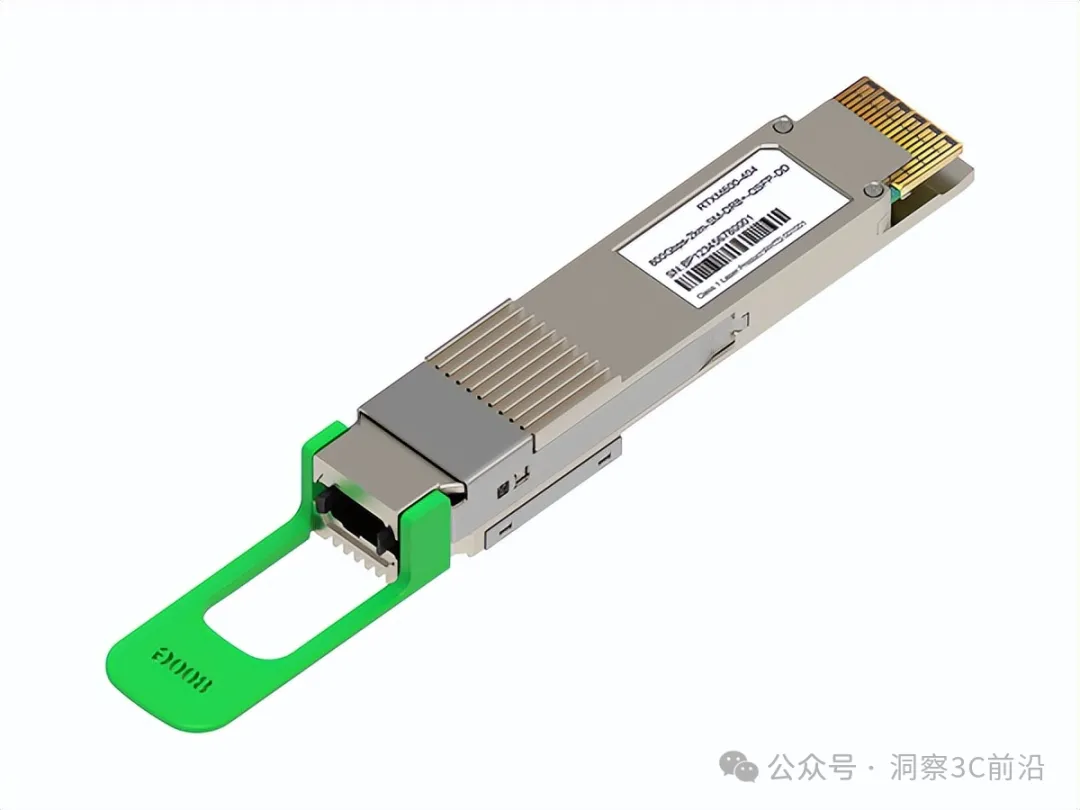
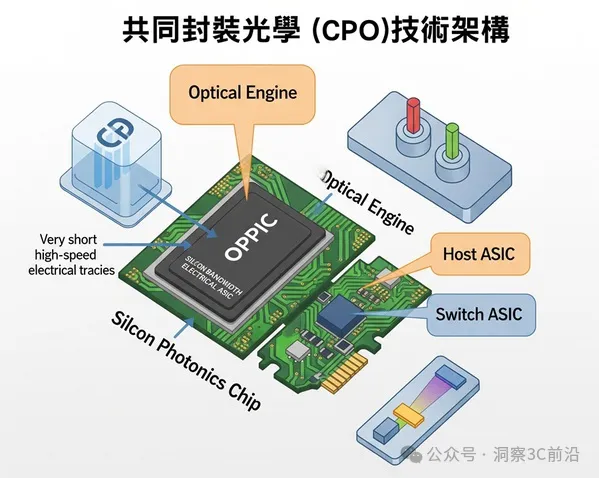
傳統可插拔光模組,電訊號走線長、功耗高、時延大,早已跟不上AI超算叢集的高速互聯需求;而CPO共封裝光學雖然性能極致,但封裝難度極高、良率偏低、維運成本昂貴,且一旦部件損壞需整體更換,量產落地和大規模普及仍有較長周期。
而NPO近封裝光學,精準卡在兩者之間,完美平衡性能、成本與實用性:
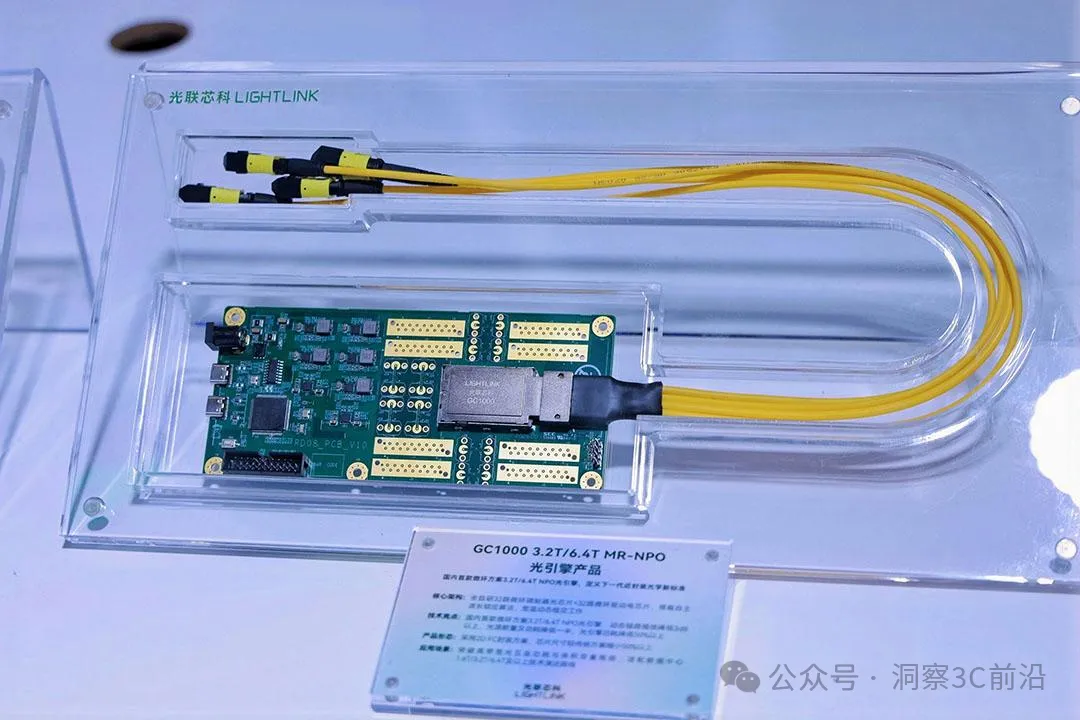
將光引擎緊鄰交換晶片佈置,大幅縮短高速電訊號傳輸路徑,把訊號時延壓縮至納秒等級;相比傳統光互聯方案,整體功耗下降40%-50%,頻寬密度大幅提升,完美適配AI大算力叢集的超高傳輸需求。
更關鍵的是,NPO保留了獨立封裝結構,支援部件單獨拆卸、維修更換,無需整體報廢,量產難度、供應鏈風險、維運成本遠低於CPO,是現階段兼顧性能與落地性的最優商用路線。
02. 巨頭密集落地,產業化節奏徹底敲定
從實驗室概唸到樣品測試,再到規模化試點,NPO的產業化速度遠超行業預期,全產業鏈已進入全速衝刺階段。
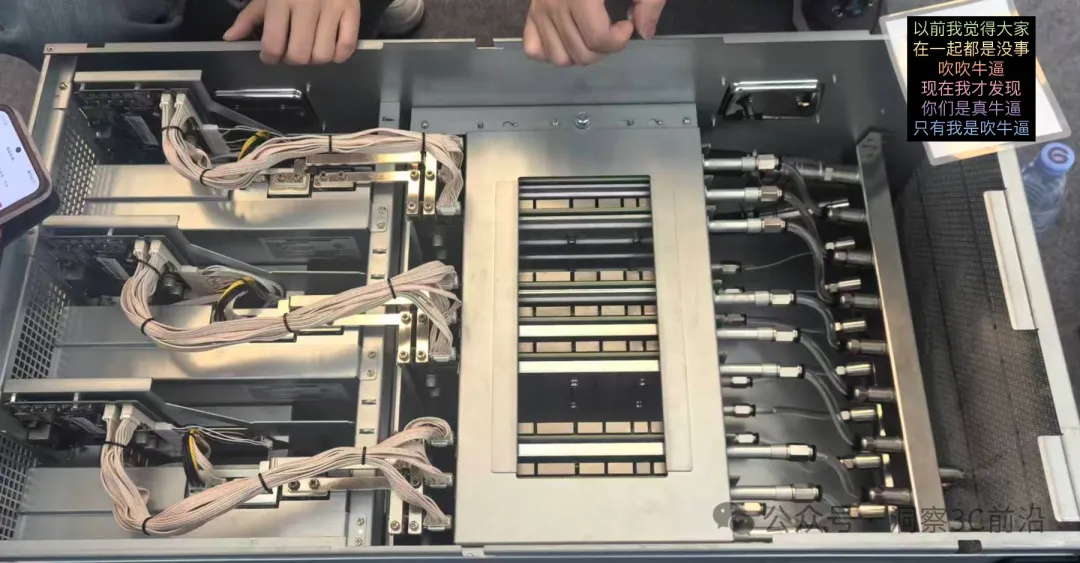
目前,國內頭部光模組廠商已完成多梯度產品佈局,1.6T NPO產品已實現商用送樣,3.2T產品完成客戶場景測試與流片,6.4T高端產品進入聯合研發階段;光博會最新展品更是集中亮相3.2T、6.4T乃至7.2T超高頻寬NPO光引擎,技術迭代全面提速。
下游雲廠商落地節奏清晰明確:
騰訊、阿里確定於2026年四季度啟動NPO超節點試點,搭建新一代高速互聯算力叢集;行業調研資料顯示,2027年下半年將迎來頭部客戶批次採購,2028年實現行業大規模普及。與此同時,輝達已釋放千萬級NPO模組需求指引,海外算力巨頭也全面入局,全球NPO商用浪潮正式開啟。
不止產品落地,行業標準也迎來突破。華為聯合20余家頭部企業落地國內首個NPO光互連MSA多源協議,打破海外標準壟斷,國產NPO產業鏈實現從技術跟跑到標準制定的跨越。
03. 算力賽道新拐點,NPO開啟光互聯新時代
AI行業早已達成共識:算力的上限,取決於互聯的速度。
大模型參數持續暴漲、AI超算叢集規模不斷擴大,傳統電互聯、老舊光互聯方案早已不堪重負,高時延、高功耗、低頻寬的短板,正在成為AI算力迭代的最大桎梏。
NPO的快速落地,恰好補上了AI算力叢集的最後一塊短板。納秒級超低時延、近乎減半的功耗、超高頻寬密度,搭配便捷的維運模式,能夠最大化釋放GPU、CPU的算力性能,讓算力叢集的協同效率實現質的飛躍。
過去,市場只關注GPU、記憶體的迭代升級;如今,高速光互聯已然成為下一代算力競爭的核心賽道。
CPO未來可期,但NPO當下已贏。作為CPO大規模商用前最務實、最可靠、最具性價比的過渡方案,NPO已經走完技術驗證、樣品測試階段,正式站在了規模化商用的拐點之上。
2026年試點落地,2027年全面放量,這條被全行業巨頭押注的NPO賽道,即將迎來爆發式增長! (洞察3C前沿)