
這兩年,AI賽道越來越熱。
大語言模型LLM(Large Language Model)在捲得飛起的同時——
另一條結構化資料側的AI路線LDM,也突然開始湧進各類型頭部玩家。
LDM(Large Data Model),即結構化資料基礎模型,其瞄準的是生產側的核心痛點:即如何讓基礎模型直接學習不同結構化資料中的變數關係、條件關係和生成機制。
到底有多火呢,這麼說吧!
像咱熟悉的美國Google、Amazon,德國企業軟體巨頭SAP等玩家紛紛下場佈局~
不過,誰成想呢,巨頭們剛湧進LDM搶位,一支中國團隊已經先把榜首坐成了「固定席位」。
9月15日,德國軟體巨頭SAP搶發TabPFN-3.5,幾小時後(9月16日),一支由清華博士組成的團隊,用一個400M參數的結構化資料基礎模型——
直接拿下了TabArena、TALENT、BCCO三個國際主流基準測試中二分類、多分類、回歸等各項任務的「第一」,呈現斷層領先:
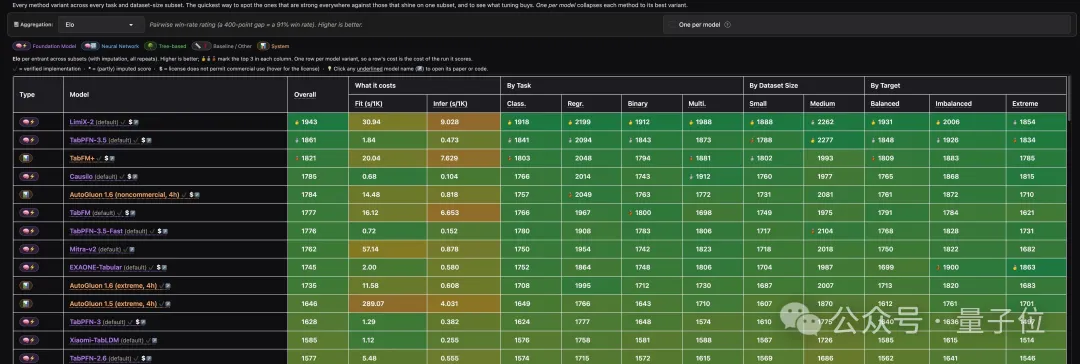
不賣關子,這個把Google等一眾大廠按在地上摩擦的,就是「穩准智能」剛剛發佈的:LimiX-2。
值得一提的是,這也不是穩准智能第一次把LDM做到國際頭部了。
去年他們發佈的國內首個結構化資料基礎模型LimiX已經上演過很長一段時間的霸榜大戲,但此後團隊也沒有追著榜單追趕,而是繼續往底層技術和模型儲備裡扎。
然後這次,直接給海內外主流選手再來了個措手不及~
在這家中國團隊看來,真正重要的,從來不是拿下一次第一,而是每到關鍵節點,都有能力重新回到第一。
而作為國內首個結構化資料通用大模型,LimiX啃下的,正是資料背後最值錢也最難找的「因果規律」。
相比TabPFN這類偏目標預測的行級建模路線,LimiX-2把面向變數關係建模前置為核心目標,學習跨變數、跨樣本的聯合依賴結構。
此外,其還自建了一套高品質自動化資料合成引擎,先讓模型見過足夠複雜的資料世界,再去處理真實任務。
過去幾年,LLM已經吃透了文字、語音、視訊,但一碰到工業生產、科學研究等應用側真正拿來做決策的場景,對因果關係、精準性和穩定性的要求會陡然提高,這也讓LDM的價值開始越來越清晰。
當前就在這條越來越熱的賽道中,穩准智能聯合清華已然率先把成果跑進了行業頭部位置。
LLM啃不動的資料分析硬骨頭,LDM開始接手了
大語言模型,這兩年能力邊界一路狂飆。
但熱鬧歸熱鬧,隨著AI真正往產業深處走,一個此前很容易被模型能力增長掩蓋的問題,也開始變得越來越清晰——
那就是現實世界,遠比語言世界「更大」。
要知道今天的大語言模型能力,很大程度上建立在一個極其龐大的語義世界之上。
文字、程式碼、論文、數學公式,甚至經過標註和描述的圖像、視訊,其中承載的知識都有一個共同特點,那就是它們已經經過了人類的一次理解、篩選和抽象。
LLM做的事情,就是把這些已經進入人類知識體系的資訊編碼成Token,通過海量語料學習上下文關係,再進一步形成知識、推理和生成能力。
所以從資訊理論和建模對象來看,LLM所處理的,更多是已經完成「語義化」的現實。
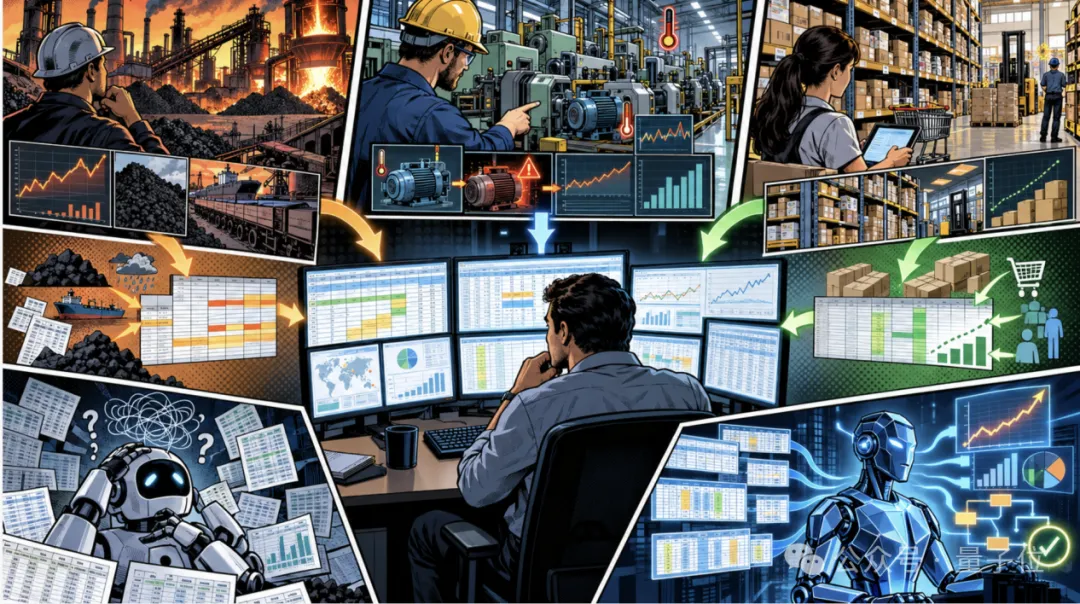
但問題是,在產業系統裡,另一類資料是長期存在於這個語義層「之外」的。
以製造業為例,溫度、壓力、轉速、原料配比、裝置狀態、能耗等幾十、幾百甚至上千個變數會同時變化,共同構成一個持續演化的高維資料空間。
其中大量關鍵規律,可能並沒有被人類提前總結成規則、公式或文字知識。
更重要的是,產業真正關心的,往往也不是單個變數是什麼,而是變數之間存在什麼穩定關係,那些關係可以跨環境成立,以及一個變數變化之後,系統整體會如何響應。
如果先把這類資料轉寫成文字,再交給LLM處理,中間天然會經歷一次「資訊壓縮」。
但在生產系統中,那些被壓縮掉的細粒度差異,恰恰可能直接決定預測精度、良率和風險判斷,在語義空間裡看似可以忽略的資訊,到了生產空間裡可能恰恰是最值錢的資訊。
這恰恰構成了「結構化資料建模」與「語言建模」之間最本質的差異——
如果說LLM主要學習人類已經表達出來的世界,那麼LDM更希望直接進入真實世界留下的高維資料空間,從變數關係本身出發理解規律。
二者面對的是不同的資訊空間,也因此更接近兩條平行、互補的基礎模型路線~
能往生產深處扎,也能補足LLM對真實資料世界理解不足的那一塊兒缺口,確實有前景啊。。。
隨著AI越來越多進入複雜決策場景,LDM也正成為基礎模型體系中越來越重要的一塊能力拚圖。
於是乎,這兩年,海內外玩家也開始接連入場,結構化資料基礎模型的競爭,正在明顯《提速》。
今年Google直接發佈TabFM,把表格資料基礎模型正式納入自己的Foundation Model版圖。
Amazon也推出Mitra,專門探索一個預訓練模型如何跨不同表格、不同任務直接遷移。
SAP動作更猛,先做SAP-RPT-1,今年又直接收購TabPFN背後的Prior Labs,投入超過10億歐元擴建結構化資料AI研究團隊。
就在幾天前,最新的TabPFN-3.5 Plus又正式進入SAP AI Core,直接開始做現金流預測、付款延遲、供應商風險、客戶流失這些企業核心決策任務。
從Google、Amazon一路到SAP,結構化資料基礎模型已經從學術圈裡的新方向,迅速變成全球科技巨頭集體押注的一塊基礎能力。
重做底層技術範式,LimiX讓模型理解資料背後的因果機制
LDM賽道開始升溫,崔鵬和團隊多年押注的方向,也終於走到聚光燈下。
穩准智能首席科學家、清華大學電腦系崔鵬教授,長期研究結構化資料與因果智能,也是LDM理念的提出者之一。
很長一段時間裡,這支團隊都在啃一些更底層的問題:Scaling規律能否延伸到結構化資料,CMNs能否進一步打開因果建模的能力上限。
這些偏離傳統因果研究路徑的探索,當時並不輕鬆。
如今,LimiX、LimiX-2連續沖上國際Benchmark前列,也讓這條當初看起來更冒險的技術路線,開始得到模型效果的直接驗證。
跟賽道升溫相比,一個更值得注意的變化是:大家底層技術其實並不那麼一樣。
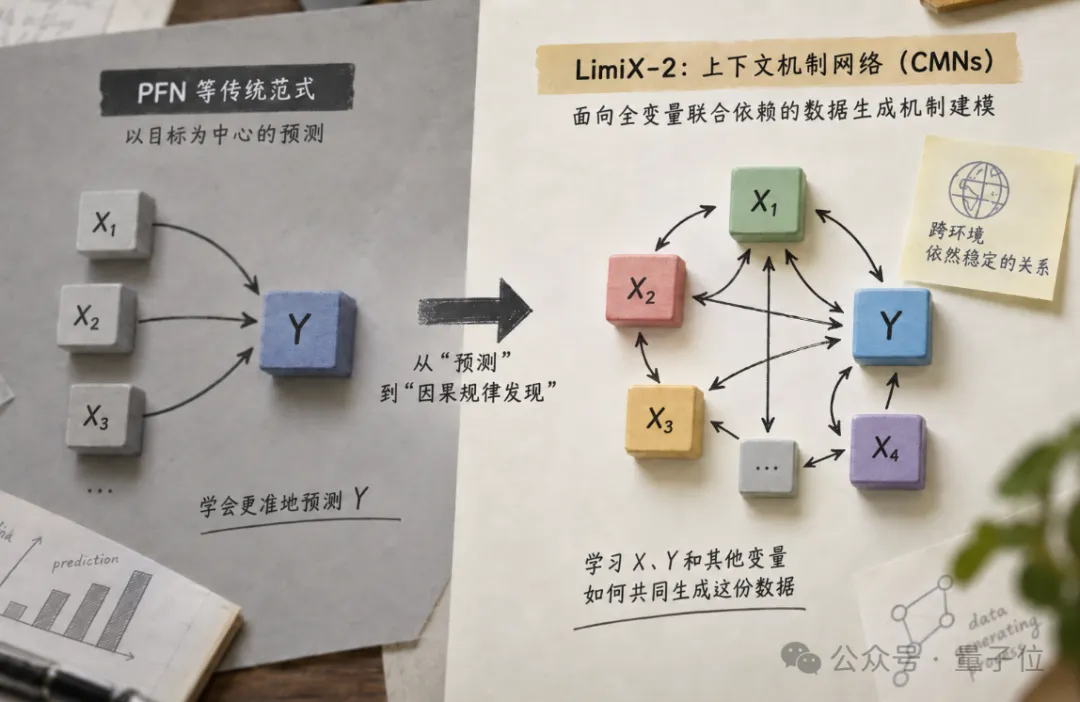
比如TabPFN為代表的PFN路線,核心目標很明確:給定上下文和目標,讓模型快速適應一張新表,並把Y預測準。
這條路線非常適合分類、回歸等任務,也推動了Tabular Foundation Model快速發展。
但當結構化資料模型繼續往更深處走,一個問題開始冒出來:如果我們想知道的,已經不止是「Y等於多少」呢?
畢竟生產側真正關心的,往往還包括變數之間是什麼關係,一個變數發生變化之後,其他變數會怎麼動。
到了這一步,傳統以目標變數為中心的PFN路線,其能力邊界就逐漸顯出來了——
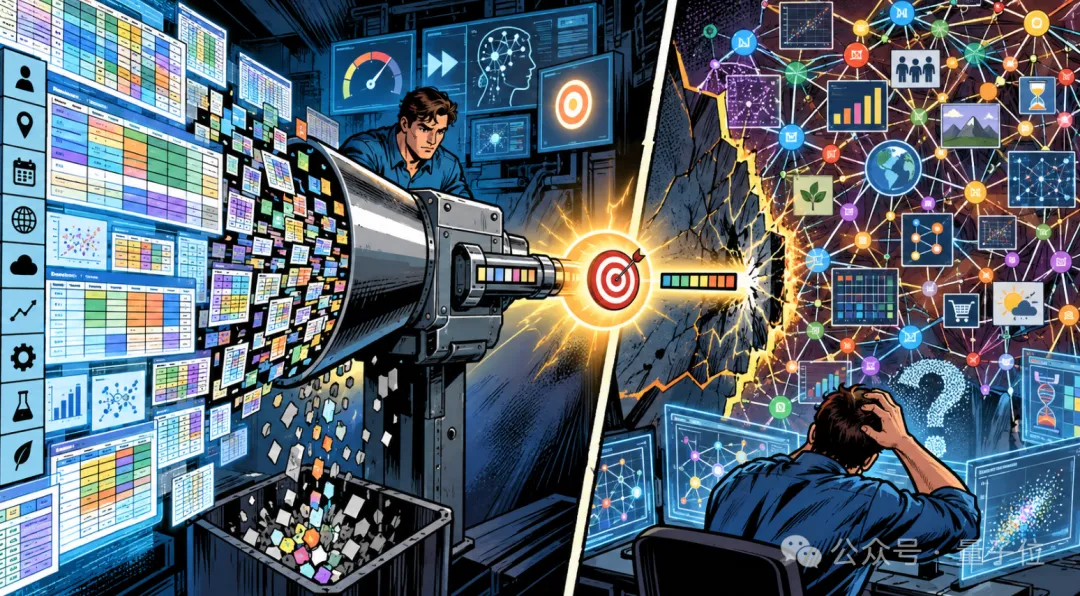
對於不少PFN類模型而言,資料通常會先被壓縮成更高層的表示,再用於完成目標預測,這樣做有利於快速適配任務,但問題是部分變數級的細粒度資訊,也可能在表示過程中被摺疊。
當問題繼續從「預測結果」往「理解變數關係」推進時,模型需要保留和利用的資訊粒度,也隨之發生變化!!
而穩准智能這次在LimiX-2上真正動刀的,則是結構化資料模型最底層的「技術範式」。
作為較早用機器學習方法研究變數關係和因果規律的團隊之一,崔鵬團隊長期關注的問題,就是如何讓模型超越表面相關性,找到那些跨環境依然穩定的關係。
因此到了LimiX-2,穩準沒有繼續沿著傳統預測範式往上堆能力,而是直接改了模型「學什麼」——
團隊創造性提出上下文機制網路Contextual Mechanism Networks(CMNs),把結構化資料建模從以目標變數為中心的預測問題,推進為面向全變數聯合依賴和資料生成機制的關係建模問題。
先來說說上下文機制網路(CMNs)。
如果說PFN仍然是在給定目標下學習怎麼預測得更準,那麼CMNs想回答的問題,已經變成了X、Y和其他變數放在一起,到底是怎麼共同構成這份資料的。
換句話說,LimiX-2沒再把變數關係當成服務於預測的中間資訊,而是直接把它變成模型要學習的核心對象。
這種底層範式的切換有點類似大語言模型從BERT走向GPT,真正變化的核心,不只體現在參數規模和Benchmark上,更在於模型學習目標和組織資訊的方式被重新定義了。
當然,CMNs這個新的學習目標,聽起來很理想,真正做起來卻沒那麼簡單。
既然想讓模型搞清楚變數之間到底是什麼關係,訓練時就不能永遠給它一道「固定」的題。
所以穩准團隊聯合清華在LimiX-2做的一件重要的事,便是通過提出上下文條件掩碼建模(CCMM),並升級自動化合成資料的生成引擎,不斷給模型換題——
通過不斷遮住-預測不同變數,逼著模型從預測單一目標,轉向學習變數之間的條件依賴和聯合結構。
反覆訓練後,模型掌握的也就不只是某一道題怎麼答,而是逐漸理解:這些變數彼此如何作用。
預測目標不斷變化,模型也就沒法只圍著某一個Y死磕,而得慢慢把整張表裡變數之間的關係摸清楚。
此外在底層技術層面,LimiX還進一步將建模粒度下沉到Cell-Level,以記憶體格作為基礎表示單元,保留列身份、具體取值和缺失狀態,並支援跨變數、跨樣本的資訊互動。
這樣一來,從資料表示到訓練目標,再到網路計算,整套設計都圍繞聯合依賴建模展開。
在這套框架下,分類、回歸、缺失值填補等任務,都可以進一步統一為對同一個資料模型的不同查詢;而對聯合關係的持續建模,也為後續的結構發現乃至因果骨架發現提供了基礎。
由此,整個底層技術能力也就形成一個邏輯閉環——
CMNs先把「目標」改成學關係,CCMM負責讓模型真正去「學關係」,Cell-Level負責保留各種細粒度「特徵」,三者共同構成一套從學習目標、訓練機制到資料表示的技術範式。
中國LimiX-2研發團隊成果到底有多強?
一套新技術範式真正有價值的時刻,往往發生在它開始改寫能力邊界之後。
對LDM來說,比再刷一張AI榜單更重要的,是它能不能把這些能力真正帶進生產環境。
而在走進真實場景之前,LimiX-2已經先在主流Benchmark上把這條路線跑到了行業頭部。
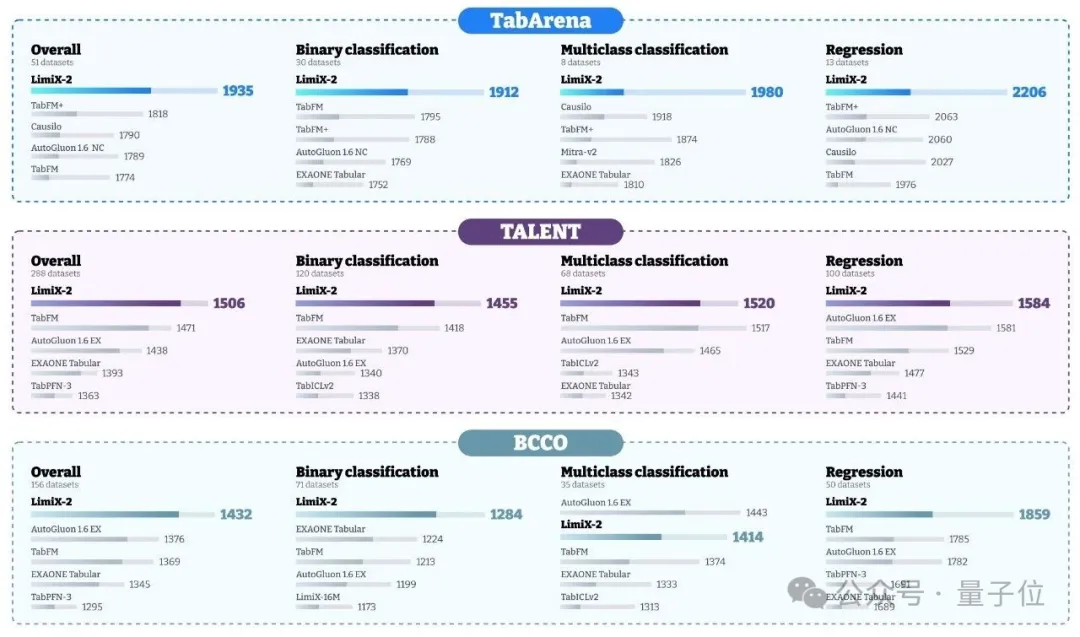
在TabArena、TALENT、BCCO等國際主流Benchmark中,LimiX-2在二分類、多分類和回歸任務上均位居第一,超過Google TabFM、TabPFN、TabICL、Mitra等模型。
先看「分類」。
分類任務解決的是「它到底屬於那一種狀態」的問題,比如裝置會不會故障、客戶會不會流失、一筆交易是否存在風險,本質上都要求模型從大量變數中找出真正影響結果的訊號。
在TabArena評測中,按Elo排名,LimiX-2四項指標均居第一,Elo達到1917,領先TabFM+143分。
另一個考驗模型底層建模能力的指標,是「回歸任務」。
回歸要求模型進一步理解連續變數之間的依賴關係,並最終把這種關係壓到一個足夠準確的數值預測上。
在TabArena回歸任務中,按Elo排名,LimiX-2四項指標均居第一,Elo達到2206,位列第一。
換句話說,LimiX-2的優勢已經不只體現在「分得對」,也開始體現在對連續關係建模得更細、更準。
值得一提的是,LimiX-2的提升也來自訓練資料這一側。
CMNs把學習目標進一步擴展到變數關係建模,對訓練資料的多樣性也提出了更高要求。
因此,LimiX-2升級了大規模自動化合成資料引擎,覆蓋更多分佈、互動關係和噪聲類型,讓模型提前見過更豐富的資料結構,從資料側支撐能力維度的擴展。
不僅如此,除了分類、回歸等預測能力,LimiX-2也開始把能力進一步推向因果發現。
面對高維複雜資料,傳統方法往往受專家先驗和統計假設限制;而在Sachs、UF、Causal Chamber等公開資料集上,LimiX-2已經領先多種傳統因果發現方法。
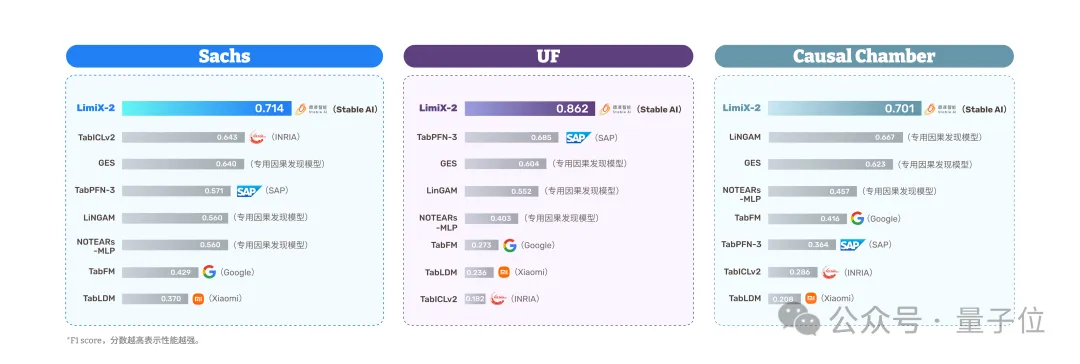
分類、回歸和跨資料泛化,都是企業的日常任務。這類榜單真正檢驗的,是模型面對真實資料時能否穩定預測、遷移並支撐決策。
而這背後指向的,正是LDM更長期的能力路徑——
從Prediction走向Relationship、Causality、Intervention、Decision,讓AI進一步理解真實世界中的變數關係、生成機制和變化規律,直達通用因果智能。
而這些,恰恰也是生產側智能化下一階段最值得關注的方向之一。
2020年,GPT-3問世。
它讓行業第一次清晰看到,基礎模型一旦跨過能力臨界點,AI就可能從解決單點任務,走向更通用的智能。
六年後的今天,AGI已經從一個遙遠概念,越來越接近一條可以被實現的願景。
但當AI繼續向前,它終究還要進入一個比語言世界複雜得多的空間:真實世界本身。
理解變數如何彼此作用、因果如何層層傳導,以及一個微小變化,最終會把整個系統推向那裡。
而LDM這塊競爭場域所指向的,恰恰就是這塊仍處早期、卻可能決定AGI下一階段能力的GPT-3時刻——
讓大模型從理解人類已經表達出來的知識,進一步走向理解世界運行本身。
就在這個可能決定下一階段AI能力上限的賽道上,顯然已經有中國團隊走到了行業頭排。 (量子位)