
AI圈需要新故事。
最近,一個不聊天、不寫程式碼的AI模型刷屏了。開發者把它塞進各種應用,有人拿它玩遊戲,有人用它分郵件,還有人讓它操控瀏覽器。
它叫Jev,由前OpenAI研究員Diogo Almeida等人聯合創立的TypeSafe AI於9月15日發佈,同時被冠以一個新品類的名字:System One Models(系統一模型)。9月21日,Jev全面開放,更多開發者湧入,上手測試它能接手哪些工作。
這個模型的特別之處在於,它只做判斷。比如收到一條使用者評論,它會判斷是否違規、該刪還是要留。TypeSafe AI把軟體裡大量分類、評分、選擇下一步動作的工作,都交給一個專門的模型去做。
真正吸引行業的是速度和價格。按照官方測試,Jev的速度是大模型的193.6倍,成本約為其1/444.6,且輸出免費。不過官方也註明,並不是所有任務都能獲得同樣的提升。
開發平台Vercel在9月18日披露,Jev接入其AI Gateway後的24小時內,已有近13%的付費團隊使用,是GPT-5.6系列上線首日的2倍、Claude Fable 5.1的6倍以上。開發者社區更是探索出了很多玩法和場景。
在大模型卷參數的時候,Jev把決策又快又便宜做成賣點,給AI行業提供了一個新的故事。
這是又一個靠效率和價格引爆關注的“DeepSeek時刻”,還是一種模型分工新範式的開端?它的出現會給大模型行業帶來哪些影響?
01.Jev不負責說,只負責選
我們先通過一個客服投訴的場景,來理解Jev能做什麼。
假設使用者發來一句“我被扣了兩次錢,想要退款”,接下來,客服系統要判斷交給哪個部門、事情有多緊急,還要判斷客戶要做什麼。程序可以把消息和預先設定好的問題一起交給Jev,由它直接返回判斷結果。
接到問題後,Jev的輸出會分為三種類型。
第一種是Choice,在給定選項裡做選擇。比如“該交給哪個部門”,候選選項包括售前組、售後組、技術組等,Jev會選出一個,同時給出各選項的機率。
第二種是Score,按預設標準打分。比如“問題有多嚴重”,程序可以設定從“輕微”到“造成重大損失”的不同等級,Jev給出各等級的機率,再計算加權分數。
第三種是Noul,判斷一句話成不成立。比如“使用者在要求退款”,如果返回0.97,就表示模型認為這句話有97%的機率成立。
三種輸出可以在同一次呼叫裡一起完成,程序拿到結果就能繼續走下一步。
具體效果如何,開發者已經做了一些嘗試。
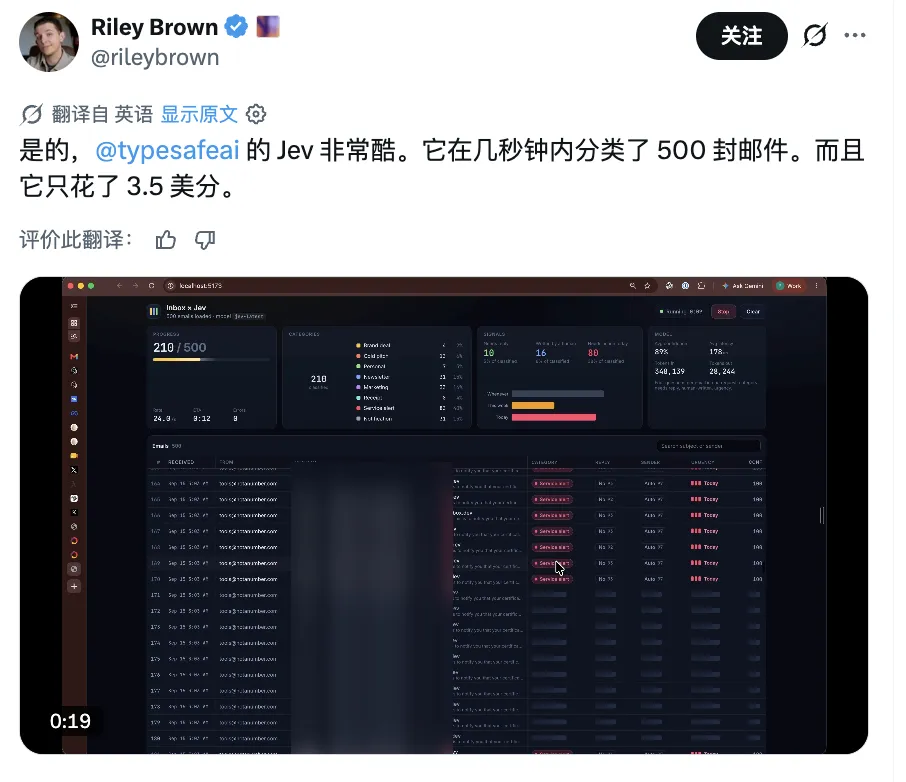
有網友在X上展示用Jev進行郵件分類。據他介紹,Jev在數秒內完成了500封郵件的分類,花費3.5美分。對於需要反覆讀取文字、分配類別的任務,這顯示出低成本批次處理的潛力。
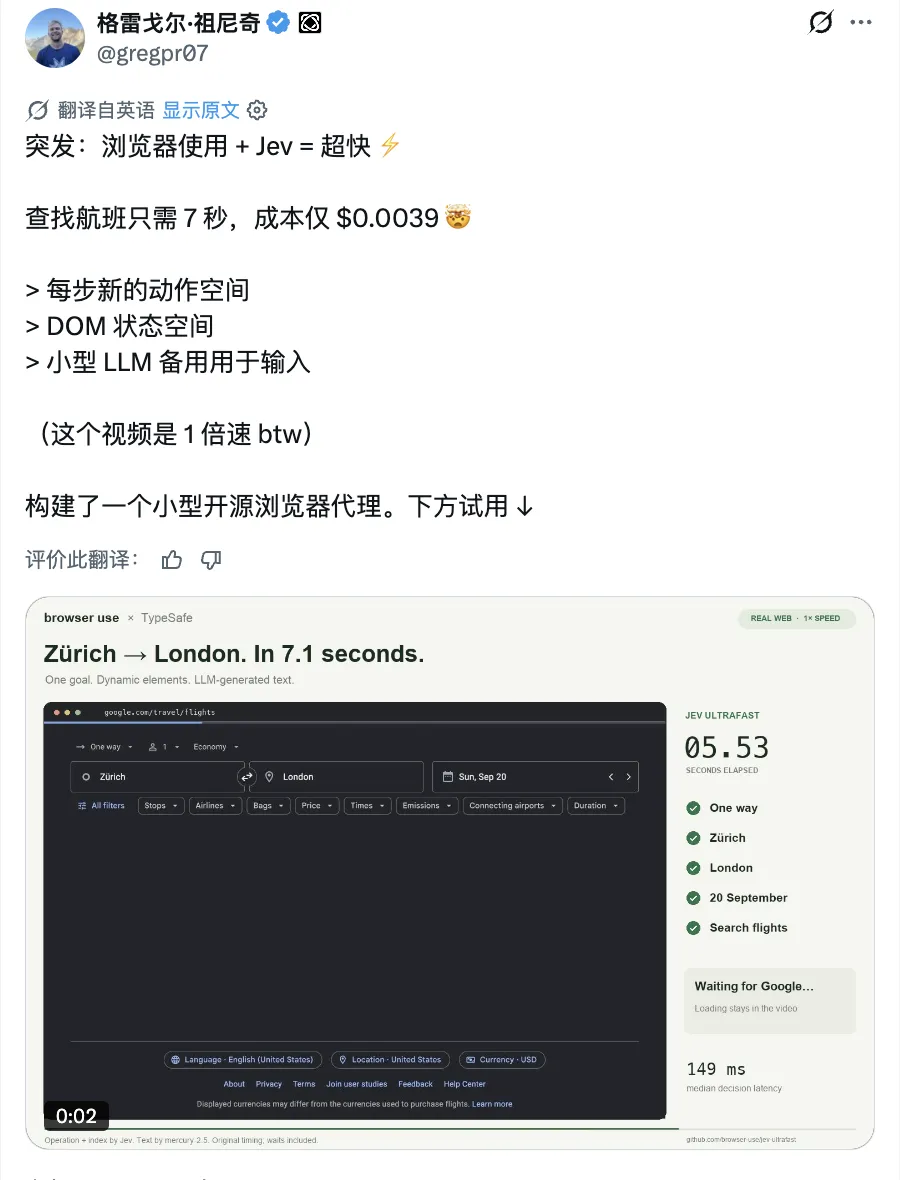
還有網友展示了航班查詢的案例。他把網頁上的按鈕、輸入框等元素整理成候選項,讓Jev決定下一步執行什麼操作、選擇哪個目標。到了需要填入城市名的環節,再呼叫生成模型提供文字。據他介紹,這套系統在約7秒內就完成了一次航班查詢。
不同用法背後,是同一個設計思路。TypeSafe AI把Jev歸入一個新品類——“System One”,取自卡尼曼《思考,快與慢》中那種不用過腦子、憑直覺瞬間給出的判斷。Jev本質上是一個決策模型,不生成任何字元,直接返回可供程序呼叫的結構化決策。
這些事情,通用大模型也能做,Jev的區別在哪裡?
最明顯的區別在於輸出方式。通用大模型通過生成文字給出答案,即使只需要一個選項,通常也要逐個生成Token。Jev直接返回選項、分數或機率,程序拿到結果就能繼續執行。
輸出方式背後,其實是產品定位的不同。通用大模型可以聊天、寫程式碼,也能分析問題,Jev則專門處理判斷任務,開發者提供資訊、描述判斷要求,必要時給出候選選項,由它返回結果。仍以退款為例,識別訴求、分配工單可以交給Jev,解釋退款政策、給客戶寫郵件,則需要通用大模型。
這也容易讓人聯想到傳統的分類器。分類器是專門給資訊歸類的模型,開發者先設定類別,再用已經標好類別的資料訓練它,讓它學會不同類別的特徵,從而判斷新的輸入應該歸到哪裡。但分類器通常圍繞固定任務訓練,換了業務場景或標籤,往往需要補充標註資料、重新訓練或調整。
相比之下,Jev的使用方式更靈活,它仍具備大模型式的語義理解與泛化能力,開發者可以通過提示詞描述不同的判斷任務,不必為每個新任務重訓模型。
02.快、便宜、精準,是怎麼做到的?
Jev能幹什麼講清楚了,那麼,它為什麼能在一周內讓開發者集體上頭?
先來看需求端。
文字打標籤、請求分流、風險判斷,這些需求一直存在。到了Agent時代,這類“判斷類呼叫”的需求變得更大了。
一個Agent完成任務,往往需要反覆作出選擇。哪怕使用者提出的是一個簡單任務,背後可能都會發生幾十次模型呼叫。
大模型研究員曾小健告訴「AIX財經」,Jev踩中的正是這個痛點。過去,開發者把太多判斷題交給生成式大模型,讓模型先生成文字,再從中提取結論。單次呼叫的開銷不大,但在Agent持續運行的過程中,重複判斷會明顯推高整個任務的成本和耗時。
Jev把這類需求單獨做成產品,無論是選工具、檢查內容,還是判斷任務是否完成,開發者都能找到可以嘗試接入的環節。
再看產品端,Jev同時做到了“速度快、便宜、判斷准”三件事。
首先是快。
一位業內人士告訴「AIX財經」,CoT(思維鏈)讓模型一步一步思考,通過增加推理過程中的計算量,提高複雜任務的精準性。Jev則省去逐Token生成文字的過程,直接返回判斷結果和機率,以此提高速度。
此外,同一份輸入還可以平行完成多個獨立判斷。大模型研究員姚宇航舉例,檢查一份文件時,寫作質量怎麼樣、有沒有敏感詞彙,可以平行判斷,不必逐項等待。放在大規模呼叫中,這能節省可觀的時間。
其次是便宜。
通用大模型的API通常分別按輸入、輸出Token收費,生成的內容越長,輸出費用越高。Jev不生成文字回覆,只收取輸入費用,每百萬輸入Token為0.042美元,輸出不收費。對於反覆分類、打分的任務,這種設計減少了為獲取一個簡單結論而支付的生成費用。
這種設計,在Agent中尤其有價值。一次任務可能包含多次工具選擇、結果檢查和重試判斷,每一步的開銷都會計入完成任務的總成本。曾小健舉例,可以先用Jev判斷問題難度,把簡單問題交給便宜模型,複雜問題再升級到更強的模型。這樣,既降低了判斷環節的費用,也減少了不必要的強模型呼叫。
再者是訓練方法讓模型返回的機率本身可信。
前述業內人士解釋,Jev的判斷仍依靠模型內化的世界知識、高品質的決策資料與訓練軌跡,以及對輸出機率的有效校準。
這種訓練方法叫作校準決策強化學習(RLCD)。所謂校準,就是在大量被模型賦予80%機率的判斷中,相應事件實際發生的比例也應接近80%。這樣,開發者才更容易根據模型的把握程度,決定哪些結果可以自動執行,哪些需要覆核。它改善的是判斷與不確定性的表達,並不保證每次都答對。
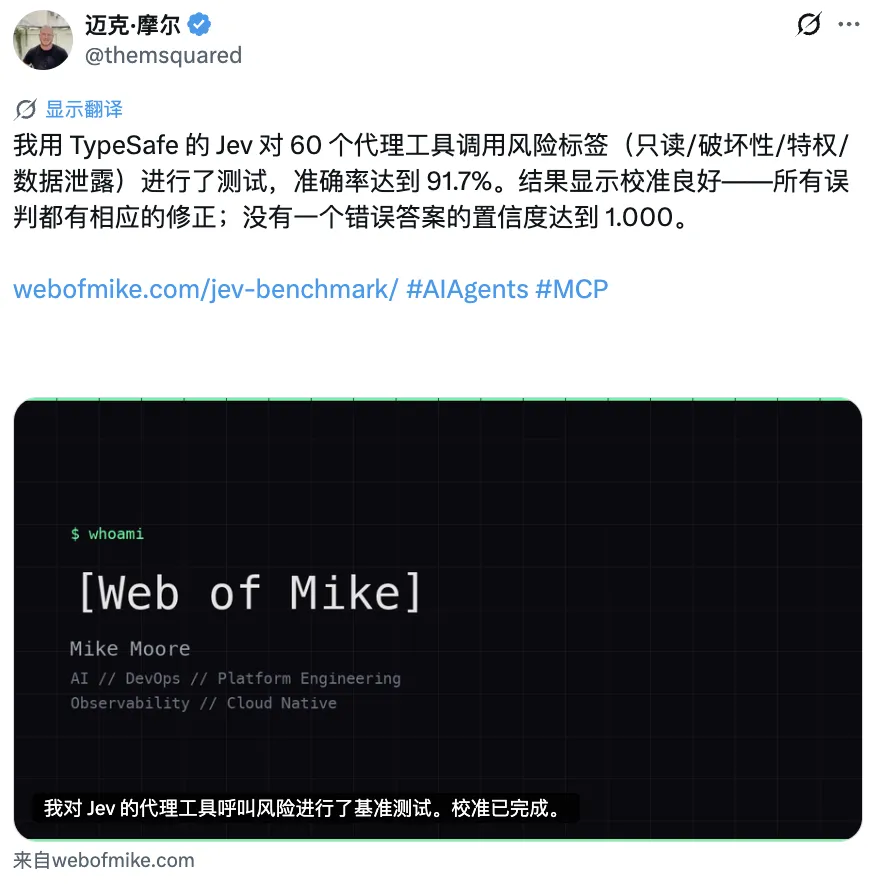
有網友的測試就呈現了這種差別。他讓Jev判斷60個Agent工具呼叫屬於唯讀、破壞性、及權限,還是資料外傳,再對照自己預先標註的答案。結果55個判斷一致,一致率91.7%。但難度不同的案例表現差距明顯,34個界限清楚的案例全部答對;12個刻意偽裝成正常操作的陷阱案例,答對了11個;剩下14個本身就存在爭議的含糊案例,只答對10個。
姚宇航解釋,Jev並不是真的零幻覺,它的輸出被卡死在給定選項裡。如果給定A、B、C、D四個選項,它不會憑空選出E,但仍可能在四個選項中選錯,需要通過模型微調和上層工程降低誤判機率。
以上是Jev公認的優點,但能具體快多少、便宜多少,還得看任務和對照對象。曾小健提醒,如果換成便宜的小模型,並要求它只輸出簡短結果,差距會明顯縮小。同一段材料需要完成多個獨立判斷時,共享上下文、平行處理的優勢才更容易體現,真正的收益在高頻、批次判斷中。
03.Jev會帶來什麼改變?
Jev的出現是一陣風,還是一種新範式,類似當年的“DeepSeek時刻”?得從兩面看。
從技術層面看,Jev並不算新。曾小健指出,分類器、排序模型和意圖識別早已存在,Jev並沒有跳出這類任務的邊界。
但從產品層面看,它是新的。Jev把“判斷”做成了一個便宜、快速、可以獨立呼叫的模型介面,面向 Agent、單獨計費、單獨最佳化。開發者可以圍繞判斷任務,單獨比較準確率、延遲和費用,選擇適合的模型;決策能力也因此有了自己的迭代路徑,不必再跟著通用模型的整體能力一起升級。
對每天要處理大量文字的企業來說,只要判斷質量夠用,Jev就能明確帶來更快、更便宜的處理效率。曾小健把它總結為“系統工程和產品架構上的創新”。
前述業內人士則更看重它在模型體系中的位置。他認為,Jev所代表的技術方向,未來很可能成為一種重要的推理與輸出範式,與普通文字生成、CoT深度推理長期並存。
多位從業者告訴AIX財經,接下來能接住這波紅利的,包括三類玩家:個人開發者、企業、具身智能公司。
對個人開發者來說,最簡單的嘗試是把Jev接進已有Agent,承擔工具選擇、任務終止以及失敗重試等判斷。曾小健認為,API呼叫本身門檻不高,會Python或JavaScript的開發者很快就能上手。這類任務選項有限、呼叫頻繁,偶爾判斷錯了通常還能恢復,適合用來測試決策模型的效果。
他提到,真正的門檻是,怎樣把業務需求定義成一個好的判斷問題。比如判斷“客戶風險高不高”,高和低的標準是什麼、多大把握才能自動執行、什麼情況必須交給人工,都需要開發者提前想清楚。
到了企業端,價值主要來自規模。姚宇航看好程式碼審查、客服和大規模文字處理等每天都要反覆分類、篩選、檢查的任務,一條資料還可能對應多個判斷。只要質量達到要求,單次呼叫節省的時間和費用,就能隨著業務量累積,降低整套系統的運行成本。
具身智能的想像空間更大。姚宇航認為,機器人對響應速度要求高,行業本身也還在早期,新的決策模型有機會切入。
機器人執行任務時,需要不斷根據環境變化決定下一步。如果環境資訊已經整理好、可選動作也已明確,快速決策模型有機會承擔其中一部分選擇,減少使用者的等待時間。但這仍是潛在用途,Jev能否適應實際環境、滿足可靠性要求,還需要專門驗證。
這些場景也給模型廠商提供了另一種做產品的方式。
姚宇航向「AIX財經」表示,過去行業比的是誰的模型更大、資料更多、算力更強,目的是解決更複雜的問題;Jev換了個方向,把那些又快又便宜就能解決的小任務專門做好,反而獲得了關注。模型廠商除了繼續提高能力上限,也可以圍繞具體判斷任務,最佳化速度、費用和穩定性。
曾小健打了個比方,未來的Agent系統更像一個模型團隊,有的承擔推理或生成,有的負責路由、排序或安全檢查。開發者需要重新判斷,哪些步驟值得呼叫強大的生成模型,哪些只需要一個快速、可靠的決策模組。
對國內廠商來說,機會是現成的。客服識別使用者意圖、銀行和保險把工單分到對應部門、銷售線索評出優先順序,都是合適的場景。加上國內企業更重視資料安全和本地部署,能夠在企業內部運行、適應中文業務標準的決策模型,有機會做出差異化。
這些機會並不只屬於Jev。姚宇航提到,已經有國內開發者嘗試用開源模型微調類似產品,他認為,復現這類功能的門檻並不高,後續可能有更多公司加入API服務競爭。
即便Jev的話題熱度可能只會維持幾個月,但用“便宜快速的模型做判斷”這個思路會持續。只要專門的決策模型能穩定降低工作的成本,就有繼續使用的理由。 (定焦One)