
就在剛剛,我們看到了不少令人意外的資料。
到2031年,人工智慧預計將累計創造22.5兆美元的全球經濟價值。
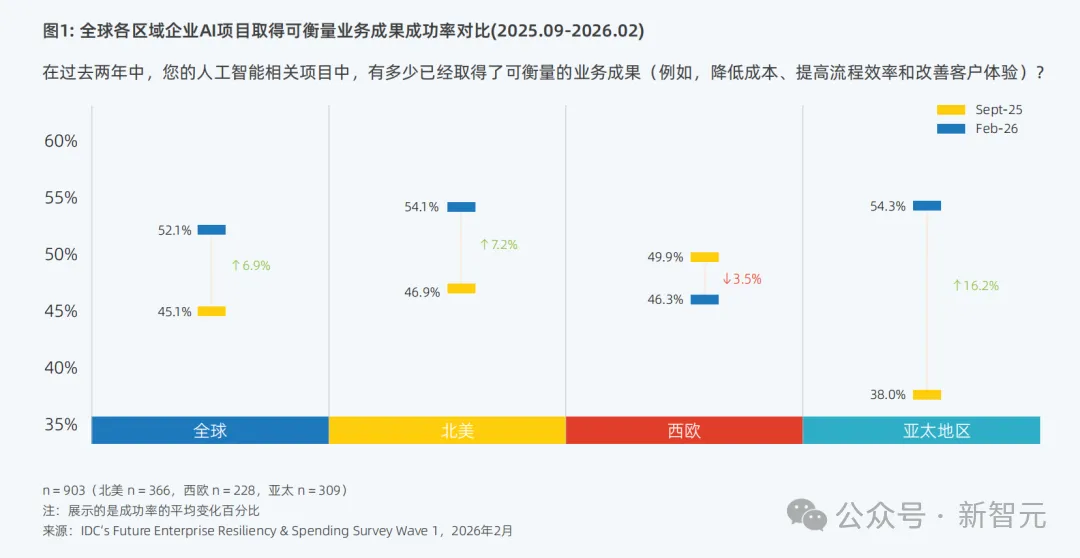
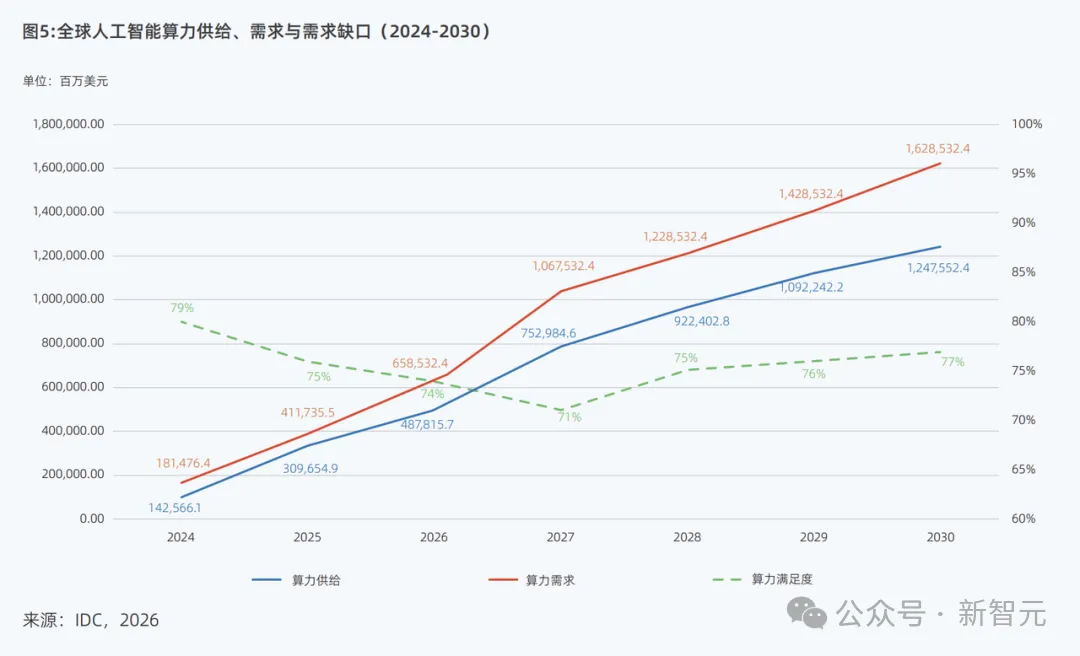
預計到2030年,全球AI算力缺口將達到驚人的3809億美元(近3兆人民幣)!
另外,2026年中國智能體部署的滲透率高達81.0%,全球領先!
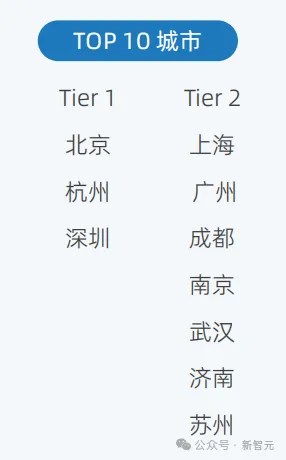
而且,令人意外的是,2026年,中國人工智慧城市排行榜大變樣了。
北京、杭州、深圳,處於TOP 3。
這些硬核資訊,都來自於一份重磅報告。
就在最近,IDC與浪潮資訊聯合發佈了首份智能體基礎設施研究報告——《2026年中國人工智慧計算力發展評估報告》。
從這份研究報告可以看出:Agent正在重塑一切,而它帶來的直接後果,就是算力的一場大饑荒,隨之而來的就是一場大洗牌。
Agent爆發之年,或將迎來算力荒
就在今天,OpenAI官宣:他們內部的神秘模型,在24天內攻破了超100個世界級數學難題。解題的背後,完全是一群智能體在協作。
OpenAI聯創Andrej Karpathy曾斷言:「AI智能體真正落地還需要10年。」
如今看來,這並非一句悲觀的預測,而恰恰宣告了Agent「黃金十年」的正式開啟!
據OpenAI披露,為瞭解決NS方程相關問題, 10,000個並行智能體耗時約88個小時。
它們相互傳送了490萬條消息,總共消耗了約3000億個輸出Token!
單單在解決NS問題的核心階段,這些智能體就傳送了270萬條消息,耗費了1300億個Token。隨後耗時17小時,完成了Lean形式化與驗證。
3000億Token相當於超過2200套《三體》 的內容量,或者大約相當於中國國家圖書館的文字資源總量的一半。
而普通人一輩子說完的話,大約只有 6 億 Tokens。也就是說,500個人一輩子「生成」的Token,這群智能體只要88小時。人類或許最終能更優美地解決NS方程,但在速度上和思考規模上,卻難以跟這些智能體匹敵。
這是一個標誌性的數字。例如,GPT-3模型在訓練時使用了3000億個Token,而現在,一個多智能體科研任務的累計Token消耗量,就達到了同樣等級。
但這只是世界Agent經濟的冰山一角。
年初OpenClaw風靡一時。隨後,在輝達GTC大會,黃仁勳定下了基調,實質上宣告:
現在世界上每一家公司都需要智能體戰略。
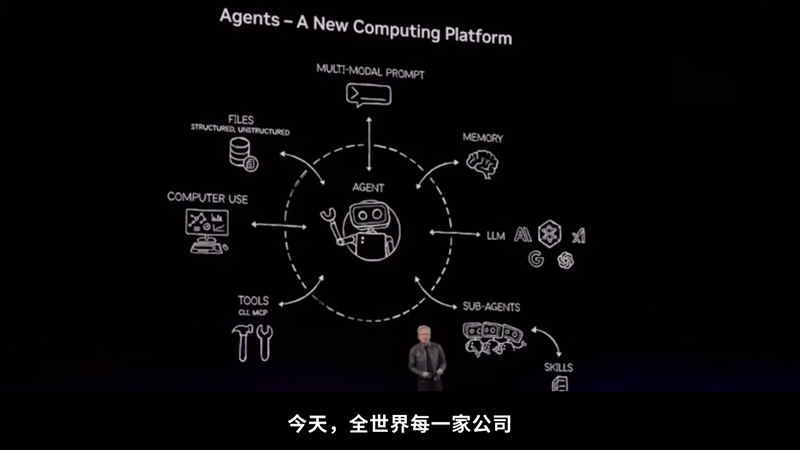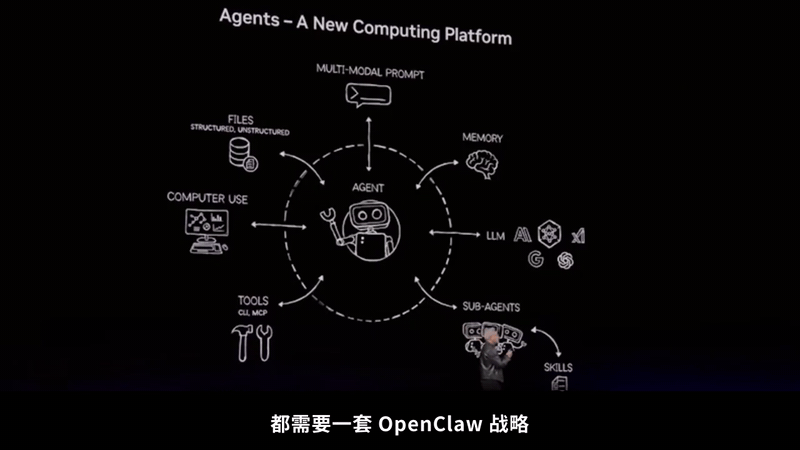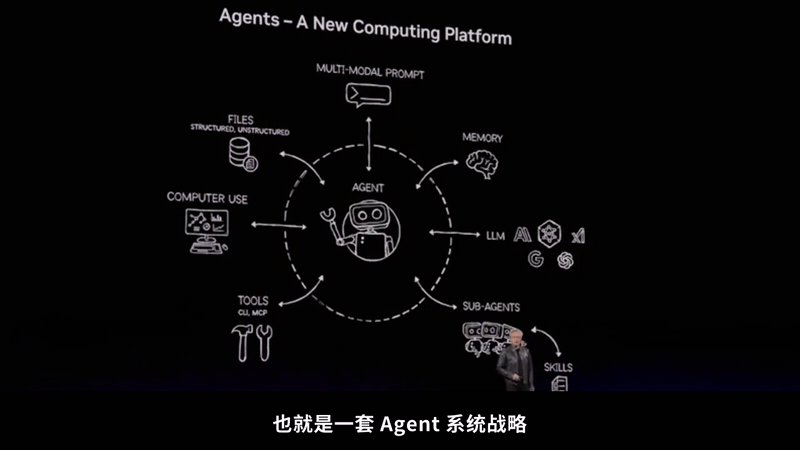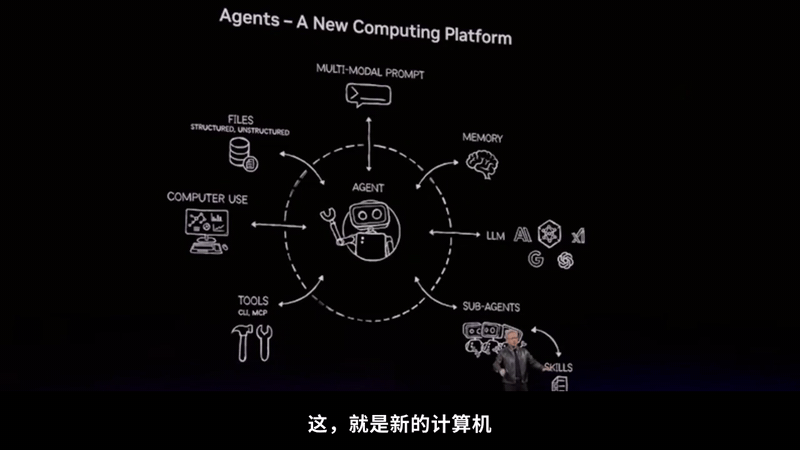
而在中國智能體部署滲透率上,中國領跑世界,今年已達81.0%,高於全球領先水平的78.1%。
但可惜的是,昔日大廠和資本瘋狂囤積的舊算力卡,如今可能要變「廢鐵」了。
過去兩年,所有人都在卷「AI訓練」,算力中心拔地而起,成千上萬張GPU被塞進機房。
但今天,智能體(Agent)正將這些投資無情地拍在沙灘上。
AI算力的評價標準和競爭邏輯,已經在短短一年內發生了天翻地覆的改變。
如果說大模型發展的1.0階段是「千模大戰」的算力囤積,那麼現在的2.0階段,計量單位已經從「算力規模」變成了「Token的生產效率」。
Token狂飆37倍,大模型開始「用不起」了
為什麼說Agent是新變數,徹底改變了潮水的方向?
我們需要先理解Agent與過去聊天機器人的根本區別。
以前的大模型是一次性問答,幾十個Token就搞定了;但Agent是一個「數字員工」,它需要多輪推理、呼叫工具、跨系統協作,還要時刻保存「記憶」(上下文)。
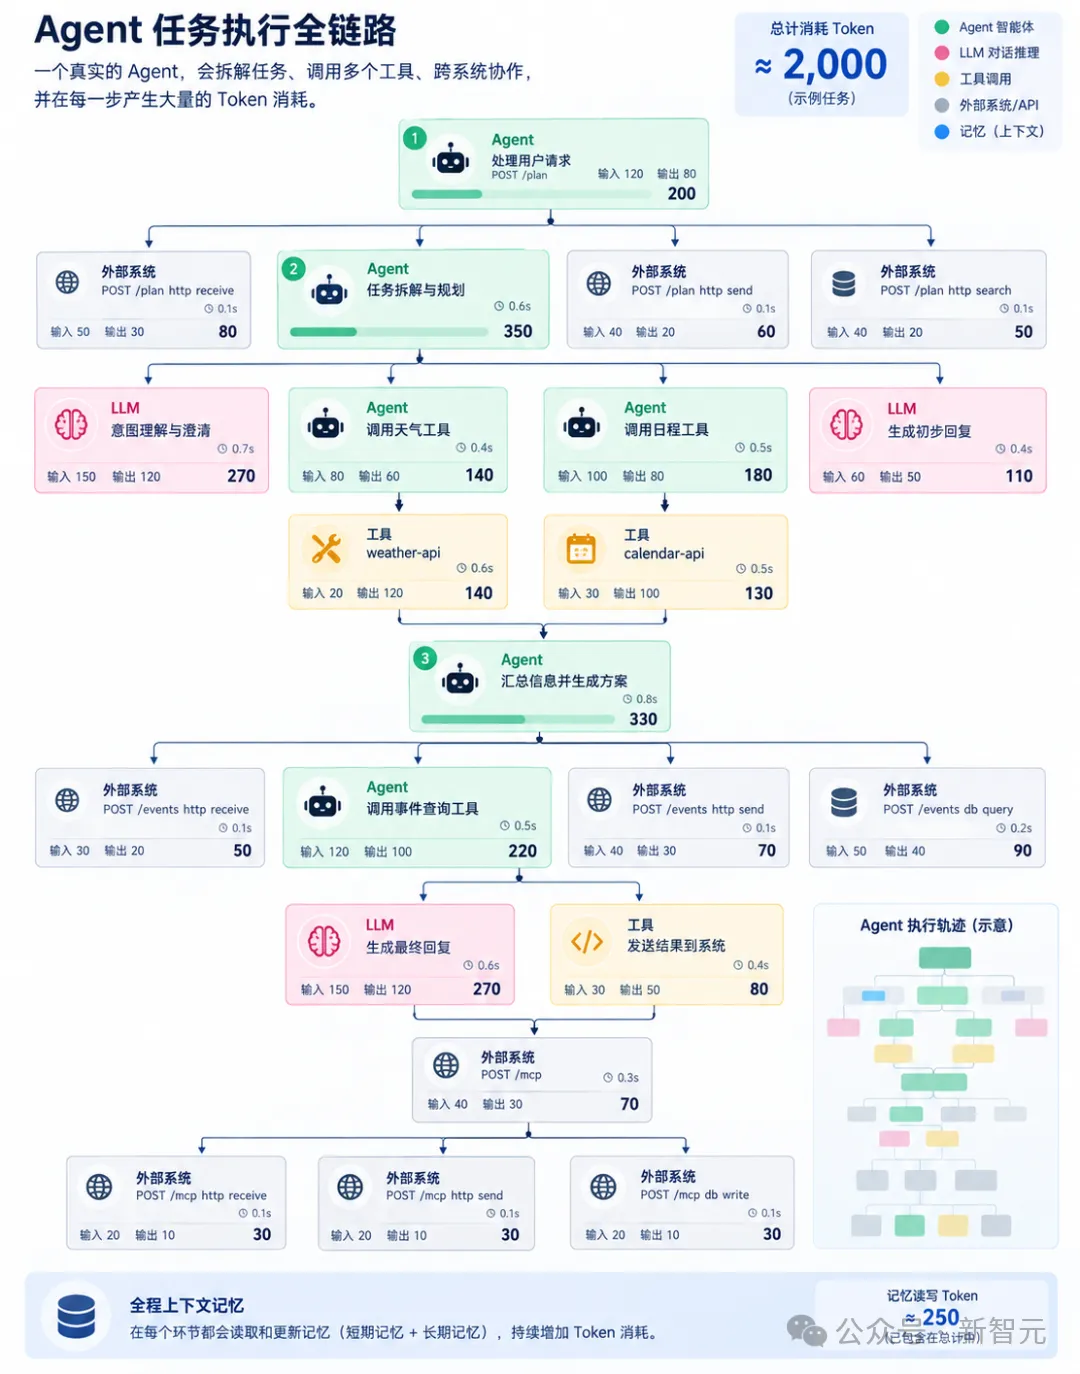
這帶來了一個極其恐怖的乘數效應:
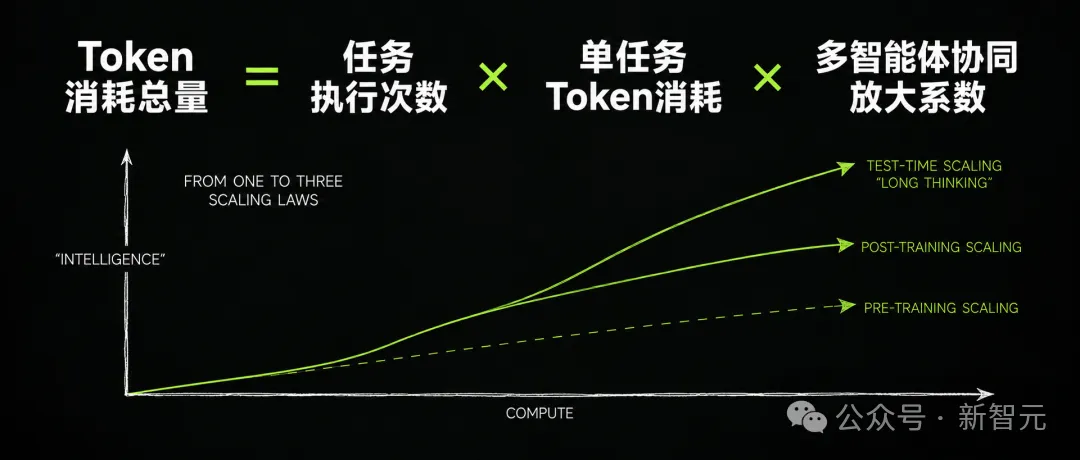
IDC給出了一組讓人倒吸一口涼氣的資料:
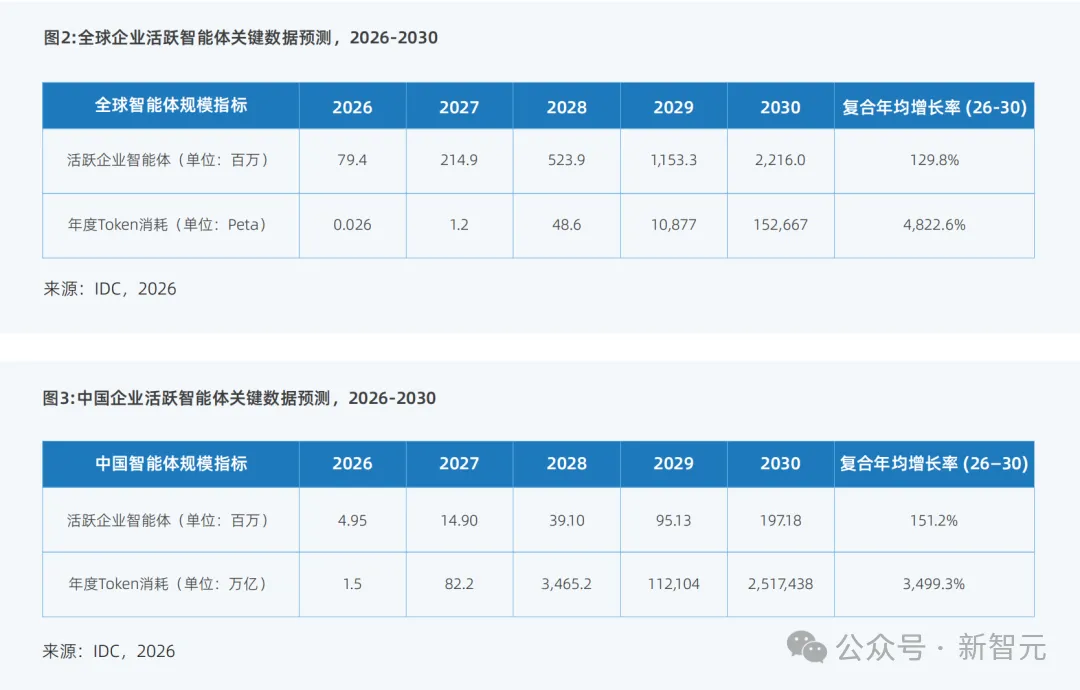
預計到2030年,全球活躍智能體數量複合增長率將達到129.8%,但同期的Token消耗量複合增長率,卻高達駭人聽聞的4822.6%!
Token消耗的增速,是智能體數量增速的整整37倍!
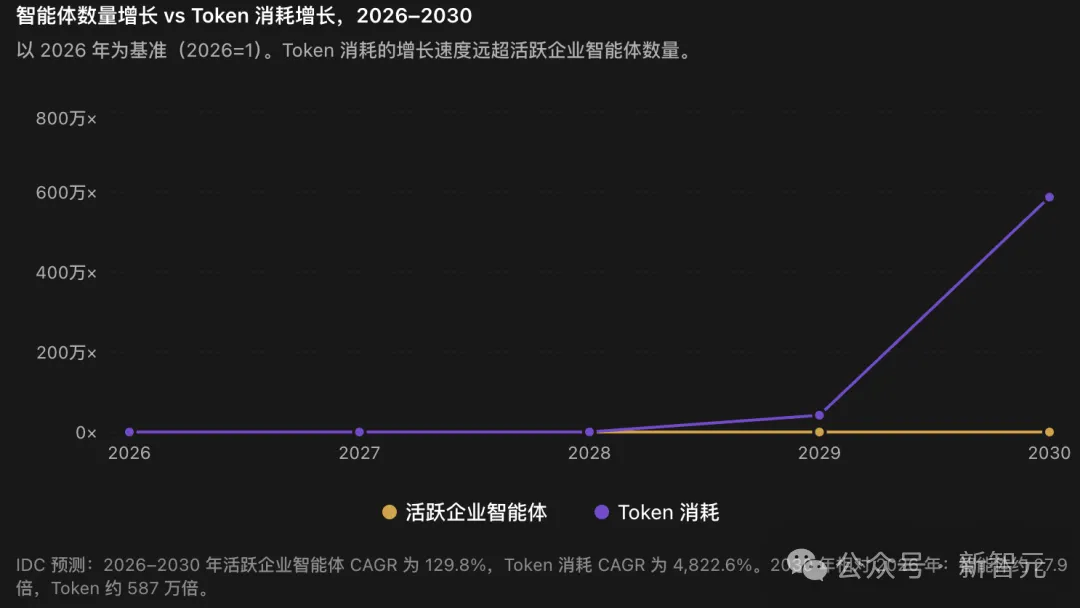
換句話說,AI不再只是偶爾聊天的玩具,而是7x24小時全天候在後台瘋狂運轉的「耗電/耗算力巨獸」。
未來4年,智能體的數量可能是幾十倍的增長,但Token的消耗是數百萬倍的增長。
當所有的企業都在邁向OPC,試圖用Agent替代傳統人力時,算力的需求呈現出了指數級的暴漲。
這也直接導致了一個極其殘酷的現實:算力不僅不夠用,而且越來越貴。
舊卡變「廢鐵」,AI算力不止缺芯
IDC資料顯示,2025年到2030年我國智能算力和通用算力增速預期分別從46.2%上調到50.3%、從18.8%上調到27.7%。
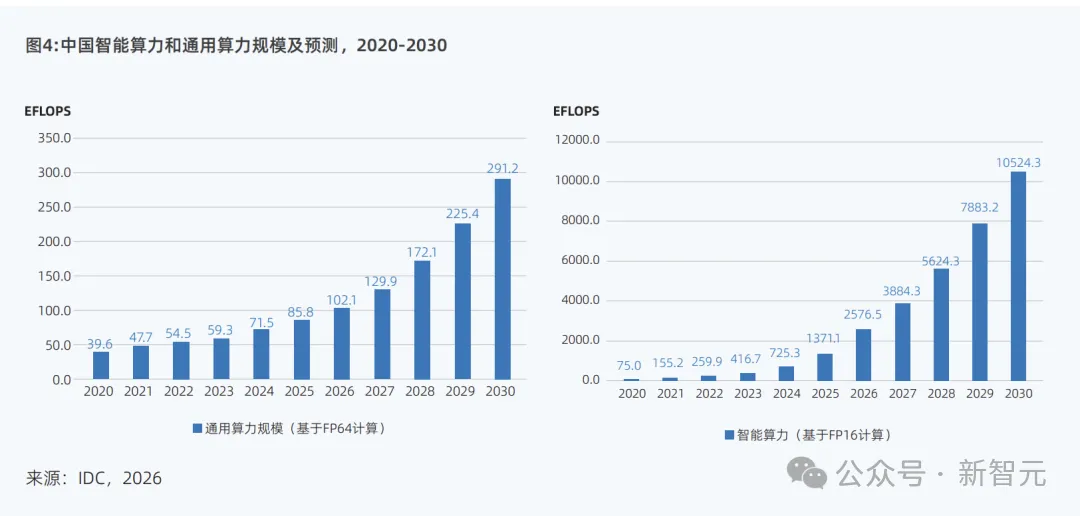
中國智能算力規模2025年達1,371.1 EFLOPS,2026年預計增至2,576.5 EFLOPS、同比增長87.9%,2030年將達10,524.3 EFLOPS,2025—2030年複合增長率50.3%,較上一版本預測的46.2%顯著上調。同期,通用算力規模2025年為85.8 EFLOPS,2026年預計增至102.1 EFLOPS、同比增長19.0%,2030年將達291.2 EFLOPS,復合年均增長率27.7%,亦高於上一版本預測的18.8%。
既然需求這麼大,前兩年各地建了那麼多智算中心,囤了那麼多卡,難道派不上用場嗎?
答案是:錯配,嚴重的結構性錯配。
現實很殘酷——有GPU,絕不等於有適合智能體的算力。
過去兩年,大公司買的算力卡、各地建的智算中心,絕大多數面向「訓練」場景。
訓練追求的是算力的峰值,但Agent時代的「推理」場景,追求的是超大容量的上下文保存(KV Cache)、低時延和極高的吞吐量。
這就像你買了一支頂配的衝刺接力隊,現在卻要求他們去跑一場永無止境的馬拉松,而且還要邊跑邊解複雜的微積分。
此外,還有一些被淘汰下來的中低端算力卡,算力值本就不高,視訊記憶體容量更是可憐,根本存不下Agent動輒幾十萬Token的長鏈路記憶。除了給初學者測試練手,真正的商業價值幾乎為0。
既然存量資源存在「結構性錯配」,那直接砸錢,按需增加新供給、去買適合Agent的算力卡不就行了?
這正是目前行業面臨的第二個困境:物理世界的供給增速,根本追不上數字世界的需求增速。
儘管當下整個AI產業的算力投資力度空前,動輒百億千億,但供給擴張卻難以同步。
因為高端晶片、HBM(高頻寬記憶體)、伺服器CPU等核心部件的產能擴張周期,普遍遠遠長於人工智慧需求的爆發節奏。投資額的成倍增長,並不能在當下等比例轉化為真實的算力供給。
以Agent極度渴求的HBM為例,隨著Agent對長上下文記憶的要求越來越高,KV Cache 既吃容量又吃頻寬,記憶體成為關鍵瓶頸。
雖然記憶體大廠們都在瘋狂鎖定產能,但半導體產線的建設與擴容有著不可踰越的物理時間規律。 你今天砸下百億美金,新建一條先進封裝或記憶體產線到真正上線投產,也需要極其漫長的周期。
在當前的算力賽道上,有錢,你也買不到當下的時間。
更致命的是,能源約束正在讓這一供需矛盾雪上加霜。
資料中心的用電需求,正隨著智能體的規模化、7x24小時全天候運行而激增。
但電力供給受制於電網擴容與關鍵電力裝置交付的長周期。
一個智算中心可能幾個月就能封頂,但支撐它運轉的區域變電站和電網擴容,卻需要數年之久。電力擴容的節奏,已經顯著慢於算力建設的周期。
IDC預測,到2027年,全球AI算力需求滿足率將跌至71%的谷底,這意味著有近三成的算力需求根本得不到滿足。
算力供給錯配,疊加電力短缺等多種其他因素,全球AI行業或恐迎來智能體算力荒。
單卡稱王時代結束,Token新基建來了
既然Agent如此飢渴,我們該如何拯救算力荒?
答案是:徹底拋棄過去的「堆卡」思維,AI基礎設施正在經歷系統性重構。
智能體不再捲「峰值算力」,而是卷「持續的任務執行」,這就要求基礎設施的最佳化目標,必須從「單點性能最佳化」轉向「任務級系統協同最佳化」。
這一轉變,負載變了,焦點變了,採購變了,最後部署變了。
過去,GPU等算力階段性打短工,現在更多是具備長期穩定、高並行特徵的7x24小時「生產型負載」。
Agent時代AI基礎設施的競爭核心是「高效持續生產Token」,實現計算、記憶體、網路/資料中心、終端以及模型、調度和Token營運的全系統協同。
客戶的採購對象,正在從單純買伺服器、買GPU時長,升級為購買「模型能力與Token產出」。
跳出集中式的智算中心,雲-邊-端協同上陣,終端裝置正式成為Agent的運行節點。
為了適應這種重構,報告指出,未來的計算產業競爭將徹底裂變為兩條路線——「能力型智算」與「容量型智算」。
「能力型(Capability)智算」,生來就是為了捅破智能的「天花板」。
就像OpenAI用1萬個Agent破解數學難題一樣,依靠超節點、高速互連等系統級創新,提升算力承載超大模型和複雜任務的能力,不斷突破智能上限。
「容量型(Capacity)智算」,則是為了讓智能越來越便宜、豐富、易獲得。
通過多元算力協同、推理解耦、全鏈條效率提升,把Token產出效率拉滿,降低單位智能的成本,實現智能的規模化普惠供給。
圍繞這兩條路線,整個硬體生態都在發生系統級突變:
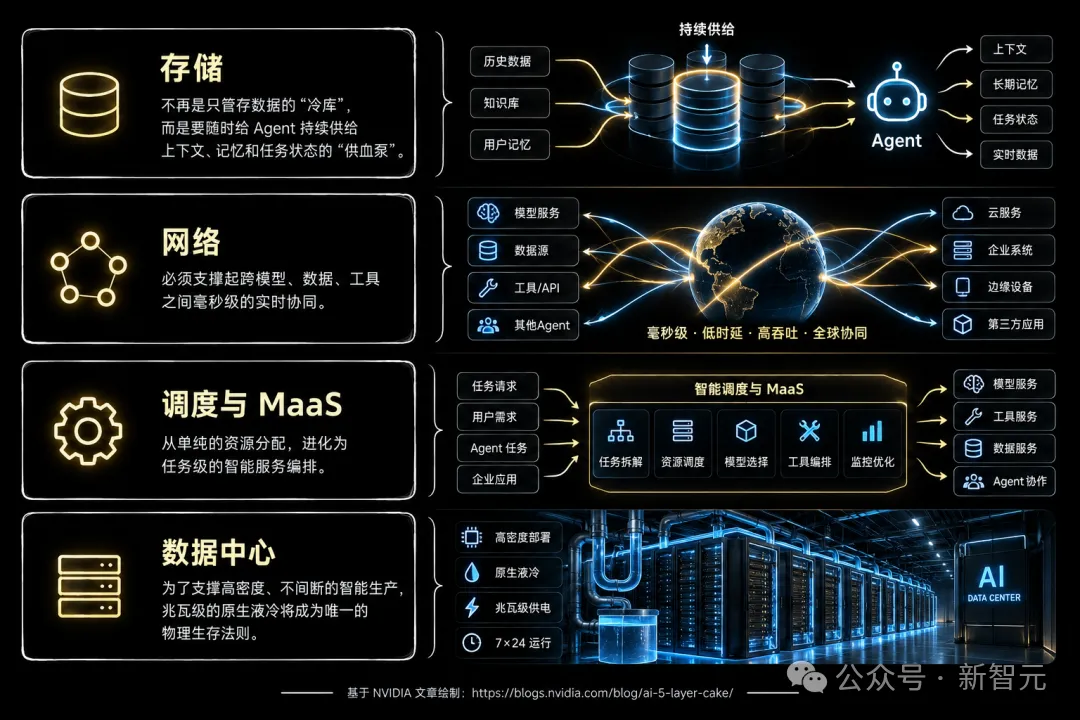
因此,AI基礎設施不再只是一個跑訓練或推理的鐵盒子,而是一座圍繞Agent開發、運行、治理的「全端智能工廠」。
程式碼開發、辦公智能體一騎絕塵,
傳統行業還要熬多久?
報告中的《各行業智能體落地成熟度與長期生產力影響分佈矩陣》,體現了一條深不見底的鴻溝。
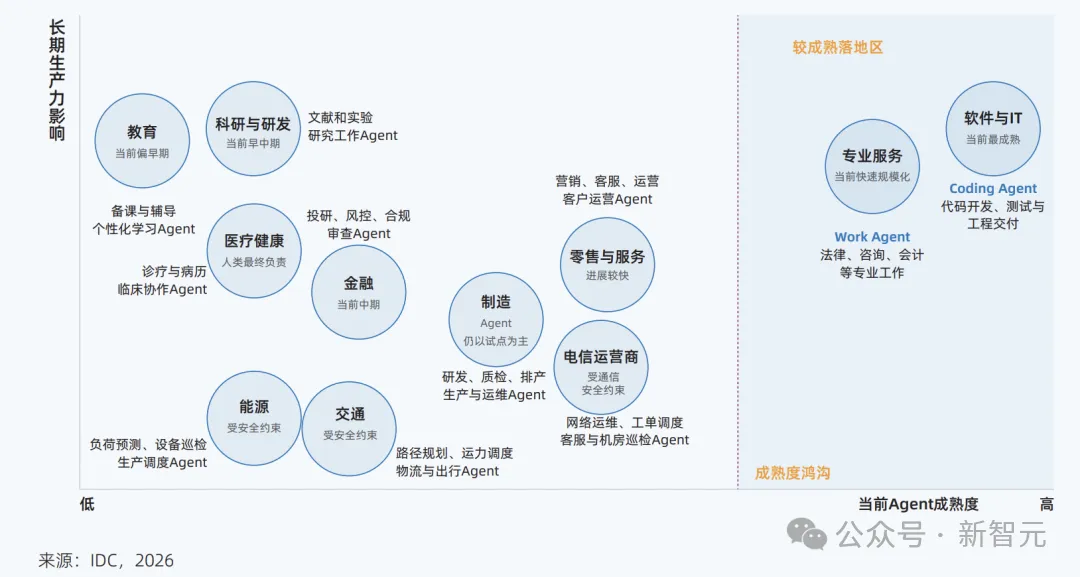
在成熟度的最右端,Coding(程式碼開發)和Work(辦公任務)智能體遙遙領先,已經全面進入規模化應用。這很容易理解,程式碼世界的規則是百分之百數位化的,結果可驗證(跑得通就是跑得通,報錯了AI可以自己改)。
但在鴻溝的另一端,製造、醫療、能源、電力等實體行業,真正進入核心業務並形成完整閉環的比例,依然是尷尬的0%。
為什麼傳統行業落地這麼難?「試錯成本」與「結果驗證」。
你不能讓一個醫療Agent直接在病人身上試錯,然後再把結果反饋給模型去最佳化;你也不能讓一個製造Agent在沒有絕對安全保障的情況下,去接管一條價值上億的真實物理流水線。
但這並不意味著傳統行業沒有機會。
相反,IDC的報告指出,這些行業的「長期生產力重構潛力」恰恰是最大的 。因為它們具有極高的專業知識密度。一旦解決了數字孿生驗證、人機協同責任邊界等問題,Agent或將徹底顛覆這些行業。
「北杭深」霸榜前三,
行業大洗牌了
在這份報告中,最引人注目的莫過於2026年中國人工智慧算力城市排行榜的「大變局」。
北京穩居第一,杭州保持第二,而深圳,強勢殺入前三,上海暫居其後。
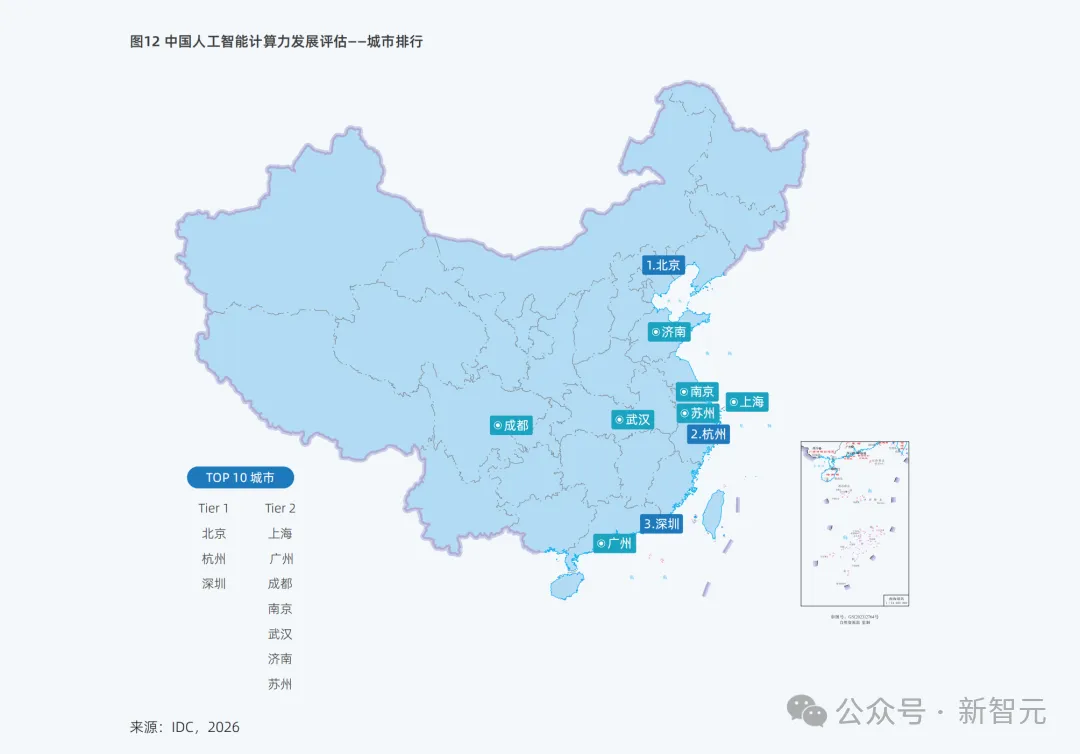
為什麼會發生這樣的排位變化?
核心原因在於,遊戲規則變了。
報告首次將「智能體應用落地」、「具身智能產業佈局」、「大模型開發及推理算力基礎設施建設」納入了核心評價指標。
深圳進入前三,正是因為它死死把握住了Agent爆發與具身智能的硬體結合機遇。
深圳是AI伺服器與算力晶片製造的重要基地,有著深厚的算力供給產業基礎。當AI從虛擬的螢幕裡走出來,進入工廠、進入實體機器人,深圳的算力供給側優勢瞬間被放大。
這給所有二三線城市提了個醒:未來的城市競爭,誰能提供最豐富的Agent落地場景(比如智能製造、智慧港口),誰就能在算力版圖上撕開一道裂口。
大洗牌:泡沫破裂前夜,誰在真正賺AI的錢?
面對如此海量的投入,一個避無可避的問題擺在所有人面前:企業真的賺到錢了嗎?AI算力會過剩嗎?
IDC副總裁周震剛給出了一個非常清醒的回答:「泡沫是存在的,但泡沫的出現不意味著市場沒有價值。」
目前的階段,就像當年早期的雲端運算大戰。
大家都在擴產、搶地盤。在這個「搶跑」階段,利潤大部分都流向了上游的算力卡,以及再上游的半導體廠商。
甚至一些Token服務商在「賠錢賣吆喝」,試圖「以時間換空間」,但這絕非長久之計。
目前爆火的AI短劇、一人公司OPC等,開始讓第一批人嘗到甜頭,但市場終將回歸商業本質,價格終將回歸價值。
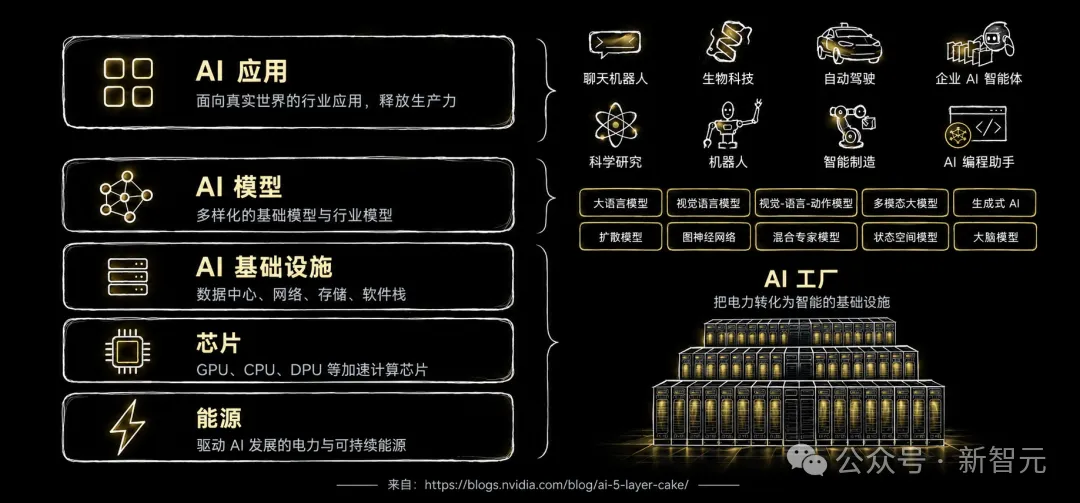
終局將是Token的精細化營運。
Token供應商或將通過Token路由技術,根據具體業務需求,將請求動態分配至更匹配的模型和算力資源,在互動性與吞吐量之間實現動態平衡,從而提升資源利用效率和使用者體驗,提升Token服務的利潤空間。
泡沫破裂的那一天,不是AI的末日,而是洗牌的開始。 (新智元)