
美國卡脖子,卡不住大模型
中美晶片博弈,又有了新變化。
晶片管制本身並不新鮮,美國對輝達先進AI晶片的限制已持續數年。
但新鮮的是,9月12日美國前沿AI公司Anthropic CEO 達里奧·阿莫代伊談到晶片時,把晶片管制放進了一個更大的命題裡:美國可以放慢AI發展的速度,前提是不能讓中國追上來。
在X平台發佈的長文《We Must Pace the Frontier》中,阿莫代伊還提出,美國應繼續限制向中國出售先進AI晶片和半導體製造裝置,同時打擊晶片走私、海外資料中心遠端獲取先進算力以及模型蒸餾。他認為,這些措施可以在未來3-5年顯著拉大美國與中國的AI領先差距。
即,把晶片、算力與前沿AI發展速度、中美AI競爭直接聯絡起來。
這意味著,過去,晶片管制解決的是中國能不能拿到最先進的卡;現在,它開始被放進另一個問題裡:中國還能不能獲得支撐下一輪AI躍遷的先進算力。
而資本市場真正交易的,恰是預期鏈:算力受限→國產晶片接不接得住→接住的成本是多少。
問題也因此變得緊迫。
而阿莫代伊所說的未來3-5年,恰恰也是國內大模型繼續迭代、推理需求持續增長的階段。
如果高端晶片真的買不到,中國大模型能不能繼續運行?
更重要的是,誰能在算力受限的情況下,把每一張國產晶片的價值榨得更高,產生更多、更便宜的Token?
這是這一輪國產算力替代,真正值得資本市場重新審視的地方。
高端晶片買不到,中國大模型也不會因此停下來。
因為算力的供給側已經發生變化了。
過去幾年,在高端晶片供給受限、算力獲取的不確定性急劇上升的背景下,中國大模型企業開始推進國產算力的替代。
從目前已經出現的案例看,國產算力已具備支撐大模型運行的能力。
也就是說,即使高端晶片買不到,國產算力至少可以為中國大模型提供一層兜底。
且兜底的證據正在變多。
一是推理側。智譜國產晶片推理叢集已達10萬卡規模,GLM-5.3-Flash線上流量全部運行在國產晶片上,其匿名模型Ox-Alpha在海外平台累計處理62萬億Token,已經進入真實Token生產環節。
二是訓練側。美團LongCat-2.0已經在大規模國產算力上完成訓練;還有粵港澳“國芯訓國模”等項目也在推進萬卡級國產訓練等。
但能跑和跑得好是兩回事。
如昇騰910C在萬億參數模型的全參數後訓練任務中,衡量訓練效能的核心指標MFU約30%-35%,而同等級任務H100叢集通常可達40%-50%。這意味著,同樣的錢和時間,國產算力暫時還訓不出同樣的模型。
因此,對大模型而言,算力供給只是第一關。
真正決定競爭力的,是第二關算力效率。它回答的是,有限的算力能夠產生多少有效產能。
而大模型的算力效率,至少由三個變數共同決定:晶片(單卡性能、互聯頻寬、記憶體、能效)、軟體(編譯器、算子、推理框架、通訊庫、調度)、模型(MoE架構、稀疏注意力、低精度計算、KV Cache最佳化)。
粗略地說,單位Token成本 ≈ 晶片成本 ÷(晶片性能 × 軟體利用率 × 模型效率)。
三個變數的現狀並不均衡。晶片決定算力供給的上限,也是當前最難快速彌補的變數;軟體決定硬體性能能夠釋放多少,模型則決定完成同樣任務需要多少算力。
當晶片供給短期難以改變時,軟體和模型就成為大模型公司更主動的最佳化空間。
這也解釋了為什麼,國產算力替代並不只是晶片廠商的生意,大模型公司本身也開始參與到軟體適配、系統最佳化和模型效率提升中。
目前,幾家頭部大模型公司的實踐,正是圍繞這條邏輯展開的不同路徑。
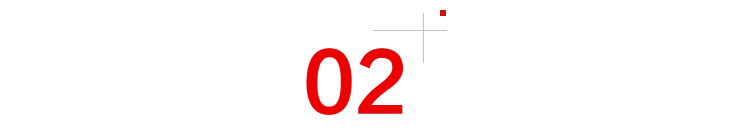
四家公司的答案各不相同。
其中,智譜要證明重資產能換來成本優勢,MiniMax要證明自建算力能承接真實流量,DeepSeek要證明模型效率能替代晶片性能,Kimi要證明生態能替自己補足算力。
它們解決的問題不同,但最終指向的都是把有限的算力,儘可能快地轉化成更多、更便宜的Token。具體分析如下:
(1)智譜:算力全端閉環,能否兌現成成本優勢。
智譜選擇的是重資產路線。
從租賃GPU,到採購Token工廠服務,再到All-in-Infra,國產晶片已是主力推理算力,還收購中科加禾補齊編譯器與推理引擎軟體棧,把更多算力基礎設施掌握在自己手裡。
更值得關注的是,智譜9月完成50億美元融資後,獲得了繼續擴張訓練和推理基礎設施的資金。且管理層交流會上明確表示,算力供給短期內不再是收入增長的主要約束。
但自建算力並不意味著成本一定下降。
資料中心、晶片、網路和電力都需要資本投入,後續還要承擔折舊和維運成本。
所以智譜真正需要證明的是,把算力從外部租賃變成自己擁有之後,能不能提高利用率,並最終降低單位Token成本。
雖然智譜管理層在交流時,首次給出了算力投入的量化測算。300億元算力投入約對應10萬P算力,其中40%用於訓練研發、60%用於業務推理。依託GLM-5.3的推理性價比,理論推理毛利最高可達80%,算力利用率打滿全價的情況下,年收益可達400億元。
即一年下來不僅能覆蓋全部算力投入,還能承擔模型訓練研發費用,理論上可以把算力從成本中心變成可以計算回報的資產。
這套測算真正能否成立,還要回到經營資料驗證。所以下一階段最值得看的,是單位Token成本、毛利率能否持續改善。
如果下一年這些指標均有改善,才能證明重資產算力投入真正從成本中心變成生產能力。否則,資本市場可能會下行調整。
(2)MiniMax:從租算力走向擁有可控算力,先看落地。
MiniMax面對的是另一個問題。
2025年前三季度,公司雲端運算服務成本佔銷售成本的比例超過90%。這意味著,模型呼叫量增長的同時,算力成本也會快速增加。
所以MiniMax開始從租賃算力,逐步轉向自建國產算力叢集,M3、H3等模型也開始推進國產晶片適配。
它的驗證順序比智譜多一步。
因為算力叢集剛開始建設,第一步要驗證的其實是這些算力能不能從建起來,真正走到跑起來。只有當MiniMax也像智譜一樣,已經開始用國產晶片承載真實推理流量後,那麼,從租算力到擁有可控算力,才真正完成了第一步。
到了那時,市場才會進一步追問,擁有算力之後,MiniMax能不能讓更多Token以更低的成本被生產出來?
所以,MiniMax還處於算力從建設走向生產的驗證階段。後續可跟蹤的,是國產叢集的落地進展和模型適配進度。只有叢集真正上線並承載真實流量,模型適配才可能轉化為實際的成本改善。在此之前,MiniMax的算力自主化仍是一個待兌現的事。
(3)DeepSeek(籌備科創板IPO):把模型效率變成競爭的一部分。
如果說智譜和MiniMax在解決國產算力承載能不能跑、能不能握在自己手裡的問題,那麼DeepSeek的看點是它站在效率側,不糾結於擁有多少算力,而是執著於同樣的算力能跑出多少Token。
這條路線最特別的地方在於,它與管制邏輯天然避險。管制晶片想讓算力變貴,模型效率想讓算力變便宜,兩者相互抵消。這正是DeepSeek區別於其他企業的戰略底色。
需說明的是,DeepSeek並非獨有某項技術,MoE、低精度、KV Cache最佳化、稀疏注意力等,已經成為整個大模型行業持續最佳化的共同方向。
真正值得關注的地方,是DeepSeek長期把模型效率放在架構設計的核心位置,而非當作錦上添花的工程手段。
但國產算力替代層面,這條路線能否繼續跑通,待驗證。
2026年4月V4發佈時,DeepSeek明確表示受限於高端算力、Pro版吞吐有限,預計昇騰950超節點批次上市後價格會大幅下調;而8月V4-Pro的漲價,恰恰暴露了現實約束。在國產算力穩定供給之前,Pro版仍受制於晶片。
真正的產能賭注,是DeepSeek在烏蘭察布資料中心部署的16萬卡叢集,據彭博社報導要到2027年底至2028年初才逐步投產。
即,DeepSeek當前定價中包含的是2027—2028年的產能預期。 如果16萬卡如期投產、950如期放量,單位Token成本有望降到行業最低,彈性是四家最大的;但"如期"兩個字,就是它最大的不確定性。交付每延期一個季度,彈性敘事就整體後移一個季度。
所以,下一階段最值得看的,是價格。國產算力形成穩定產能之後,Pro版價格能否實質性下調。那是自研晶片、國產適配、自建資料中心三條線能否匯成真實成本優勢的驗收點。
(4)Kimi(月之暗面,申報IPO):用生態降低適配成本和時間。
Kimi代表的是另一條路徑,通過開放模型和生態合作,縮短國產晶片從拿到手到真正可用的適配週期。如華為昇騰、阿里平頭哥、海光、摩爾執行緒、壁仞等均在Kimi模型開源後第一時間宣佈適配。
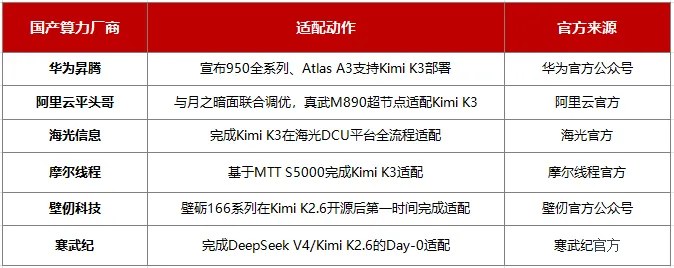
此路線的優勢是不用自己投入大量資源,適配成本較低。
但它也暴露了另一個問題,適配成功,不等於算力供給充足。
K3發佈後使用者請求量爆發,逼近現有叢集承載極限,後被迫暫停C端新使用者註冊。算力仍是硬約束,產品需求爆發時容易被算力卡脖子。
所以Kimi這條路線解決的是國產晶片怎麼更快用起來,但能否解決算力瓶頸,仍需驗證。在此之前,公司的業績增長可能會受到算力的掣肘。
把四家公司放在一起看,會發現適配路線解決"跑得了",算力自主解決"跑得起、跑得住"。觀察點是叢集擴容,驗證點是下一次需求爆發時還會不會被卡住。
綜上,晶片越來越難買到的情況下,把輝達的卡換成國產卡,並不是目的。真正需要觀察的,是國產算力能不能從“備份算力”變成一套真正有效率、能產生商業回報的生產能力。
進展如何,有三大跟蹤指標:
第一,產能(能跑)。
對我們投資者而言,叢集到底有多少卡很難知道,但資料中心和算力叢集的投產進度、國產晶片採購和部署規模,以及大模型公司是否已經開始用這些算力承載真實業務是可以跟蹤的。
如MiniMax的國產算力叢集落地進展;昇騰950的放量,以及DeepSeek在烏蘭察布16萬卡國產算力的投產進度等。
第二,效率(跑得好不好)。
這一層不必強求企業披露單卡Token產出等內部指標,更重要的是看同樣的算力投入,能不能支撐更多模型呼叫和更大的業務量。觀察訊號包括:模型呼叫量增長、Token使用量增長、國產算力承載的業務規模,以及公司是否持續發佈模型側的降算力、降視訊記憶體等最佳化。
第三,成本(能不能賺錢)。
最終還是要回到財務資料。看單位Token成本有沒有下降,推理業務毛利率有沒有改善,以及API價格下降之後,利潤能不能保持增長。對於上市公司或準備上市的大模型企業,這些資料最終都會反映到收入、毛利率和現金流上。
如果上述指標同時改善,國產算力從備份選項就轉變成了成本優勢;但如果只有適配、沒有效率,國產算力替代的敘事就很難持續。
而如果一定要給上述四條路徑排一個順序,短期確定性最高的是智譜,中期彈性最大的是DeepSeek,MiniMax和Kimi仍在驗證期。
回到開頭的問題,高端晶片如果買不到了,中國大模型未必會停下來。但屆時誰還能以足夠低的成本繼續跑,誰就可能在“國產替代敘事”基礎上,進一步獲得更高的估值溢價。 (虎嗅APP)