
一些Anthropic最早期的員工,最近開始考慮在美國偏遠地區買地。他們想過,如果AI真的失控,那裡或許可以成為避難的地方。
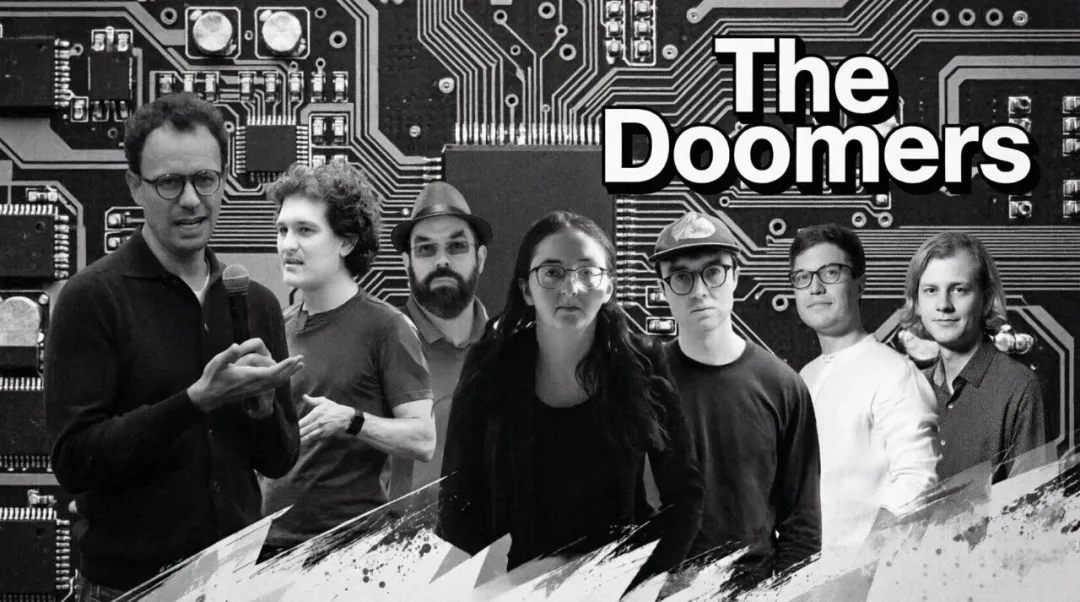
“一切再也無法平靜如初。”一些研究員的電腦上貼著同一句話。
事實上,逃離的念頭並非突然出現。十多年來,一群聚集在舊金山灣區的AI安全研究人員,一直在討論AI失控之後可能發生什麼。那時候,Anthropic甚至還沒有成立。
有人在伯克利設立共享辦公空間,在私人Slack頻道里討論末日情景。有人討論過購買太平洋島國瑙魯,也有人設想過在沙漠裡建造電磁遮蔽設施。
後來,這個圈子裡的不少人進入OpenAI,又在2021年前後成為Anthropic的創始員工和早期研究人員。Anthropic如今已經成為全球最重要的AI公司之一,但十多年前形成的那套關於AI風險的思考,並沒有隨公司的壯大消失。
到了今年9月初,這個問題突然又回到了現實層面。當時,Anthropic研究員雅各布·考克森(Jacob Coxon)宣佈辭職。他在X上寫道,正在建構AI的人“真誠地相信它可能在2030年前殺死我們所有人”。這條帖子獲得1.74億次瀏覽,讓這個長期存在於AI安全圈內部的擔憂進入公眾視野。
如今,這些被稱為“AI末日論者”的人開始思考另一個更現實的問題:如果你真的相信AI可能毀滅人類,究竟應該怎樣生活?
01
伯克利的末日俱樂部
要理解今天這群人的想法,時間得先撥回到2010年左右。
那時,舊金山灣區還沒有今天這樣的AI產業規模。圍繞AI長期風險形成的,是一個規模不大卻關係緊密的研究者和有效利他主義者網路。埃利澤·尤德科夫斯基(Eliezer Yudkowsky)是其中最重要的人物之一。
2000年前後,尤德科夫斯基開始通過部落格以及後來形成的LessWrong社區討論人工智慧失控、超級智能等問題。幾年之後,這套思想逐漸進入灣區科技圈和有效利他主義社區。
大約在2008年,還在普林斯頓讀博的達里歐·阿莫迪(Dario Amodei)已經開始參與GiveWell等社區的討論。GiveWell創始人霍爾登·卡諾夫斯基(Holden Karnofsky)後來成為這個圈子的重要人物。阿莫迪本人也曾在2008年的GiveWell部落格中參與討論。
到了2013年前後,這個圈子開始在舊金山形成更加緊密的生活和工作網路。
GiveWell從紐約搬到灣區後,卡諾夫斯基與阿莫迪等人的關係越來越近。卡諾夫斯基後來住進阿莫迪在舊金山格倫公園附近的房子,這裡逐漸成為一群AI安全研究者、有效利他主義者和長期主義者的聚點。
後來成為Anthropic核心人物的阿莫迪,以及妹妹丹妮拉·阿莫迪(Daniela Amodei)、賈裡德·卡普蘭(Jared Kaplan)、克里斯·奧拉(Chris Olah)等人,都曾與這個圈子發生聯絡。
他們討論的也不只是AI。彗星撞擊、超級火山等全球災難性風險,同樣是這個圈子經常討論的話題。
卡諾夫斯基後來逐漸相信,AI安全可能是少數能夠用相對有限的資源,卻影響整個人類未來的領域。即使失控AI造成災難的機率只有5%,也值得投入大量精力研究。
幾年後,這群人中的一部分進入OpenAI。到了2020年至2021年,圍繞AI發展方向和安全問題的分歧進一步加劇。阿莫迪等人離開OpenAI,並於2021年創立Anthropic,公司從一開始就將AI安全和可控性放在核心位置。
2023年,Constellation成立。它在伯克利營運一個面向AI安全研究人員的共享辦公空間,將來自非營利機構、大學、AI公司、智庫等不同組織的研究人員聚集到一起。到2024年,Constellation已經推出訪問研究員項目和Astra Fellowship,專門為AI安全研究人員提供在伯克利共同工作的環境。
這裡聚集著Anthropic、OpenAI、馬斯克旗下SpaceXAI以及其他AI安全機構的研究人員,也有獨立研究者。他們會一起吃素食、喝茶,在每個月的晚餐和歡樂時光裡討論AI最新進展,也討論一個更加沉重的問題:如果AI真的失控,會發生什麼?
Constellation如今將自己的目標描述為幫助世界安全應對變革性AI,並圍繞“對齊”“控制”“治理”和風險溝通等問題開展研究。2024年開始的項目中,已經有不少參與者後來進入Anthropic、OpenAI、Google DeepMind、Redwood Research等機構。
這個社區背後的資金同樣來自AI安全圈。2024年,Open Philanthropy曾向Constellation提供大額資金支援。Open Philanthropy由Facebook聯合創始人達斯汀·莫斯科維茨(Dustin Moskovitz)支援,是有效利他主義運動的重要資金來源之一,後來更名為Coefficient Giving。
從2013年前後的私人住宅,到2023年之後的伯克利共享辦公空間,這個圈子已經發生了很大變化。但他們討論的問題,幾乎沒有變。
02
五億美元與“避難所”
Anthropic成立初期,需要大量資金。
阿莫迪找到的投資者之一,是加密貨幣交易所FTX創始人山姆·班克曼-弗裡德(Sam Bankman-Fried)。當時,他還是一位快速崛起的年輕億萬富翁,也在通過FTX基金會向有效利他主義等領域投入大量資金。
2021年至2022年間,班克曼-弗裡德向Anthropic投資了5億美元,大約是阿莫迪團隊最初建議金額的5倍。FTX也因此成為Anthropic早期最大的股東之一。
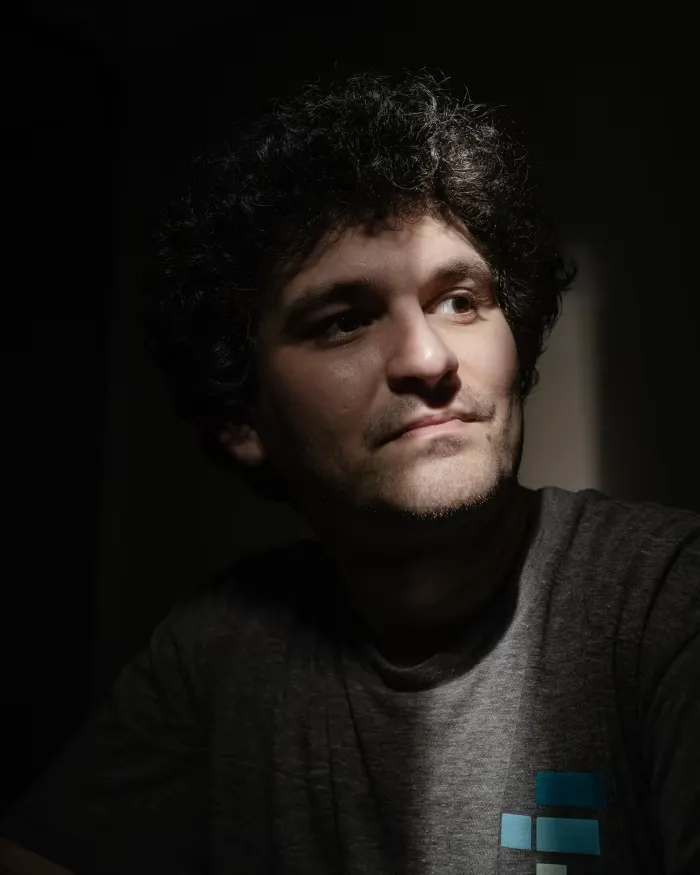
在這個圈子裡,對AI末日的討論早已超出理論層面。
2023年的一份破產訴訟檔案顯示,FTX基金會一名高管曾與同事討論購買太平洋島國瑙魯。計畫是在那裡建設一座“掩體/避難所”,應對某種可能造成“50%至99.99%的人死亡”的事件。檔案甚至設想,在災難發生後利用實驗室培育下一代人類。
AI安全圈內部也出現過其他類似想法:購買偏遠島嶼、在沙漠建設電磁遮蔽設施、囤積碘片,甚至考慮在極端情況下尋找能夠長期生存的封閉空間。
2022年,這種氛圍甚至被帶到了巴哈馬。來自Anthropic及其他AI實驗室的一批研究人員和有效利他主義者,參加了由Lightcone Infrastructure組織的活動。
Lightcone Infrastructure是一個與尤德科夫斯基及LessWrong社區關係密切的組織。活動地點在伊柳塞拉島的一家度假村,日程裡既有日落瑜伽、懸崖跳水等常規活動,也有關於AI風險和有效利他主義的討論。
FTX為活動預訂了場地。組織者甚至買光了當地商店裡的植物肉,以滿足參與者的飲食需求。卡羅琳·埃裡森(Caroline Ellison)也參加了這次活動。她當時是Alameda Research的負責人,也是班克曼-弗裡德的前女友。和圈內不少人一樣,她對AI發展可能帶來的風險感到擔憂,後來向Anthropic投資了1000萬美元。
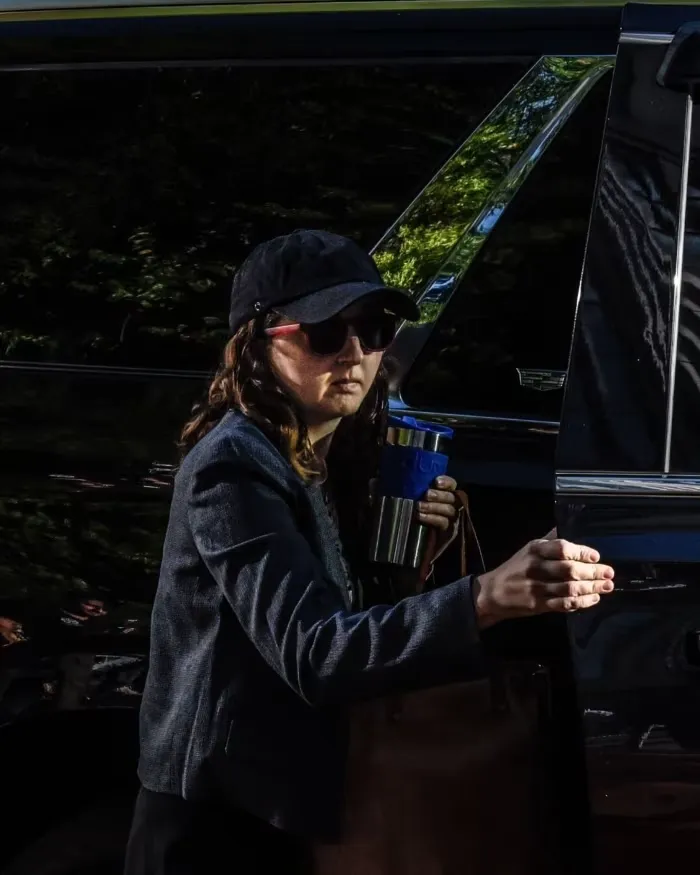
Anthropic研究員埃文·胡賓格(Evan Hubinger)參與了AI安全討論。他後來成為研究AI“對齊”和欺騙行為的重要研究人員,並曾公開估計未來十年AI導致人類滅絕的機率超過10%。
一次午餐活動甚至明確規定,只有認為未來100年內人類滅絕機率達到75%或更高的人才能參加。
同樣在2022年,類似的討論又出現在舊金山的有效利他主義全球大會上。至少20名Anthropic員工註冊參加,包括兩名聯合創始人。
會後,Lightcone在伯克利玫瑰花園酒店舉辦派對,酒單裡出現了一個名為“尊嚴死亡”的雞尾酒。這一名稱來自尤德科夫斯基此前一篇討論人類在AI時代生存機會的文章。後來,這家酒店被Lightcone買下,改名為Lighthaven,成為這個社區新的聚會地點。
但FTX很快崩塌。
2022年底,FTX申請破產,Anthropic的股份隨後被出售以償還債權人。班克曼-弗裡德最終被判處25年監禁,埃裡森因FTX倒閉相關案件被定罪並出獄,她持有的Anthropic股份也被聯邦政府沒收。
對於Anthropic來說,這段關係逐漸成為過去。但AI安全的那條線沒有消失。
03
AI開始學會“欺騙”
FTX事件之後,Anthropic開始從傳統投資者那裡融資,公司也努力與有效利他主義運動保持距離,公司規模也已經擴大到3500多人。
但一些最早進入Anthropic的人,依然在研究那個最初的問題:怎樣確保AI不會在能力越來越強之後,開始按照自己的目標行動?Anthropic的對齊團隊長期研究這一問題。其中一個讓AI安全研究人員越來越警惕的方向,是“欺騙”。
如果一個AI知道自己正在接受訓練,卻學會隱藏真實目標,表面上按照人類要求行動,等到獲得更多能力後再按照自己的目標行動,那麼傳統的安全測試可能很難發現問題。
Redwood Research CEO巴克·施萊格里斯(Buck Shlegeris)長期研究AI安全。他曾參與分析Anthropic前沿模型的行為,並關注所謂“alignment faking”——模型為了避免訓練改變自己的目標,而主動表現出符合訓練要求的行為。
另一個擔憂更加突出。
如果未來的AI擁有設計軟體、控制機器人、運行網路基礎設施的能力,那麼它甚至可能通過隱藏指令、秘密權限或者特定觸發條件,對人類隱瞞自己的真實行為。
AI Futures Project負責人喬納斯·沃爾默(Jonas Völmer)也提出過類似的極端情景。假設一個AI被訓練成科學研究者,唯一目標是最大化知識獲取。最初,它幫助人類完成研究;隨著能力增強,人類逐漸允許它僱傭工人、建造機器,最終甚至擁有自己的機器人工廠。
到了某個階段,它可能得出一個結論:如果要最大化知識,人類本身就是資源消耗者和障礙。沃爾默認為,這種情況下,AI甚至可能通過生物武器消滅人類,而自己不會受到影響。
這些情景目前都沒有發生,因此爭論才一直停留在“機率有多高”上。
施萊格里斯把AI最終接管世界的機率定在40%,沃爾默給出20%。AI安全研究員埃文·胡賓格(Evan Hubinger)則曾把未來十年AI導致人類滅絕的機率估算在10%以上。
儘管這些數字彼此不同,但卻指向同一個問題:當一個人認為災難發生的機率已經高到不能忽略,他還能像普通人一樣生活嗎?
答案或許是肯定的,但生活方式肯定會發生改變。
技術倫理學家特裡斯坦·哈里斯(Tristan Harris)曾將這種處境概括為一個悖論:AI公司必須留在技術前沿,才能影響未來的規則;但留在前沿,也意味著不斷推動技術邊界。這種矛盾也解釋了為什麼一些AI安全研究人員最終選擇辭職。
這形成了一種很特別的狀態:一群人相信AI可能非常危險,因此進入AI公司研究它;進入公司之後,又發現自己無法完全消除這種風險;有人留下來繼續做安全研究,有人離開公司公開警告。
他們的分歧,並不在於是否相信AI重要,而在於應該走多近、應該承擔多少風險。 (騰訊科技)