
KV Cache從"臨時變數"變成"持久資產"——記憶體容量和訪問速度,正在直接決定智能體的記憶能力。
開篇:那個越寫越厚的"草稿本"
一個AI智能體正在處理百萬級token的對話歷史。它要反覆回放上下文、呼叫工具、多步推理——每走一步,都要把已經"記住"的內容再讀一遍。
這個"記住"的載體,叫KV Cache。它像一個越寫越厚的草稿本:對話越長,草稿越厚,轉眼就佔滿了昂貴稀缺的GPU視訊記憶體。據中信證券測算,上下文從8K激增到1M tokens時,單使用者FP16精度下的KV Cache視訊記憶體佔用會從約5GB飆升至640GB以上——而一張頂級GPU的HBM視訊記憶體,不過百GB量級。
視訊記憶體放不下怎麼辦?
答案指向一個被低估的方向:記憶體。當AI從"簡單對話"走向"智能體",記憶體的角色正在發生質變——從"資料倉儲"變成"算力放大器"。存力,正在接棒算力,成為AI基建投入的新主戰場。
一、範式轉移:推理時代,記憶體被推向瓶頸中心
先看負載結構的變化。
據中國信通院資料顯示,2026年計算工作負載中推理佔比將提升至66%——推理取代訓練成為算力消耗的主體。華泰證券2026年7月研報的判斷與之呼應:AI產業正從大模型預訓練切換至AI Agent商業化落地,推理算力需求進入加速增長通道。
輝達GTC 2026大會上的措辭變化同樣值得注意。黃仁勳提出,行業競爭已從"大模型時代"發展到"token產能時代",未來的資料中心不再是記憶體檔案的倉庫,而是生產token的工廠。中信證券在轉述GTC 2026時將其概括為"Token工廠經濟學",並點出其核心意義:記憶體在AI基礎設施中的戰略地位被強化——頻寬與容量等存力指標,已成為系統升級的核心。
為什麼會這樣?因為推理與訓練對記憶體的依賴完全不同。
訓練是"離線批處理":資料一次性寫入,算完即走。推理是"線上服務":模型要持續響應、反覆讀寫,每一次對話、每一個token都在與記憶體打交道。當推理佔據66%的工作負載,記憶體的每一次"慢"都會直接變成使用者的等待。
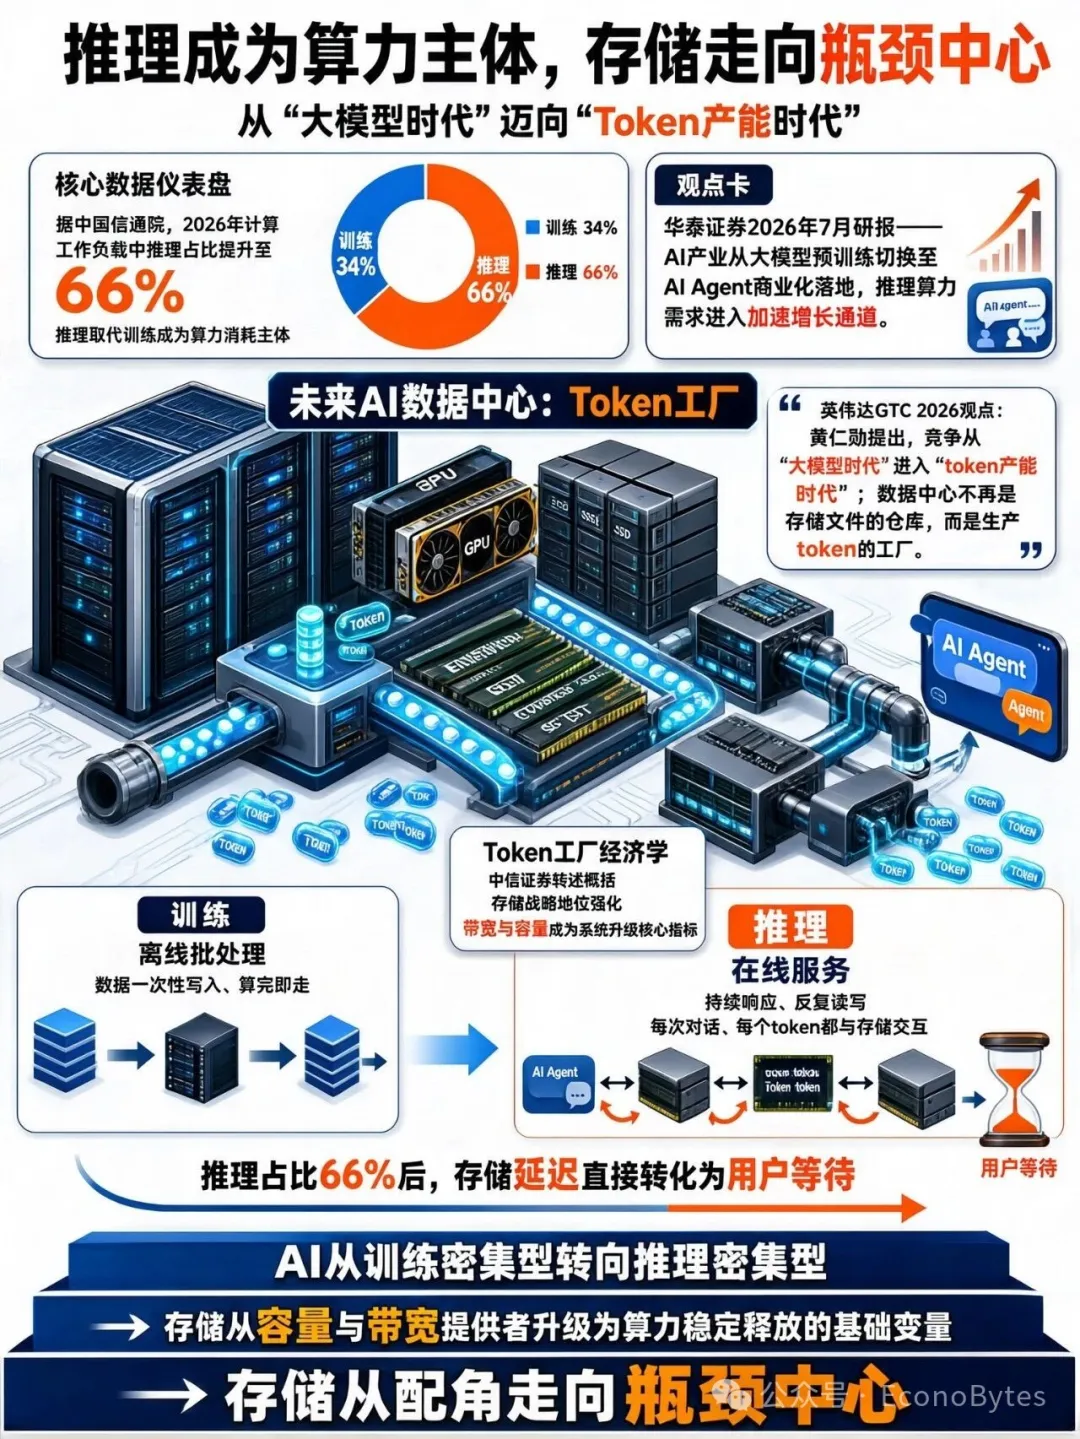
記憶體不再只是容量與頻寬的提供者,而是決定算力能否被穩定釋放的基礎變數。AI正從"訓練密集型"轉向"推理密集型",記憶體從"配角"走向"瓶頸中心"。
二、技術原理一:KV Cache膨脹——智能體的"記憶黑洞"
理解這場範式轉移,要先理解KV Cache。
大模型處理長文字分兩個階段:預填充階段把輸入一次性算完,生成KV鍵值向量;解碼階段逐token生成輸出,每個新token都要與之前的KV做注意力計算。KV Cache的作用,就是在預填充階段把鍵值向量存下來,避免解碼階段重複計算——它是"以算力換時間"的產物。
問題在於,KV Cache是隨上下文長度動態膨脹的。
資料說話:據中信證券研報(Llama-3-70B、GQA級、FP16口徑),上下文從8K到1M tokens,單使用者KV Cache視訊記憶體佔用從約5GB飆升至640GB以上。放到更長的時間尺度,記憶體廠商VAST Data的測算顯示,單會話64K token的KV Cache已約30GB、128K約61GB;業內普遍的技術推演是——當上下文從64K增長到1000萬token,KV Cache需求將從百GB級跳升至TB級。
輝達對此的表述很直接:上下文窗口正增長到數十萬乃至數百萬token,KV Cache正在超出GPU HBM的容量。
智能體的工作方式讓這個矛盾雪上加霜。智能體不是一次對話就結束——它要反覆呼叫工具、回放歷史、多輪試錯,百萬級token的對話歷史被一遍遍讀取。KV Cache從"臨時變數"變成了"持久資產",記憶體容量和訪問速度直接決定智能體的"記憶能力"。
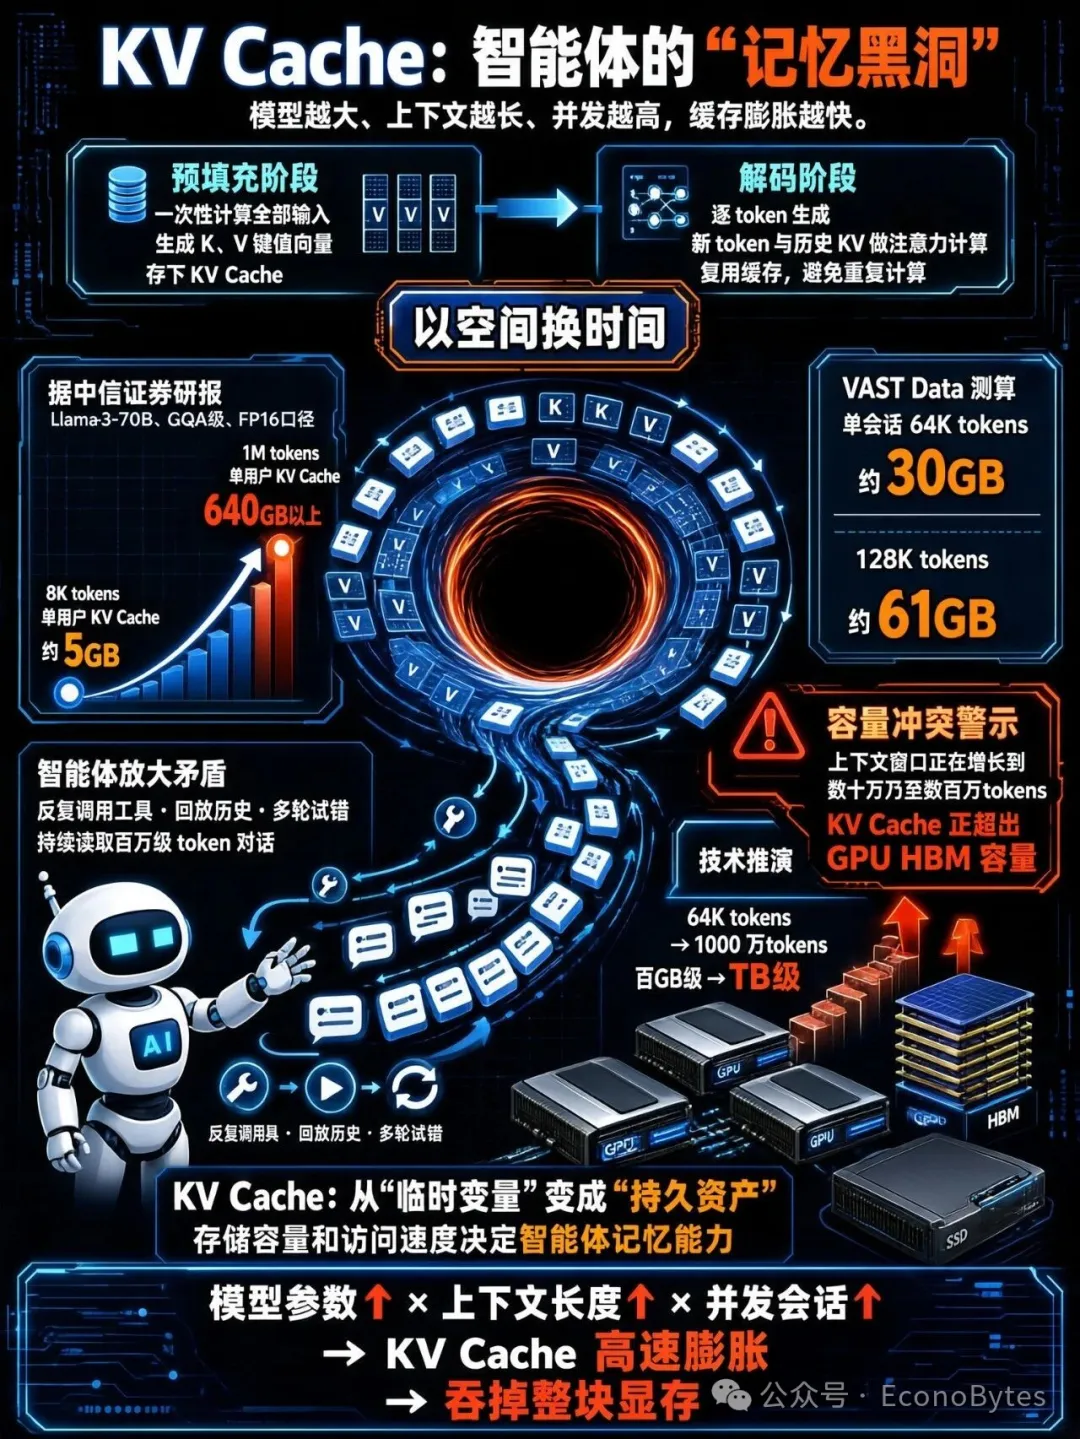
KV Cache是智能體的"記憶黑洞":模型越大、上下文越長、並行越高,它膨脹得越快,直到吞掉整塊視訊記憶體。
三、技術原理二:從"以存換算"到記憶體層級重構
視訊記憶體放不下,行業給出的解法是"以存換算"——把已經算好的KV Cache保存到更便宜的記憶體層級,後續請求直接復用,減少重複計算。天風證券將其概括為CachedAttention式的"以存代算",把KV Cache快取到HBM+DRAM+SSD的多級記憶體中。
輝達是這輪重構的旗手。2025年3月,輝達發佈KV快取解除安裝軟體Dynamo,把訪問頻率較低的KV快取解除安裝到CPU記憶體和SSD等容量更大、成本更低的層級;2026年初,輝達發佈由BlueField-4 DPU管理的CMX情境記憶記憶體平台(GTC 2026全面亮相),以64顆BlueField-4 DPU管理整櫃約9600TB的容量,擴展Local SSD與共享記憶體之間的"記憶層級"。英特爾也在跟進——2026年9月推出KVShrink智能體記憶分層解除安裝方案,熱資料常駐GPU HBM、歷史資料分層解除安裝,配合硬體壓縮加速。
這些產品背後,是記憶體層級的一次系統性重構。
傳統架構是"記憶體-硬碟"二元結構:快的太貴,便宜的太慢。新的架構正在演變為多層金字塔——以TrendForce對推理場景的劃分為例:頂端是GPU片上SRAM,往下依次是HBM、系統DRAM、本地SSD,底層是共享記憶體;中間還插入了HBF(高頻寬快閃記憶體)與SSD POD等全新層級。
輝達Dynamo的解除安裝路徑清晰地標註了這條鏈路:G1 GPU HBM → G2 CPU記憶體 → G3本地SSD → G3.5 SSD POD → G4共享記憶體。每一級都是一次"性能換容量"的折中,而每一級的存在,都是為了同一個目標:讓最貴的HBM只裝最熱的資料,讓其餘的記憶有序地流向更便宜的層級。
記憶體不再是"存資料"的地方,而是"存算力"的延伸——記憶體層級越豐富,算力釋放越充分。
四、需求升級:從"訓練一次性讀寫"到"推理高頻讀寫"
層級重構的背後,是讀寫模式的根本性變化。
輝達官方技術部落格對LLM推理的定性很明確:解碼階段是memory-bound(記憶體受限)操作——資料從記憶體搬運到GPU的速度主導了延遲,計算單元在大部分時間裡等待資料。推理的記憶體負載構成也遠比訓練複雜:模型權重(靜態)、KV Cache(動態膨脹)、啟動值(瞬時)、RAG向量庫(持續增長),四類負載對記憶體提出了截然不同的要求。
讀寫模式因此發生了三重質變:
- 頻率:從訓練"小時級"的批處理讀寫,變成推理"毫秒級"的即時互動;
- 模式:從"一次寫入、多次讀取"的流水線,變成"高頻讀寫、隨機訪問"的並行流;
- 敏感度:從延遲"可容忍"(訓練慢幾小時無所謂),變成延遲"致命"(推理慢一秒使用者就流失)。
硬體配置的演變印證了這一變化。據TrendForce與券商測算口徑,AI伺服器的DRAM平均搭載量已達1.2-1.7TB,較普通雙路伺服器提升4-8倍(招商證券口徑為相較1TB級高性能伺服器提升2.5-3倍);方正證券測算,AI伺服器單機SSD的價值量較普通伺服器增長約10倍——AI伺服器正在從"算力機器"變成"存算一體機器"。
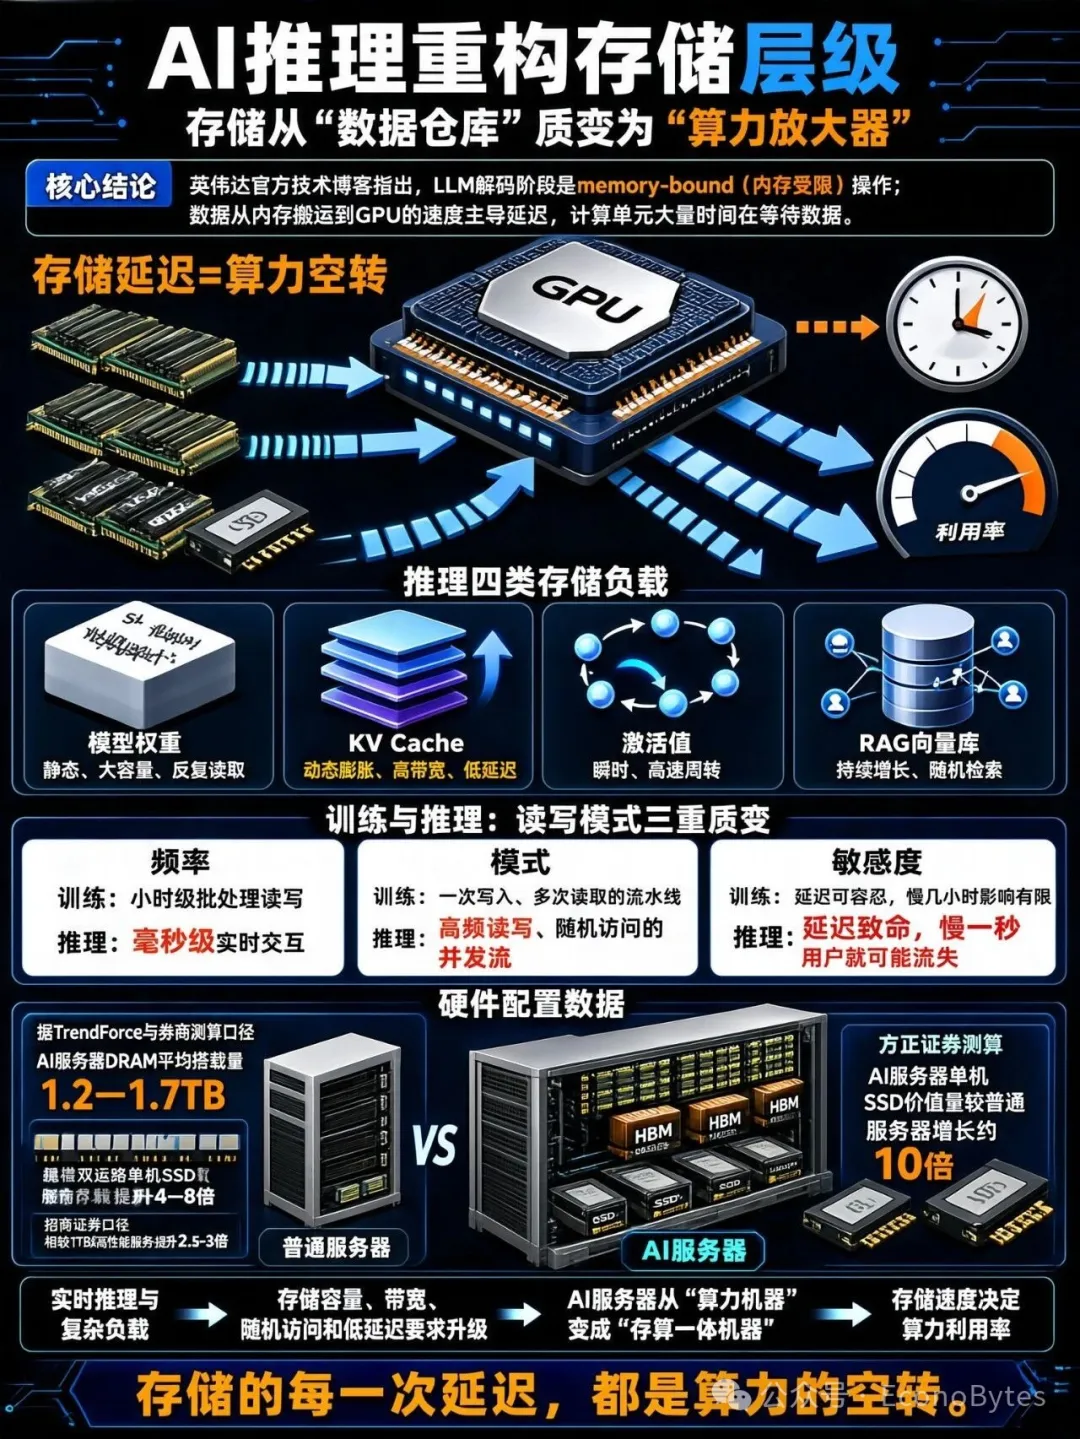
記憶體介質的角色從"資料倉儲"質變為"算力放大器"——速度決定算力利用率,記憶體的每一次延遲都是算力的空轉。
五、產業含義:存力接棒算力,成為AI基建投入新重點
當存力成為瓶頸,資本的流向就變了。
先看供需。高盛在2026年2月的研報中測算,當年全球DRAM、NAND、HBM的供需缺口分別達4.9%、4.2%、5.1%,均為2011年以來最高水平;到5月底,高盛進一步將DRAM缺口上修至5.0%、NAND至4.4%、HBM至5.4%——緊缺在半年內仍在加劇。AI是主因:含HBM的伺服器相關DRAM已佔全球DRAM總需求的53%(2026年),2027年將升至57%。
市場規模因此進入罕見的陡峭爬坡。Omdia在2026年7月將全球半導體市場營收增長預測上調至同比+94.1%——記憶體器晶片收入將佔全球半導體總營收的一半以上;Counterpoint的測算口徑更激進:2026年全球記憶體市場規模將達約9750億美元,為2025年的4.2倍(註:各機構對基數與絕對額分歧巨大,TrendForce口徑為8893億美元,此處引用需註明機構)。
記憶體巨頭的資本開支已全面轉向AI記憶體:三星2026年宣佈在AI半導體領域投入超110兆韓元(約733億美元,含記憶體、代工與先進封裝,創史上最大年度投資);SK海力士2026年資本開支指引為high-40兆韓元區間,M15X工廠提前擴產、龍仁叢集Fab1潔淨室2027年初啟用;美光2026財年資本開支上調至超250億美元,較此前提升39%。
投資的流向同樣清晰:一是HBM產能擴張——據TrendForce口徑,HBM佔DRAM晶圓投片的比例已從2025年底的約18%升至2026年底的約22%,2027年將達約30%(摩根大通口徑2025年約20%);二是先進製程遷移與配套的記憶體層級建設。
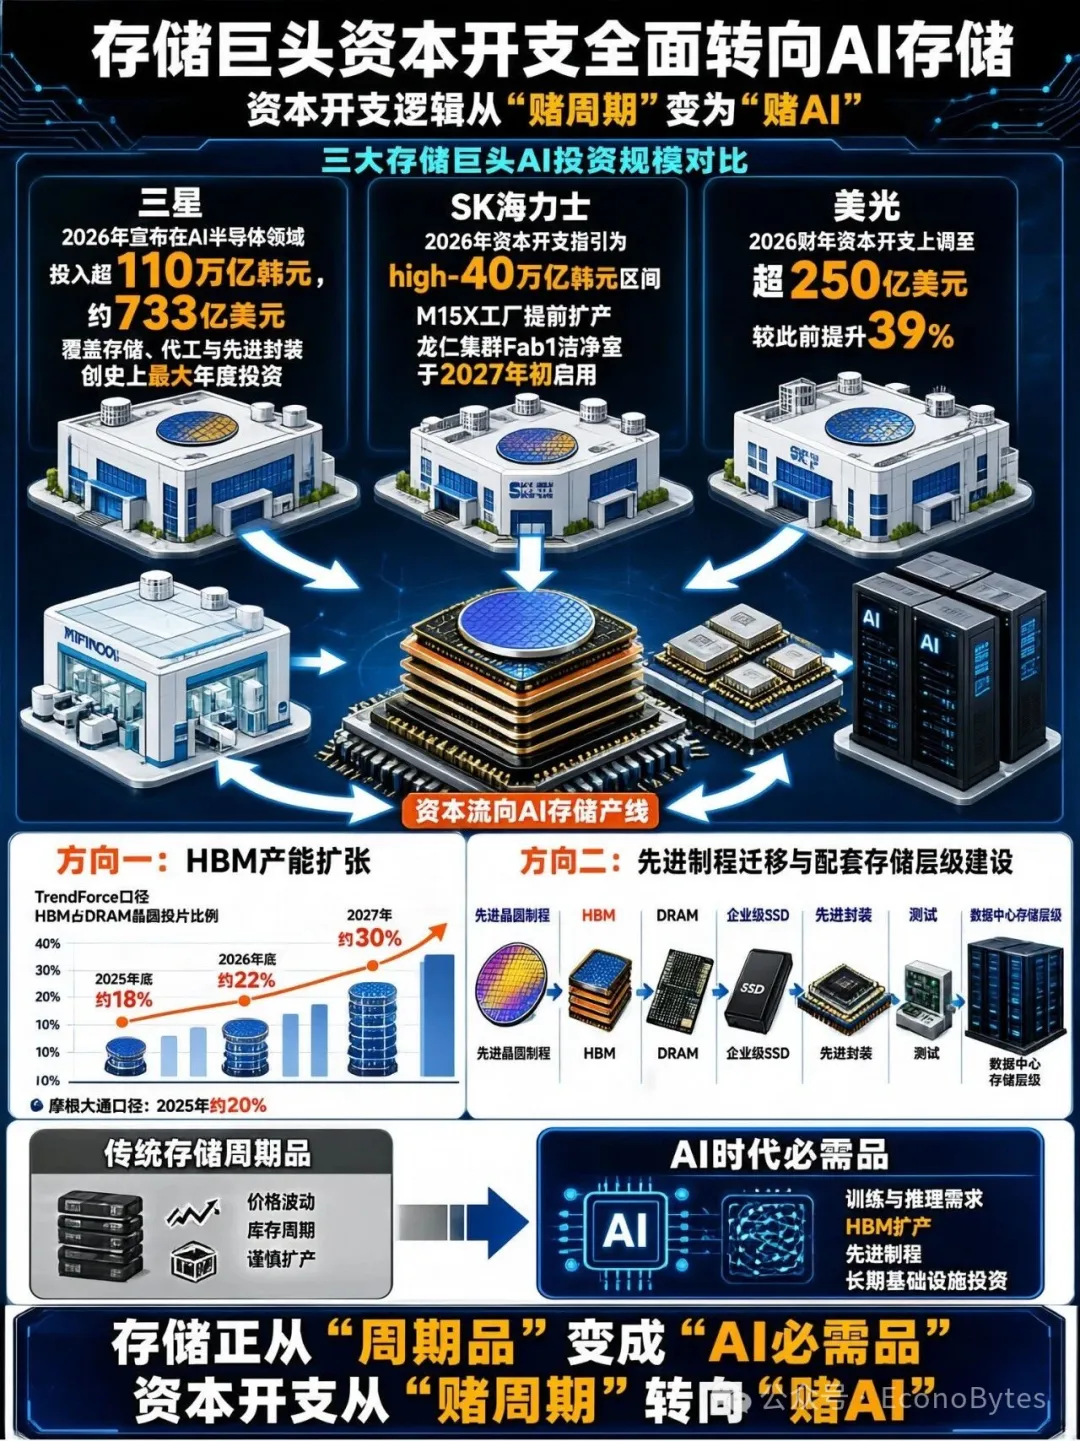
記憶體正從"周期品"變成"AI必需品"——資本開支的邏輯從"賭周期"變為"賭AI"。
六、投資對應:大容量/高頻寬記憶體的接力邏輯
順著需求結構往下看,一條清晰的接力鏈浮現。
第一棒:HBM——AI訓練的核心瓶頸。輝達GPU的"標配",佔DRAM晶圓產能比例從幾年前的個位數升至2025年底的約18%-20%,2027年將達約30%。三強格局:SK海力士守城、三星攻城、美光追趕(詳見本系列前文)。HBM是"極致性能"層的代表,價格最貴、壁壘最高。
第二棒:企業級SSD——AI推理與KV Cache外溢的核心受益者。據TrendForce資料,2026年一季度企業級SSD合約價環比上漲約80%,部分熱門型號較2025年底接近翻倍,品牌營收創184.6億美元新高。驅動因素正是推理:AI資料中心需要支援持續多步推理和日益龐大的KV Cache,企業級SSD必須提供高吞吐、穩定延遲、可預測QoS與高強度寫入的耐用性。摩根士丹利測算,AI佔NAND需求的比重將從2025年的18%升至2027年的41%。
第三棒:CXL記憶體池化——連接HBM與傳統記憶體的"新層級"。CXL將物理上分散的記憶體整合為共享資源池,允許CPU、GPU和擴展裝置靈活訪問DRAM。Yole預測,CXL市場規模將從2026年的21億美元增至2028年的158億美元——增長超6倍。
第四棒:HBF(高頻寬快閃記憶體)——為KV Cache而生的新層級。2026年2月,SK海力士與閃迪牽頭成立HBF聯盟(Google、Tenstorrent為成員);8月,雙方經OCP發佈HBF首個標準規範。HBF用TSV堆疊NAND、經中介層近GPU連接,容量可達HBM的8-16倍(閃迪口徑),定位正是AI推理中KV Cache的記憶體需求。量產預期在2028年。
接力邏輯的核心:AI推理正在催生一個從"極致性能"(HBM)到"大容量低成本"(企業級SSD)的完整記憶體層級——每一層都有明確的AI場景驅動,每一層都是新的產業機會。
七、結論:存力時代剛剛開始
AI智能體正在把記憶體推上主戰場。
從KV Cache膨脹讓"存力"成為決定AI系統性能的核心變數,到"以存換算"催生記憶體層級重構;從訓練的一次性讀寫到推理的高頻讀寫——記憶體的角色正在發生根本性質變。三組事實可以佐證:推理佔計算負載66%(中國信通院)、半導體市場營收因記憶體暴漲而預計+94.1%(Omdia)、記憶體巨頭將千億美元級資本開支投向AI記憶體。
對AI架構師,啟示是具體的:存力設計不再是"配多大硬碟"的簡單問題,而是決定算力能否被穩定釋放的系統工程——KV Cache的分層策略、解除安裝路徑、容量規劃,將與模型架構同等重要。
對產業研究者,啟示是結構性的:記憶體正從"周期品"變為"AI必需品"——HBM、企業級SSD、CXL、HBF的接力邏輯,構成了AI記憶體投資的完整圖譜。
對投資人,啟示是周期性的:算力軍備競賽的下半場,是存力的全面升級——誰在記憶體層級重構中佔據關鍵位置(HBM產能、eSSD主控與顆粒、CXL控製器、HBF標準),誰就是下一輪周期的贏家。 (EconoBytes)