
之前Bernstein就寫過一篇1GW資料中心的花費,之前那篇文章主要是用NV的伺服器去算的,昨天Bernstein又將Nvidia、AMD、Google和OpenAI的AI架構放在同一框架下比較,拆解了1GW資料中心各個系統的價值量。
最終給的結論是約350億至400億美元,跟之前的那個報告的資料差不太多。
AI機櫃拆解
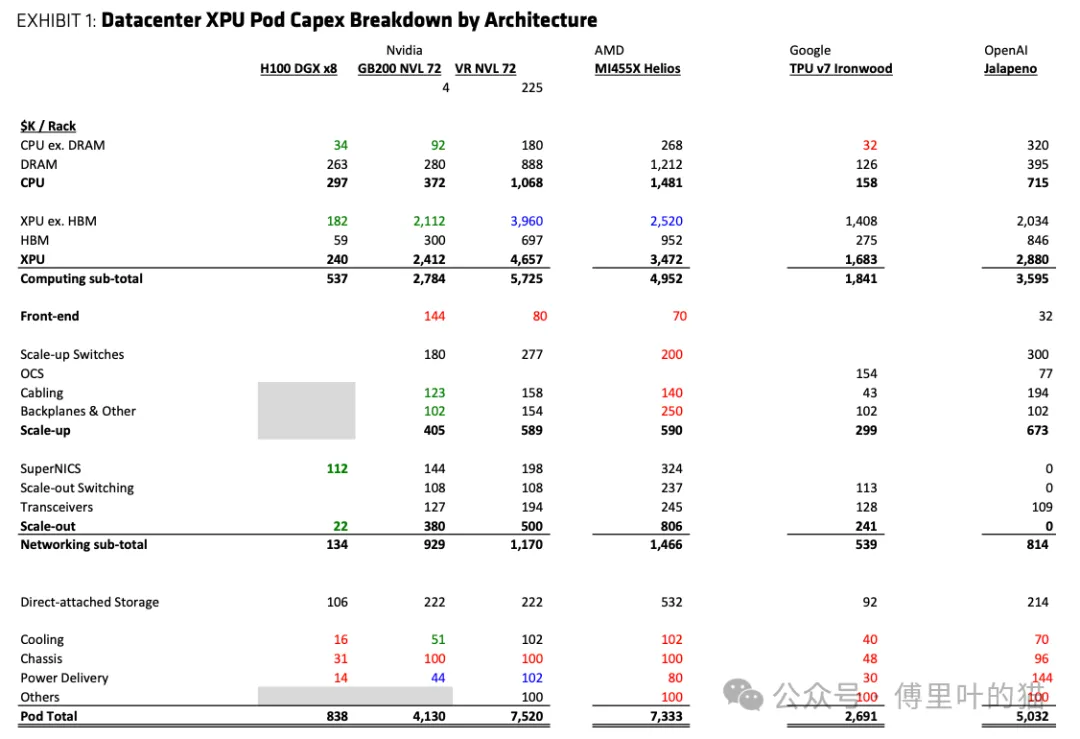
Bernstein估算,幾種新一代AI系統的成本分別為:
- Nvidia GB200 NVL72:約413萬美元
- Nvidia Vera Rubin NVL72:約752萬美元
- AMD MI455X Helios:約733萬美元
- Google TPU v7 Ironwood:約269萬美元
- OpenAI Jalapeno:約503萬美元
這些數字不僅包括GPU或ASIC,也包括CPU、HBM、DRAM、NAND、網路、供電、製冷和機箱。
不同架構的成本構成差異很大。
Nvidia的價值量主要集中在GPU;AMD雖然GPU價格較低,但記憶體、記憶體和網路投入更高;Google和OpenAI則通過自研ASIC和新的互聯方式,重新分配了整個系統的價值量。
Vera Rubin為何從910萬美元降至750萬美元?
Bernstein此前估算,一套Vera Rubin NVL72系統需要約910萬美元。這次下調至752萬美元,更接近供應鏈流傳的700萬至800萬美元區間。
下調主要有三個原因。
首先,機櫃內NAND容量假設從約2.2PB降至576TB,並將機櫃外記憶體從系統BOM中剝離。
其次,HBM4價格假設從48美元/GB下調至30.6美元/GB。Rubin配置約20.7TB HBM4,考慮Nvidia加價後,整套系統的HBM價值量約為69.7萬美元。
最後,報告重新校準了網路、液冷和供電成本。
在752萬美元的Rubin系統中,GPU本身約396萬美元,CPU及記憶體約176萬美元,網路約117萬美元。計算硬體仍佔大頭,但網路已經成為第二大價值類股之一。
AMD不是“便宜版Nvidia”
AMD MI455X Helios的成本約為733萬美元,與Vera Rubin相差不大,但成本構成完全不同。
報告估算,MI455X GPU單價約3.5萬美元,低於Rubin GPU約5.5萬美元。不過,AMD系統配置約31.1TB HBM,高於Rubin的20.7TB,CPU記憶體和本地記憶體容量也可能更大。
AMD在網路上的投入同樣更高。
由於每顆GPU最多可以配置3張NIC,Helios系統的網路卡、交換機和光模組成本明顯增加。其網路價值量約為147萬美元,高於Rubin的117萬美元。
因此,AMD節省的GPU成本,一部分轉移到了記憶體、記憶體和網路。
如果AMD的市場份額提升,受益的不只是AMD本身,網路卡、交換機、光模組和記憶體供應商也可能獲得更高價值量。
自研ASIC不會讓基礎設施消失
Google TPU和OpenAI自研ASIC的系統價格明顯低於Nvidia方案。
其中,Google TPU v7 Ironwood約269萬美元;OpenAI Jalapeno約503萬美元。Jalapeno實際上是一套雙機櫃系統,主要針對推理場景最佳化。
OpenAI的思路是擴大scale-up互聯域,將更多資料保留在HBM和CPU DRAM中,同時減少傳統scale-out網路和NAND依賴,並使用光路交換器OCS。
這意味著,自研ASIC不會簡單地消滅網路和記憶體價值量,而是改變這些價值量出現的位置。
傳統交換機可能減少,但scale-up交換、銅連接、背板和OCS需求會上升;NAND用量可能降低,但HBM和DRAM容量可能增加。
更準確地說:ASIC改變的是AI產業鏈的利潤分配,而不是讓基礎設施投入消失。
為什麼每GW投資都在350億至400億美元?
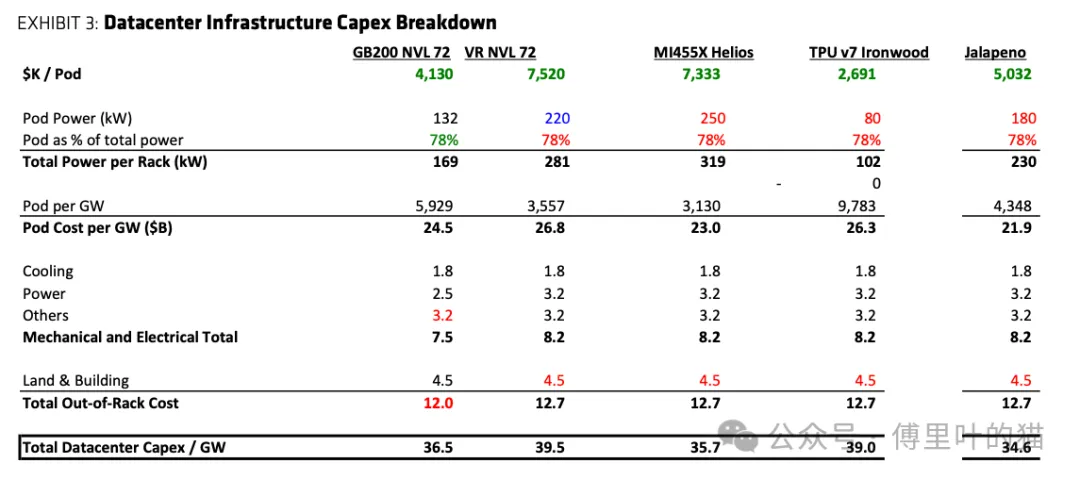
雖然不同系統的價格相差數倍,但換算成1GW資料中心後,差距明顯縮小:
- Nvidia GB200:約365億美元/GW
- Nvidia Vera Rubin:約395億美元/GW
- AMD MI455X Helios:約357億美元/GW
- Google TPU v7 Ironwood:約390億美元/GW
- OpenAI Jalapeno:約346億美元/GW
原因是,便宜的系統不一定擁有更高的功率密度。
例如,Google TPU系統本身較便宜,但單套系統功耗也較低。建設1GW容量需要採購更多Pod,最終總投資並未顯著低於Rubin。
此外,伺服器之外還有大量固定投入。Bernstein估算,每GW資料中心的供電、製冷及其他機電設施需要約75億至82億美元,土地和建築還需要約45億美元。
所以,無論採用那一種晶片,變電、配電、液冷、廠房和土地都很難省掉。
最大的成本可能不是電費
市場經常把電價視為AI算力經濟性的核心變數,但報告顯示,真正的大頭可能是硬體折舊。
假設電價為0.15美元/kWh,運行1GW資料中心一年的電費約為13億美元。
相比之下,Vera Rubin資料中心即使按6年折舊,每年資本開支折舊也約為66億美元。
因此,決定AI算力成本的關鍵因素是:
- GPU和ASIC採購價格
- 硬體折舊年限
- 裝置利用率
- 單位功耗下的有效算力
- 模型的實際吞吐量
在40%利用率假設下,Bernstein估算每顆加速器的小時成本約為:
- GB200:1.77美元
- Vera Rubin:3.18美元
- AMD MI455X:3.23美元
- Google TPU v7:1.29美元
- OpenAI Jalapeno:1.27美元
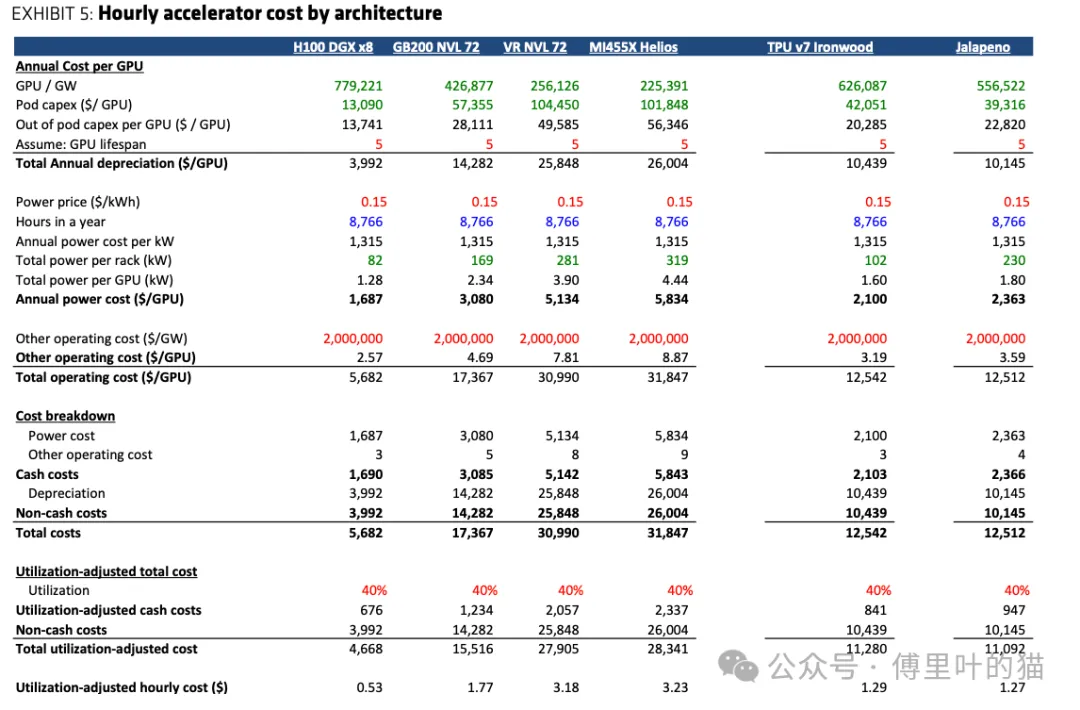
不過,這些數字不能直接用來判斷晶片性價比,因為不同晶片的性能、軟體生態和適用模型並不相同。
它真正說明的是:提高昂貴硬體的利用率,可能比降低電價更加重要。
AI價值鏈正在向外擴散
Bernstein預計,全球AI硬體對應的電力容量將從2025年的約27GW,增加至2026年的35.5GW和2027年的43.3GW。
隨著AI資料中心繼續擴張,價值量將從GPU向更多環節擴散:
- HBM、DRAM和企業級NAND
- scale-up與scale-out交換機
- 網路卡、光模組和銅連接
- 液冷、供電和高壓直流裝置
- 資料中心土地、建築和電力資源
所以,最關鍵的問題還是在於誰能用更低的全生命周期成本,把昂貴的晶片轉化為持續、穩定且高利用率的算力 (傅里葉的貓)