
Claude Haiku 5.5發佈,小模型大逆襲!
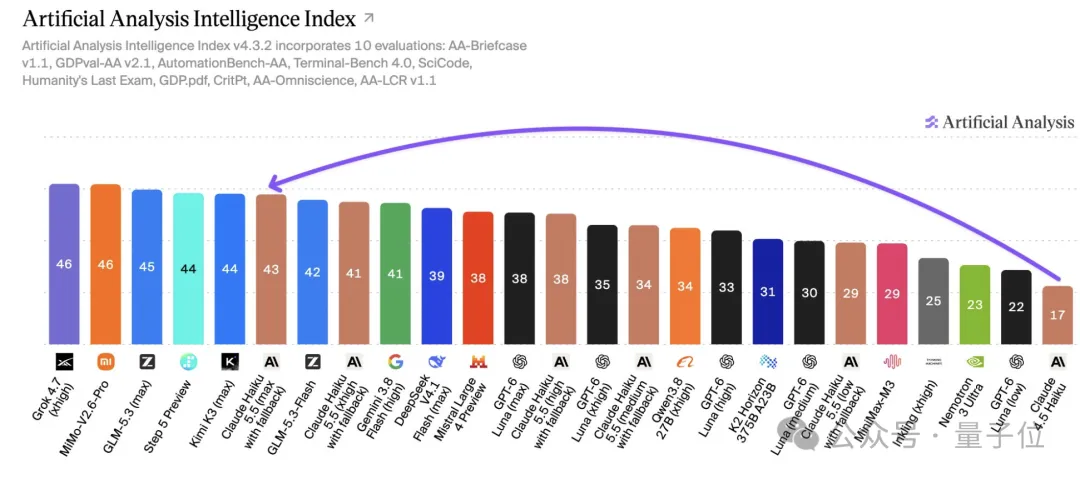
單論跑分,直接超越兩大前“斬殺線”DeepSeek V4.1Flash和GLM-5.3-Flash,成為新的小模型守門員。
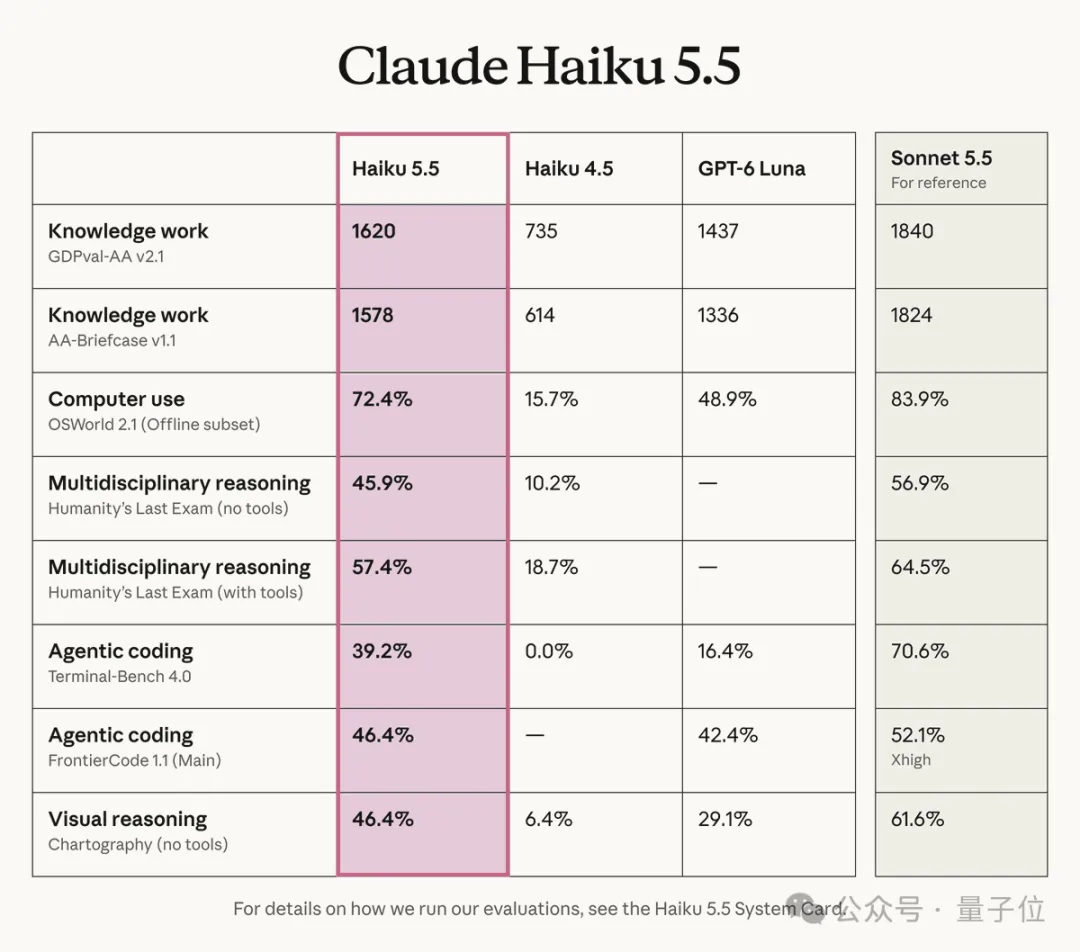
一看官方跑分,好嘛,這就是衝著GPT-6 Luna來的,逐項贏過Luna。
由於鵜鶘騎自行車測試已經基本飽和了,最新趕到戰場的是奔跑斑馬測試。
Haiku 5.5甚至價格也完全對標GPT-6 Luna。
上代Haiku 4.5還是剛好一年前出的,價格是5.5的10倍。
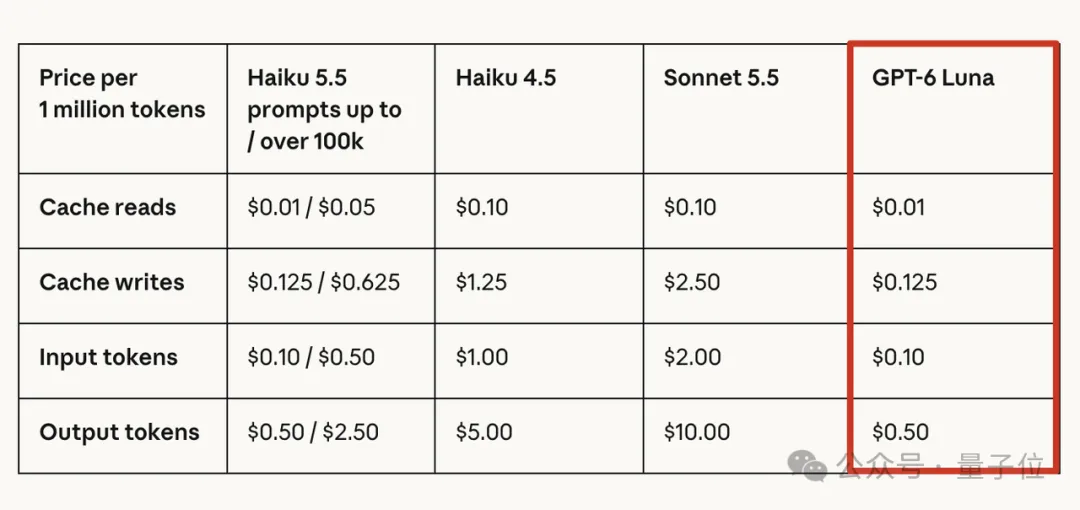
不過Haiku5.5的價格還有條件,提示詞在10萬token以內的請求(佔Haiku 4.5請求量的90%),輸入輸出價格直接砍90%;超過10萬token的部分,只砍50%。
而且這樣一來,除了快取命中的輸入這一項,Haiku 5.5在不超出100k提示詞時的價格也比DeepSeek-V4.1 Flash的谷時價格便宜了。
為了測試電腦使用能力,我們讓Haiku 5.5把GPT-6和DeepSeek的價格填到Haiku發佈頁表格的後面。
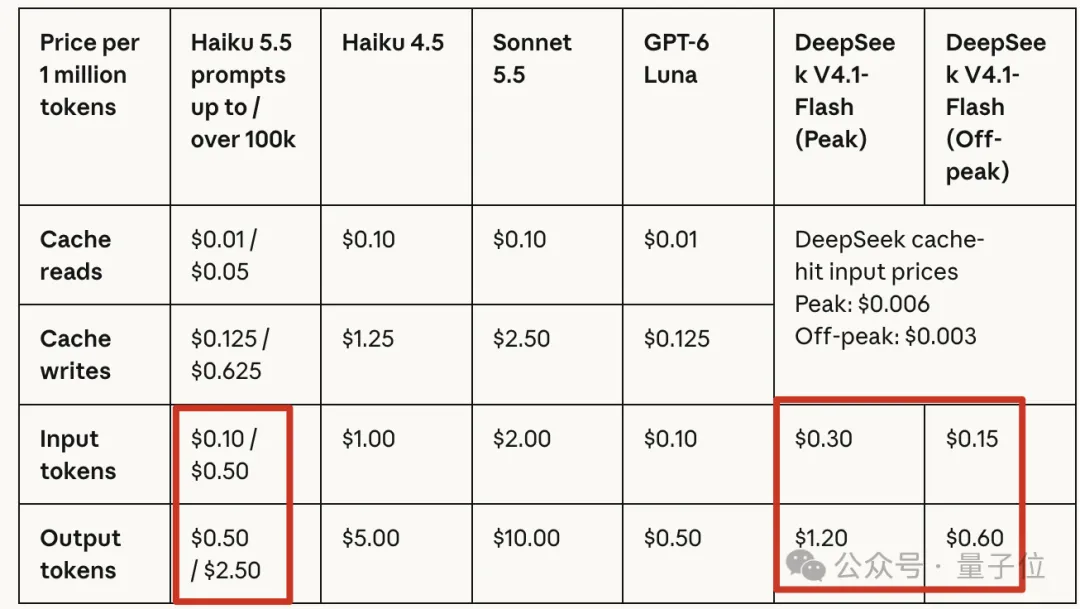
它沒有直接編輯html元素,而是到控制台用指令碼注入內容。
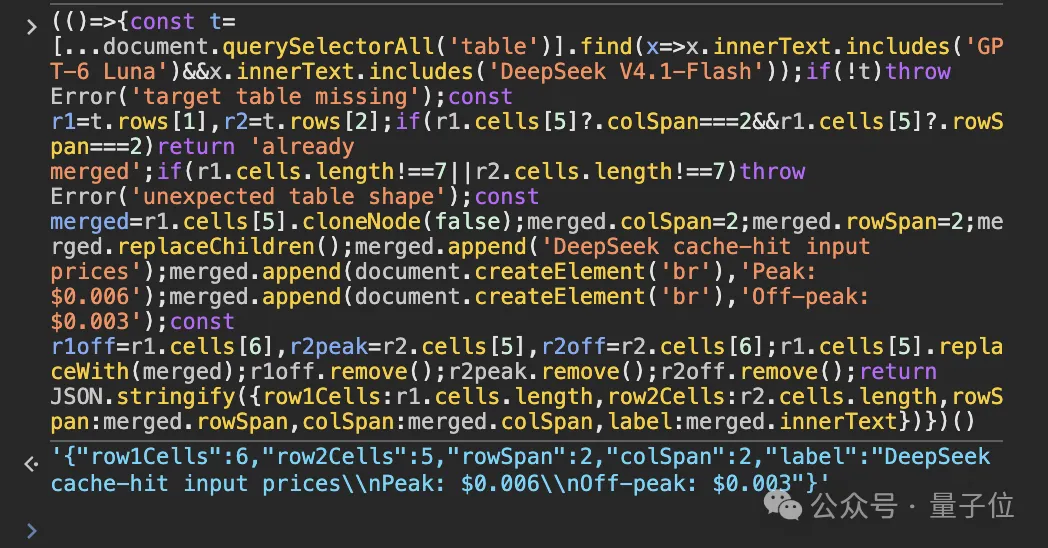
至此Opus 5.5管複雜推理、Sonnet 5.5管通用執行、Haiku 5.5管跑量和速度,群賢畢至,只差Fable了。
只能說隔壁OpenAI要是不努把力,Claude都沒必要把Fable 5.5這管大牙膏擠出來。
彷彿回到了英特爾和AMD比拚CPU的日子。
換了tokenizer,耗費token更多
Haiku 5.5是第一個支援effort調節的Haiku模型,繼承了系列從low到max的五檔組態。
上一代Haiku 4.5在電腦操作和編碼方面基本交白卷,這一代直接進化。
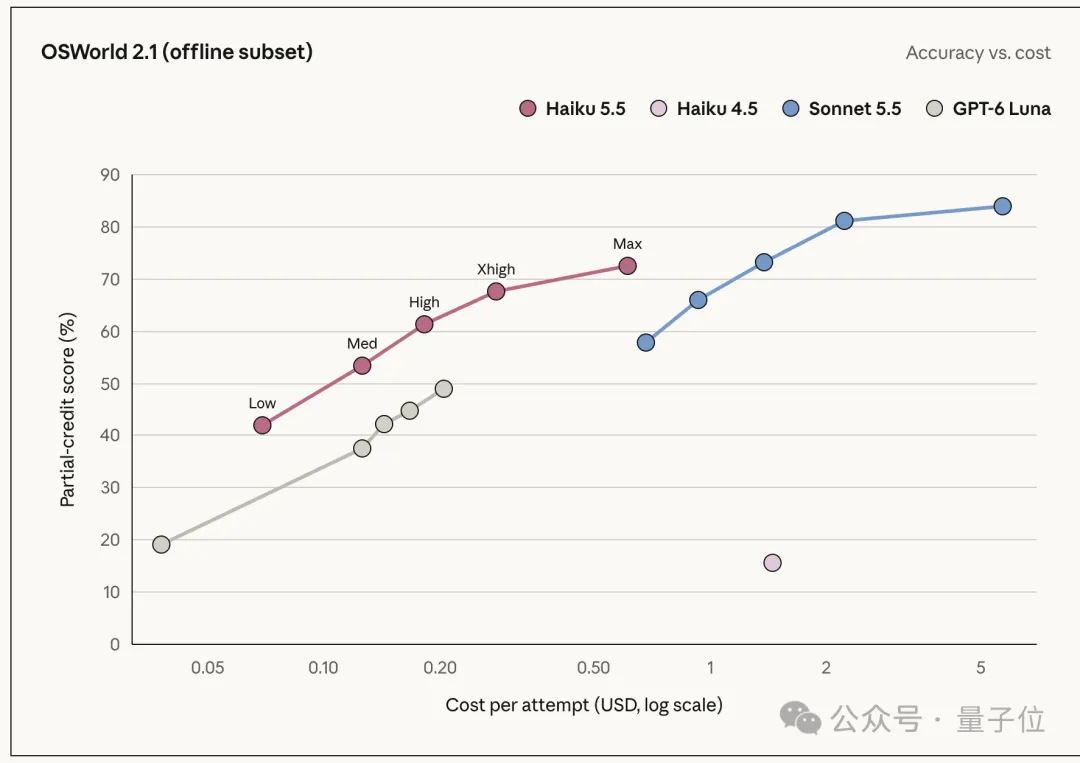
看OSWorld 2.1(測agent操作真實電腦完成多步任務):Low檔42.0%精準率、單次成本$0.07;Max檔72.4%、$0.61。Haiku 4.5隻有Max檔15.7%、$1.45,
也就是說,5.5的Low檔比4.5的Max檔准,還便宜一半。
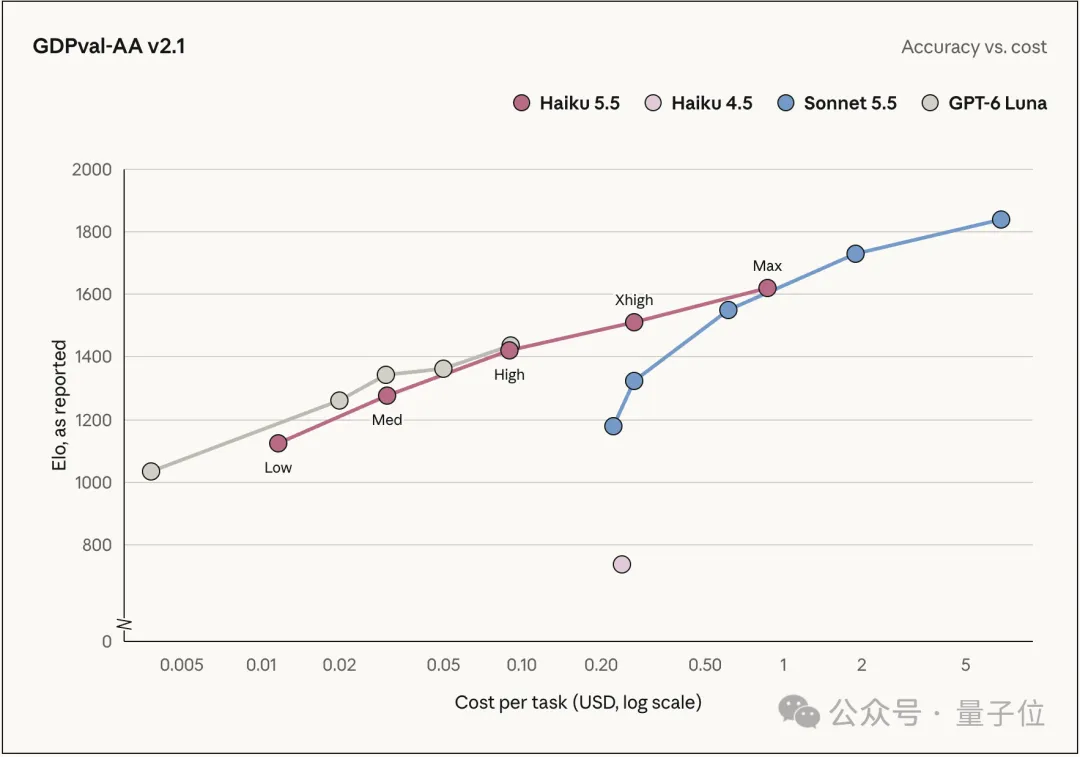
GDPval-AA v2.1(測44個職業的真實專業工作)也是類似曲線:Low檔Elo 1125、$0.01;Max檔1620、$0.87。4.5的Max檔只有735、$0.24。
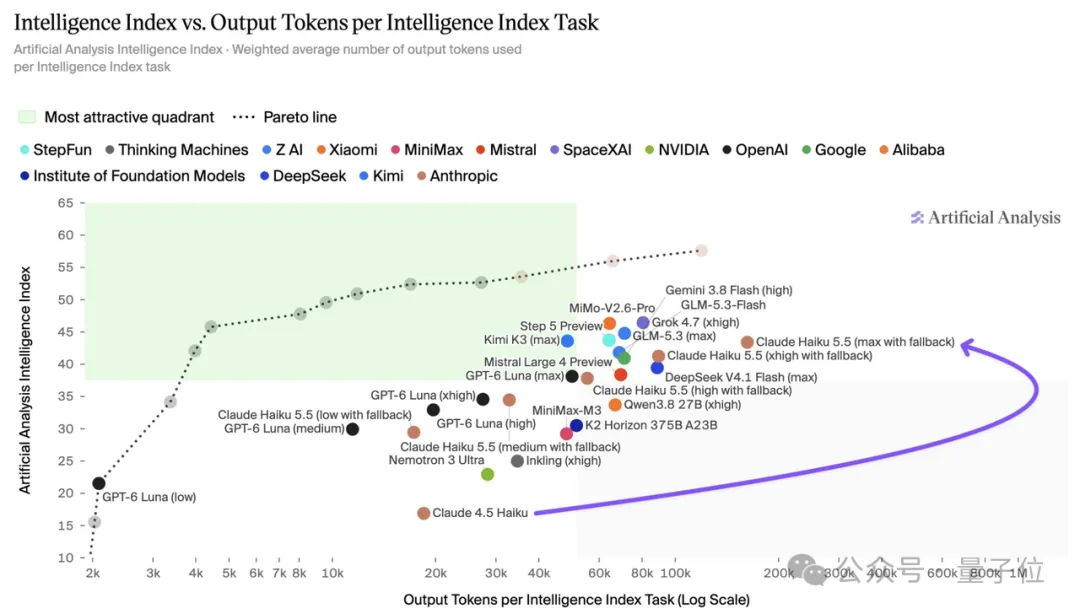
不過Haiku 5.5換了tokenizer(和Sonnet 5.5、Opus 5.5同款),同樣任務會多耗費token,所以實際省的錢比標價折扣少億點點。
特別是程式碼、表格、非英語內容的膨脹可能更高。
在AA測評中,Haiku 5.5雖然API價格便宜了,但“完成任務的平均成本”並沒有到達理想區間。
替不了Sonnet
很多人對Haiku5.5的期待是能在部分任務替代Sonnet 5.5,進一步壓低成本。
但這次並沒有出現奇蹟,小杯還是小杯。
Terminal-Bench 4.0上Haiku 5.5拿39.2%,Sonnet 5.5拿70.6%。複雜多步編碼、跨檔案重構、長週期自主規劃方面差距非常清楚。
Anthropic自己也建議了,複雜agent編碼優先用Sonnet 5.5或Opus 5.5。
Haiku 5.5的價值在執行層。任務已經拆好、驗收標準明確、可以平行跑的任務。
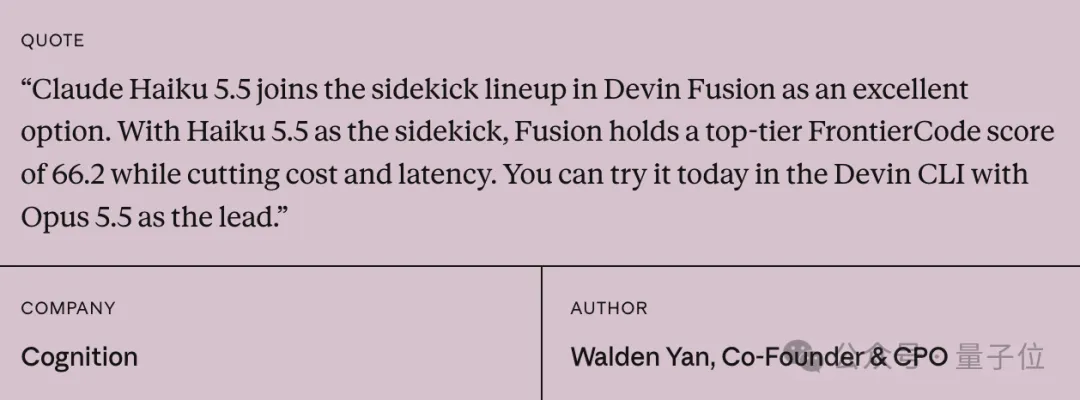
比如Cognition的Devin用Opus 5.5做主模型、Haiku 5.5做子智能體,FrontierCode組合跑到了66.2%,比兩個模型各自單跑都高。
如果你以前的業務用Haiku 4.5,這次不是換個模型名就能上線的。
budget_tokens手動思考組態直接報錯,必須改成自適應思考加effort參數。
temperature、top_p、top_k全部鎖定預設值,依賴採樣參數做創意控制或多樣化生成的應用要改邏輯。
assistant消息預填充被取消了,以前靠預填充強制JSON開頭的寫法得換工具呼叫或結構化輸出介面。
電腦操作工具版本也更新了,從computer_20250124換成computer_toolset_20260801,介面格式和返回結構可能都不同。
另外自適應思考默認開啟,響應第一個內容塊可能是思考塊而不是正文,解析邏輯要按type欄位過濾。
五處變動,每一處都可能讓請求直接報錯或返回非預期結構。
Anthropic提供了遷移指南,建議切之前對著過一遍。
順帶兩條福利
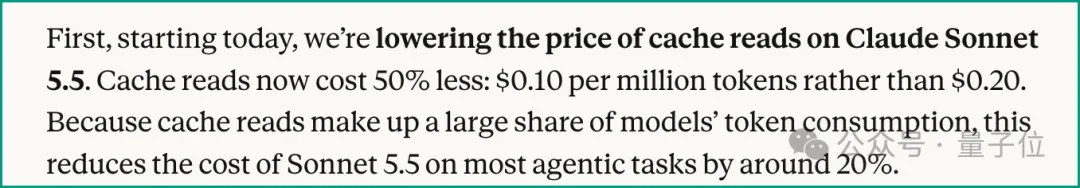
Sonnet 5.5的快取讀取從$0.20/M降到$0.10/M,Anthropic稱大多數agent任務因此成本降約20%。
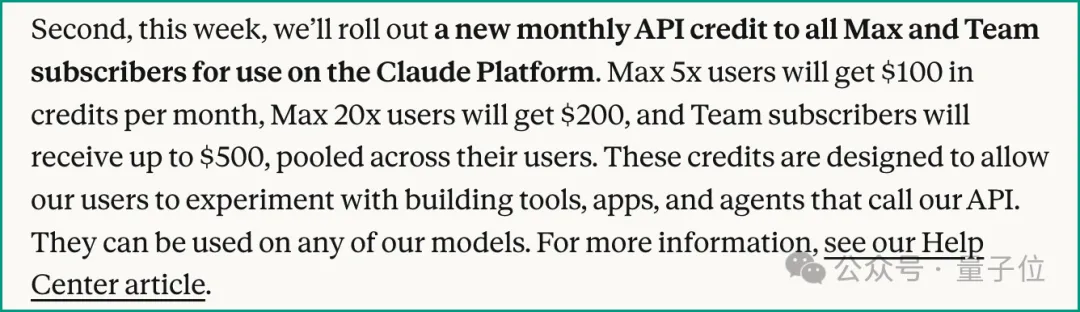
Max和Team訂閱使用者本週起可以領取API額度,Max 5x每月$100,Max 20x每月$200,Team最多$500/月在團隊內共享。
這些額度可以用來實驗調API建工具、應用、agent,所有模型通用。
神馬?你說A社把我的買Coding Plan錢還給我,讓我還可以在API上再用一次?
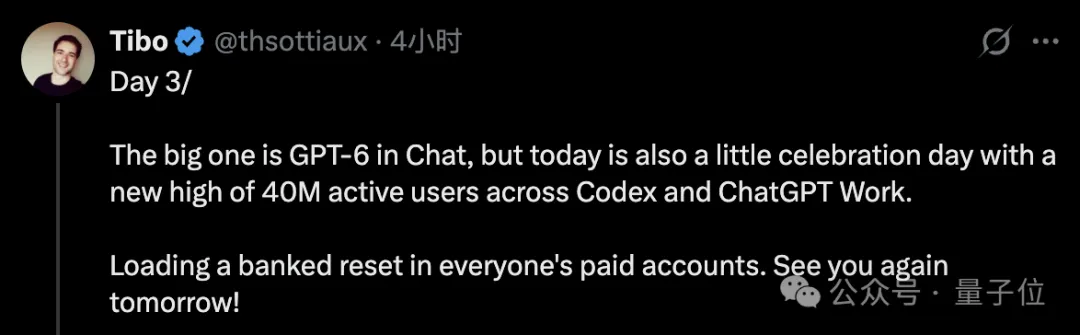
那麼OpenAI在幹嘛呢?OpenAI又送了一張重設卡。
(量子位)