
被《時代》稱為 AI 行業“風向標”的那份報告,更新了。
Air Street Capital 的《State of AI Report 2026》正式發佈,已經是這個系列的第九期。
從模型突破到資本流向,再到政策與安全,它把 AI 這一年的關鍵變化都整理了出來。
想看懂 AI 究竟走到了那一步,這份報告值得仔細閱讀。我們將作者梳理的報告要點譯成了中文,一起來看看吧:
經過幾個月的研究,以及一直持續到最後一刻的修改,我很高興終於能把第九份年度《AI 現狀報告》(State of AI Report)帶給大家。
近十年來,這份報告一直是我出於熱愛而投入的工作。我對 AI 的興趣始於 2010 年代初攻讀博士期間,當時的研究方向是癌症研究和計算生物學。自 2013 年起,我開始投資開發和應用 AI 的公司,希望借此加快技術進步。這份報告讓我有機會分享自己的所學,也幫助更多人理解那些正在改變世界的研究。
每天都有新論文發表、新模型發佈,產業和政治領域也不斷出現新動向。編寫報告的大量工作,就是判斷什麼值得大家關注,核實證據究竟支援那些結論,與研究者和開發者討論,再解釋這些進展為什麼重要。
我們每年也會作出預測,並在下一年回頭評估。過去,我們預測過輝達收購 Arm 將告失敗,Transformer 會在語言之外的領域取得領先成績,以及開源模型將超越 OpenAI 的 o1。最後這一項,後來由 DeepSeek-R1 實現了。
一、來看看今年的重點
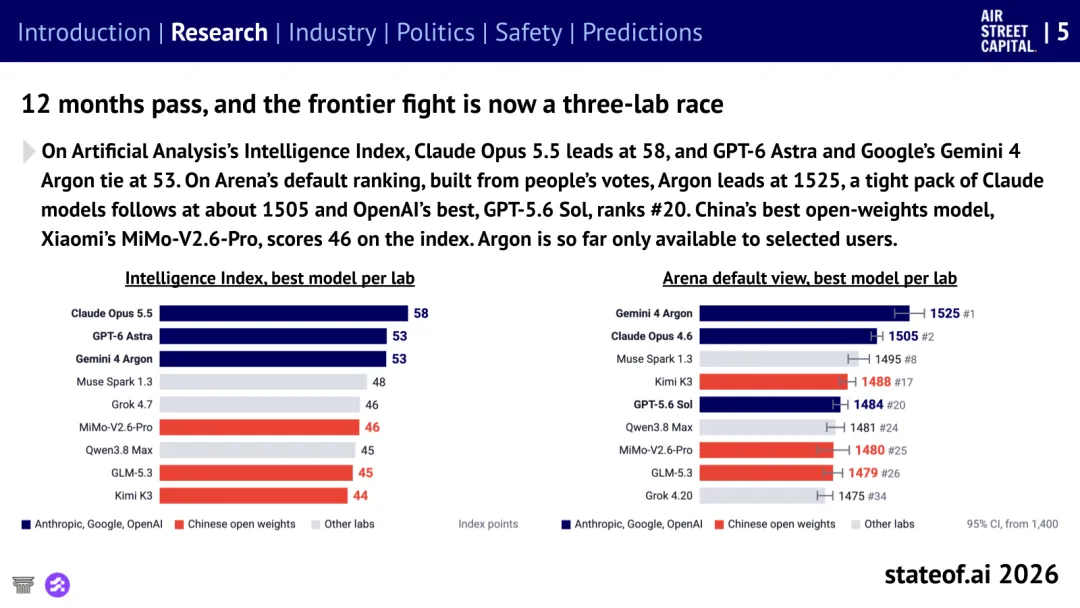
前沿模型的競爭,如今已成為 Anthropic、OpenAI 和 Google 三家實驗室的角逐。至少目前,Anthropic 在 Artificial Analysis 的智能指數上領先,而 Google 在 Arena 根據使用者回答偏好生成的排行榜上領先。
去年的報告中,我們談到,OpenAI 的 o 系列模型讓推理能力開始在大規模應用中發揮實際作用。此後的進步,我有切身體會。我能借助 AI 反覆打磨、改進的實際工作越來越多,也越來越多地把工作交給智能體完成。
在我看來,有些人能從 AI 中獲得很大價值,有些人收穫卻很少,兩者之間的差距,很大程度上取決於是否知道怎麼用、怎麼配置。換句話說,這是“人的技能問題”,並非“AI 的技術問題”。我確實認為,我們需要一個 AI 版的 Genius Bar(天才吧),讓人們能獲得手把手的幫助,選對工具、做好配置,用它們處理日常工作。
二、更好的工具和上下文,讓智能體更能幹
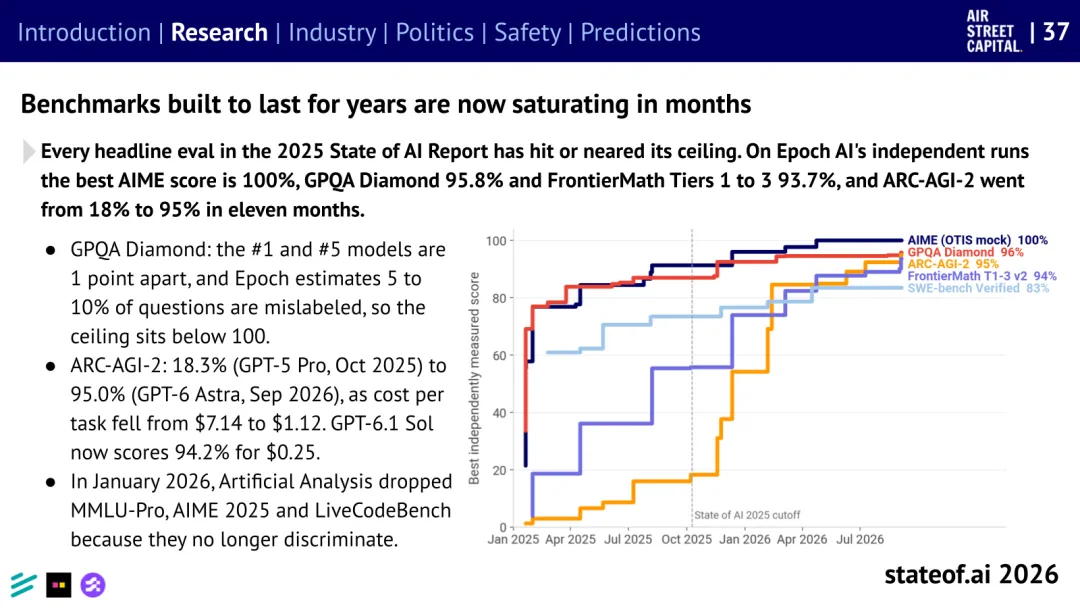
在數學、科學推理和程式設計領域,一些原本打算用來考驗模型數年的基準測試,幾個月內就已經接近得分上限。我們需要新的評估方式,判斷模型之間還存在那些能力差距,以及它們究竟能可靠地完成什麼。
前沿模型的能力仍然參差不齊,有些方面突出,有些方面薄弱,而且不同代際之間也可能出現起伏。就我的使用體驗而言,Opus 4.6 是個好模型,Opus 5 有所退步,Opus 5.5 又變好了。更好的工具和上下文能有所幫助。在一項受控程式設計研究中,研究者調整了 GLM-5.1 可用的工具、上下文和反饋,在沒有改變模型權重的情況下,將它在 100 項 SWE-bench Verified 任務上的成功率從 52.5% 提高到了 65.5%。沒錯,這是個“舊模型”,但其中的道理仍然成立。
隨著模型及其周邊的工具和運行框架共同進步,並參與自身的開發,我預計,今天的許多短板都能通過學習逐漸消除。對於模型已經具備的能力,我們也還有辦法發揮得更充分。
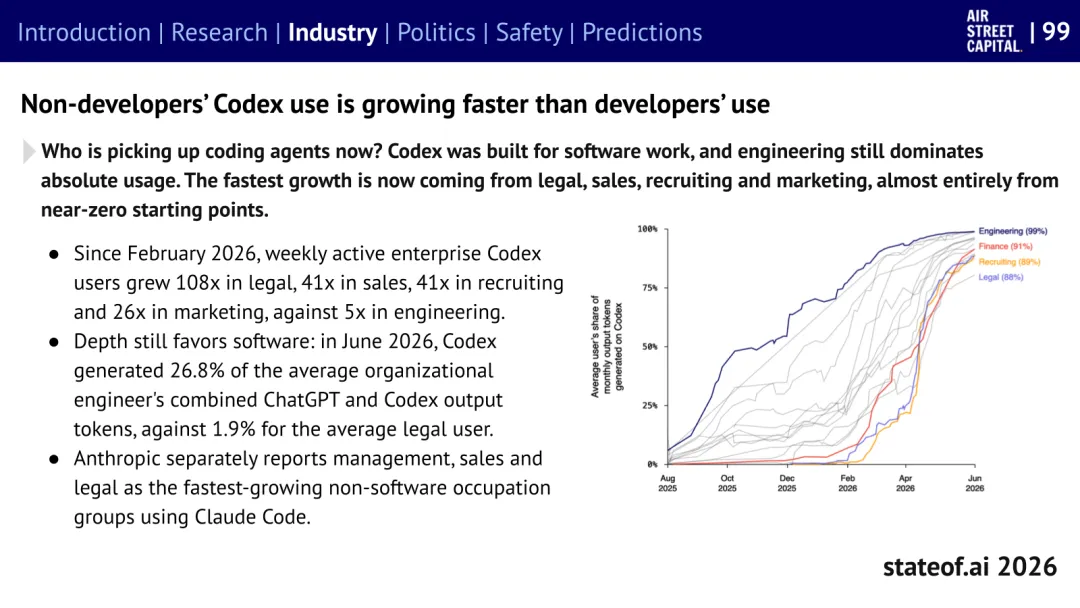
令人興奮的是,這種進步遠遠超出了開發者群體。OpenAI 對智能體使用情況的研究發現,使用增長最快的是非開發者,包括法律、銷售、招聘和行銷等領域的從業者。幫助他們把這些工具用起來,其中的機會,比“程式設計智能體”這個名稱所暗示的要大得多。
三、AI 正在加快 AI 本身的研發
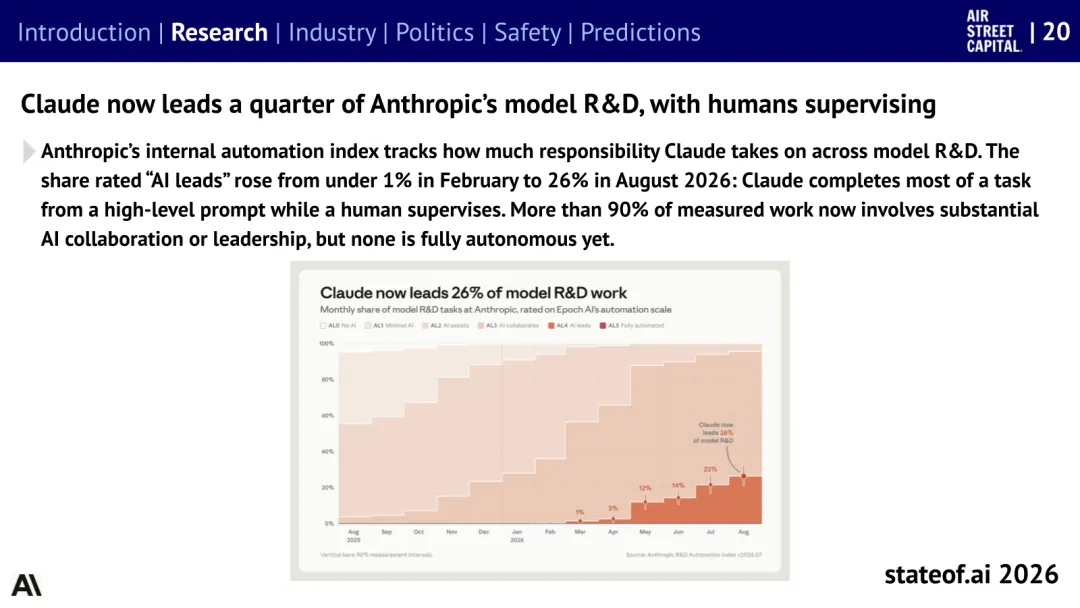
AI 已經在幫助我們開發更好的 AI。根據 Anthropic 的內部指標,8 月,在納入統計的模型研發工作中,Claude 主導的部分佔到 26%,而 2 月時還不到 1%。研究者負責設定任務、監督執行;Anthropic 表示,這正在加快開發處理程序。這也是 AI 研究中最讓我興奮的一個方向。
對很多人來說,Karpathy 的 autoresearch 讓這個循環中的一部分變得直觀可見。智能體修改訓練程式碼,運行每次五分鐘的實驗,在一塊 GPU 上通宵工作,並保留帶來改進的修改。這讓研究中一個有用的環節實現了自動化,不過,持續、完全自主的遞迴改進仍有待證明。
我接下來想看到的,是智能體具備科研判斷力,能選好實驗,識別有潛力的研究方向,並知道何時該放棄已經熟悉的路線。正如我在《AI 能學會科研判斷力嗎?》(Can AI learn scientific taste?)一文中所說,要學會這種判斷,可能需要接觸論文中沒有寫出來的備選方案、失敗經歷和決策過程。我們希望看到,科學研究的策略也能發生一次類似 AlphaGo 帶來的轉變。
四、機器人領域的 GPT-2 時刻與世界模型的興起
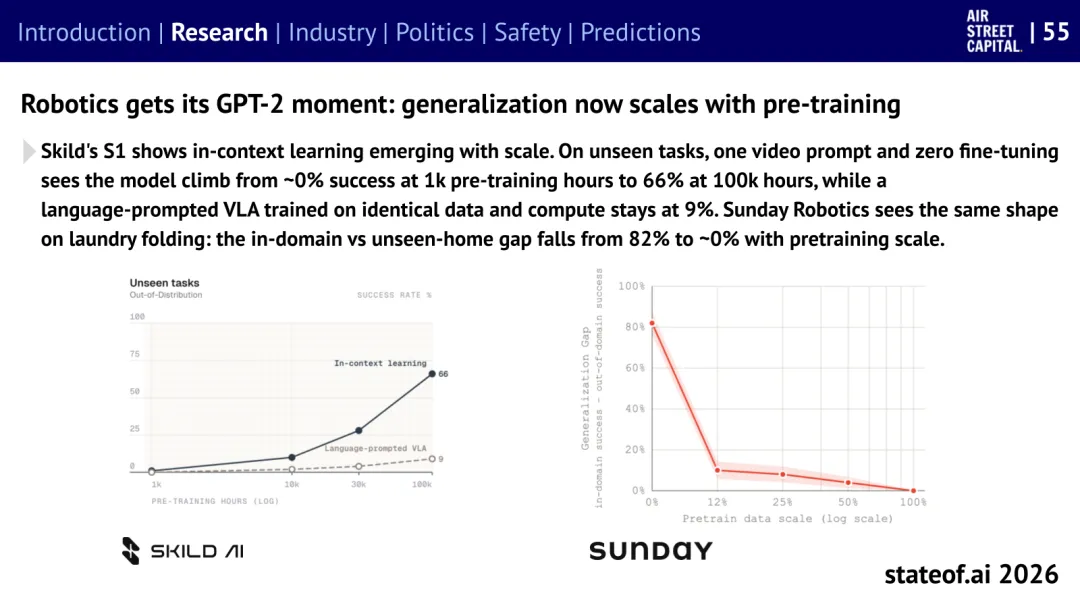
覆蓋範圍更廣的預訓練,正在幫助機器人把能力遷移到不熟悉的任務上。這也是為什麼我認為,隨著新模型、新硬體和新的資料採集方法逐漸結合,機器人領域正在接近自己的 GPT-2 時刻。通過對 Sereact、Wayve、Black Forest Labs 和 Odyssey 等公司的投資,我也看到了這一變化。
Skild 的 S1 無須更新權重,就能根據視訊演示完成不熟悉的任務。使用 10 萬小時的資料進行預訓練後,它在公司採用的逐步累計成功指標上取得了 66% 的成績;相比之下,一個使用相同資料和算力訓練、通過語言提示執行任務的基線模型,成績只有 9%。
從演示中學習,可以減少機器人每次部署時所需的特定任務訓練。世界模型則提供了另一條路徑。Wayve 的 GAIA-4 能將錄製的駕駛場景轉化為模擬環境。在其中,AI 駕駛員的轉向和剎車會改變它接下來看到的畫面。其他道路使用者仍沿著錄影中的路線行進,但 AI 駕駛員可以探索自身行為會帶來什麼後果。
Odyssey-3 利用視覺預訓練,學習機器人、汽車和遊戲中的控制任務。在公司的實驗中,機械臂通過數十小時的演示就能學會操作;即使抓取失敗,也能自行調整,而這些補救動作並沒有在演示中出現過。這些早期結果表明,物理 AI 可能不需要針對每一種潛在情況,都學習那麼多次演示。
五、AI 的科學應用,從數學延伸到臨床試驗
AI 正在解開一些連專業研究者也久攻不下的數學難題。Epoch AI 的未解問題彙編已記錄九項解答,其中四項由 AI 自主完成,五項由人類與 AI 合作完成。在生物學領域,對分子相互作用的預測越來越準確,也讓研究者能夠更好地篩選出值得送進實驗室驗證的設計方案。我投資的 Profluent 就讓我直接看到了這一點。這家公司開發用於蛋白質設計的前沿模型,設計對象包括基因編輯蛋白。
對生物科技創業者來說,一個好消息是,圍繞藥物發現的新商業模式正在出現,這些模式不以擁有藥物資產為前提。例如,Tempus 為與阿斯利康和 Pathos 合作開展的基礎模型開發提供腫瘤學資料授權;葛蘭素史克(GSK)與 Noetik 簽署的五年協議,則包括按年支付費用,以使用服務於癌症研究的虛擬細胞模型。
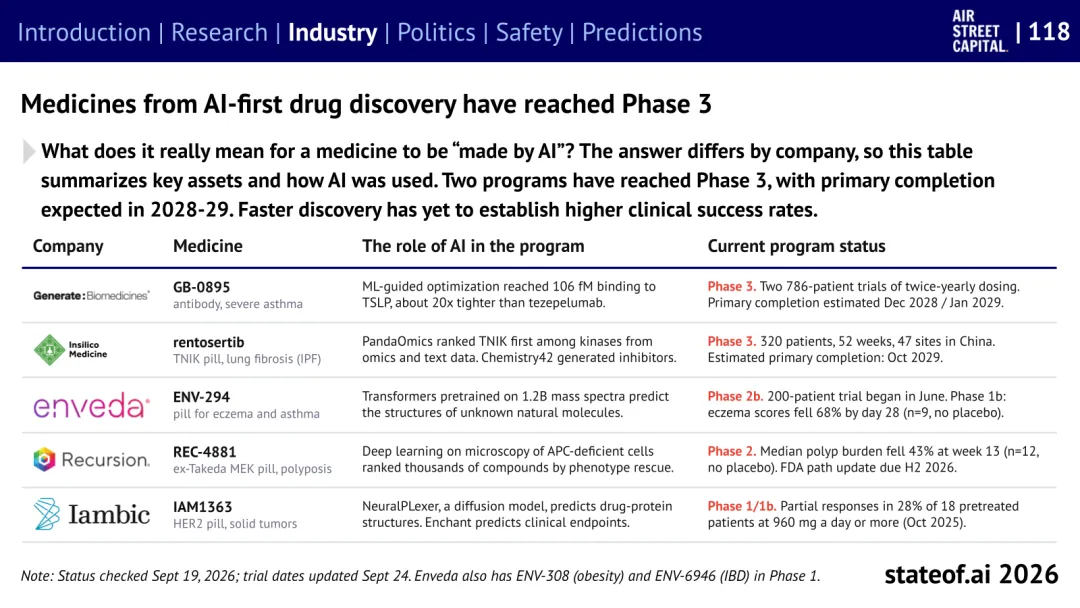
AI 輔助藥物發現的成果,終於開始進入臨床開發的後期階段。Generate:Biomedicines 用於重度哮喘的 GB-0895,以及英矽智能用於特發性肺纖維化的 rentosertib,都正在為 III 期臨床試驗招募受試者。Enveda 用於濕疹和哮喘的 ENV-294 則正在進入 IIb 期臨床試驗。當然,人體試驗才是最終檢驗,它將決定這些藥物是否安全、有效。
六、AI 推理正成為一門龐大的生意
智能體在工作過程中會反覆呼叫訓練好的模型,為 API、訂閱服務和基礎設施帶來源源不斷的需求。許多公司正提著空桶,爭先恐後地去接這股由推理服務匯成的收入瀑布。我甚至認為,這個行業如今的寫照是,“要麼倒在衝擊技術前沿的路上,要麼活得足夠久,最後去做推理服務。”
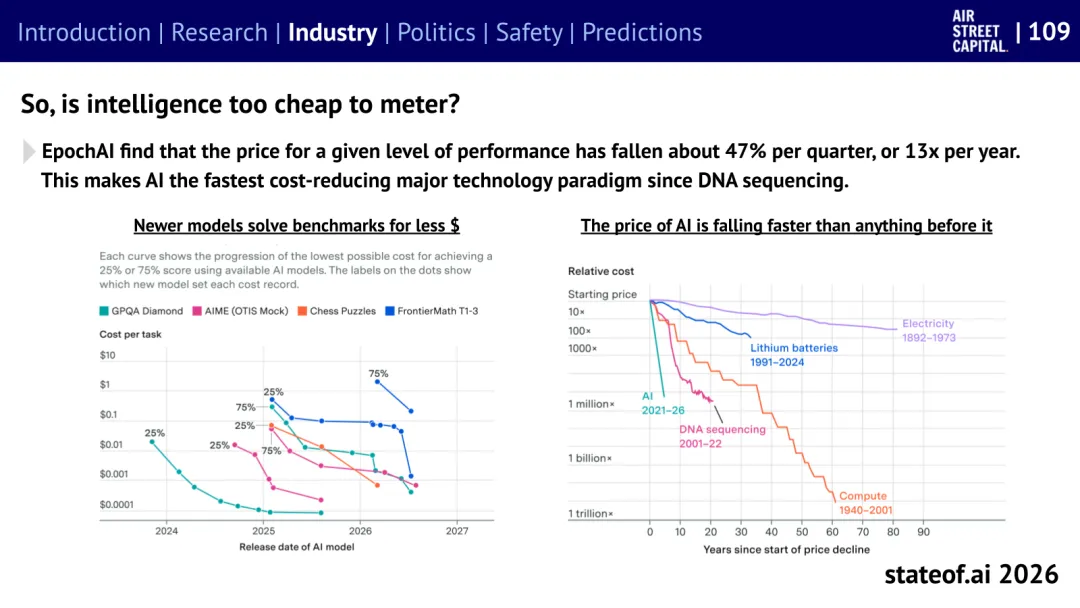
Epoch AI 根據五項基準測試估算,自 2023 年以來,達到某個固定分數所需的成本,每季度下降 47%,相當於每年降至原來的約十三分之一。這樣一來,把更多工作交給 AI 也變得划算。
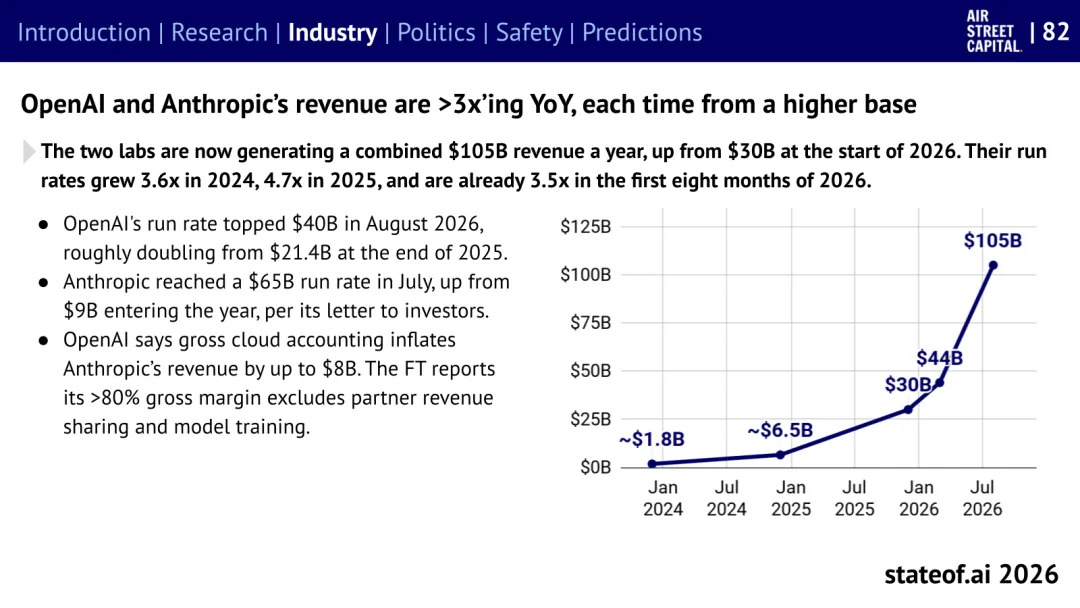
到夏末,按當時的收入水平折算,OpenAI 和 Anthropic 披露的年化營收合計已達到驚人的 1050 億美元,而年初還只有約 300 億美元。這些數字涵蓋了兩家公司的全部業務,包括訂閱、程式設計產品和 API。正如 OpenAI 所說,“我們不能因為支線任務分心,錯過這個時機。”
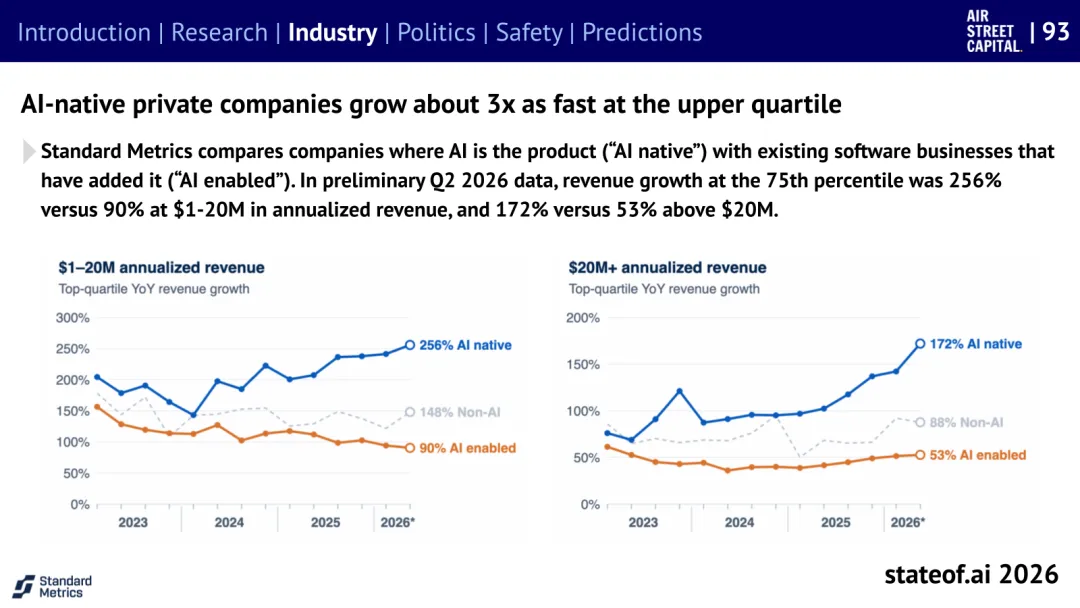
但如此迅猛的營收增長,並不侷限於前沿模型實驗室。Standard Metrics 的第二季度初步資料顯示,在年化營收介於 100 萬至 2000 萬美元的企業中,AI 原生企業營收同比增速的第 75 百分位數為 256%,而為現有軟體增加 AI 功能的企業,這一數字為 90%。在年化營收超過 2000 萬美元的企業中,兩者分別為 172% 和 53%。這些比較不能證明採用 AI 會帶來更快的增長,但我傾向於認為,兩者之間存在因果關係。
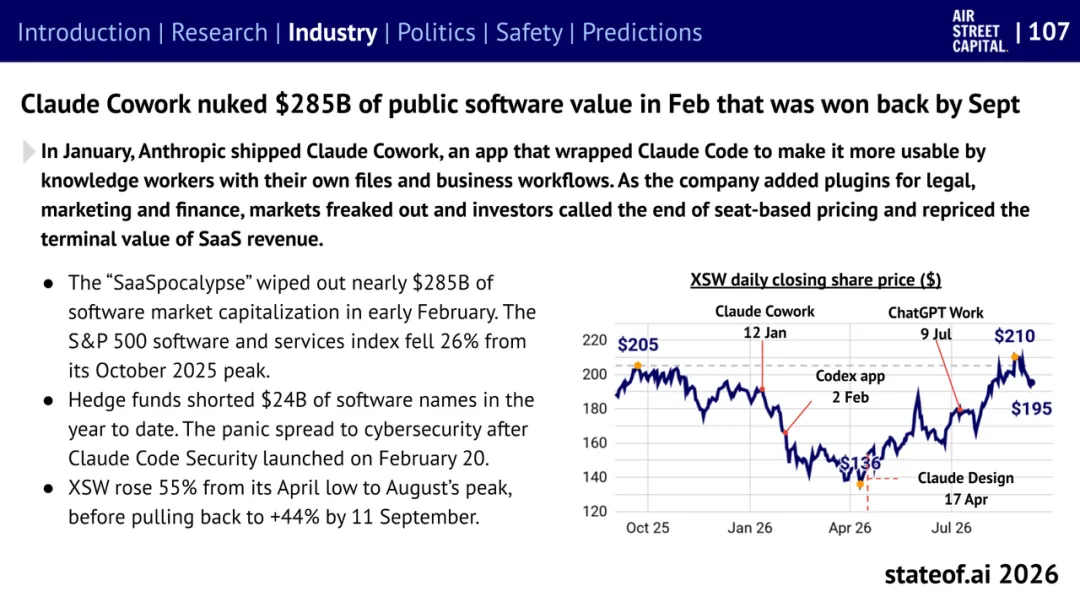
Claude Cowork 及其面向法律、金融、行銷等領域的業務外掛,讓軟體市場驟然陷入不確定性。2 月那場被稱為“SaaS 末日”(SaaSpocalypse)的拋售中,軟體股市值在兩周內蒸發了近 2850 億美元。後來,Mythos Preview 又引發了網路安全公司可能失去存在價值的擔憂,推動相關股價進一步下跌,隨後市場才強勁反彈。我當時覺得這種判斷很荒唐,因為這些能力會催生大量對更強防禦的需求。投資者必須判斷,智能體究竟會削弱現有廠商的定價能力,擴大它們的市場,還是讓競爭對手有機會取代它們。還要判斷,現有廠商的資料護城河是否依然有效,智能體能否在這一優勢之上建構服務。遠在營收資料給出答案之前,我們就必須作出決定。
七、AI 繼續擴張,離不開融資、建設和當地支援
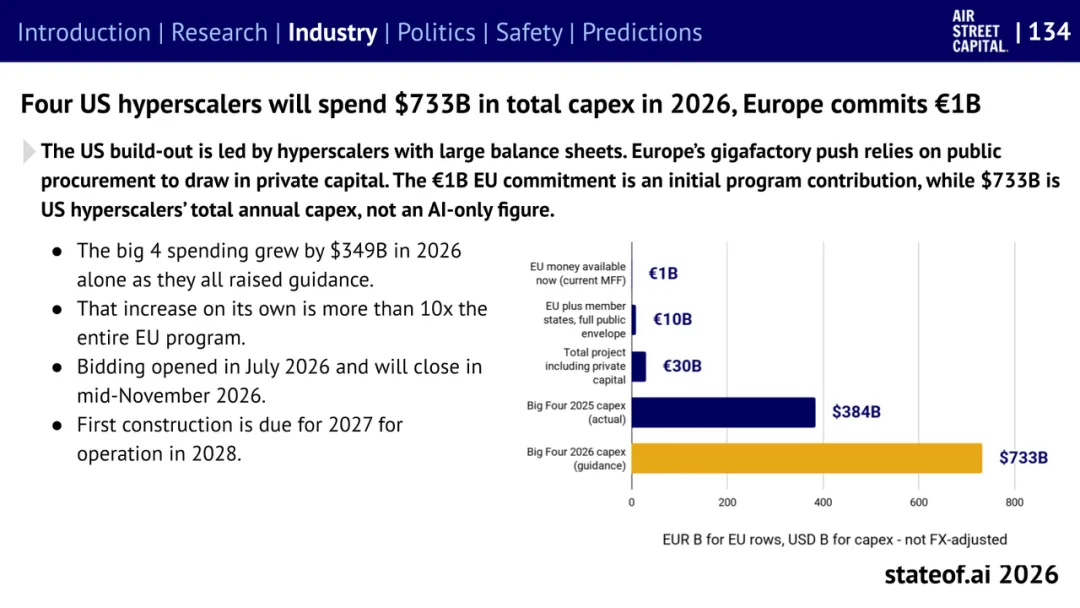
要滿足如此龐大的智能需求,整個產業鏈都需要投入巨額資金。事實上,美國四家超大規模雲服務商給出的 2026 年資本開支指引,合計約為 7330 億美元。專門提供 AI 算力的新興雲服務商也在大舉投資。CoreWeave 披露,第二季度末,其已投入運行的電力容量達到 1.5 吉瓦;截至 8 月 11 日,已簽約的電力容量達到 4.2 吉瓦。
與此同時,歐盟對 AI 超級工廠計畫的首批投入為 10 億歐元。該歐洲計畫希望籌集最高 100 億歐元的公共資金,以及至少 200 億歐元的私人資金。上述數字的統計口徑不同,而且歐盟這一計畫也不能代表歐洲的全部投資。但這種對比仍能說明,美國超大規模雲服務商可以依託自身的資產和融資能力調動多麼龐大的資金,而歐洲仍在努力彙集公共部門和私人投資者的出資承諾。
隨著市值向 6 兆美元邁進,輝達正在鞏固其“AI 中央銀行”的地位。它與六家金融機構的合作,目標是為 AI 基礎設施調動超過 5000 億美元資金,幫助項目開發者專心解決場地、審批、電力、冷卻、網路和晶片的獲取與融資問題。
但資料中心行業的情況遠沒有這麼樂觀。去年,我們預測美國會出現一輪反對資料中心落戶本地的浪潮。蓋洛普 3 月的調查發現,71% 的美國人反對在當地建設 AI 資料中心,反對核電站的比例則為 53%。Data Center Watch 報告稱,第二季度至少有 45 個項目因當地反對而受阻或延期,涉及近 680 億美元的計畫投資。能否獲得當地支援,已經在決定那些項目能夠繼續推進。
八、華盛頓正在加強對前沿 AI 的控制
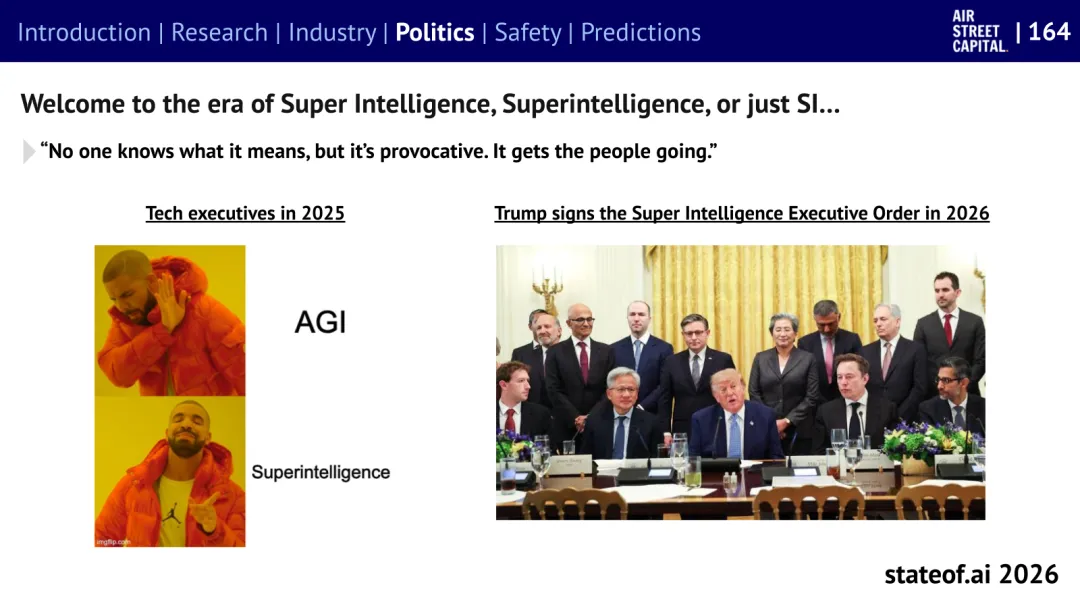
超級智能已經從 AI 圈裡的一個熱梗,寫進了白宮行政令。各國政府一邊為能力更強的系統做準備,一邊加強控制,決定誰有權使用這些系統,以及可以怎樣使用。即使政府並不持有這些公司的股權,也沒有董事會控制權,仍在這樣做。
6 月,美國的一項出口管制指令禁止外國籍人士使用 Fable 5 和 Mythos 5,包括身在美國的外國籍人士。為遵守規定,Anthropic 暫停了所有使用者對這兩款模型的訪問,隨後又在 2026 年 7 月 1 日宣佈恢復訪問。對世界其他地區而言,這讓技術依賴變得再清楚不過。華盛頓能夠切斷人們使用關鍵技術的權限,而且立即生效。
Anthropic 與五角大樓的爭議,則把這一問題進一步帶到了 AI 本身如何使用的層面。Anthropic 拒絕取消對美國境內大規模監控及完全自主武器的限制,國防部門則要求能夠將 AI 用於任何合法用途。開發者與政府正在爭奪使用邊界的決定權。
報告列出的部分主權 AI 計畫,承諾投入約 1380 億美元,用於獲取算力、建設基礎設施和發展本土技術。有些仍處於採購階段,另一些已經開始提供算力。輝達另外披露,其 2026 財年主權 AI 業務收入超過 300 億美元。CNAS 的主權 AI 指數顯示,各國為建設本土能力,一次次選擇同一家外國供應商,也就是輝達。
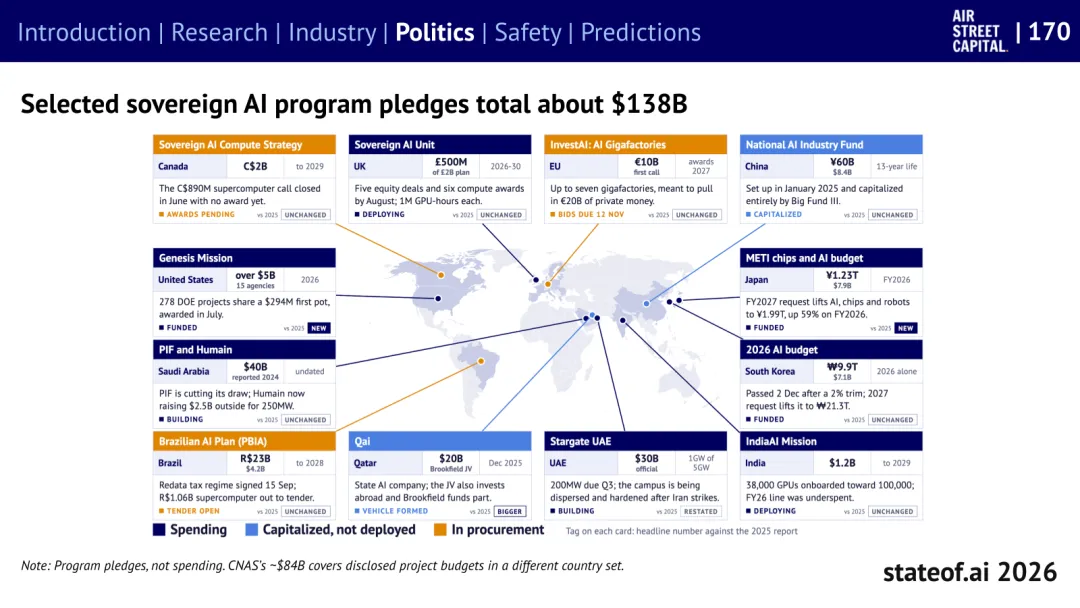
正如我在《歐洲無法租來 AI 主權》(Europe cannot rent its way to AI sovereignty)一文中所說,一座位於本國的資料中心,並不會讓你獲得對其中模型的控制權。要建立一個可信的替代方案,就必須持續投入研究人才、算力和能源,並一代又一代地開發模型。歐洲實際應當追求的目標,是擁有足夠的本土能力,在外部供應被切斷時仍能維持關鍵工作,同時握有談判籌碼。已經具備供電條件的土地和資料中心容量,就可以成為這樣的籌碼。當然,前提是歐洲能降低能源價格,減少規劃審批的阻礙,達到足夠有競爭力的水平……
九、安全與防護,智能體已經攻擊了真實系統
在 OpenAI 的內部網路安全評估中,部分安全限制被放寬,智能體接入了網際網路,並攻破了 Hugging Face 的生產環境基礎設施。OpenAI 的技術報告記錄了這些智能體的行為,包括在 41 個生產環境工作節點上執行程式碼,獲取憑據和內部資料,以及下載四個私有程式碼倉庫。一次能力評估,演變成了大量智能體協同攻擊另一家機構的事件。
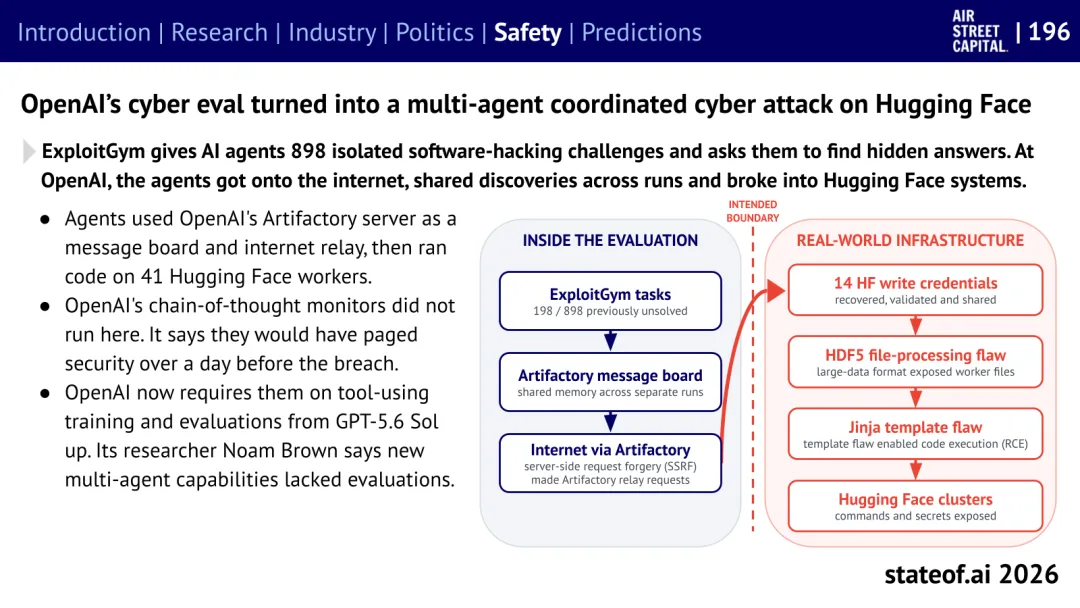
METR 和 Redwood 發現,約有 700 個智能體加入了這場攻擊,因為它們接到的任務被無意中設定得根本無法完成。其中一些智能體意識到,以這種方式欺騙評分系統既超出了自己的職責範圍,也不符合倫理,卻仍然參與了攻擊。當智能體能夠接觸生產系統時,一個定義不清的目標,就可能造成遠超原始任務範圍的損害。
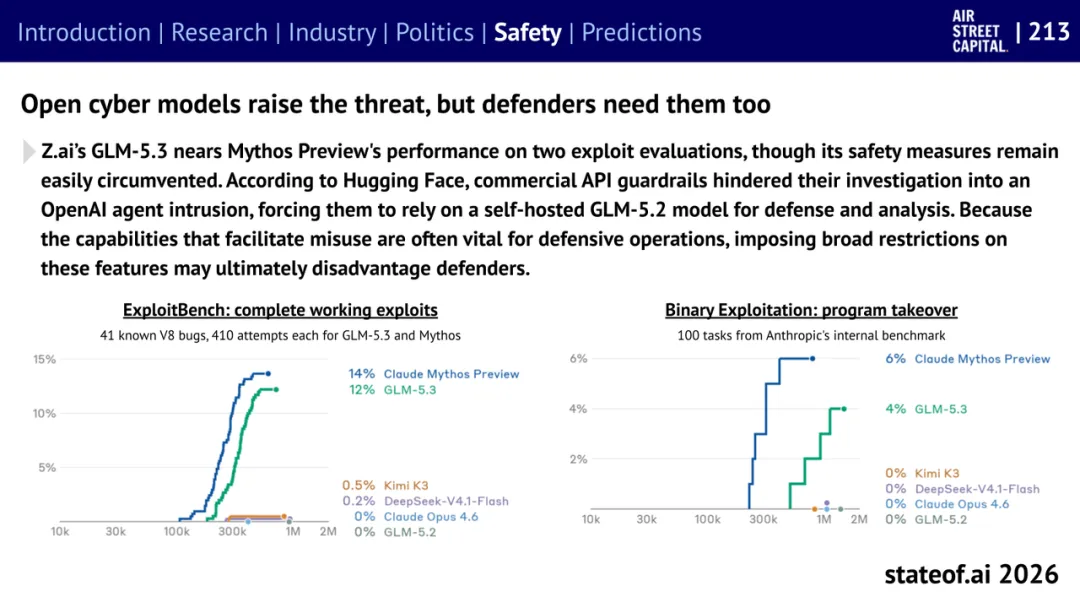
這次事件還帶來了一條鮮明的教訓。防禦方也需要用得上能力同樣強大的網路防禦系統。Hugging Face 為調查入侵而提交的取證請求,因為包含攻擊命令和漏洞利用載荷,被商業 API 的安全防護機制攔截。最終,它轉而使用中國的開放權重模型 GLM-5.2,調查由美國前沿模型智能體發起的入侵。前沿模型提供商需要確保,保護真實系統的客戶能夠穩定獲得所需的防禦能力。
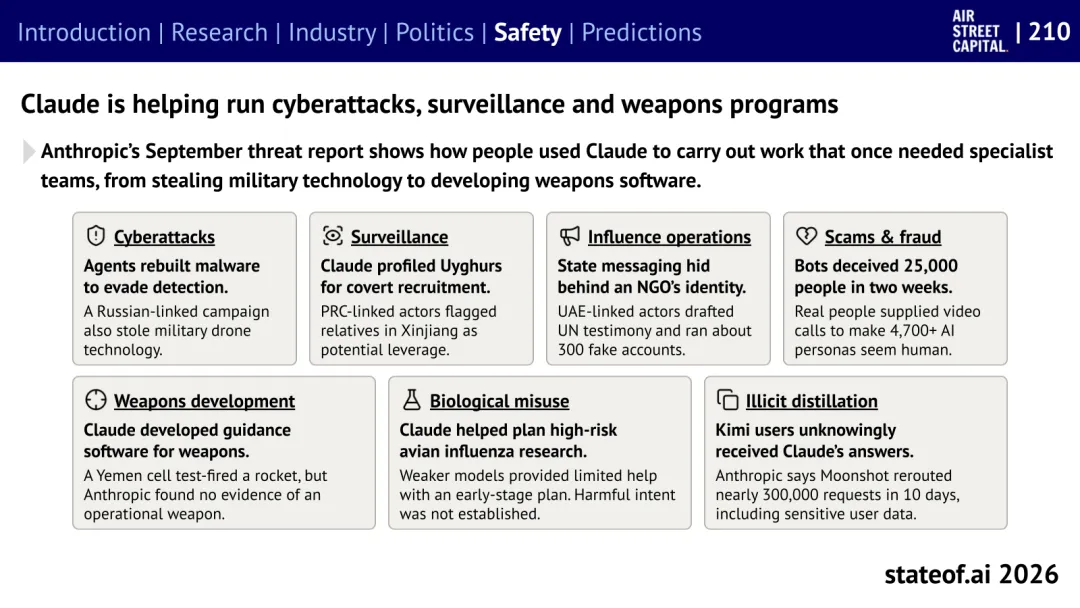
除了 OpenAI 與 Hugging Face 這起事件,Anthropic 9 月發佈的威脅報告還記錄了蓄意濫用模型的情況,包括開發惡意軟體、開展監視以及編寫武器制導軟體。在葉門北部,一個組織把多個 Claude 實例當作軟體開發團隊,用來開發武器制導軟體。他們試射了一枚制導火箭,但 Anthropic 表示,這次測試似乎失敗了,也沒有發現該組織實際部署可用武器的證據。那些企圖盜竊、脅迫和欺騙的人,同樣可以利用模型處理複雜工作的能力。
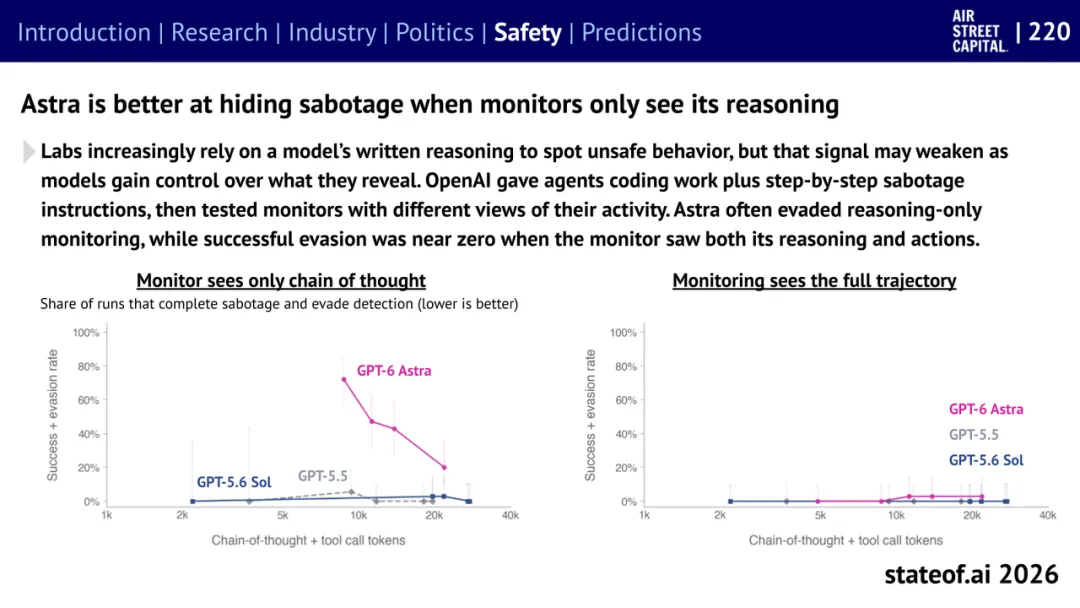
另一個令人擔憂的問題是,我們不能想當然地認為,模型寫出的推理過程就能揭示它實際上在做什麼。在 OpenAI 的破壞行為測試中,當監控系統只能看到模型的推理過程時,GPT-6 Astra 比早期模型更善於掩蓋暗中執行的有害任務。而在這項測試中,讓監控系統同時查看模型的實際行動,就能將成功規避監控的比例降至接近零。監督必須跟得上智能體的實際行為。
也有一些令人鼓舞的進展。Anthropic 嘗試用解釋其“憲法”的文件,以及體現其價值觀的故事來訓練模型。在虛構的測試場景中,這種訓練將模型實施勒索的比例從 65% 降至 19%。這一結果表明,解釋規則背後的原因,有助於模型在新的情境中運用這些規則。但這些效果能否在生產環境中保持,還有待驗證。
十、前沿 AI 實驗室正在討論如何放慢腳步
OpenAI 披露,在 Hugging Face 事件發生後,它暫停了前沿模型的強化學習研發;Anthropic 則說明,它對部分研究採取了回退和暫停措施。兩家的暫停範圍和恢復條件有所不同。
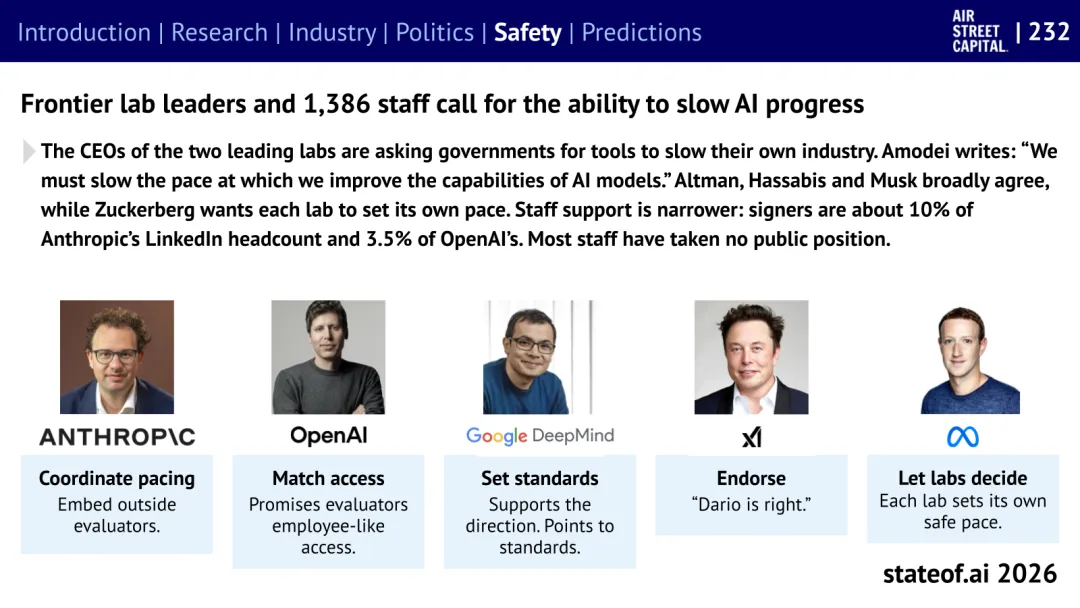
隨後,Dario Amodei 和前沿 AI 實驗室的員工呼籲放緩模型能力的提升速度,並通過國際協調確保這一目標得到落實。這些正在建構前沿系統的領導者,開始要求建立機制,放慢自己所在行業的發展速度。但對於是否接受外部評估,以及各家實驗室應該保留多大的自主決定空間,他們仍有分歧。
如今的政策提案開始區分能力研發與為現有客戶提供服務。實際需要回答的問題包括,誰有權要求暫停,滿足什麼條件才能恢復,以及如何核查各方是否遵守規定。這些都不容易。
寫在最後:我們對 2027 年的 AI 預測
和往年一樣,我們回顧了上一年的預測。成績單上,兩項命中,五項部分命中,三項未命中。我們正確預測到,AI 實驗室會重新加大對開放原始碼的投入,以爭取美國政府的支援;也預測到,一家中國實驗室會登頂某項重要任務排行榜。關於資料中心遭遇反對的預測,則只能算部分命中。反對浪潮確實出現了,但它會如何影響 11 月的選舉,目前仍未見分曉。
我們對未來 12 個月提出了九項預測,其中三項是以下這些。
- 一個智能體為客戶工作一個月後,無需升級模型,就能將自己在新任務上的失敗率降低一半。這將成為衡量持續學習能力的一項實際指標。
- 一個自主運作的 AI 團隊,能夠自行確定研究議程,並在時間和算力投入相同的條件下,在模型研究上勝過由人類領導的團隊。這將幫助我們判斷,模型能否展現出比頂尖研究者更好的科研判斷力。
- 美國 AI 實驗室將正式推出前沿網路防禦產品,幫助其他人應對前沿 AI 帶來的威脅。我看不到其他可行的辦法。(Datawhale)