
SK 海力士在 OCP 2026 亮出 MARS 與 HBF:推理的勝負手,正從算力挪到「KV 快取搬不搬得動」
SK 海力士高級副總裁 Hoshik Kim 在 2026 年 OCP 全球峰會上,同時講了 MARS(以記憶體為中心的 AI 機架級系統)和 HBF(高頻寬快閃記憶體)。一個想把記憶體從伺服器裡拆出來做機架級共享池,一個想在 HBM 之外加一層大容量、近 HBM 頻寬的快閃記憶體。對做推理的人,這事現在就該看:多輪 Agent 把 KV 快取堆成山,HBM 先扛不住。
聚焦 🔍
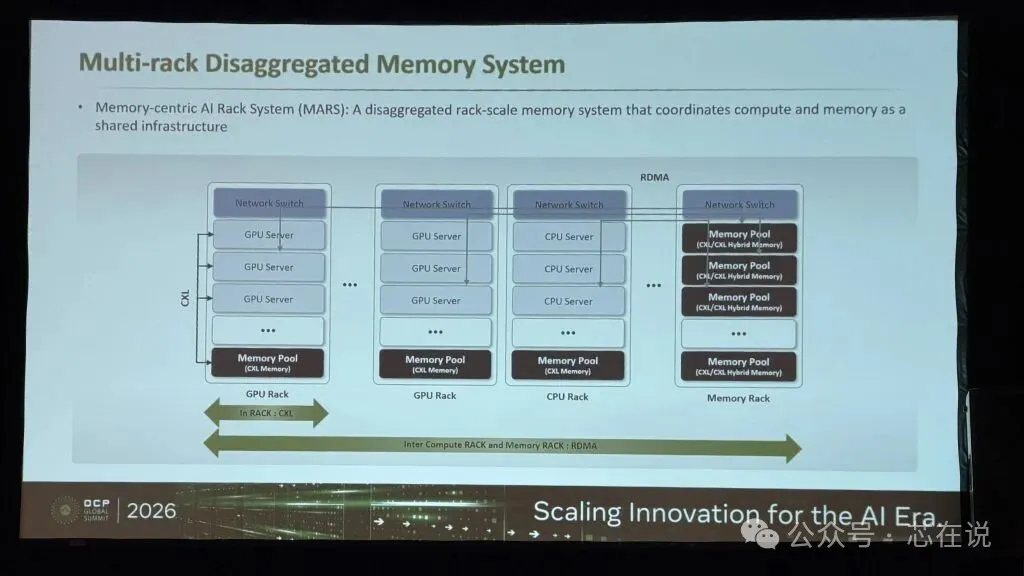
MARS 的思路是「記憶體分離」:把記憶體從 CPU/GPU 伺服器的限制裡解耦,做成專用的海量記憶體池,並從托盤級記憶體池擴展到機架級。Kim 給出的應用場景是多輪 AI 智能體推理,膨脹的 KV 快取被轉存進共用記憶體,不再吃掉 GPU 視訊記憶體和記憶體系統。官方口徑是 TTFT(首詞元時間)相比重新計算提升 3 到 5 倍,尾部延遲被大幅壓低。
以處理器為中心的叢集,死法很具體
A 伺服器 512GB 閒著,B 伺服器爆記憶體,借不了。要加記憶體,只能買整台新節點。營運商於是被迫過度配置 GPU,TCO 往上走,利用率往下掉。Kim 的說法是,要從「每台伺服器留余量」轉向「池級效率」。
這套帳我熟。以前在機房調優,最氣人的不是資源不夠,是資源明明在那兒,就是不歸你。
洞察 💡
記憶體漲價不是缺貨,是帳期遊戲。但推理的瓶頸比帳期硬:詞元成本裡藏著一個很少被單獨算的變數,KV 快取的駐留時長。Agent 越會聊,上下文越長,同樣一塊 HBM 就要多養一批「停著不走」的快取。HBM 是按頻寬定價的,拿來當倉庫用,每一個詞元都在替倉儲費買單。
HBF:頻寬砍半,容量乘 14
HBF 是這次更值得盯的牌。Kim 的原話要點:頻寬通常是 HBM 的一半,容量約為 HBM 的 14 倍。節奏方面,OCP HBF 規範 0.7 版本在今年 7 月發佈,1.0 版預計明年初,HBF Cube 計畫 2028 年初送樣,目前在做概念原型。
頻寬砍半,容量乘 14,這筆帳很像給「大模型長期記憶」留的後門。熱資料放 HBM,溫資料放 HBF,冷資料放 SSD,三層擺開,視訊記憶體焦慮才有解。
警示 ⚠️
2028 年初才送樣,意味著量產和上機櫃還在更後面。現在凡是把「HBF 救活推理」寫成現成方案的文章,炒的是標準預期,不是產品。另外別忘了,3 到 5 倍的 TTFT 提升是廠商演講裡的對比資料,基線是「重新計算」,不是一套調優過的快取解除安裝方案。基線換了,倍數就得重算。
我大學學電腦那會兒,作業系統課上老師畫記憶體金字塔,從暫存器一路畫到磁碟。現在這個金字塔被橫過來擺進了機架:左邊算,右邊存,CXL、MARS、HBF 都在搶中間那塊「既不像記憶體也不像硬碟」的灰色地帶。
關鍵 📌
MARS 解決的是記憶體沒法跨節點共享,HBF 解決的是 HBM 容量太小。兩件事擺一起看,SK 海力士要的不只是賣顆粒,而是在 AI 機架裡拿到定義記憶體池介面和分層方式的位置。HBM 的紅利越吃越緊,下一塊地盤是池化記憶體的標準話語權。
一個可能挨罵的判斷
接下來 TTFT 的軍備競賽,未必打在 GPU 浮點上,更可能打在 KV 快取搬不搬得動上。GPU 再猛,上下文在 PCIe 通道上排隊,使用者等的就是那幾百毫秒。流量不是演算法給的,是人性漏出來的,人等不及就切 APP。
反過來想也成立:如果 KV 快取的命中率和復用率本身沒那麼高,池化記憶體的收益會比演講裡小得多。這個數,廠商不會替你算,得拿自己的流量去測。
機會 ✅
一個可復用的分層判斷框架,按「詞元生命周期」配記憶體,別再按「伺服器」配:
熱層(HBM):時延敏感,單請求上下文小,prefill 頭部。
溫層(HBF、CXL 記憶體擴展、機架級記憶體池):多輪 Agent,長文件,企業知識庫常駐。
冷層(SSD、對象記憶體):日誌,歸檔,微調樣本。
選型前先量三個數:平均上下文長度,快取復用率,重新計算一次的代價。
有個彆扭,幹這行的才懂:跟客戶說「8 張卡」,他聽得明白。說「機架級分離式記憶體池」,他以為你在賣雲。可再過兩年,只會堆卡的整合商,大概要被懂記憶體分層的人擠到邊上去。
洛陽那邊,牡丹花會照舊人擠人,龍門石窟的盧舍那大佛不管深圳漲不漲價,都坐在那兒。我們搞半導體的和大佛差不多,區別就一條:大佛不慌,我們總怕錯過下一代介面。 (芯在說)