

深度揭秘第六代AMD EPYC伺服器CPU技術細節。

芯東西11月12日報導,進入11月,AMD喜訊不斷,上周最新財報披露Q3資料中心收入接近乎翻倍,這周股價連續走高,三天上漲超13%。

昨天,AMD宣佈採用SP7封裝的第六代EPYC 9006 SP7伺服器CPU “Venice”全面上市,首批AMD Helion智能體AI機架將於本月陸續上市。

在Q3財報電話會議上,AMD董事會主席兼CEO蘇姿丰博士稱,“Venice”晶片的早期需求是EPYC歷代新品中最強勁的。
AMD在第三季度開始交付“Venice”處理器,OEM和ODM合作夥伴承諾推出超過240款平台,比第五代“Turin”多出20%,雲實例計畫於2027年初陸續上線。
這些都說明“Venice”已經開始賣座。
那為何“Venice”賣得這麼好呢?這次AMD技術大佬們也不藏了,上周在拉斯維加斯的一場閉門技術會上,把第六代EPYC伺服器CPU的設計目標和技術細節里奇外外講了個遍。芯東西在現場足足整理了六萬字筆記。
從智能體AI時代需要什麼樣的CPU,到為什麼要做四款不同配置的CPU,再到“Venice”的架構細節,包括SoC架構、微核心架構、記憶體、I/O、功耗管理等創新技術,AMD高管和技術專家們講得非常深入,並花了很長時間來討論如何降低記憶體成本,資訊量爆棚。
AMD迄今已發佈六代伺服器CPU,從2018年推出的初代“Naples”到第六代“Venice”,性能提升多達近20倍。


“Venice”最多提供256核、512線程、1.6TB/s記憶體頻寬、5.3GHz運行頻率,計算Die採用2nm製程工藝。
與英特爾至強6980P、輝達Vera CPU相比,“Venice”的線程密度、每核性能、吞吐量都顯著提升,因此能提供更高的每瓦、每美元、每機架智能體性能。

據AMD現場分享,今年年初,其伺服器CPU市場份額還處於40%出頭的水平,如今已攀升至40%中段;大多數美國財富100強企業都在資料中心採用EPYC處理器。

AMD還披露了未來路線圖,第七代“Florence”將於2028年發佈,同樣採用兩種核心路線,將採用下一代製程工藝和記憶體,並將AI計算擴展(ACE)推向市場;第八代“Ravenna”也已經在開發中。

如今智能體AI計算需求爆炸式發展,新一代AI基礎設施已是算力廠商的兵家必爭之地。“Venice”憑什麼承載起AMD進一步擴張伺服器CPU疆域的雄心?
答案,就藏在一系列硬體設計的技術創新裡。
本文對第六代AMD EPYC伺服器CPU的技術細節與產品亮點進行了精編,按如下章節分享:
1、第六代EPYC伺服器CPU產品組合與型號。
2、智能體AI、雲端運算、HPC與垂直市場性能對比。
3、Helion智能體AI機架與智能體工具包。
4、“Venice” SoC:CCD、I/O Die與資料通路。
5、Zen 6c核心的11項關鍵改進。
6、全新Zen 6指令集與AI計算最佳化。
7、記憶體:DDR5、LPDDR5X、CXL 3.1。
8、MEXT:記憶體黑科技讓DRAM容量減半。
9、I/O:PCIe Gen 6與SDXI資料搬運引擎。
10、功耗管理:DFP、UPP、UBPS、FAST。
11、RAS、機密計算與安全最佳化。
01. 第六代AMD EPYC伺服器CPU:四款產品,最高256核、5.3GHz頻率
第六代AMD EPYC伺服器CPU產品組合共有四款產品,包括“Venice” SP7、“Venice” SP8、“Venice-X”和“Verano”,分別面向不同的工作負載計算需求。

(1)“Venice” 9006 SP7:旗艦產品,面向高計算吞吐需求,採用緊湊型插槽設計(76 x 80mm),高密度Zen 6c配置最多256核和512線程、4.1GHz頻率,高頻Zen 6配置最多96核和192線程、5.3GHz頻率;支援單路和雙路部署,單路最多提供96條PCIe Gen 6通道,單通道頻寬是上一代產品的2倍;支援符合JEDEC標準的MRDIMM-12800,每插槽可提供1.6TB/s記憶體頻寬;處理器功耗可配400–600W。產品已開始出貨。
(2)“Venice” 9006 SP8:面向計算需求相對適中、重視I/O能力和成本效率的企業級市場,尺寸比SP7更小(62.5 × 80mm),配備全新I/O Die,最多配置128個Zen 6c核心或96個Zen 6核心,支援8通道記憶體,每通道可裝兩條DIMM,每個插槽提供128條PCIe Gen 6。產品將於2027年上半年上市。

(3)“Venice-X” 9006X SP7:面向對大容量L3快取敏感的HPC工作負載,搭載3D V-Cache,用堆疊快取換更少的記憶體訪問,最多配備96核,L3總快取量最多可達1152MB。產品將於2027年下半年上市。
(4)“Verano” 9006 LP:面向AI主機節點,採用24通道LPDDR5X,可降低非CPU核心部分的功耗,通過可更換的SOCAMM記憶體模組提供記憶體,降低記憶體側功耗。產品將於2027年下半年上市。

雖然“Verano”採用BGA封裝,而“Venice” SP7採用SMLGA插槽,但從邏輯架構來看,CCD與I/O Die之間的資料通路得到了完整復用。因此,“Verano”能提供與SP7相同的核心級性能能力。

“Venice” 9006 SP7伺服器CPU的型號如下。其中“F”代表高頻型號,採用Zen 6核心。

不同市場對性能、能效和計算密度的關注重點不同,因此“Venice” CPU架構需對不同運行區間進行最佳化。
下圖中,縱軸代表性能,橫軸代表功耗。圖中標註的15%~100%利用率,指的是SoC整體的核心活躍比例,也就是同一時間有多少CPU核心正在運行。

右側的HPC和主機節點工作負載非常重視單核心峰值性能,往往具有突發性,同時對延遲較敏感,因此CPU必須具備足夠寬的動態運行範圍,所以AMD利用更先進的製程工藝把核心的最高運行頻率拉到5.3GHz。
另外兩個工作負載是雲端運算和Agentic-Bulk。當CPU核心利用率下降時,功耗預算可以集中到正在運行的核心上,CPU核心必須具備足夠寬的頻率和功耗調節範圍,才能將這些額外功耗轉化為相應的性能提升。因此Zen 6c核心需要具備最高4.1GHz的運行頻率。
如果將SoC功耗預算進一步降低至400W,設計重點已經轉向計算密度。在這個運行區間,AMD更關注每兆瓦能提供多少線程、每瓦功耗能提供多少計算性能。
02. “面向智能體AI時代的最佳CPU”,雲端運算、HPC與垂直市場性能表現超競品
AMD將EPYC 9006 SP7伺服器CPU定位為“面向智能體AI時代的最佳CPU”,為智能體AI基礎設施涵蓋的三類CPU(通用服務、AI主機節點、智能體沙箱)都設計了針對工作負載最佳化的處理器。

(1)在通用計算測試中,“Venice”的每瓦性能相較上一代提升40%,是輝達Vera、Arm AGI、第六代英特爾至強等CPU的約1.5倍-3.5倍。

(2)高達5.3GHz的高頻主機節點處理器可提供多達上一代1.6倍、第六代至強1.8倍的大語言模型輸出吞吐量。

(3)高密度AMD EPYC處理器在託管智能體沙箱方面,每CPU瓦特的智能體數量是輝達Vera的約3.3倍、英特爾至強6980P的約2.5倍。

對於智能體沙箱,基於AMD EPYC 9996 CPU的伺服器在相同35千瓦功耗範圍內,每個機架可支援的智能體數量約是使用默認電源管理設定的系統的1.18倍。
為什麼是“最佳”?AMD稱,“Venice”在Token經濟性、每美元Token產出、最高智能體承載數量、每瓦智能體承載能力等方面均有領先表現,同時也是世界上能效最高、每瓦性能最出色的智能體AI CPU。
相比上一代,AMD EPYC 9006 “Venice”伺服器CPU在整數計算、浮點計算、記憶體頻寬、高性能計算、矩陣計算工作負載的性能提升多達1.3倍~2.7倍。

對於智能體AI應用,模型呼叫、檢索、路由、文件解析、程式碼編譯和沙箱執行都會佔用CPU。

AMD將智能體流程拆開來測試,對比英特爾至強6980P,在多數情況下,“Venice”的性能至少達到2.4~2.8倍;在tokenize和編排方面,“Venice”的性能達到3.5倍。
與輝達Vera公開資料相比,在雙方都使用各自最優編譯器的比較口徑下,“Venice”可提供2.8倍的吞吐量、1.3倍的每核性能和1.3倍的記憶體頻寬。

從智能體AI的安全需求來看,AMD正在安全生命周期、威脅覆蓋範圍、基礎安全能力、遠端證明和身份驗證、機密計算等多個層面建立相應能力。

面向企業和雲服務應用,基於AMD EPYC 9996 CPU的系統,與基於輝達Vera CPU的系統相比,性能最高可提升至3.7倍;與基於英特爾至強6980P的系統相比,性能最高可提升至2.2倍,性價比最高可提升至2.0倍。
微軟Azure宣佈預覽基於“Venice”的HDv2實例,成為首個提供第六代EPYC的雲服務商。
對於高性能計算(HPC)工作負載,根據已發佈的SPECrate基準測試結果,“Venice”憑藉高記憶體頻寬和領先的計算性能,能夠幫助縮短生命科學、量子化學和天氣預報等領域複雜模擬的洞察時間。
在AMD展示的單節點測試中,對比英特爾Granite Rapids,“Venice”的SPEC HPC 2021性能達2.3倍,STREAM測試性能達2.2倍。
在有限元分析、計算流體力學、SPICE電路模擬、天氣預測等工作負載中,“Venice”相比競品都實現了顯著的性能提升。

在垂直市場,企業客戶購買的並不只是一顆CPU,而是解決業務問題的方案。
面向資料中心現代化,相對於當前已部署的英特爾至強Ice Lake系統,遷到“Venice”可幫客戶將伺服器數量最多減少86%,並將五年總擁有成本降低37%。

同時,“Venice”非常適合用於記憶體基礎設施,能夠實現約為第六代至強方案3.3倍的記憶體和資料庫吞吐量。
與第六代英特爾至強相比,Databricks使用“Venice”,在SQL事務處理方面實現略高於2.6倍的性能表現,NoSQL性能則達到3.5倍,在一組智能體AI工作負載中性能提升多達2.7倍。

相較上一代,運行金融開源庫QuantLib時,“Venice”的總吞吐量提升約80%,按單位功耗衡量,可完成的任務數量增加了約50%;運行NUMPY和SCIPY開源庫時,“Venice”單台伺服器的平均性能達到約2.1~2.3倍。

在製造業,相比上一代,“Venice”運行不同工業軟體時性能提高至1.3倍~1.6倍。
在電信業,“Venice”可實現相對於上一代約3倍的單位功耗流量處理能力,也就是說在相近功耗下能處理3倍的流量,從而逐步降低營運商的營運成本。
在醫療業,從第六代英特爾至強平台遷到“Venice”後,運行分子模擬任務可實現3倍的性能。

03. Helion智能體AI機架:最高3.7萬核、7.4萬線程,能跑7.3萬個智能體
“Venice”旨在成為最出色的智能體AI CPU,高密度Helion智能體AI機架則負責將這些領先能力整合起來,為客戶交付完整解決方案。
跟英特爾、Arm AGI,輝達Vera機架相比,“Venice”依然表現得贏麻了,提供了最多的73728個線程。

Helion提供三種部署選項:

(1)Helion Liquid:專為與AMD Helios機架級解決方案並肩部署於大規模智能體AI環境中而設計,擁有最高的智能體密度,機架功率為120kW,單櫃可容納36864核、73728個線程,運行超過73000個智能體。
(2)Helion Air:擴展風冷資料中心的智能體容量,在約60kW機架功率下可提供1.6萬個以上的核心,承載超過32000個智能體。
(3)Helion Air Inference:將CPU執行和本地GPU推理整合於同一機架中,本地同時跑模型和工具。

如果客戶希望在供電受限的機架中運行更多智能體,AMD提供了一項統一功率配置功能。它可以在CPU和記憶體之間統籌功率,動態分配功率預算;當記憶體需要更多功率時,可以對CPU進行功率限制。啟用這項功能後,在相同功率預算下可獲得20%的性能提升。
AMD Helion智能體AI機架通過開放的智能體AI基礎設施藍圖,把靈活性交給客戶。客戶可根據自身基礎設施的需求,選擇合適的CPU和GPU容量、散熱和連接方式。
用於智能體沙箱的伺服器CPU配備了ROCm Agentic Toolkit智能體工具包,可在Helion上管理會話、調度任務,並用處理程序級或虛擬機器級沙箱隔離工具,幫助客戶簡化部署和擴展智能體AI的過程。

目前AMD已有超過10款通過Helion認證的機架。首批Helion機架將從今年11月開始上市。
04. Venice SoC:兩類核心,復用I/O Die,重新設計Die互聯
在設計“Venice”時,AMD確立了一些明確目標:實現最高吞吐量、最低總擁有成本(TCO)、最佳能效,同時保留AMD一貫重視的企業級功能。

Zen 6核心是整顆“Venice” SP7 SoC的基礎。這些核心以核心計算Die(CCD)的形式整合到SoC中,最多有8顆CCD,通過2顆I/O Die連接到整個系統。
Zen 6主打單核性能,Zen 6c主打核心密度,兩者共享同一套核心邏輯和x86指令集。
高頻Zen 6 CCD整合12核,高密度Zen 6c CCD整合32核。每顆SoC最多可以整合8個CCD,因此高頻Zen 6版本最多提供96核,而Zen 6c版最多可提供256核。
兩種配置均支援同步多線程技術(SMT),分別提供最多192個線程和512個線程。

CPU核心之外的相關功能模組主要由I/O Die承擔。2顆I/O Die採用同一設計,在封裝裡相互旋轉180度。每顆有8個DDR5通道、48條PCIe 6.0通道,並整合控制邏輯、電源管理模組、I/O Hub、安全微控製器等元件。
第五代Infinity Fabric負責把請求送到目標CCD、記憶體控製器或I/O連接埠,管理流量和服務質量,並通過大量控製器及Fabric路由機制,確保CPU核心能夠及時獲得資料,同時讓不同資料流達到所需的性能水平。

為確保核心獲得足夠的資料供給,“Venice”還增加了SDP可擴展資料連接埠的數量,32核CCD配備4個SDP連接埠,12核CCD則配備3個SDP連接埠。每個SDP能夠提供每周期32B的讀取頻寬,以及每周期16B的寫入頻寬。
同時,AMD也在封裝層面重新考慮了CCD與I/O Die之間的連接方式,採用EFB先進扇出橋接技術,把Die之間的距離縮短至幾百微米,以降低功耗與延遲。
其體封裝過程是:在玻璃載板上形成銅柱,放置橋接晶片,進行塑封,隨後建構RDL重布線層,將訊號引導至微凸點,並在這些位置安裝有源晶片,最後將重新建構的封裝模組切割分離,形成獨立封裝單元。
兩顆I/O Die還帶來一個調度問題:線程和資料放在那一側,會影響訪問路徑。
NPS(Nodes Per Socket,每插槽節點數)是一種通過韌體來管理系統拓撲和記憶體交織方式的機制,會建立多個鄰近域,將一定數量的計算資源、記憶體資源和I/O資源組合到同一個域中。

NPS1把記憶體訪問交織到全部16個通道,適合難以精確控制線程與記憶體放置的系統;NPS2按I/O Die劃出兩個 NUMA域,每域最多128核、8個記憶體通道,單域搭配滿速MRDIMM能提供約819GB/s的理論頻寬,甚至超過了上一代“Turin”整顆SoC的記憶體頻寬;NPS4進一步細分資源,適合在一個插槽內平行運行多個獨立實例。
隨著SoC規模不斷擴大,NPS2所提供的計算資源和記憶體資源規模已經足以構成一個具有實際價值的計算單元。
05. 相比 Zen 5c,Zen 6c做了那些改進?
微架構設計有4個關鍵因素:頻率、IPC、功耗和面積。它們之間存在各種權衡,相互制約。
從Zen 4開始,AMD逐步開發能讓不同CPU核心實現差異化的技術。Zen 6系列核心則進一步強化了5個目標:
- 主核性能增長
- 高效實現最大吞吐量
- 為智能體計算工作負載增強AI能力
- 增強最低延遲運行點的能力
- 擴展可信計算能力
AMD一直在最佳化頻率和IPC之間的關係,對面向橫向擴展的Zen 6c核心設定了較低的頻率目標,因此可在核心內部增加某些資源,從而提供更高的IPC。

相比Zen 5,Zen 6的CCD核心數增至12核,最高頻率提升至5.3GHz,L3快取增至48MB,核心數最多96核。
相比Zen 5c,Zen 6c的CCD擁有翻倍的32核,可將更多工作負載完整放入單個CCD中;每核心L3快取翻倍至4MB,對應單個CCD中的L3快取增至128MB;最高頻率提升至4.1GHz;核心規模最多256核。
一個較大的虛擬機器或共享資料的多線程任務,更容易放在同一個快取一致性域內。
在固定頻率、採用輕負載測試方法的情況下,相較Zen 5c,Zen 6c的企業級和雲伺服器工作負載IPC平均提升20%左右,AI工作負載IPC平均提升約31%,綜合IPC平均提升約27%。

總體來看,相比Zen 5c,Zen 6c主要有如下改進:

(1)返回地址棧從52項增加到64項。
(2)微操作快取(Op Cache)從6K增至6.75K操作。
(3)微操作快取頻寬從每周期12條指令增至18個操作。
(4)整數調度器從統一式轉向分佈式和共享式設計,重新劃分資源,讓AGU與ALU共享部分調度器,共享調度器共96項,由於整數計算需求更高,還為ALU單獨配置了48項專用調度條目。
(5)整數物理暫存器檔案從240項增加到352項。
(6)載入佇列從64項增加到80項。
(7)記憶體佇列從96項增加到128項。
(8)浮點調度器從3x38項增加到3x60項。
(9)重排序緩衝區(ROB)從448項增加到640項。
(10)平均每核心L3快取容量從2MB增至4MB。

Zen 6c對分支預測進行了大量最佳化,提高精準率並降低延遲,還增強了微操作融合能力,能將兩條指令融合為一個微操作,讓部分指令只佔用一次調度和結果轉發。
這能同時帶來顯著的性能和功耗收益。即使ROB的物理容量沒有變化,通過微操作融合也能夠容納更多指令。

在資料快取方面,Zen 6對頻寬、TLB(地址轉換後備緩衝區)、指令窗口、資料預取都做了最佳化。
出於能效方面的考慮,L3與L2之間的資料傳輸頻寬仍然是每周期32B,L2到L1的頻寬為每周期64B。
L1 TLB對所有頁面大小都採用全相聯設計,能應對各種不同的軟體程式碼和記憶體訪問模式;L2 TLB擁有容量非常大的4KB頁面資料TLB,支援除1GB頁面之外的其他頁面大小;對於1GB頁面,提供有單獨的TLB。
低線程數和高線程數對預取激處理程序度的要求不同。對此,AMD投入了大量精力來調整預取演算法,讓它能夠根據客戶實際調度到CPU核心上的工作量,以及這些工作負載的變化情況,動態調整預取策略。

快取層級結構方面,Zen 6和Zen 6c基本架構特性大致相同,在佇列容量等方面有些差異。
與前代不同,Zen 6c能提供完整的每核心4MB L3快取。此外,32核心複合體內部保持完整的快取一致性,保留影子標籤機制,L3採用犧牲快取設計,接收從L2逐出的資料,也能借助影子標籤查到資料是否在另一個核心的快取裡。這樣,即使請求核心的快取未命中,也有機會在核心複合體內拿到資料。

對於32核版本,一個核心複合體最多可同時處理1280次從L3到記憶體的未完成命中請求。而在12核、48MB L3版本中,該數量降為480次。
全片高負載時,預取策略還會收斂,避免無效預取擠佔頻寬。
06. 全新Zen 6指令集:最佳化AI計算,VNNI INT8執行流水線數量翻倍
每推出一代新產品,AMD都會推動x86指令集進化。
全新Zen 6指令集增加了完整的FP16支援,還引入了英特爾此前在AVX方面增加的一些指令,包括VNNI INT8 相關指令和部分資料類型轉換指令,並擴展部分AVX指令與VEX編碼的IFMA支援。

AMD保留了每周期兩次512位載入,同時支援每周期4次256位載入。這樣一來,已經用上256位AVX、又難以進一步向量化的程式碼,也能更充分地使用載入通路,提高吞吐量。
在浮點計算方面,Zen 5對F16僅支援格式轉換操作,也就是必須先把資料轉成FP32,進行運算,再將結果轉換回FP16,這個過程會產生額外的轉換開銷。
而Zen 6和Zen 6c加入了完整的AVX-512 FP16計算支援,因此相關工作負載可直接執行FP16運算。
AMD還將用於AI工作負載的VNNI INT8執行流水線從Zen 5中的2條擴展到Zen 6中的4條。

同時,Zen 6新增了一個指令集功能BMM(Bit Matrix Multiply,位矩陣乘法),可執行位級操作,支援密碼學演算法、AI工作負載及其他位操作演算法。
高頻Zen 6的浮點調度器有46項,Zen 6c有60項,這正是兩種物理設計的區別之一。前者給高頻留出空間,後者可以用更大的窗口挖掘平行性。
在核心/虛擬化方面,Zen 6增加了一個新的使用者態與核心態介面FRED,用於處理中斷、異常和系統呼叫,可提供更高性能、更好的安全性,同時讓作業系統和虛擬化軟體開發者更容易使用。
性能分析也有改動。Zen 6指令集增加了一個獨立的記憶體性能分析器和IBS硬體緩衝功能。記憶體性能分析器包含一組專用暫存器和跟蹤機制,可監控記憶體系統中的活動;借助IBS緩衝功能,處理器可自動將採樣結果寫入記憶體緩衝區,減少逐樣本觸發中斷的開銷。
07. 記憶體:DDR5和LRDDR5X按需選,支援CXL 3.1協議
“Venice”採用了五類關鍵的記憶體技術。

首先是DDR5。SP7的16個DDR5通道採用1DPC,每通道支援1條DIMM,即1DPC配置。DDR5-8000 RDIMM滿通道理論頻寬約1.02TB/s,12.8GT/s MRDIMM可達約1.64TB/s。16條512GB DIMM對應最高8TB容量。

“Verano”則提供注重能效的LPDDR5X配置,將記憶體介面拆到4顆獨立的記憶體Die上,每顆6個通道,合計24個通道、768位介面,採用可更換的SOCAMM模組。計算Die用N2工藝,記憶體Die用N3工藝,I/O Die用N6工藝。
對於希望把SoC功耗壓到400W以下的主機節點,降低記憶體相關功耗能給計算核心留出更多預算。
CXL 3.1和MEXT提供了兩種擴容路徑。
CXL把裝置後面的記憶體對應進系統地址空間,可做容量擴展、軟體分層或交織。在當前記憶體價格受到明顯壓力的市場環境下,客戶可以重新利用在舊DRAM技術上的投資,通過CXL以合理成本實現TB級記憶體容量擴展。

“Venice”的全部96條PCIe通道都同時支援CXL。使用者無須提前配置,只要插入裝置,系統就能自動識別它屬於PCIe還是CXL。平台的服務質量(QoS)機制可區分本地DDR和CXL流量,降低兩者互相爭搶頻寬的影響。
MEXT是今年6月剛被AMD收入麾下的一項記憶體最佳化技術,通過將快閃記憶體作為一個記憶體層級,旨在解決記憶體浪費問題,降低記憶體成本。這是在本次技術活動最受關注的技術,沒有之一。
08. MEXT:DRAM容量減半,性能幾乎不折損
MEXT團隊早在2024年就開始與AMD合作。當時AMD想要增加可用記憶體容量,在內部145台系統採用MEXT記憶體擴展技術後,其節省的DRAM採購成本多達490萬美元,佔單系統成本的83%。

MEXT的技術思路是,利用AI監控系統運行狀態,提前預測那些記憶體頁面即將被訪問,然後在應用程式真正需要這些頁面之前,主動將它們從快閃記憶體遷回DRAM。
也就是說,通過透明化的軟體機制,讓快閃記憶體表現得像DRAM一樣。
為什麼選擇快閃記憶體?因為從單位位元來看,相比DRAM,快閃記憶體的成本低至約1/50、功耗低至約1/30,但訪問速度慢到只有DRAM的1/500。

這套方案完全由軟體實現,包括Linux驅動程式、AI引擎和用於觀察系統記憶體實際使用情況的RAMView工具。
據分享,MEXT成功做到只需一個EPYC CPU核心,就能在不到1秒內完成訓練,並開始進行高品質預測。隨著執行階段間增加,預測效果還會繼續改善。
它的好處非常直觀,能夠顯著降低伺服器DRAM成本。
假設你原本計畫購買一台配置2TB DRAM的EPYC伺服器,現在就只用買1TB DRAM,另外1TB記憶體容量則由MEXT解決方案提供。
這裡還有第二層收益。為了實現2TB DRAM容量,你可能需要採購昂貴的256GB DIMM記憶體條。但如果改用128GB DIMM,其成本遠低於256GB DIMM的一半。
因此你不僅減少了所需的DRAM總容量,還能買價格更低的DIMM。
此外,MEXT能夠擴展伺服器的可用記憶體容量。例如,一台原本配置1TB DRAM的伺服器,可通過軟體和NVMe快閃記憶體擴展,讓系統呈現出1.2TB、1.5TB、2TB、3TB甚至4TB的記憶體容量。
這些技術的應用面很廣,能部署在企業本地資料中心、雲端、虛擬機器、裸金屬伺服器上,也支援容器環境。
新採購的和已部署的EPYC伺服器,都能用這項技術。伺服器需要配備NVMe快閃記憶體盤,或者至少預留未來安裝NVMe快閃記憶體盤的空間。
AMD MEXT軟體希望實現的效果如下圖所示,從完整DRAM配置開始,逐步減少25%、50%,以此類推。
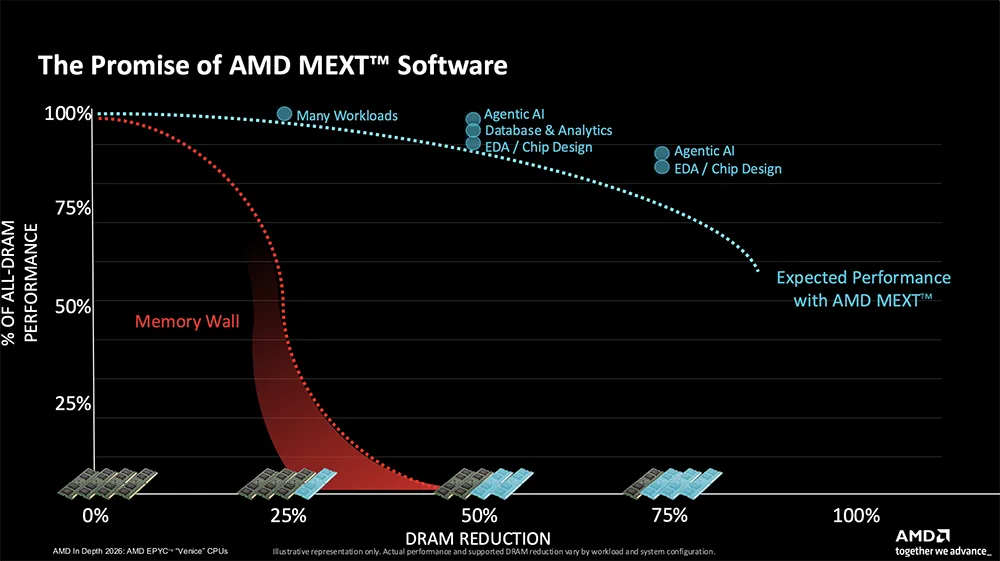
在智能體AI、資料庫分析和EDA工作負載中,MEXT能夠將DRAM容量減少一半,同時實現接近全DRAM配置的性能。
在5種智能體工作負載中,通過採用MEXT軟體,在將DRAM容量減少一半的情況下,應用性能能達到原來的99%。

即便DRAM容量減少到原來的1/4,MEXT仍能使其保持相當不錯的性能。
在“Venice”上運行Synopsys PrimeTime EDA工具,同樣將DRAM容量減半,MEXT能保留全DRAM配置95%的性能。

在微軟Azure雲平台上運行Apache Spark資料處理引擎,將DRAM容量減少一半後,MEXT使其性能達到原配置的99%。

09. I/O:最佳化PCIe 6.0與資料搬運,為CPU核心提供充足資料頻寬
面向不同工作負載,“Venice”升級至PCIe Gen 6,單通道速率升至64GT/s,還引入了新的前向糾錯機制、訊號傳輸方式及FLIT模式,以提高資料傳輸效率。

SP7單路最多可配96條PCIe Gen 6和額外8條PCIe Gen 4,雙路最多可配128條PCIe Gen 6和額外16條PCIe Gen 4。
“Venice”也最佳化了資料如何進入CPU的方式,新增PTM(Precision Time Measurement,精確時間測量)功能,用於對齊CPU連接埠和PCIe裝置的時間基準;在虛擬化和機密計算方面,支援PCIe鏈路IDE(Integrity and Data Encryption,完整性與資料加密);繼續支援熱插拔及高級錯誤報告(AER)等功能。
此外,PCIe Gen 6引入了更靈活的鏈路功耗管理能力。L0p低功耗狀態切換允許鏈路保持通訊能力的同時,進入較低功耗狀態,並根據需要恢復更高的傳輸能力。
直接快取注入功能允許裝置把即將使用的資料送入快取,縮短CPU取資料的路徑。“Venice”則改進了這項能力的啟用方式,裝置支援TPH(TLP Processing Hints,事務層封包處理提示)時可以利用其提示,平台也可為部分不支援TPH的裝置提供快取注入。
同時,客戶可根據兩個CPU節點之間的NUMA平衡需求,選擇使用2或3條xGMI鏈路。多留幾條給xGMI插槽互連,跨插槽資料交換的頻寬更高;少用一部分,則可騰出更多資源接外設。

執行記憶體資料複製、清零和加密等操作,可以交給SDXI資料搬運引擎。AMD預計SDXI的資料搬運吞吐量約為100GB/s,密碼學加速吞吐量約為50GB/s。

該引擎還支援虛擬化。客戶可將其作為支援SR-IOV的裝置進行配置,再將相應功能分配給指定客戶虛擬機器,虛擬機器就能直接利用這些資料搬運和加密加速能力。
10. 功耗管理:從Fabric功耗狀態切換,到三大關鍵技術
隨著CPU核心數量增加,如何降低計算核心之外其他SoC模組的功耗,變得越來越重要。
為此,AMD設計了一種Fabric功耗狀態切換機制DFP State Change,可根據工作負載動態調整Fabric互連網路的運行頻率,例如在延遲敏感時提高頻率、在頻寬受限時適當降低頻率。
AMD稱新一代架構已大幅縮短了功耗狀態切換時間,在不同階段切換時可避免產生資料傳輸中斷窗口。
AMD觀察到,資料中心營運商希望解決三類功耗管理挑戰:一是利用被閒置的功率預算,二是動態調整功耗,三是解決達到功率閒置時的性能管理問題。
對此,3項技術構成了“Venice”的功耗管理方案:

(1)UPP,統一功率配置。把CPU SoC和DIMM視為一個統一的功率預算管理單元,利用兩者峰值未必同時出現的特點,減少預留的功率預算,預計特定平台的功率容量規劃需求可降約10%~15%。
(2)UBPS,基於利用率的功率伸縮。根據系統忙閒動態調整功率,負載回升時再為更高電壓和頻率提供預算,更靈活地平衡性能與功耗。
(3)FAST,頻率自適應頻譜技術。給不同CPU核心劃分性能優先順序,觸及功率或溫度上限時,優先讓低優先順序核心降頻,儘量保住關鍵線程的響應時間。
這三項技術可疊加使用。客戶可以對整個平台進行性能與功耗特徵分析,再決定在什麼情況下使用那些技術,從而在平台層面實現更精細的性能和功耗最佳化。
11. RAS與安全:最佳化故障隔離與恢復,提供靈活機密性保護
任何資料中心技術都離不開對RAS(可靠性、可用性和可維護性)的高度重視。
RAS關注故障能否被發現、隔離和恢復。
在擴展RAS功能方面,“Venice”支援PCIe高級錯誤報告和CXL 3.1裝置故障恢復,記憶體方面繼續支援Chipkill級記憶體可靠性保護,並增強了機器檢查架構的錯誤記錄。

AMD也在與OCP(開放計算項目)密切合作,支援其RAS生態系統中的API增強,並正在減少研究如何減少對SMI/SMM(系統管理中斷/系統管理模式)的依賴。
從“Venice”中,AMD引入了一項MPRAS新功能,它利用片上專用微控製器,把部分原先需要SMI處理的部分工作解除安裝到片上,從而減少對業務線程的打斷。
除了這些改進外,AMD也持續增強各類互連鏈路的可靠性。例如,鏈路加密、前向糾錯、CRC校驗等機制,都是確保資料傳輸可靠性的重要組成部分。
機密計算和安全功能始終是AMD的關注重點,該公司從底層硬體能力出發,向整個系統軟體棧擴展安全保護。
“Venice”繼續配備專用安全子系統,提供靈活的機密性保護,引入加入RSA-4096,為PQC(後量子密碼學)做好準備,將零信任理念延伸到晶片層,支援Calyptra 1.2硬體信任根,持續保護AI工作負載安全,並為客戶提供自主控制平台的功能。

在機密計算方面,Zen 6指令集改進了SEV-SNP(保護頁對應的完整性),提供RMPOPT、DIRTY bit最佳化和增強的SMT保護,分別用於快速降低非安全虛擬機器與機密虛擬機器混部時的檢查開銷、讓虛擬機器即時遷移變得更加容易、在充分發揮SMT性能的同時提供安全隔離。
“Venice”還支援SEV-TIO。它建構於PCIe鏈路加密能力之上,結合TDISP,讓符合條件的裝置加入可信執行環境。對於只需保護鏈路的部署,PCIe IDE可獨立啟用,提供資料加密和完整性保護。
此外,AMD引入一項裝置來源可驗證能力,將製造階段的硬體物料資訊與晶片身份做密碼學繫結,讓客戶能在晶片層面追溯裝置來源,幫助驗證裝置的真實性和完整性,並通過OCP S.A.F.E.推進安全審計的透明度。
12. 結語:一顆CPU不能包打天下,AMD建構豐富全端軟硬元件
從第六代EPYC伺服器CPU的設計思路,可以看到AMD對後續雲端計算市場發展趨勢的研判:伺服器CPU的需求會繼續分化,不同類型的客戶會按實際工作負載來配置算力基礎設施。
AMD用同一代微核心架構和Die設計,做出高頻率、高密度、高性能、高記憶體頻寬配置,再通過不同SoC平台來提供不同配比的記憶體與I/O,不僅能服務雲端的高並行,還能覆蓋GPU主機、HPC和企業記憶體等市場需求。
同時,AMD將最佳化目標從單顆CPU擴大到了整台伺服器,通過一系列技術決策,來解決如何在有限記憶體和供電條件下將更多CPU核心轉換成有效算力的問題。
隨著記憶體資源壓力日益嚴峻,MEXT有望成為AMD未來加強資料中心市場競爭力的一個關鍵引擎。目前MEXT主要與AMD伺服器CPU打配合,我們也期待看到未來將這一技術解耦、適配更多類型CPU的可能性。
第六代EPYC伺服器CPU既能作為通用伺服器CPU獨立銷售,又能成為智能體AI系統的基礎。而AMD可以提供從晶片到機架覆蓋面極廣的豐富選擇。 (芯東西)