
15,360瓦。
這差不多是十幾台家用空調同時開的功率。
在一份韓國大學實驗室畫出的路線圖裡,它是2035年一顆AI晶片模組要吃掉的電。其中超過三分之一,沒有給GPU,而是給了它身邊一種你很可能從沒見過真面目的晶片——
HBM,高頻寬記憶體。
你電腦裡的記憶體條,是一顆顆記憶體晶片平鋪在電路板上的;HBM是把十幾層記憶體晶片像蓋樓一樣豎著疊起來,再貼在GPU旁邊。
別小看這棟“樓”。輝達每一顆資料中心GPU的性能上限,很大程度上由它決定;三星、SK海力士、美光三家的市值,今年都在這輪由AI點燃的記憶體短缺中越過或逼近了兆美元。
畫出這張路線圖的人叫金正浩,韓國科學技術院(KAIST)教授,在韓國被稱作“HBM之父”。2025年6月11日,他帶著二十多名研究生開了一整天的線上工作坊,發佈了一份371頁的講義:《HBM Roadmap Ver 1.7》。
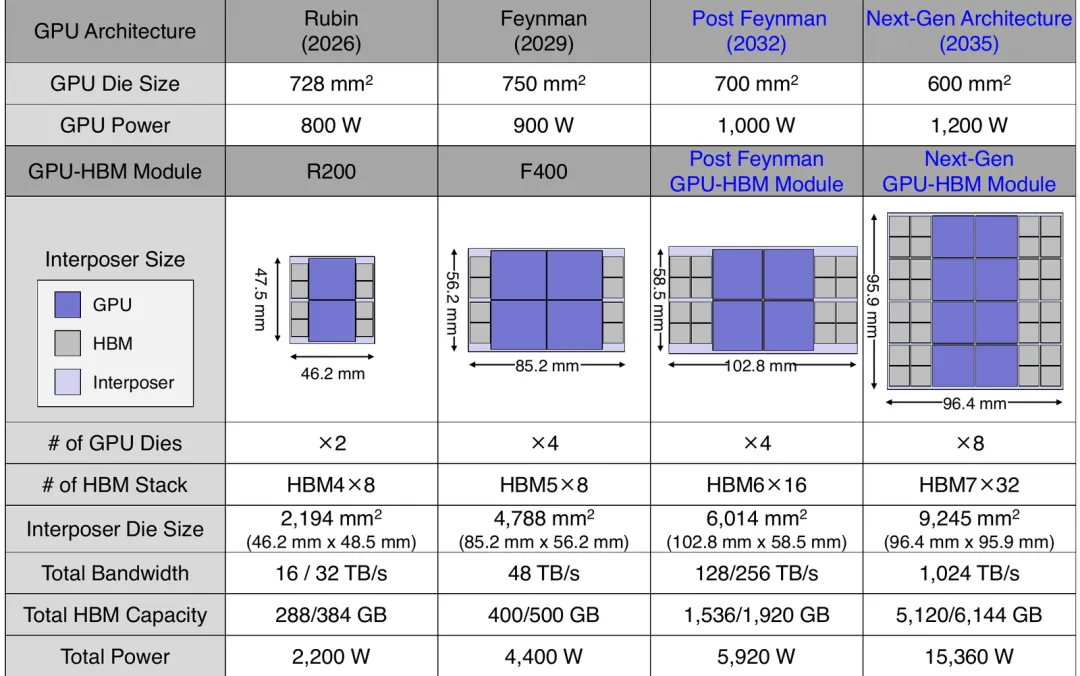
據我們檢索,這是第一份公開、完整地把HBM從HBM4推到HBM8、從2026年排到2038年的路線圖。按它的推演,一顆HBM的頻寬要從2 TB/s漲到64 TB/s,整整32倍;一個GPU模組的功耗,要從2.2千瓦漲到15.4千瓦。
發佈當周,Tom’s Hardware、Wccftech和國內多家科技媒體都做了轉載。可流傳最廣的兩個數字——“HBM4單顆288GB”“HBM8單顆6TB”——其實讀錯了:它們是講義第30頁裡整個GPU模組的總容量,不是單個HBM堆疊。
連最出圈的兩個數字都被讀錯了,這份講義值得有人從第1頁讀到第371頁。
我們讀完了,然後做了一件在中英文資料裡都沒找到先例的事:
拿這份預言,和15個月後的現實逐項對答案。
這15個月裡,HBM4已經量產,下一代HBM4E已經送樣;輝達發佈了NVHBM,親自訂HBM最底下那顆晶片的介面;SanDisk用快閃記憶體疊成的HBF,流片了第一顆。
答案有點出乎意料:
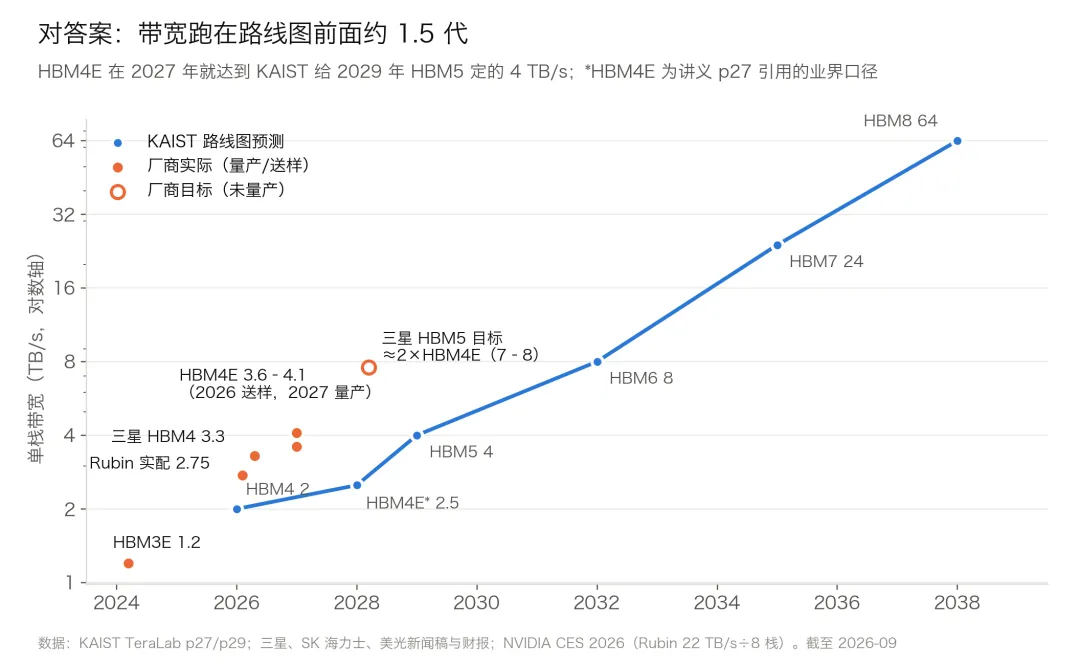
- 速度,他猜慢了。產業跑在路線圖前面約一代半。
- 架構,他猜快了。他設想的新結構,現實落後一到兩代。
- 電費,沒算平。路線圖最底層的能耗帳裡,有一個數字已經低於今天DRAM陣列訪問本身的能耗(本文估計)。
第三條最要命。後面你會看到,近存計算、以HBM為中心的計算、嵌入式冷卻,在很大程度上都可以看作這筆帳逼出來的(本文判斷)。
讀懂這三點,就讀懂了未來十二年AI晶片的主線。
30秒速讀卡:十個判斷
- 速度跑在預言前面約一代半。KAIST假設HBM4為2 TB/s,量產HBM4已達2.75–3.0 TB/s;HBM4E在2027年量產,比KAIST給HBM5定的4 TB/s早約兩年。
- 架構落後於預言一到兩代。KAIST以為HBM4就會把近存計算塞進base die;現實中客戶定製要到2027年的HBM4E,而且先只定製介面和控製器。
- 最大的隱藏假設是能效。頻寬漲32倍、功耗只許漲2.4倍,每位元能耗要在12年裡降到1/13(按講義p29口徑);而過去三代幾乎原地踏步。
- 這筆帳算不平,才有了後面的一切。近存計算、HBM為中心的計算、嵌入式冷卻,在很大程度上可以看作這張功耗表逼出來的(本文判斷)。
- 逼出3D的是幾何與RC,不是散熱。HBM8每毫米邊長要引出約1,500根線,平面中介層布不下;換細線布得下,又跑不快。
- 高度牆在鬆動,混合鍵合在推遲。JEDEC已把高度放寬到775 µm,據報還在討論900 µm以上;SK海力士已明確HBM4E不用混合鍵合。
- base die正在變成“新北橋”。記憶體控製器放在誰的晶片上,誰就掌握記憶體的定義權。權力流向“誰設計base die”,而不是整體流向記憶體廠。
- HBM越來越像快取。頻寬漲32倍、容量只漲5倍,封裝裡會長出一整套記憶體層級;HBF是吞吐機,不是延遲機。
- 錢的三個反常識。2026年一季度起,DDR5每片晶圓的收入超過HBM;HBM佔DRAM營收的比例2026年反而下降(本文推算);龍頭SK海力士受早期低價長約拖累最大。
- 中國距前沿約3–5年,產能差一個數量級以上。但HBF新賽道的護城河在NAND陣列與晶圓鍵合,而晶圓鍵合恰是國產記憶體最早量產的能力之一。
第一部分 對答案
一、一份被讀錯的預言書,和它的三個破綻
先說清楚這份講義是什麼。
它由24個報告組成:前101頁是金正浩本人90分鐘的總論,其餘23個是研究生報告。金正浩的實驗室TeraLab長期做高速互連、電源完整性和封裝設計,與韓國記憶體廠合作緊密。這決定了這份講義的長處,也決定了它的立場,後面會反覆看到。
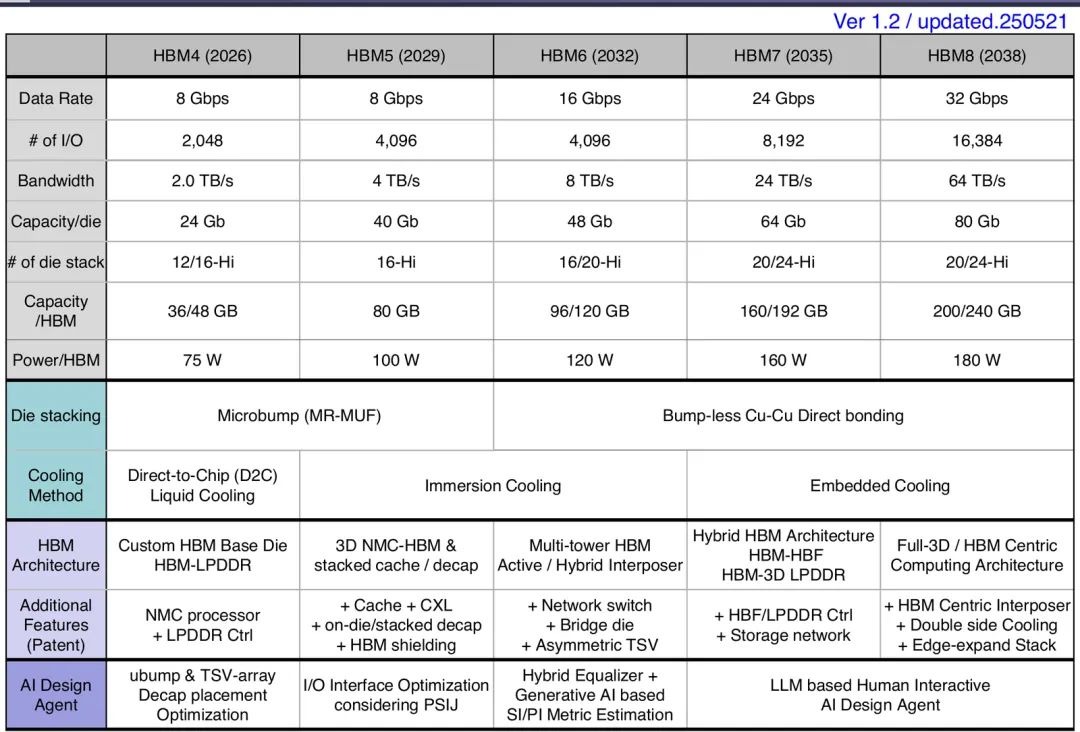
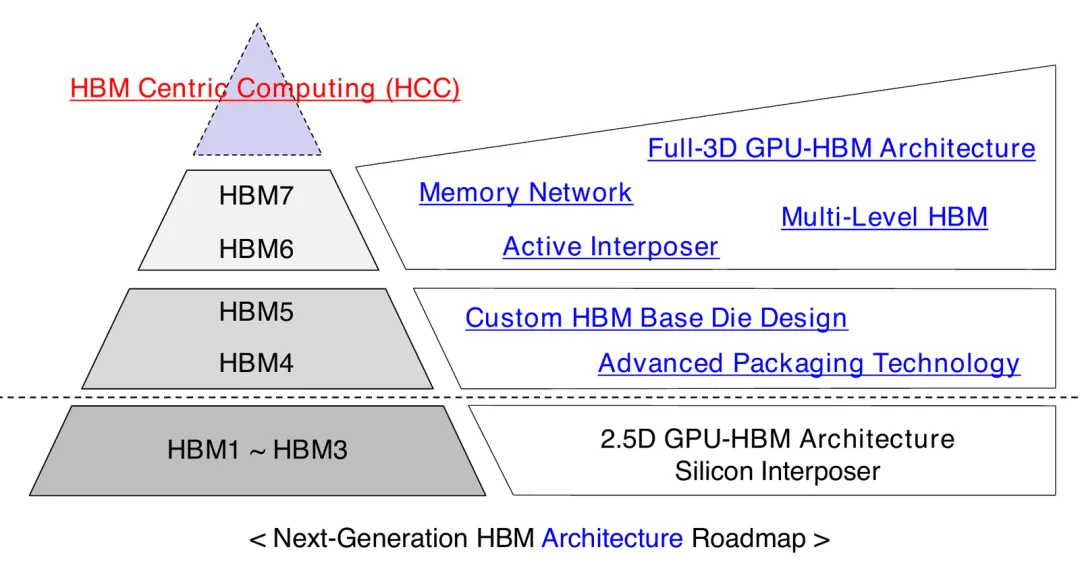
路線圖的骨架,是下面這張表:三年一代,HBM4(2026)、HBM5(2029)、HBM6(2032)、HBM7(2035)、HBM8(2038)。
再往上一層,是把這些HBM裝進GPU模組的系統推演。從這張表開始,數字變得驚人:
讀這份講義,要帶著三個提醒。
破綻一:它是拼裝的。總表右上角寫著“Ver 1.2 / updated 250521”,與封面的Ver 1.7不一致。我們逐頁核對,講義內部至少有十幾處數字對不上。舉一個最顯眼的:2035年的模組,32個HBM7×24 TB/s應為768 TB/s,表裡寫的是1,024 TB/s;總功耗15,360 W用的是HBM8的單棧180 W,若按表中標註的HBM7(160 W/棧)計,應為14,720 W——開頭那個“15,360瓦”,可能多算了640瓦。
破綻二:它兼有專利展示的性質。總表裡有一整行,標著“Additional Features (Patent)”。
破綻三:它有立場(本文判斷)。“HBM為中心、GPU退出資料通路”的敘事,天然契合記憶體廠的戰略訴求。技術預測和產業倡導,要分開讀。
所以我們的讀法是:
把它當成一張“物理可能性地圖”和一份“問題清單”,而不是時間表。
它最有價值的地方,不是猜對了那一年,而是把HBM未來十二年要撞的每一堵牆,都列了出來。
但在對答案之前,得先弄明白一件事:一顆記憶體晶片,憑什麼讓輝達和三家記憶體巨頭都這麼緊張?
二、先補一課:一顆記憶體,憑什麼卡住整顆AI晶片
如果你不是做晶片的,這一節值得花三分鐘。後面所有的帳,都建立在這裡。
廚房越來越大,傳菜口卻沒怎麼變寬
AI晶片有一個越來越尖銳的矛盾:算得越來越快,喂得越來越慢。
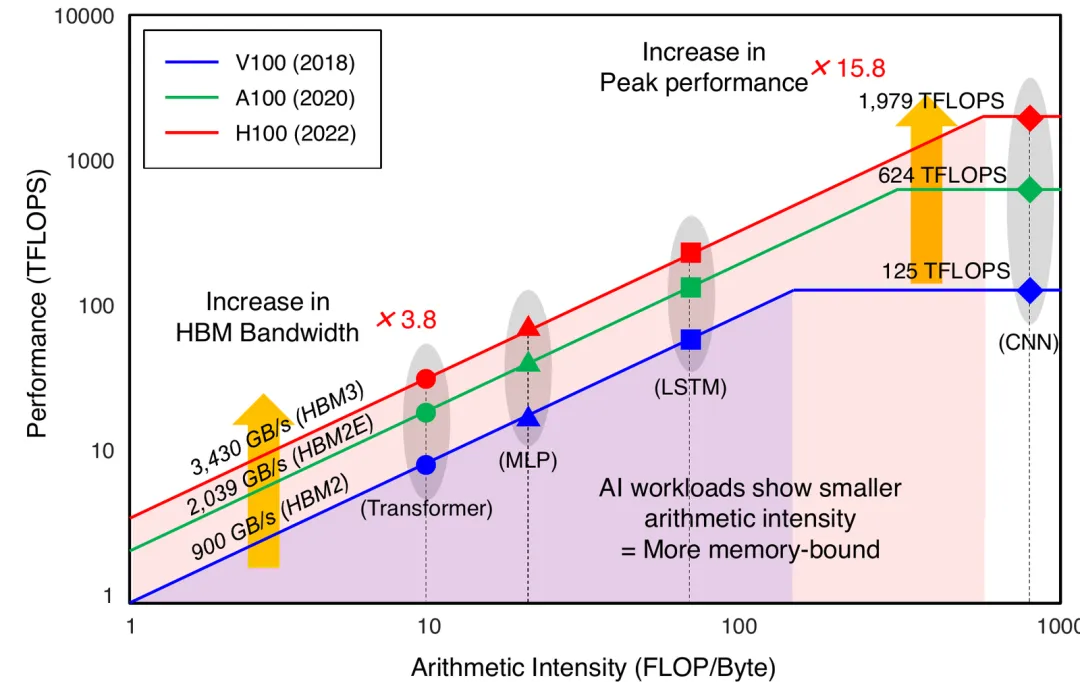
講義用輝達三代GPU的資料說明:從V100到H100,峰值算力漲了15.8倍(A100/H100取稀疏峰值,按稠密口徑約7.9倍),HBM頻寬只漲了3.8倍。美光在2026年Hot Chips上給出了更新的口徑:加速器算力約每兩年漲3倍,HBM頻寬每兩年漲不到2倍——用美光的原話說,“記憶體牆在惡化”。
打個比方:廚房(算力)每兩年擴建三倍,傳菜口(頻寬)只拓寬不到兩倍。廚師越來越多,卻越來越多地站著等菜。
一棟住商樓,樓裡有幾千部電梯
金正浩在講義裡放了三頁比喻(講義p14、p16、p18):一棟住商復合樓、一部電梯、一座仁川機場。這三頁只有標題和一張照片,下面的解讀是我們按上下文補上的。
住商復合樓:樓下幾層是商舖裙樓,樓上是住宅塔樓。HBM最底下那顆邏輯晶片叫base die,就是“商舖層”,負責對外打交道;上面疊著的十幾層DRAM晶片是“住宅層”,負責存資料。
電梯:樓上樓下要靠電梯連通。HBM裡的“電梯”叫TSV(矽通孔)——在每一層晶片上打出幾千個貫穿的孔,灌上銅,讓資料豎著上下。
機場:海量旅客(資料)要同時進出,靠的不是一條快車道,而是很多登機口同時開放。
這棟“樓”最後和GPU並排貼在一塊矽片上(矽中介層),中間鋪著幾千條“車道”。下面這張A100的實物切片,是講義裡少有的封裝實拍照片:
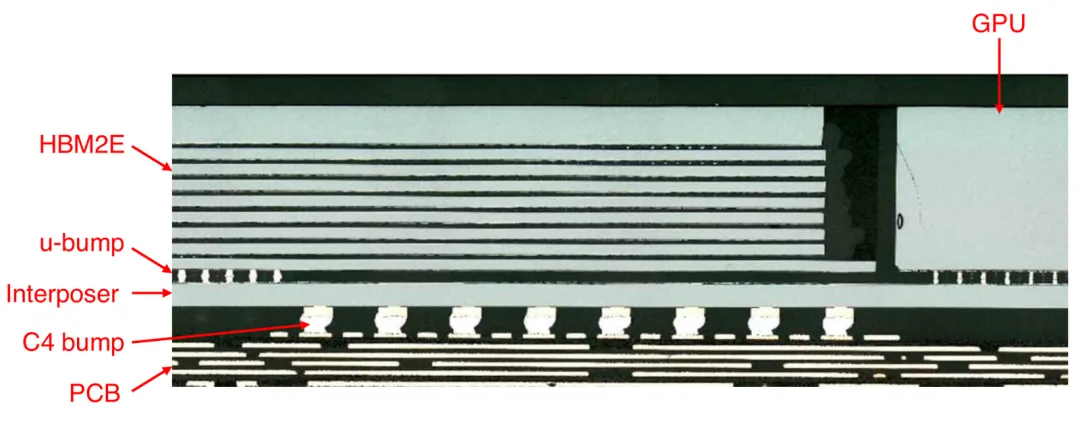
左邊能數出8層DRAM疊在更寬的base die上,通過密密麻麻的微凸點坐在中介層上,與右邊的GPU頂面齊平——這就是台積電的CoWoS封裝,也是今天AI晶片最搶手的產能。
機場的秘密:慢,但是多
更值得看的是HBM的“內部視角”。HBM3對外只有1,024根線、每根7 Gbps;到TSV層變成4,096根×1.75 Gbps;到最裡面的bank group層,變成16,384根×0.4375 Gbps。每一層都是896 GB/s。
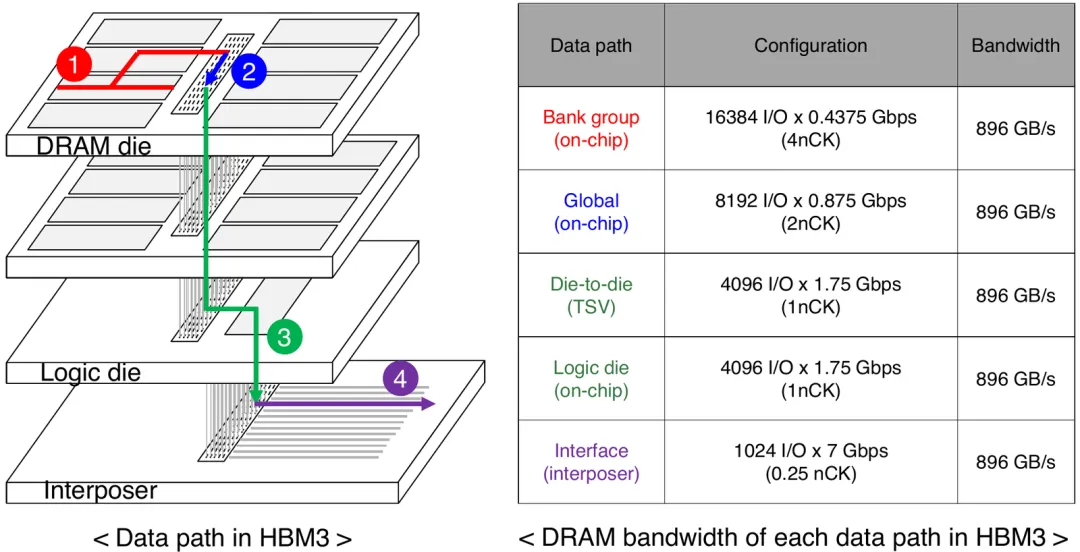
這張圖藏著一個很少被討論的事實:DRAM陣列本身的速度,二十年幾乎沒變。
HBM的快,不是記憶體單元變快了,而是“登機口”開得足夠多。
如果內部速率維持0.4375 Gbps,HBM8的64 TB/s需要約117萬根同時工作的資料線,是HBM3的71倍(本文推算)。
這也解釋了為什麼HBM越來越“費矽”:美光披露,HBM4每顆die有256個bank,是HBM3E的2倍、DDR5的8倍;同樣容量,HBM3E消耗的晶圓面積約為DDR5的3倍,而且逐代惡化。
它也越來越貴。按韓媒2025年11月報導的2026年供貨談判價估算,12層HBM4一顆約560美元(另有報導稱超過600美元),比HBM3E貴約一半;一顆輝達Rubin身上裝8顆,光記憶體就是約4,500美元(本文估算)。
HBM是整顆AI晶片裡最貴、最難造、也最卡脖子的部件之一。這就是為什麼一份HBM路線圖,值得逐頁去讀。
課補完了,現在翻開答卷。先看最直觀的一題:速度。
三、對答案:速度猜慢了一代半,架構猜快了一到兩代
下面這張表,是本文的核心之一。左邊是KAIST在2025年6月寫下的預言,右邊是2026年9月的現實。
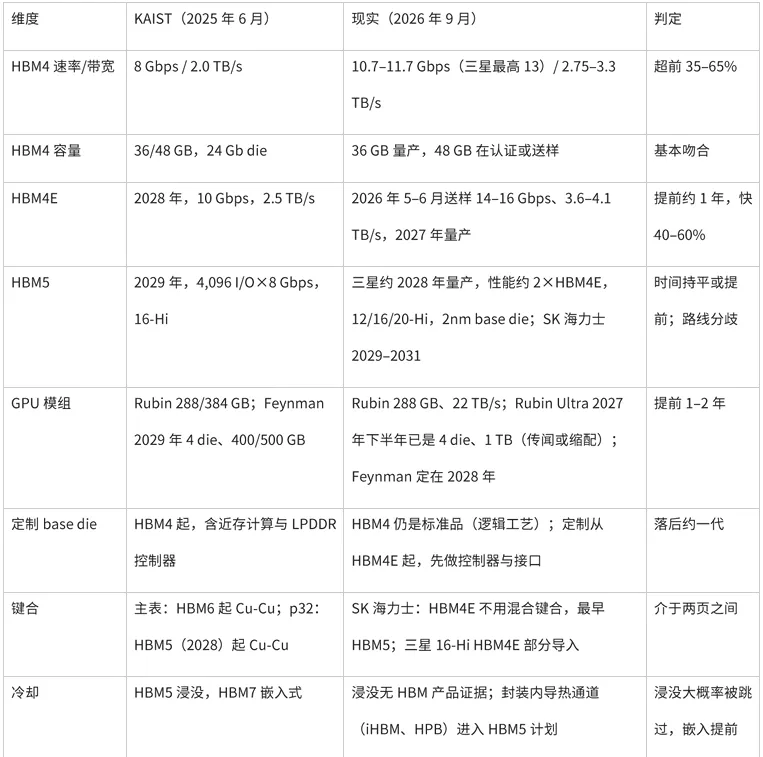
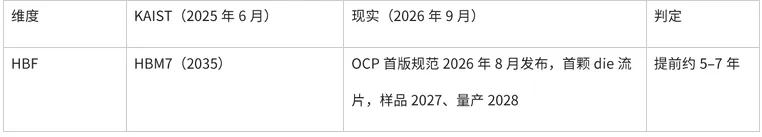
把這張表壓成一句話:
凡是客戶掏錢拉動的,產業都比預言快;凡是要改寫範式的,預言都比產業急。
具體說,速率、模組容量、HBF進度這些由客戶和商業節奏驅動的維度,產業都比講義快;近存計算的程式設計模型、HBM為中心的計算、堆疊內流道這些需要系統級範式變化的維度,講義都比產業激進。電氣規格提前約一代半,架構創新推遲一到兩代。
速度為什麼跑得這麼快?因為有一個足夠強勢的買家在拉。2025年三季度,輝達把Rubin的HBM4引腳速率要求上調到11 Gbps以上;據TrendForce,三家均需調整設計(美光否認重新設計),量產推遲約一個季度。Rubin的頻寬口徑,從13 TB/s一路改到了22 TB/s。
有意思的是,AMD走了另一條路:MI455X用12個HBM4堆疊拿到432 GB和23.3 TB/s,折合每棧約1.94 TB/s、約7.6 Gbps(本文推算)——用棧數換頻寬,不追引腳速率。
同一代HBM4,兩種哲學。這恰好對應了頻寬僅有的兩個旋鈕,後面還會講到。
路線圖是寫在紙上的預言;金正浩在採訪裡,還說過不少更大膽的話。
四、給“HBM之父”的7個驚人判斷打分
路線圖之外,金正浩這15個月裡還說過不少驚人的判斷,在韓國和國內都傳播很廣。既然在對答案,不妨一起打個分。
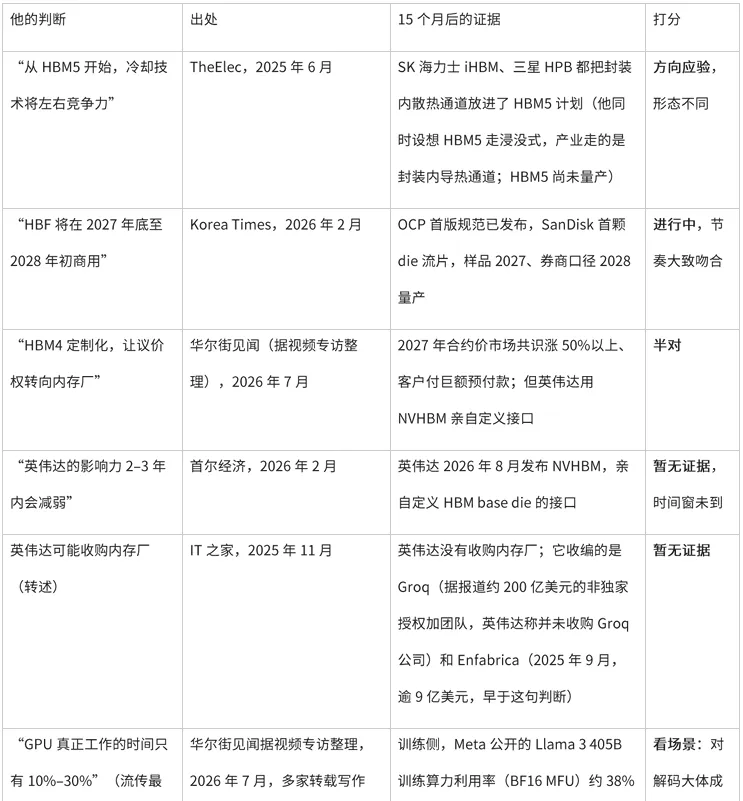
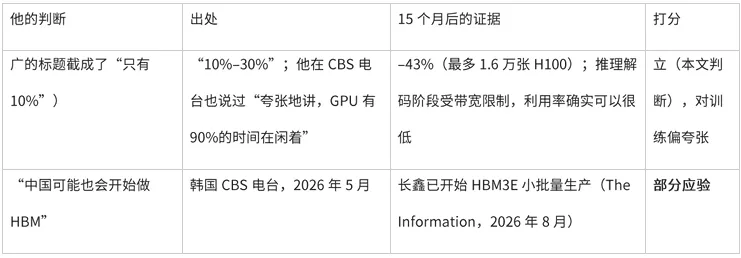
七個判斷打下來:方向感一流,技術節奏大致踩准,但對“記憶體壓過輝達”的判斷偏樂觀。這和他路線圖裡“HBM為中心”的立場一脈相承。
但真正值得拿出來說的,不是那一句說得準不準——
而是那張路線圖裡,有一個數字,低於DRAM陣列訪問本身的能耗。
第二部分
五筆物理帳
接下來五節,是五筆物理帳:電費、線、高度、熱、電流。每一筆對應一堵牆。它們是全文最硬的部分,但每節只講一件事,結論都加粗放在節末。讀累了,可以只看加粗句,再從第十節接著讀。
五、第一筆帳·電費:一張比發動機空轉還省油的油耗表
如果把這份路線圖當成一份財務預算,最可疑的一行是電費。
兩個旋鈕:車道數×車速
先交代一個背景:想讓HBM搬資料更快,只有兩個旋鈕可擰。
把HBM和GPU之間的連接想像成一條高速公路:頻寬=車道數×車速。車道數就是I/O數,車速就是每根線的速率。
KAIST的“漲32倍”,是車道擴8倍、車速提4倍拼出來的,而且兩個旋鈕輪流擰:HBM5隻加車道不提速(4,096 I/O、8 Gbps),HBM6隻提速不加車道(16 Gbps),到HBM7和HBM8再一起漲。
產業偏偏反著來:HBM4E沒加車道,就在2,048 I/O上把車速拉到16 Gbps;三星對HBM5的口徑是“2倍HBM4E”。
兩條路都不便宜,而且越往後越貴,貴得不成比例:
- 加車道:GPU和HBM兩頭都要多修“匝道”(PHY電路面積),中間的矽中介層還要多鋪幾層路;
- 提車速:訊號越快越容易“抖”,得花真金白銀去壓住抖動。講義裡一個學生報告算過:把HBM5的電源噪聲抖動目標從6 ps收緊到5 ps,需要的去耦電容從2個增加到8個(講義p199,讀圖估計)。要求只收緊了一點,電容卻翻了兩番。
那個旋鈕更便宜,決定了每一代HBM長什麼樣。但不管擰那個,都繞不開同一張帳單:電費。
12年,油耗降到1/13
把講義總表裡的兩行數字放在一起,會看到一把張得很開的剪刀:從HBM4到HBM8,單棧頻寬要漲32倍,單棧功耗卻只許漲2.4倍(75 W→180 W)。
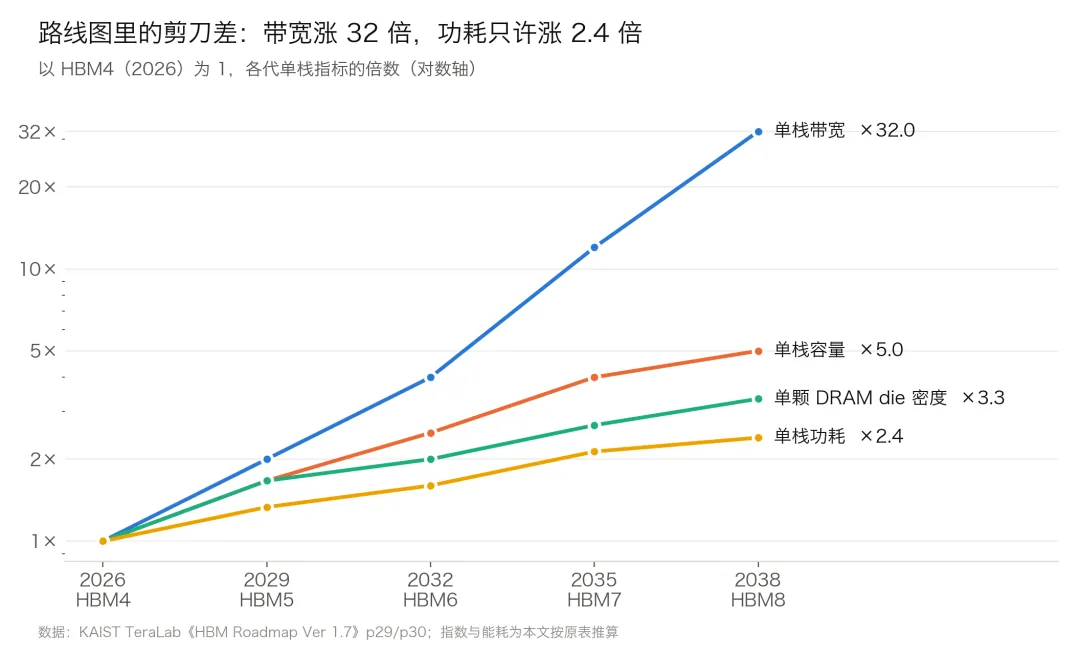
搬的資料多了32倍,用的電只多2.4倍。唯一的出路,是讓搬每一個位元的電費大幅下降。這個指標叫“每位元能耗”,單位是pJ/bit(皮焦/位元)。你可以把它理解成晶片的“百公里油耗”:搬同樣多的資料,要花多少電。
把單棧功耗除以單棧頻寬,這張路線圖隱含的“油耗”就算出來了:
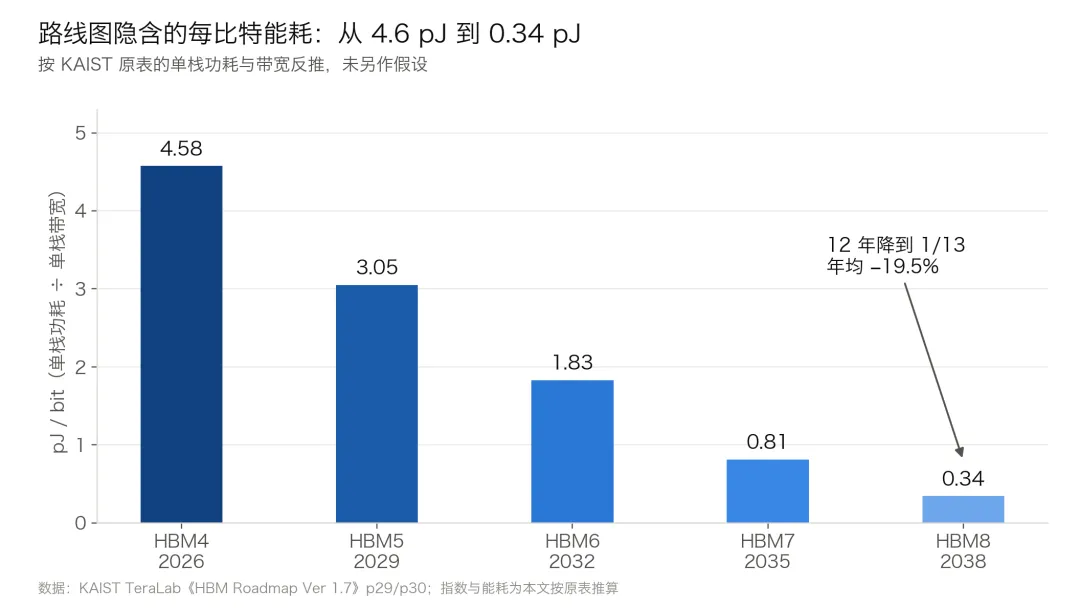
從4.6 pJ/bit到0.34 pJ/bit,12年降到約1/13,年均下降約20%(按p29的75 W計;若取p27的43 W,也需降約7.7倍)。
換成汽車,就是要求一輛車在12年裡,把油耗降到原來的1/13。
問題是,這輛車過去幾乎沒怎麼省油。按講義自己p27的業界表推算,HBM2E、HBM3、HBM3E三代的每位元能耗分別約5.2、3.8、4.0 pJ/bit。三代下來,幾乎原地踏步。
比發動機空轉還省油?
0.34 pJ/bit到底有多難?得先看搬一個位元的電,都花在了那。
它大致分兩段:一段是把資料從記憶體單元裡“取出來”,一段是沿著線“送出去”。HBM的聰明之處在第二段:資料靠極短的TSV豎著走,“送出去”的電費被壓了下來。可第一段是DRAM陣列自己的事。打開一整行(行啟動)、放大微弱的訊號(感放)、在晶片內部搬運,一樣都省不掉。
講義p302引用的資料是:DRAM晶片主動讀取約5 pJ/bit(DDR4口徑)。其中陣列本身那一段,按公開文獻的一般估計仍在1 pJ/bit量級(本文估計)。
換句話說——
0.34 pJ/bit,已經低於今天DRAM陣列訪問本身的能耗。
好比要求一輛車的百公里油耗,比它發動機空轉的油耗還低。
反過來算,就知道180 W這個數有多“緊”:
- 如果HBM8能做到1 pJ/bit,64 TB/s要約510 W一棧;
- 如果維持HBM4的能效,要約2.4 kW一棧。
路線圖裡的180 W,更像散熱封頂,而不是物理推演。
現實也在印證:油耗在降,總油量卻漲得更快。三星在ECTC 2026的論文中估計,HBM4E的功耗比HBM3E高86%,是HBM2的5.6倍;同期單棧頻寬漲了約2.5–3.4倍,每位元能耗仍降了三到四成。這是進步,但年均降幅明顯低於路線圖要求的約20%。三星在Hot Chips 2026上還說,base die的功率密度將從HBM4E的0.5 W/mm²升到HBM5的2 W/mm²以上。
所以,這筆帳的含義遠比“功耗會更高”深刻。它只給HBM留了兩條路:
要麼頻寬跑不滿,要麼資料必須少走路。
回頭再看講義的架構路線,從“近存計算”一路走到“HBM為中心的計算”,在很大程度上可以看作它自己的功耗表逼出來的(本文判斷)。不讓計算靠近資料,這張表合不攏。
電費帳算不平,工程師的第一反應是:那就多修幾條路,讓資料跑得更快。可路,也快修不下了。
六、第二筆帳·線:一根頭髮絲的寬度裡,要引出一百多根線
問題出在“門”太窄。
HBM和GPU之間所有的資料,都要從HBM堆疊朝向GPU的那一條邊“出門”。這條邊只有約11 mm長,門卻一代比一代擠:I/O數每代翻倍。講義p31畫出了工程師為此做的努力:微凸點(晶片間的微型焊點)間距從55 µm縮到40 µm,中介層上的“路”從2層加到6–8層,線寬壓到2 µm以下,還要在訊號線之間夾地線當“隔離帶”(“訊號-地-訊號”交錯遮蔽)。
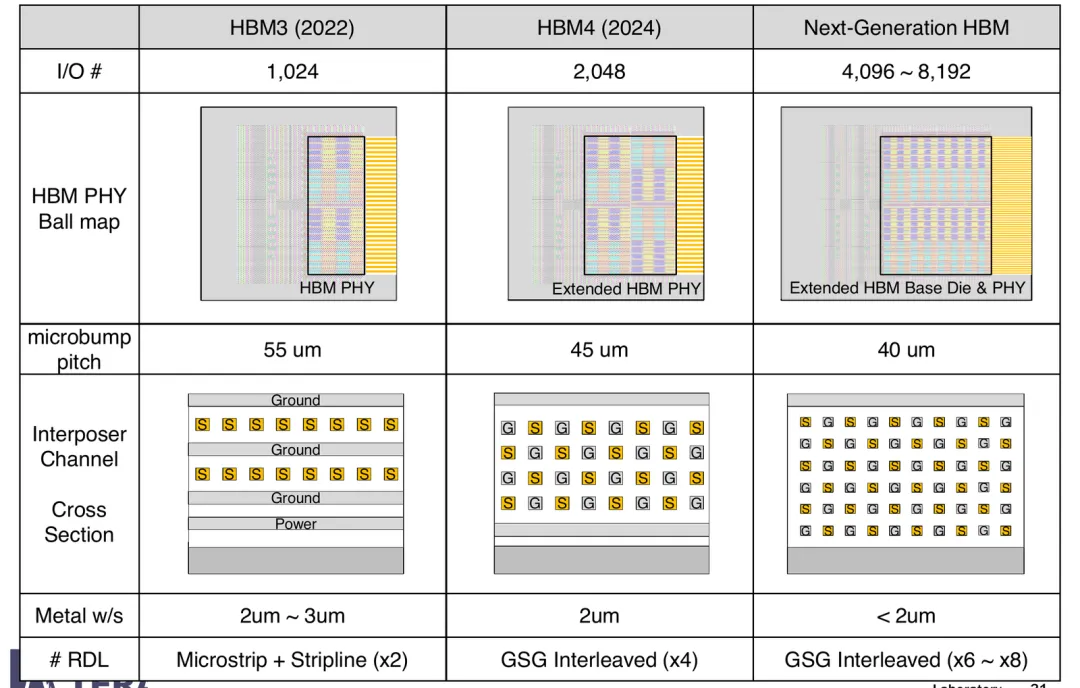
我們把這個壓力換算成一個直觀的數:這條邊上,每毫米要擠出多少根線?
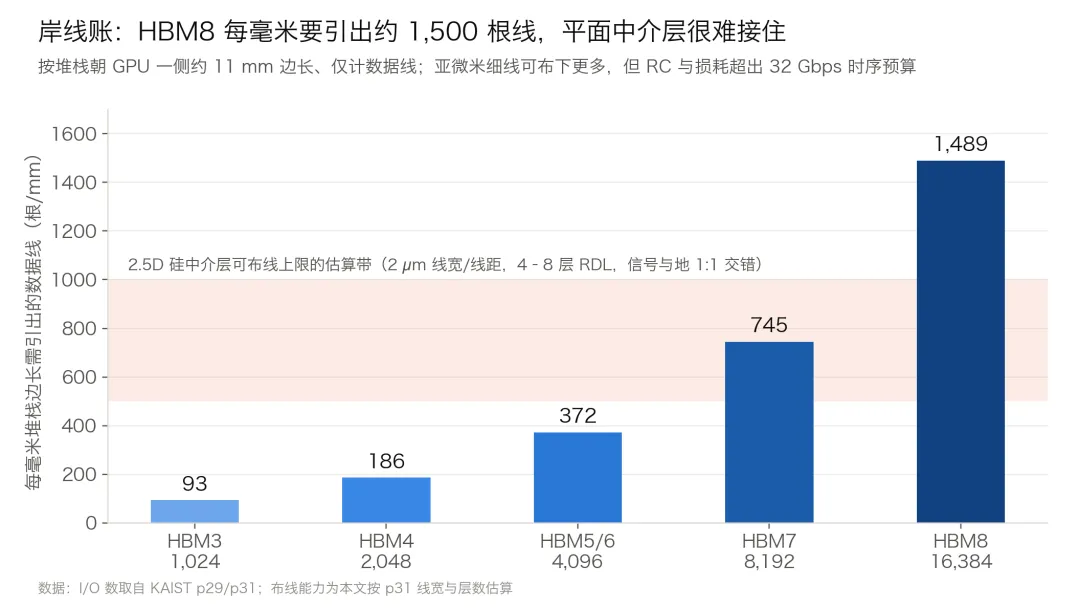
HBM4約186根,HBM8約1,489根。相當於要在一根頭髮絲(約70 µm)的寬度裡,分幾層引出一百多根線。
平面矽中介層能擠多少?按2 µm線寬線距、4–8層布線、訊號與地1:1交錯估算,大約500–1,000根/mm。HBM8要的,已經超出這個能力。
那把線做細呢?可以。改用亞微米細線(講義p216里矽中介層線寬為0.4 µm),線數能布下,但電阻和損耗隨之飆升,於是撞上第二道檻。
這道檻叫RC,可以理解成“水管越細,灌滿越慢”。
線越細,電阻越大。訊號每翻轉一次,都要把線上的電“灌滿”或“放空”,電阻越大,灌得越慢。估算一下:1.2 µm寬、5 mm長的銅線,電阻約70 Ω,這個“灌滿時間”(RC時間常數)已經和32 Gbps下每個位元的停留時間(單位間隔,約31 ps)同一量級(本文估算)。
也就是說,上一個位元還沒站穩,下一個位元就來了。
補救的辦法是在接收端加“均衡器”,把被拖壞的訊號修回來。講義在HBM6一代,就把“混合均衡器”列進了AI設計代理的任務。可均衡本身又要吃電,繞回了上一節那張電費帳。
結論:幾何與RC一起,把2.5D中介層的天花板定在HBM7前後。HBM8把GPU疊到HBM上方,是被逼出來的。
平鋪走不通,就只能往上疊。於是講義給出了這樣一幅圖:
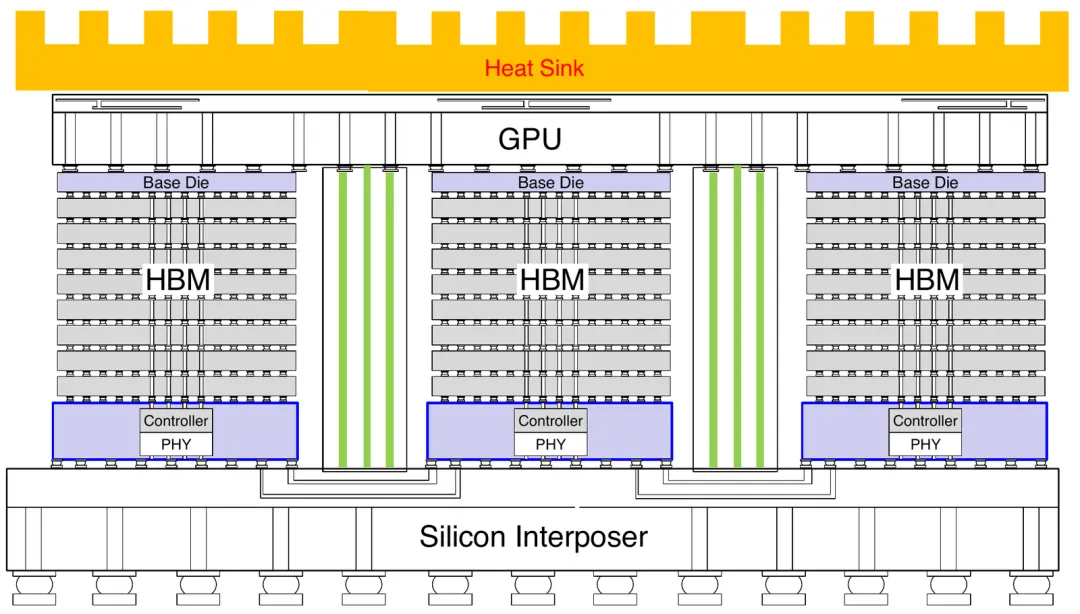
產業已經在往這個方向走,只是比講義快:
- 三星zHBM:用晶圓鍵合把HBM直接疊在處理器上,Hot Chips口徑下I/O功耗降約70%、頻寬約2.3倍,2029年以後推出;
- 輝達Feynman:2028年首次採用3D die堆疊加定製HBM(3D堆疊是否涉及記憶體尚未披露);
- SK海力士:封裝負責人稱,從HBM5起研究把DRAM垂直疊在GPU上。
線的問題,靠把GPU往上疊來解。而HBM自己往上加層,也有一道牆。
七、第三筆帳·高度:8張A4紙的厚度,要塞進20層晶片
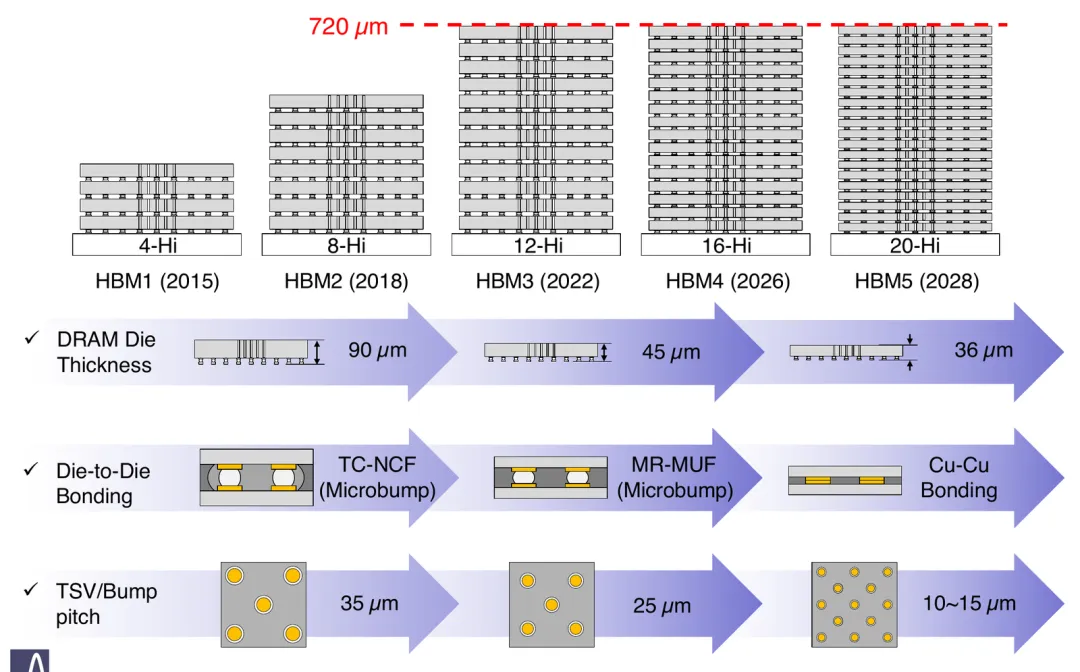
HBM不能無限往上蓋。它要和旁邊的GPU頂面齊平,才能共用一塊散熱器,所以JEDEC給整棧規定了高度上限:原來是720 µm,HBM4放寬到775 µm——大約8張A4紙疊起來的厚度。
要在這個高度裡塞進16層、20層晶片,每一層就得磨得比頭髮絲還薄。
講義這張圖有一個算術破綻:16×45 µm=720 µm,20×36 µm=720 µm——正好頂滿,沒給base die和鍵合層留一微米餘量。
現實比講義松:
- JEDEC已放寬高度:SK海力士在Hot Chips 2026上說,775 µm恰好等於300 mm邏輯晶圓的厚度;16-Hi的核心die進一步減薄(媒體轉述約50 µm,另有約30 µm的說法,口徑待核),die間距比12-Hi縮小一半;20-Hi需要825–900 µm。
- 高度繼續鬆動:據韓媒報導,JEDEC在討論HBM4E放寬到約900 µm、HBM5最高1,000 µm(尚未官宣)。
高度一放寬,混合鍵合就推遲。
混合鍵合(Cu-Cu直連)是業界公認的下一代堆疊技術:取消晶片之間的焊球,銅對銅直接“長”在一起。同一高度下核心die可以厚24%,熱阻比現在的MR-MUF工藝低約35%。但它貴、良率低。只要JEDEC肯放寬高度,廠商就寧可繼續用老工藝。
於是,SK海力士明確HBM4E繼續用MR-MUF,混合鍵合最早用於HBM5的20-Hi以上;三星更激進,計畫在16-Hi HBM4E上與TC鍵合併行匯入。有意思的是,現實節奏恰好落在講義自己前後矛盾的兩頁之間:講義主表寫HBM6才上Cu-Cu,p32卻寫HBM5(2028年)就上。
這一推遲,直接改寫了兩家裝置商的命運:
- TC鍵合機龍頭韓美半導體:2025年前三季度拿走71%的HBM TC鍵合機營收,2026年二季度營業利益率高達52%;
- 混合鍵合龍頭BESI:混合鍵合客戶增至21家,但“前三大HBM廠一家領先、兩家測試中”;三星在Pyeongtaek規劃約50台D2W混合鍵合機的量產線,全面量產要到2029–2030年。
規矩一松,新技術就推遲;推遲一年,就有人多賺一年。
樓蓋得越高、越薄,下一個問題就越致命:熱。
八、第四筆帳·熱:溫度就是時鐘
HBM有個麻煩的鄰居:GPU。
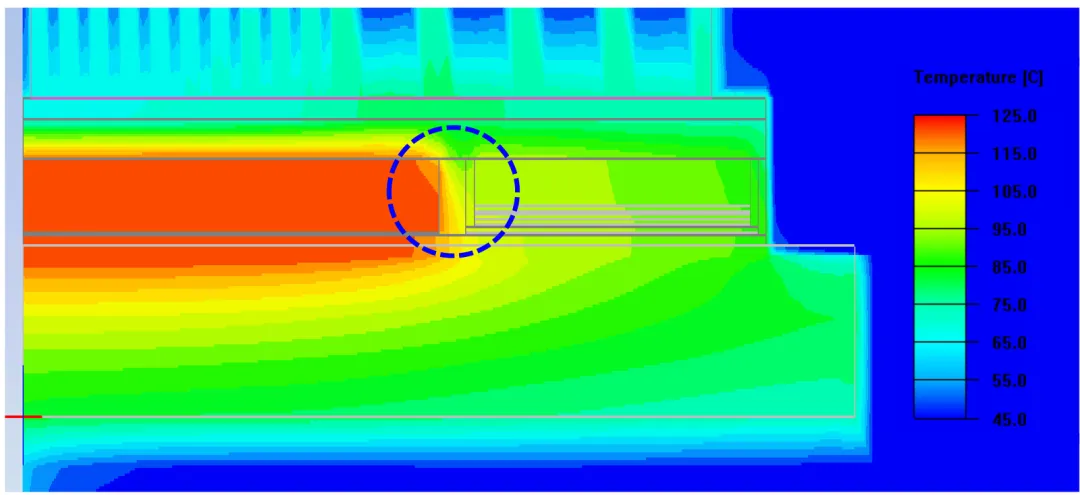
從圖13能看到,GPU的熱量順著中介層和模塑料,一路“灌”進隔壁的HBM。而DRAM怕熱:超過85 °C就要加倍刷新(刷新,就是定期給記憶體單元“補一次電”),既佔頻寬,又加功耗。
所以,GPU每多燒一百瓦,都在蠶食HBM的熱余量。這是系統級成本模型裡常被忽略的一項。
HBM自己也越來越燙。按講義數字,HBM8單棧180 W;按HBM4約12.8×11 mm的佔地(SK海力士Hot Chips口徑)計,平均熱流約128 W/cm²,單位面積的發熱約為一顆B200級GPU的兩倍。而且這些熱不是從一整塊矽片上散掉,而是要一層層穿過20多層鍵合介面,就像隔著二十多層棉被往外透氣。
模組層面,就是開頭那個數字:
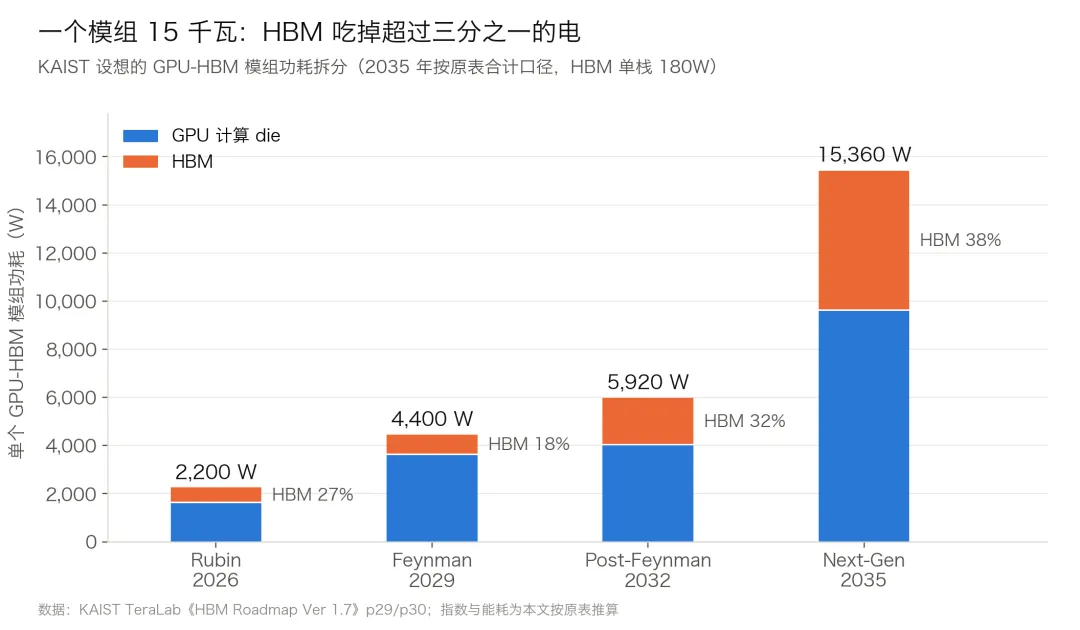
講義的冷卻路線是:冷板(HBM4)→浸沒(HBM5/6)→嵌入式(HBM7/8)。現實做了兩處修正:
- 浸沒大機率被跳過。產業主流仍是單相冷板,TrendForce估計2026年AI晶片液冷滲透率約53%;浸沒只能改善封裝外表面,解決不了堆疊內部層間的導熱瓶頸。
- “嵌入式”提前到了HBM5,但形態不同。SK海力士的iHBM在D2D PHY區放入導熱矽元件,熱阻降30%;三星的HPB已在HBM4E上驗證;台積電在ECTC 2026上演示了直接矽冷卻,測試載具散熱達5.3 kW;微軟在GH200上驗證了晶片內微流道,結到入口熱阻降低51%–60%。
這些都是“封裝內導熱通道”,還不是講義設想的那種更激進的方案——讓冷卻液直接穿過DRAM堆疊:
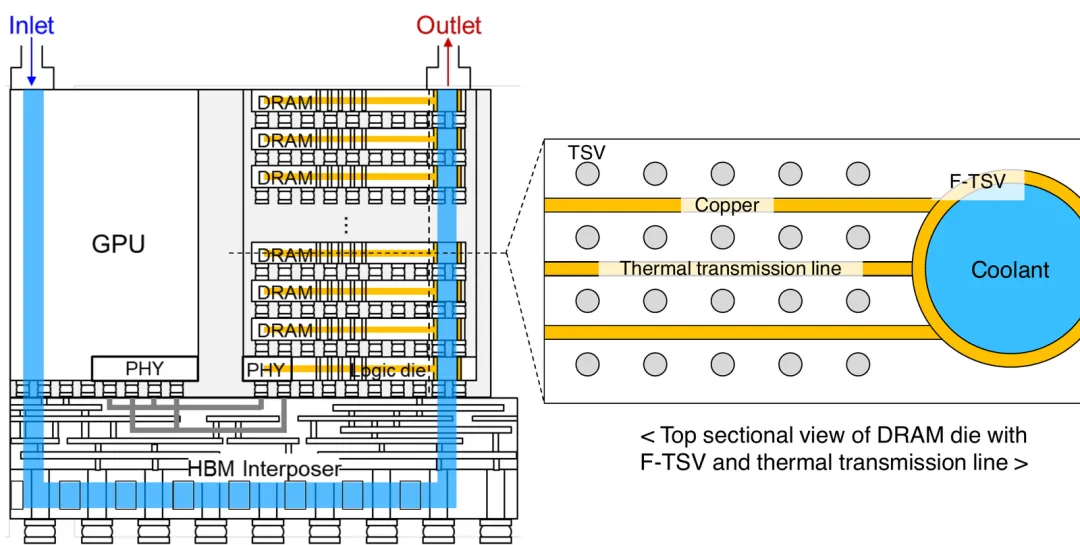
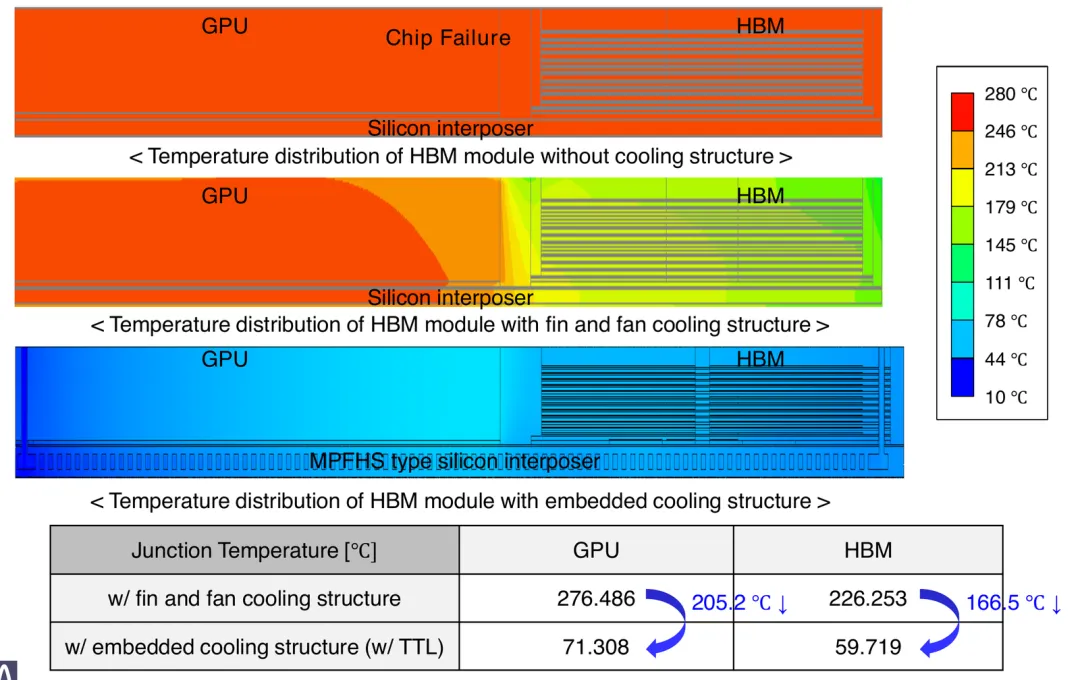
這組數字要打折看:對照組是風冷,不是今天GB200、GB300標配的冷板,降幅被放大了。
但同一份報告裡,藏著一個比“降了多少度”更有價值的發現。
晶片裡有一個“節拍器”,叫時鐘。它像樂隊指揮,要讓成千上萬根線上的資料踩在同一個拍子上。拍子傳到各處的時間差,叫“時鐘偏斜”:偏斜越大,留給資料的余量越少。
報告發現,鋪了銅“熱傳輸線”之後,3D時鐘樹的偏斜從19.49 ps降到15.75 ps。
少掉的3.74 ps聽上去微不足道。但在高速訊號的世界裡,它相當於24 Gbps下約9%的單位間隔(一個位元的“停留時間”),32 Gbps下約12%(本文推算)。
也就是說,散熱做好了,訊號也跟著變准了。
從HBM7起,溫度均勻性本身就是訊號完整性指標——溫度就是時鐘。
金正浩那句話,說得很準確:“HBM本質上是與熱和電能的戰鬥。”
熱,只是這棟樓一半的麻煩。另一半是:怎麼把兩萬安培的電流送進去。
九、第五筆帳·電流:兩萬安培,和冷卻液搶同一條路
講義下半場有11個AI設計代理報告,沒有一個討論DRAM記憶體單元:其中8個直接做供電完整性(IR壓降、供電網路阻抗、去耦、電源噪聲抖動),GAN眼圖估計的對象也是電源噪聲,其餘兩篇做互連訊號與熱-訊號佈局。
一個研究TSV與中介層二十多年的實驗室,把火力幾乎全押在“供電”上。這本身就是訊號:HBM接下來最難的,可能不是“存”,而是“供”。
為什麼?想像給一棟20層的樓供水。
水從地下室(base die)往上送,靠貫穿樓板的立管(TSV)。樓越高、立管越稀,頂樓的水壓就掉得越厲害。晶片裡也一樣:電流沿途穿過電阻,電壓被一路“吃掉”,這叫IR壓降。到了頂層,電壓不夠,晶片就不穩。
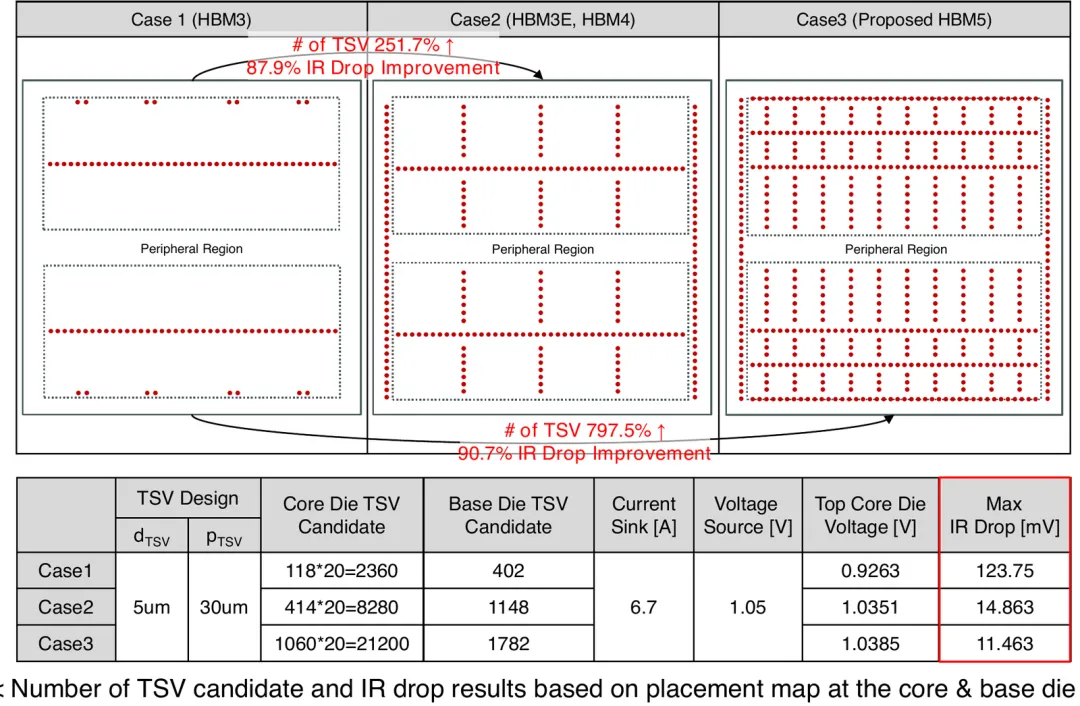
講義算出來的帳是這樣的:
- 立管要多裝:若把HBM3式的稀疏TSV直接套在20層堆疊上,頂層壓降佔電源電壓的11.8%,遠超常見的±5%容限;要壓到1.1%,每層TSV要從118個增加到1,060個,整棧約2.1萬個;
- 進水口要多開:base die供電點從1個增加到38個,壓降從45.0 mV降到11.4 mV;
- 管網要分區:定製base die塞進記憶體控製器和計算單元後,電源域增加到6個,好比一棟樓同時接6套互不相通的水管,在多層金屬裡互相交疊。
產業側也有印證:三星HBM4的TSV數量是上一代的4倍(ISSCC 2026),HBM4E需要的中介層布線層是HBM3E的2倍(ECTC 2026)。
這還只是HBM自己。把視野拉到整個模組:一顆1.2 kW、0.75 V的GPU要吃約1,600 A,一個15 kW模組要吃約2萬A。電壓不到1伏,功率卻以千瓦計,電流就只能以千安、萬安計。
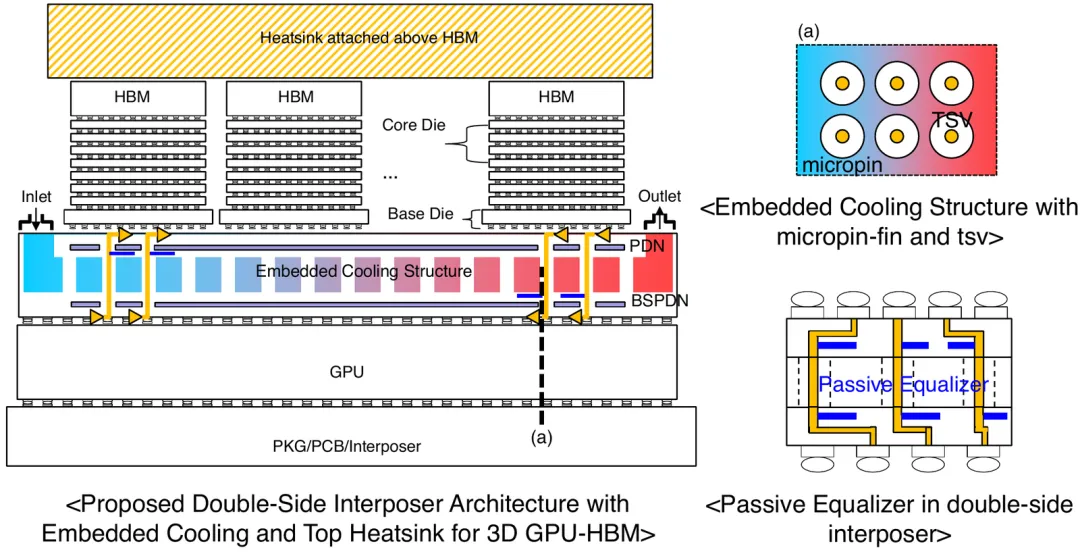
這麼大的電流從那兒進來?講義對這種千安級的系統供電討論很少,只有幾處回應:HBM之間嵌入矽柱給GPU送電(p46)、有源中介層內嵌穩壓器(p73)、背面供電(p74、p99)。
到了HBM8的雙面中介層方案,每根散熱微柱裡都要嵌一根TSV。同一根柱子,一邊幫冷卻液散熱,一邊還要走電和訊號:
冷卻液、電流和訊號,在爭同一條垂直通道。
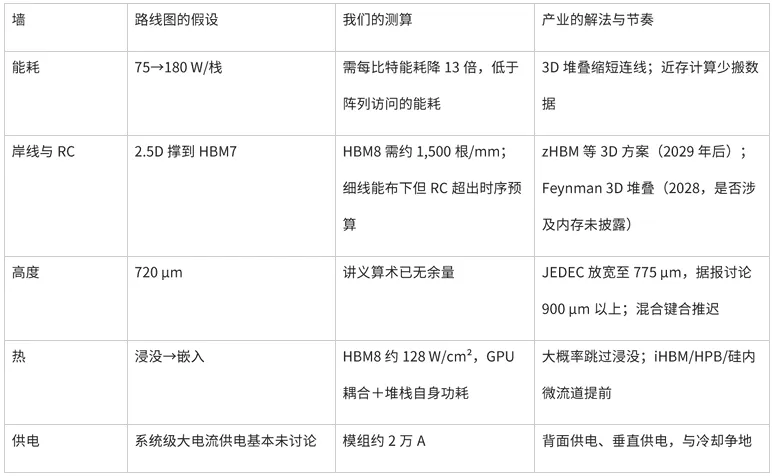
五筆物理帳,一張表
物理帳算完了。接下來的問題是:這些牆,由誰來拆?拆牆的錢,又歸誰賺?
答案藏在HBM最底下,那顆最不起眼的晶片裡。
第三部分
誰來拆牆
十、權力的遊戲:誰設計“地基晶片”,誰就握住記憶體的憲法
還記得第二節那棟“住商樓”嗎?樓下那層“商舖”,也就是HBM最底下那顆base die,正在經歷三個時代:
- 自家開小賣部(HBM3E以前):由DRAM廠用自家記憶體工藝生產,只做最基本的三件事:對外介面(PHY)、測試和供電;
- 請專業施工隊(HBM4起):換成邏輯工藝。SK海力士交給台積電12nm,三星用自家4nm,美光自研CMOS;
- 按租戶量身定製(HBM4E起):走向客戶定製。台積電C-HBM4E用N3P,電壓從0.8 V降到0.75 V,能效約2倍;三星把定製版base die轉到自家2nm;美光的標準版和定製版base die全部交給台積電。
KAIST的想像走得更遠:到HBM8,這間“商舖”要擴成一座小商場。NVLink、CXL、InfiniBand介面,指令譯碼與執行單元,L2快取,8個GPU計算單元,還有原本屬於GPU的記憶體控製器,統統搬進來。
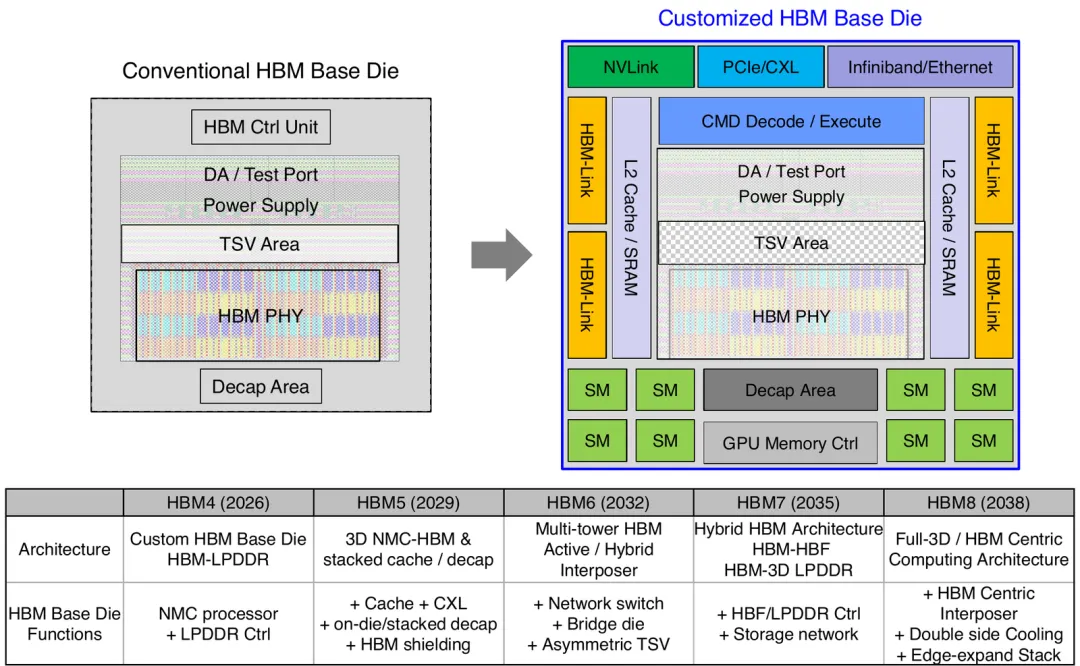
這張圖最顛覆的一筆,不在於塞了多少功能,而在於一個看似很技術的問題:記憶體控製器,放在誰的晶片上?
記憶體控製器可以理解為記憶體的“調度中心”:資料什麼時候讀、什麼時候寫、什麼時候刷新、出錯了怎麼糾,都由它說了算。
- 調度中心留在GPU裡:HBM就是標準件,像貨架上的通用商品。調度、刷新、糾錯和容量擴展的定義權,都在GPU廠手裡;
- 調度中心搬進base die:HBM就變成“帶控製器的記憶體子系統”。GPU不再逐條下達DRAM命令,而是像下訂單一樣,發出一筆筆“事務”或“分組”。
這個念頭並不新。美光的HMC(混合立方記憶體)就是邏輯base die加分組介面,最終失敗。專有協議、分組延遲和生態缺失都是原因,而缺少一個足夠強的買家為專有介面買單,是關鍵一環。
上一次,缺的是買家。
這一次,買家來了——正是第三節裡那個足夠強勢的買家。
2026年8月26日,輝達發佈NVHBM,把記憶體控製器從GPU移進HBM的base die。相對標準HBM4E,它換來三樣東西:
- 頻寬最多提升30%;
- HBM功耗降低15%;
- GPU計算die最多多出25%的面積,同樣大的晶片可以塞進更多計算。
而且輝達沒打算獨享:NVHBM通過NVLink Fusion對合作方開放,AWS(Annapurna Labs)是首個合作方,從Trainium4開始。
這並非孤例。更早,Marvell在2024年底提出的custom HBM口徑是:計算面積多出25%,介面功耗降低70%。三星在Hot Chips 2026上的說法最直白:base die與主機之間的物理介面,已是base die面積的最大佔用者。
三家的說法放在一起,結論就清楚了:定製base die的第一個商業價值,是省面積、省功耗,而不是講義設想的“加功能”。把計算單元搬進base die,要等到三星路線圖的第二階段。
先省錢,再加戲。
三國殺:定價權、定義權與製造權
金正浩的判斷是:HBM4定製化,讓議價權轉向記憶體廠。證據只對了一半:
- 支援的一面:短缺、長約、客戶預付款、三星設定的最低價格底線;
- 反對的一面:輝達在2025年把HBM4速率要求上調到11 Gbps以上,三家均需調整;2026年又用NVHBM親自訂base die介面。
我們的判斷是三方共治:
- 定價權在記憶體廠,因為短缺;
- 定義權在GPU廠,因為base die;
- 製造權主要在台積電,因為base die代工和CoWoS大多在它手裡(三星自有代工與封裝除外)。
誰拿到base die的設計權,誰就握住下一代記憶體的“憲法”。
定義權之爭的背後,其實是一個更樸素的問題:既然搬資料這麼貴,能不能乾脆不搬?
十一、近存計算:紙面4倍,模擬只剩14%
既然搬資料太費電,最直接的想法就是:別搬了,把計算搬到資料旁邊去。這就是“近存計算”。
講義HBM5一代的核心提案,是在每個HBM堆疊頂上疊一顆含10個計算單元的近存計算die:
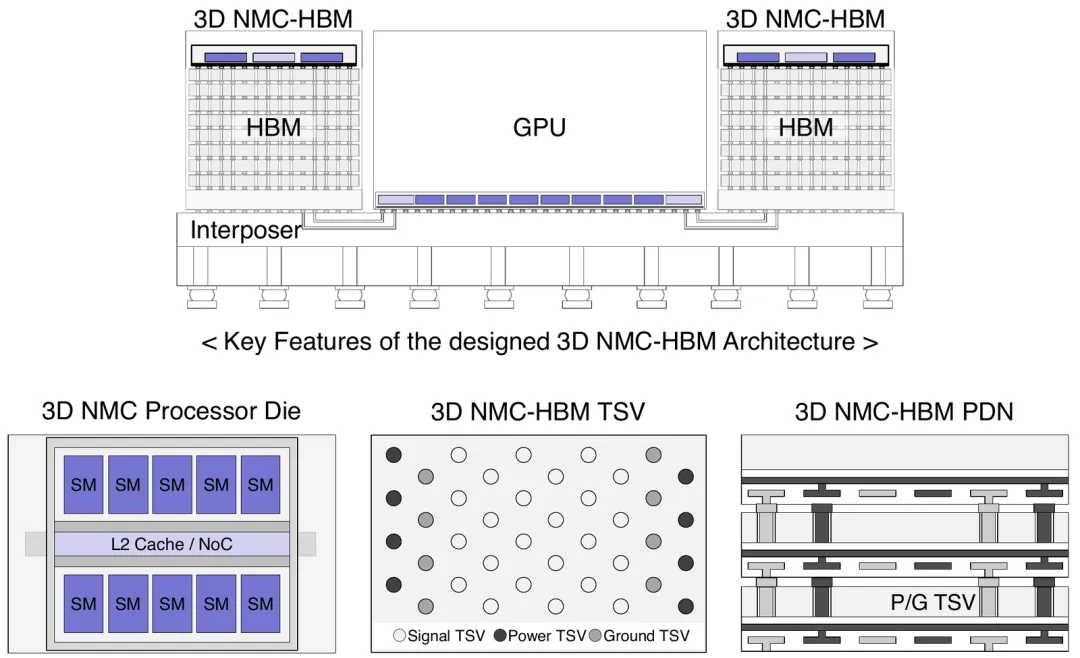
roofline給出的紙面收益很誘人:頻寬受限的矩陣運算,提速約4倍。
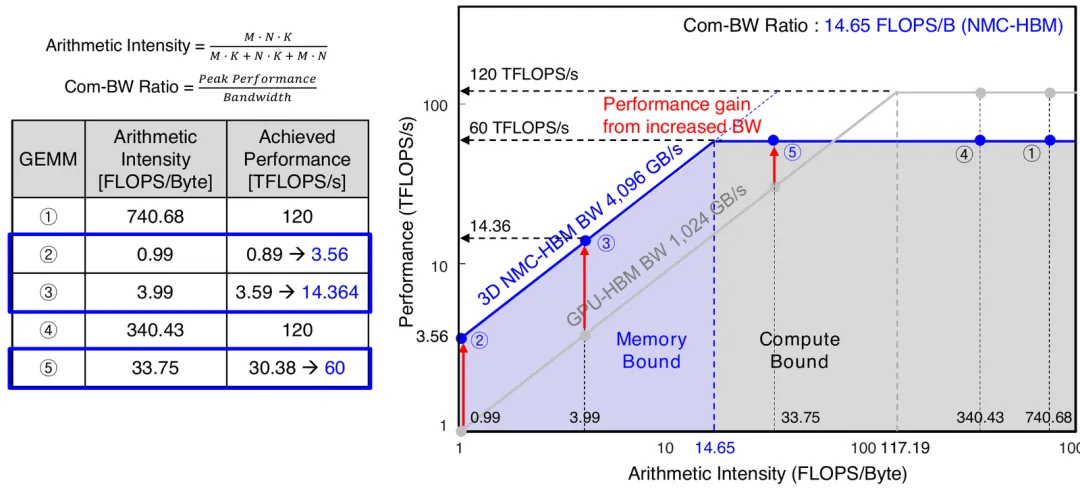
但同一個報告,用GPU周期級模擬器Accel-Sim跑出來的結果是:性能只提升7.8%–13.9%。
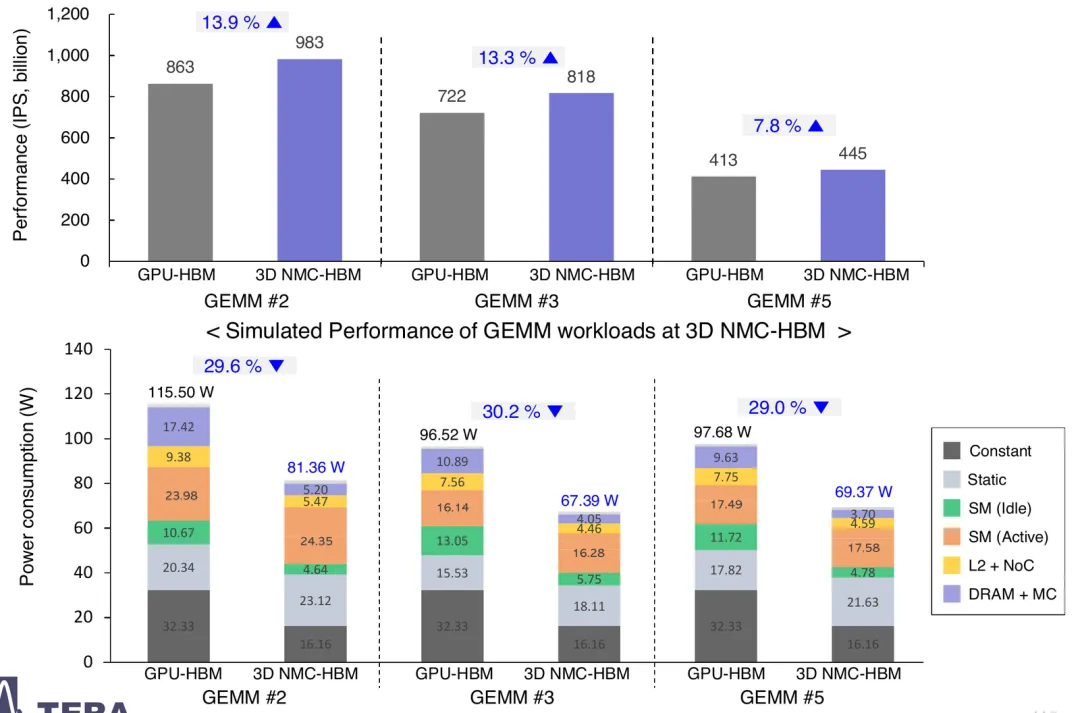
從4倍到14%,報告沒有解釋這個數量級的落差。
我們的推斷是並發度不夠:每個堆疊只有10個計算單元,要吃滿1 TB/s,每個單元的在途訪存請求要比V100多約9倍,GPU計算單元的線程和缺失佇列資源撐不住。就像把高速路修寬了4倍,出口卻只有10個收費窗口——有了頻寬,也喂不滿。
這說明近存計算不能照搬GPU計算單元,而要按bank配大量細粒度引擎,這正是三星HBM-PIM、SK海力士AiM走的路。
它真正的賣點是能效,不是性能:資料路徑縮短約5倍,DRAM加控製器的功耗降60%–70%。產業現實也印證了這一點:三星HBM-PIM從2021年發佈至今沒有量產,而LPDDR5X-PIM已整合進三星的AI PC晶片GAIA,最早2027年量產。
存內計算先落地在LPDDR,而不是HBM。
近存計算是讓計算靠近資料。講義還有一個更大膽的想法:讓HBM之間自己說話,繞開GPU。
十二、HBM不想再當配角:從GPU的掛件到網路的節點
講義HBM6一代的五個架構報告,都在搶岸線和封裝面積;其中交叉開關與“HBM為中心網路”兩篇,直接把HBM從“掛在GPU邊上的外設”變成“網路裡的節點”。挑三個最有代表性的。
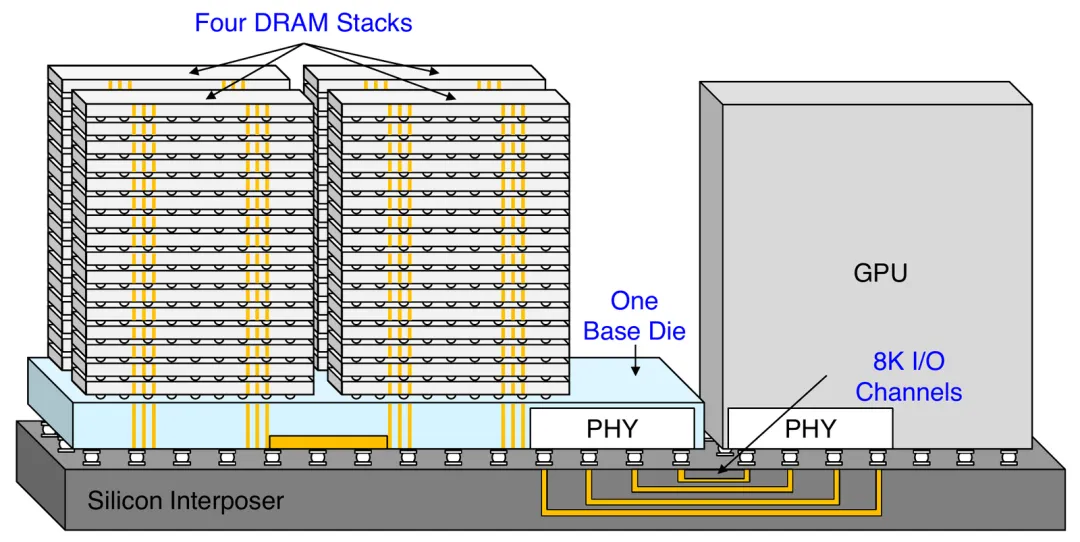
四塔HBM:壞一個塔,整顆256 GB報廢。這是這個設計最大的代價:單塔良率90%時,整顆只有約66%。它的思路是“往寬鋪”——四個DRAM塔共享一顆29.5×22 mm的大base die,8,192個I/O從一條約16.8 mm的邊送出,每毫米約488根,是HBM4的2.6倍,代價是速率降到6 Gbps。單顆256 GB、6 TB/s,模組級容量1 TB、頻寬24 TB/s。但它拿4個塔去比2顆HBM4;換成4顆分立HBM4是8 TB/s,四塔反而低25%。它真正的貢獻,是岸線密度。
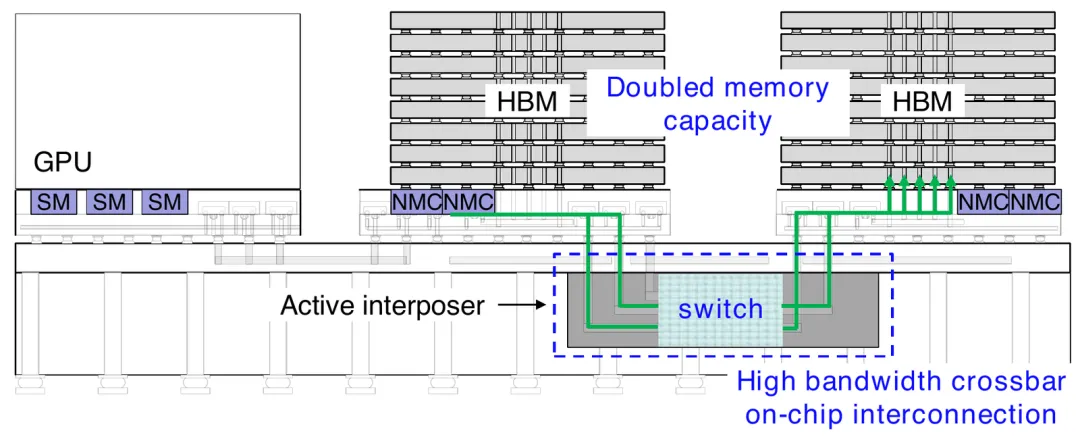
交叉開關叢集:12顆HBM圍著GPU,4.4 mm見方的開關接在四顆HBM的交角處,跨HBM訪問路徑從91.1 mm縮短到44.92 mm。報告宣稱吞吐可達10倍,理由是“頻寬5倍×容量2倍”——這個模型把頻寬與容量錯當成了相乘關係。
一個可以直接拿去用的公式:頻寬和容量不是相乘關係
在訪存受限的解碼階段,同一步裡所有序列共享頻寬。每步耗時=(權重讀取量+全部序列的KV讀取量)÷頻寬。把batch開到容量允許的最大值,吞吐上限約為:
吞吐上限 ≈ 頻寬 ×(1 − 權重佔容量比例)÷(序列長度 × 每token KV大小)
頻寬決定上限,容量只通過“攤薄權重”起作用。頻寬×5、容量×2時,收益=5×(2−w)/[2(1−w)],w為權重佔原容量的比例:w=0時5倍,w=0.5時7.5倍,w=2/3時才是10倍。
這也解釋了為什麼大模型更需要大容量HBM:四塔HBM對70B模型的提升(126%)遠大於7B模型(53%)。
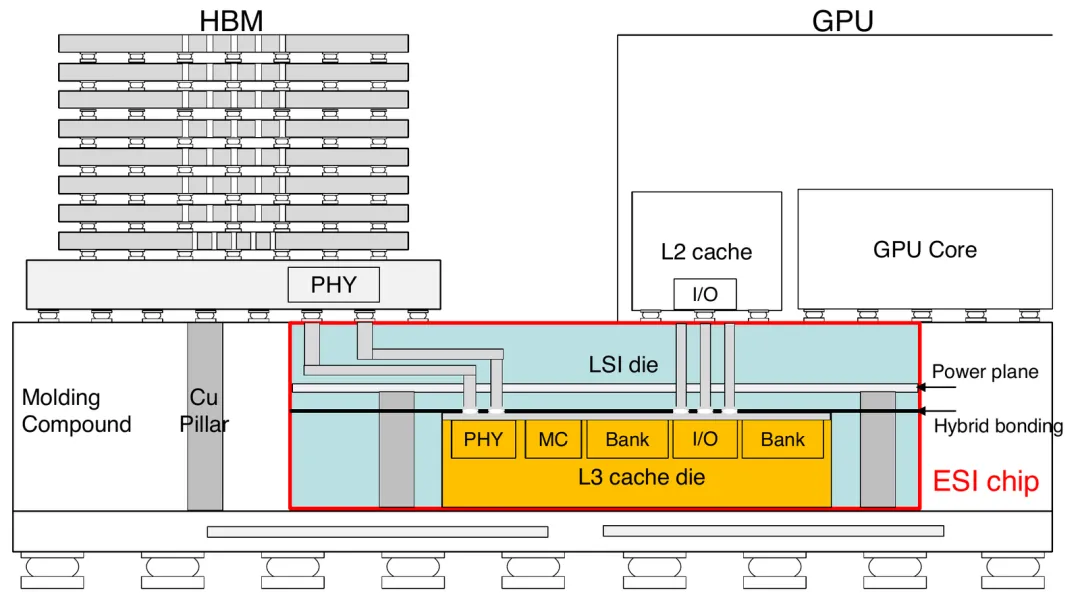
嵌入L3:在GPU邊緣下方的橋接晶片裡混合鍵合兩塊48 MB SRAM,專門存KV,報告稱解碼算力從44升到406 TFLOPS。拆開看,只有約3.7倍來自L3,另外約2.5倍來自把HBM頻寬從4.8 TB/s假設到12 TB/s;40%的能耗下降只算了導線,沒算DRAM陣列和SRAM讀寫。
但方向是對的:封裝級SRAM層正在回歸,AMD MI300把256 MB Infinity Cache放在base die裡,輝達拿Groq的SRAM架構做推理。這類架構的價值,取決於KV能被壓縮到多小——GQA、MLA、低位元KV,演算法側的KV瘦身,決定了硬體側SRAM層的價值。
這些新結構都有一個前提:封裝得足夠大。好消息是,這恰恰是最先被解決的一堵牆。
十三、封裝:面積很快不是問題,功率密度和良率才是
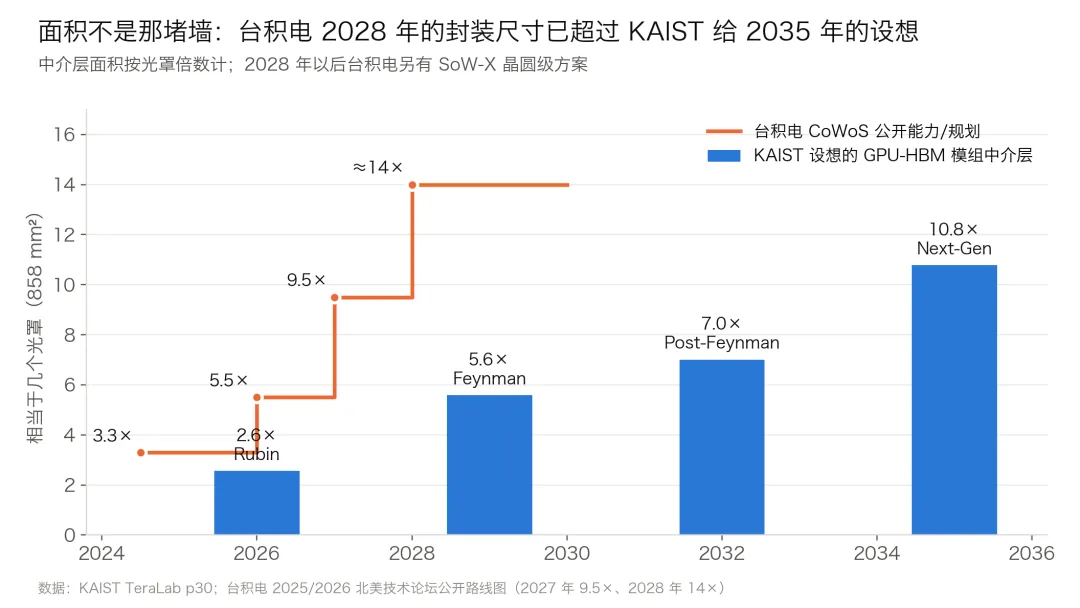
KAIST設想中介層從2.6個光罩擴到2035年的10.8個光罩。台積電的公開規劃跑得更快:CoWoS在2026年約5.5個光罩,2027年9.5個,2028年約14個(均為台積電北美技術論壇公開路線圖),另有晶圓級的SoW-X;面板級的CoPoS(310×310 mm)試產線2026年中建成,2028–2029年量產。
面積問題會比講義預期更早解決,真正卡脖子的是功率密度和良率。
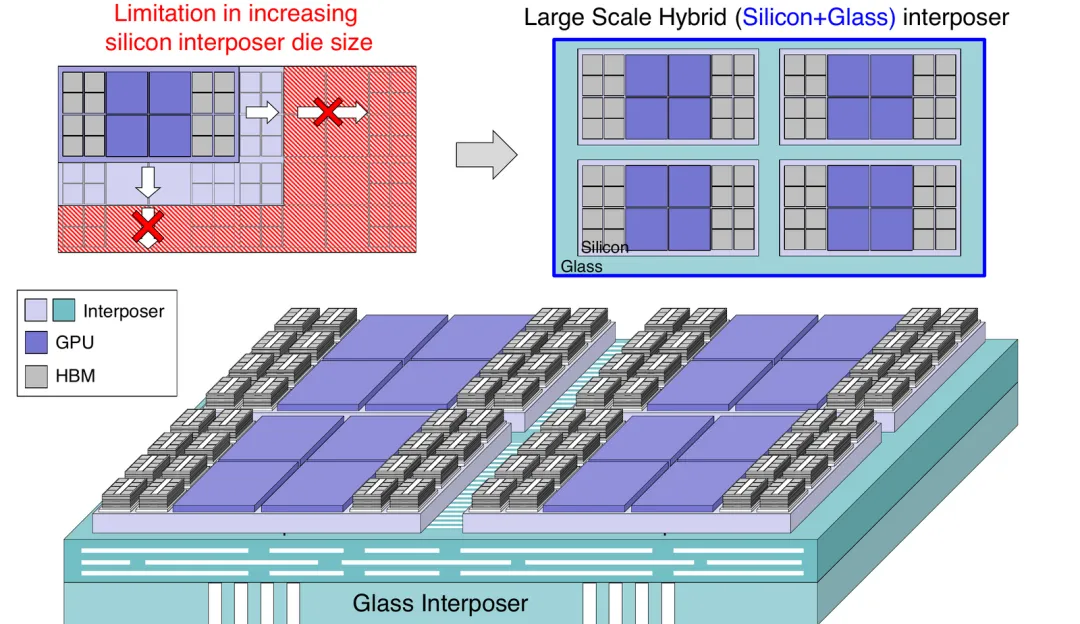
關於玻璃,講義裡的眼圖對比顯示玻璃中介層訊號更好:5 mm走線跑6 Gbps,眼高佔電源電壓43.2%,矽為30.8%。但這不是等密度比較——玻璃線寬2 µm、厚4 µm,矽線只有0.4 µm、1 µm,優勢主要來自線更粗。
玻璃真正的價值不在訊號,而在面板尺寸:讓“多個GPU-HBM模組同封裝”成為可能——封裝即機櫃。產業側,SKC旗下Absolics已向AMD送量產樣品,三星計畫2028年用玻璃中介層取代矽中介層。
HBM8的終局方案,是雙面中介層:GPU和8顆HBM在上層,PCB居中,下層倒掛16個擴展堆疊(本文由p334容量反推,原文未寫),可在HBM、HBF、LPDDR之間三選一,單GPU容量分別達5,760 GB、18,304 GB和9,600 GB。
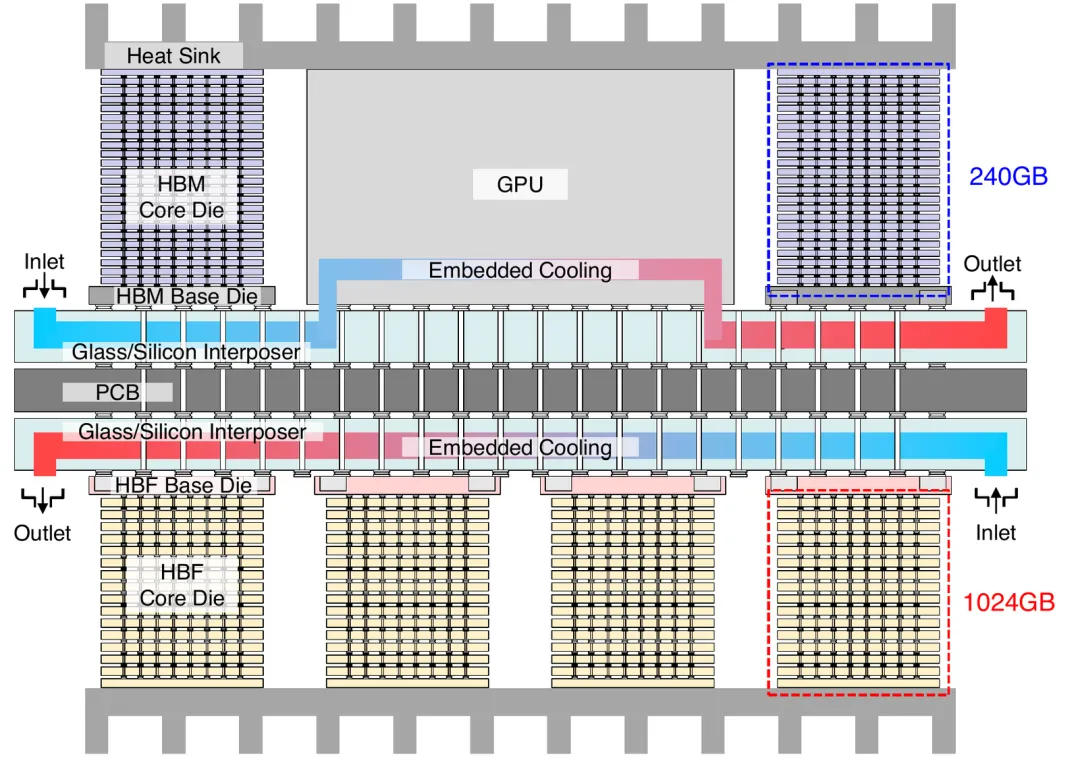
它有兩處硬傷:
- 訊號穿不過PCB:每個下層堆疊32,768個I/O,16個堆疊約52萬根訊號要豎直穿過中間層,PCB通孔做不到,只能靠玻璃芯基板加玻璃通孔;
- 與供電爭地:GPU正下方,恰恰是千瓦級GPU做垂直供電的首選位置。
2030年代封裝的核心矛盾,是訊號、電源、冷卻液三種東西爭同一條垂直通道。
訊號、電源、冷卻液之外,還有一樣東西在告急:容量。
十四、容量帳:書架不夠用了,GPU旁邊要建一座圖書館
頻寬漲32倍、容量只漲5倍,意味著“每秒能把整棧讀幾遍”從HBM3E的28遍升到HBM8的267遍,讀一遍只要3.75 ms。解碼時這是好事;但長上下文的KV cache和MoE大模型要的是容量——頻寬會閒置,容量成了硬頂。
HBM越來越像快取,容量要由下面幾層來補。
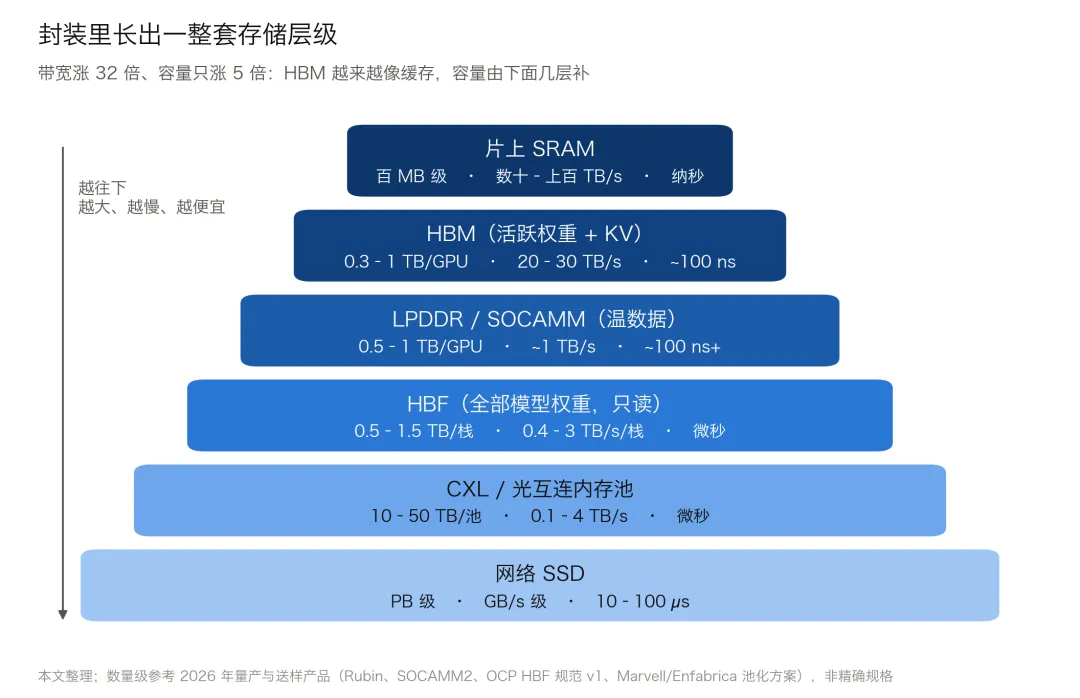
HBF:把快閃記憶體也疊成“樓”
金正浩常用的比喻是:“HBM是GPU旁邊的書架,HBF是GPU旁邊的圖書館。”
HBF(高頻寬快閃記憶體)用TSV把NAND像HBM一樣疊起來,放到GPU旁邊。講義設想16層NAND die疊在base die上,經HBM的base die接入GPU。
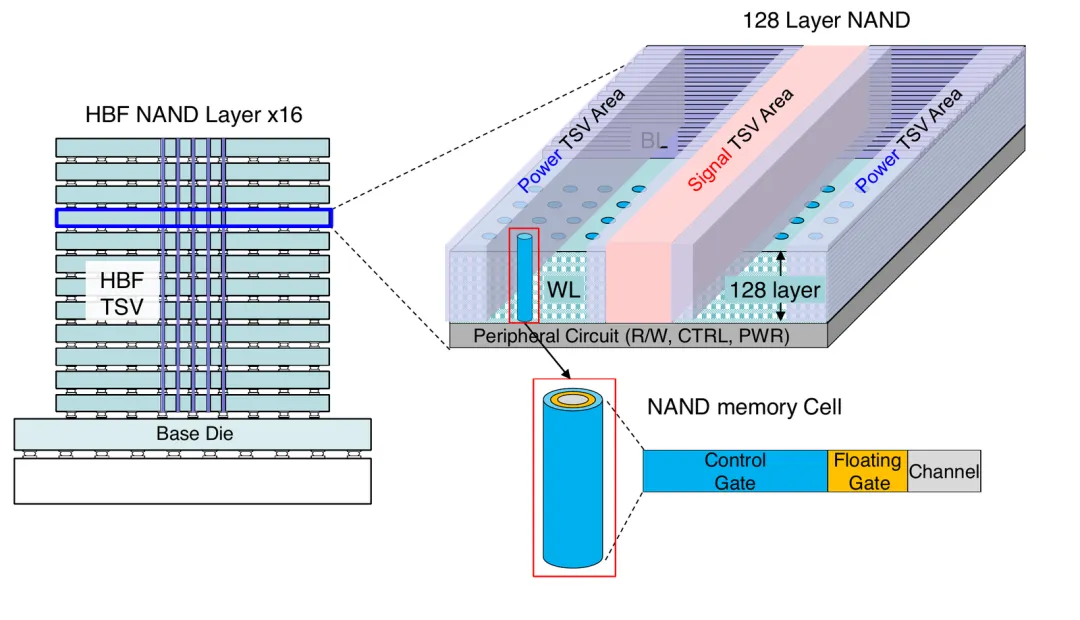
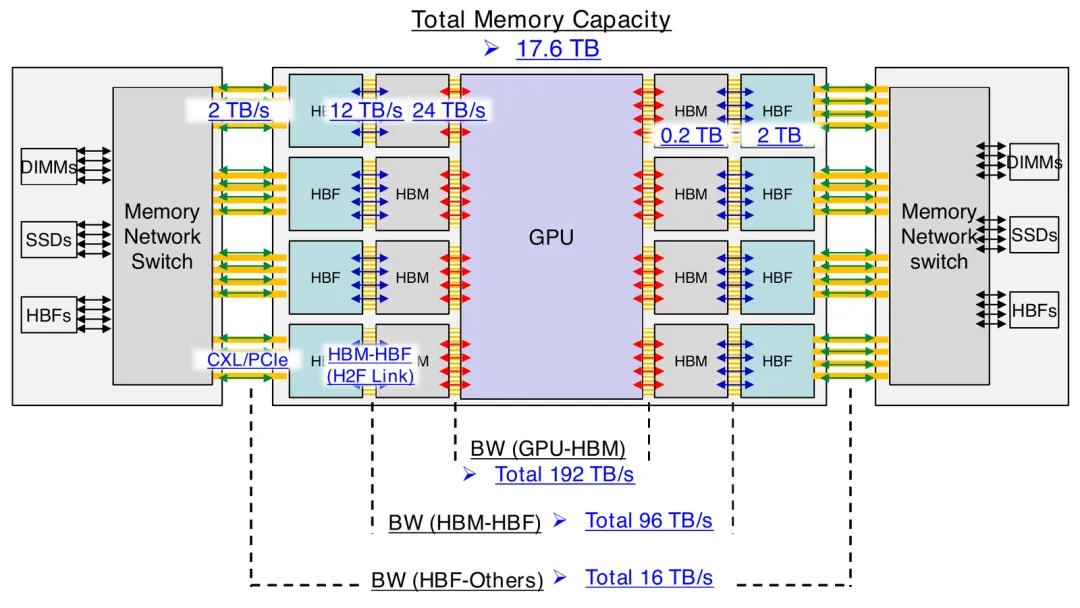
講義在HBF上的數字,需要格外小心:
- 容量算錯:16×512 Gb=1 TB,講義寫成2 TB;
- 頻寬口徑亂:同一場工作坊裡,HBF鏈路頻寬至少有1.0、2、12、64 TB/s四種口徑,最大相差64倍;唯一認真算過NAND陣列的學生報告,得出的單棧上限只有約0.8 TB/s,而且前提是SLC級的5 µs讀取時間和16個plane平行。
HBF的上限在NAND陣列,不在封裝。
還有一個能耗悖論,資料就在講義裡:
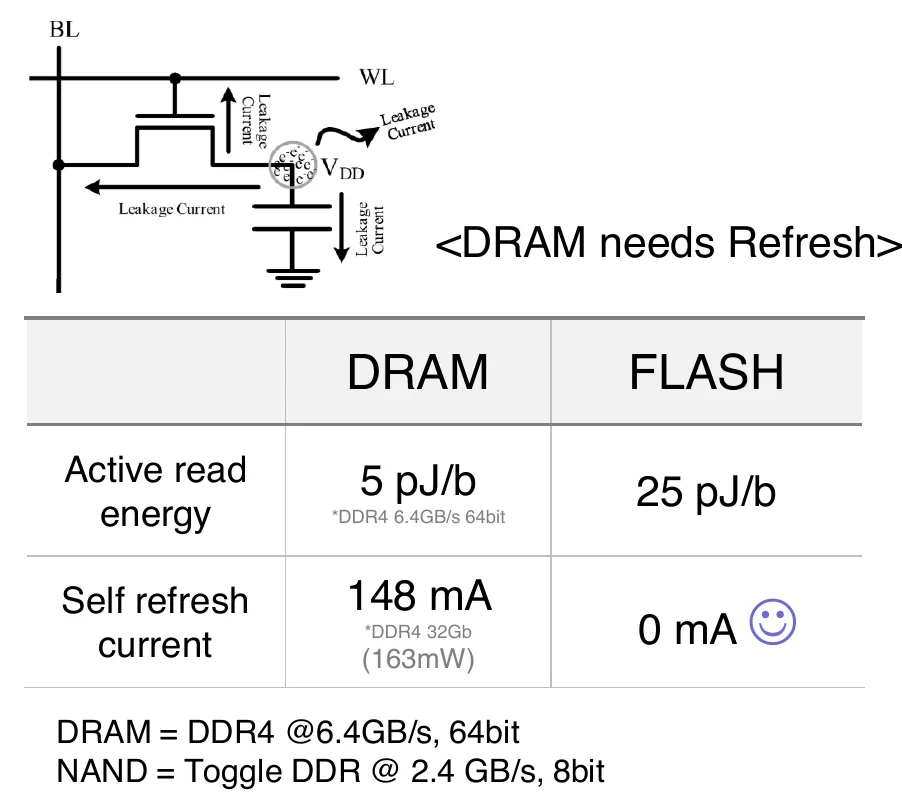
快閃記憶體主動讀取的能耗是DRAM的5倍,按25 pJ/bit線性外推,持續以1 TB/s流式讀取約需200 W一棧(本文推算)。所以HBF商業化的隱性指標,是讀能耗能壓到多少pJ/bit。SanDisk路線圖裡第一代到第三代“能效1×→0.64×”,打的正是這一仗。
產業進度比講義快約5–7年:
- 提出與結盟:SanDisk在2025年2月提出HBF,同年8月與SK海力士簽標準化備忘錄;
- 首版規範:2026年8月發佈首版OCP規範,單棧最高512 GB(8層與16層NAND),三個頻寬等級約0.4–3.0 TB/s,採用UCIe介面,Google和Tenstorrent加入;
- 產品路線:SanDisk首顆HBF die已流片,第一代512 GB、1.6 TB/s,第三代目標超過3.2 TB/s、1.5 TB;樣品2027年,券商口徑2028年量產,SK海力士說全面商用約在2030年。
金正浩預測,到2038年HBF市場會超過HBM。懷疑者也不少:Chips and Cheese認為HBF只適合大塊對齊的DMA訪問,只有在算力受限而非頻寬受限時才划算,軟體負擔接近底層裸盤API。
我們的定位是:
HBF是吞吐機,不是延遲機。這座圖書館適合搬書,不適合翻書。
講義裡有一句話說得最準:“HBM的頻寬給活躍模型,HBF的容量給全部模型。”它適合唯讀權重,比如MoE的冷專家、多Agent的權重池、RAG向量索引、離線批次推理,不適合互動式解碼的KV熱路徑。
另一條路:乾脆繞開HBM
講義設想把3D堆疊的LPDDR掛在HBM後面,由HBM的base die管理。產業走的是另一條路——在推理側用其他記憶體替代HBM:
- SK海力士:192 GB的SOCAMM2已量產,供輝達Vera CPU;
- 高通:AI200每卡配768 GB LPDDR;
- 英特爾:Crescent Island配160–480 GB LPDDR5X,英特爾的說法是“容量與頻寬已經解耦”;
- 輝達:原定用GDDR7的Rubin CPX在GTC 2026上被移出路線圖,推理交給了基於SRAM的Groq 3 LPX(另有分析師稱CPX將改用HBM4復活,可信度待觀察)。
記憶體層級確實在重建,但先發生在機櫃和板級,而不是HBM堆疊內部。
層級越多、定製越多,設計就越複雜,複雜到人已經算不過來。這正是TeraLab真正的看家本領。
十五、用AI設計AI的記憶體:定製越多,越離不開代理
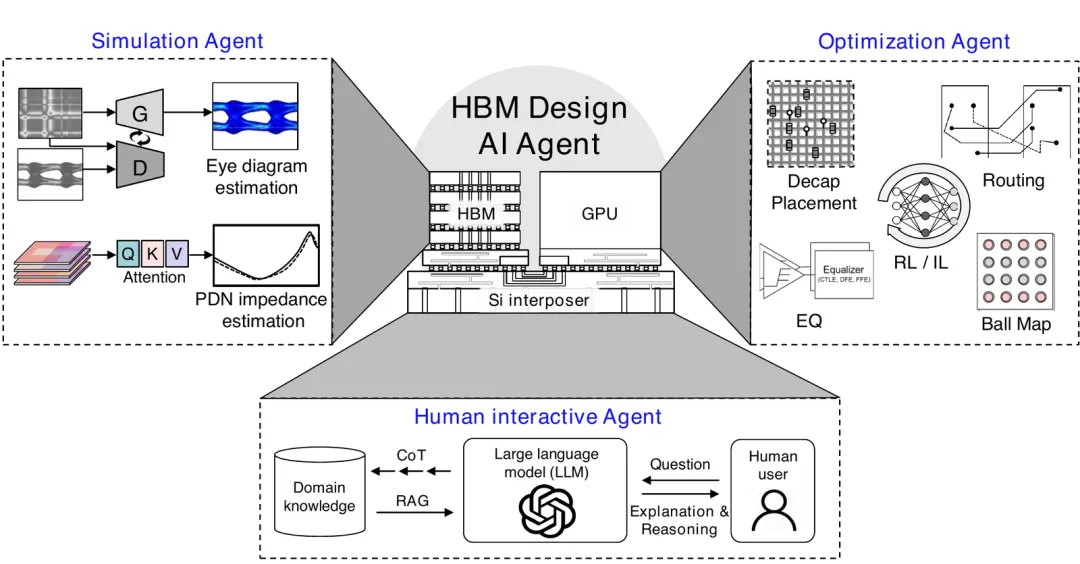
24個報告裡有11個是AI設計代理,方法從強化學習、Transformer、Mamba,一路換到擴散模型、GAN和本地部署的Llama 3.1 8B。硬數字不多,挑幾組有代表性的:
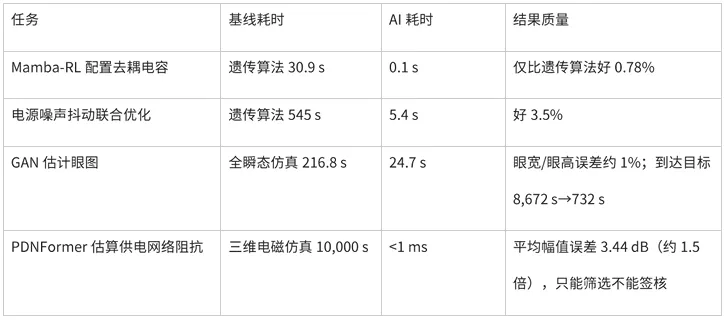
要打的折扣也很明顯:
- 基線弱:遺傳演算法只給500次評估,就去搜一個約10⁶⁵的設計空間;
- 規模小:有的“HBM base die”只有0.3×0.225 mm,比真實尺寸小三個數量級;
- 沒收斂:HBM8的3D佈局強化學習代理,作者自己承認沒有收斂。
但“為什麼HBM設計離不開AI”,報告給出了間接的答案:AI的價值與定製化程度成正比。
通用HBM只有幾個設計點,訓練一個代理不划算;一旦base die按客戶定製,每多一個客戶,就多一套交疊的電源域和幾輪數小時的電磁模擬,預訓練代理的攤銷價值才顯現。定製HBM能服務3家超大客戶還是30家,一定程度上取決於驗證周期能不能從“小時×幾十輪”壓到“毫秒篩選+少量簽核”。
護城河在求解器和真實設計資料,不在網路結構——握有這些的,是Synopsys(已收購Ansys)、Cadence和三大記憶體廠。
技術講到這裡,該算錢了。而錢這本帳,比物理帳更反直覺。
第四部分
錢與中國
十六、錢:最火的HBM,為什麼不是最賺錢的記憶體
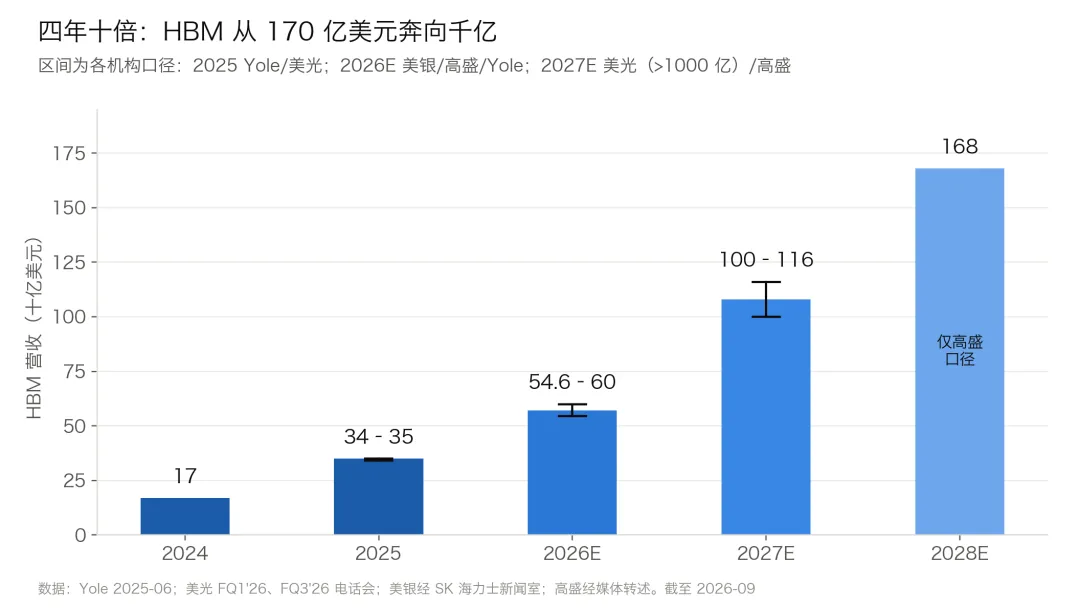
先看規模:
- 高速增長:HBM營收2024年約170億美元,2025年約340–350億美元,2026年各機構口徑在546–600億美元;
- 提前破千億:美光在2026年6月把“HBM年規模超過1,000億美元”的時間從2028年提前到2027年(此前它還稱,2028年的HBM市場將大於2024年整個DRAM市場);高盛給出的2027、2028年口徑分別是1,160億和1,680億美元。
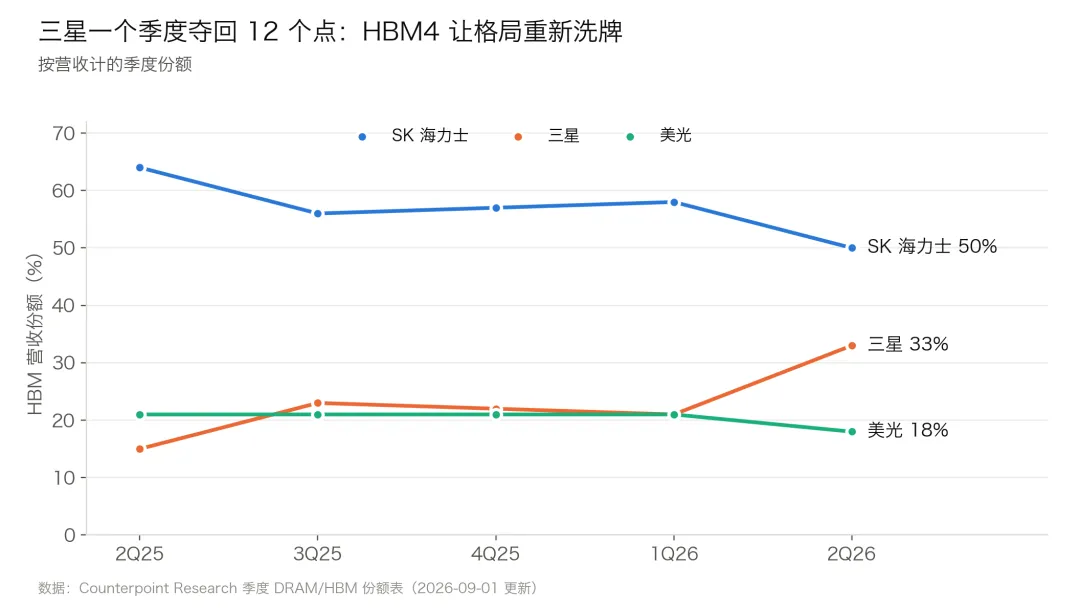
再看格局:HBM4上重新洗牌。按Counterpoint的營收口徑,SK海力士的份額從2025年二季度的64%降到2026年二季度的50%,三星從15%回升到33%。三星率先以1c DRAM加自家4nm base die量產HBM4,良率從2月的不到60%升到8月的約80%(韓媒報導)。
一年前還被認為“掉隊”的三星,一個季度(環比)就奪回了12個百分點。
然後是三個反常識。如果這一節只記一句話,記這句:
最火的記憶體,已經不是最賺錢的記憶體。
反常識一:HBM已經不是最賺錢的記憶體。
TrendForce稱,2026年一季度起,DDR5 64 GB RDIMM每片晶圓的收入超過HBM。美光CEO在電話會上說,非HBM產品的利潤率目前高於HBM;SK集團會長給出的口徑是HBM約60%、標準記憶體約80%。
怎麼會這樣?打個比方:HBM像一套早早簽了長租合同的房子,租金提前鎖定;常規DRAM像月租房,隨行就市。而常規DRAM合約價在2026年一季度環比漲了93%–98%。長約鎖住了銷量,也鎖住了漲價的紅利。
反常識二:HBM越賣越多,佔比卻在下降。
HBM自己還在猛漲:營收從2025年約340–350億美元,漲到2026年各機構口徑的546–600億美元。但整塊DRAM蛋糕漲得更快。按TrendForce預測的2026年DRAM總營收(4,043億美元)推算,HBM佔比從2025年約21%降到約14%–15%。
反常識三:龍頭的領先,反成拖累。
先上車的,先被鎖住。據Counterpoint,SK海力士受早期低價長約拖累最大:一年內DRAM整體份額從39%跌到約25%,與美光基本持平;二季度利潤雖創新高(營業利益率76%),仍因HBM4出貨低於預期而不及市場預期。
還有一個更深的訊號:記憶體正在變得有點像“水電煤”,也就是類公用事業化。
美光簽了16份五年期、照付不議的供貨協議(照付不議,就是客戶不管最後用不用得完,都按約定付錢),其中14份的最低收入累計約1,000億美元,客戶預付款和財務承諾達220億美元。美光還罕見地表示,DRAM綜合每bit成本將會上升。2027年的HBM合約價,市場共識是上漲50%以上,UBS預測漲79%。
當客戶願意預付款、簽五年、照付不議,記憶體就有了幾分公用事業的樣子。
這也是開頭那句話的註腳:截至9月12日,三星、美光、SK海力士市值分別約1.27兆、1.10兆和0.96兆美元。
路線圖對應的供應鏈受益環節
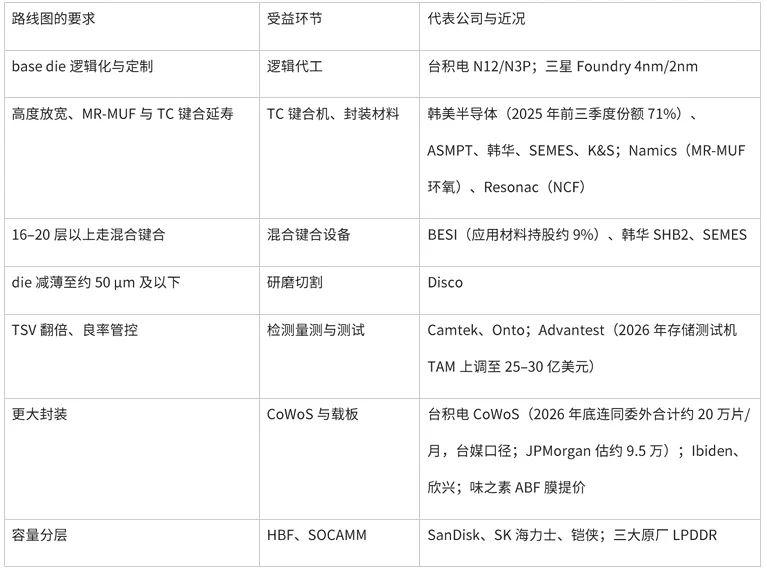
這張受益表裡,沒有一家中國大陸公司。那麼,HBM8離我們到底有多遠?
十七、中國:差距3–5年,那張牌離前沿最近
長鑫記憶體:
- 產品進度:HBM2在2024年下半年量產;HBM3在2025年下半年向華為等送樣;據The Information報導,HBM3E已開始小批次生產,阿里平頭哥和寒武紀在測試,技術落後三大原廠3–5年。
- 良率:SemiAnalysis估算HBM3 8層綜合良率約25%(前段約35%、後段約70%)。
- 產能:HBM晶圓產能約為2025年底0.5萬片/月、2026年底3萬片/月、2027年底5.5萬片/月,而韓系兩家合計超過40萬片/月,差距約14倍(口徑不完全可比,本文推算)。
- 資本:長鑫2026年7月27日在科創板上市,首日漲466%,市值約3.3兆元,但招股書募投項目裡沒有專門的HBM項目。
華為:
- 自研HBM:2025年全聯接大會上公佈HiBL 1.0為128 GB、1.6 TB/s,而2026年3月實際發佈的Atlas 350配112 GB、1.4 TB/s;950DT的HiZQ 2.0為144 GB、4 TB/s;2028年的昇騰970目標288 GB、14.4 TB/s。
- 製造方:實際的DRAM與封裝製造方未公開。
管制:
- HBM本身:美國2024年12月2日的規則以“記憶體頻寬密度超過2 GB/s/mm²”為門檻(ECCN 3A090.c),幾乎覆蓋全部AI用HBM,並同步管控HBM相關的製造與封裝裝置。
- H200放行:2026年1月起,H200改為逐案審批對華出口,每顆封裝6個HBM3E堆疊——HBM以“封裝在GPU裡”的形式合法流入中國。
- 庫存:SemiAnalysis估計,管制生效前中國累計獲得約1,300萬個HBM堆疊,並認為HBM而非邏輯晶片才是昇騰產量的瓶頸。
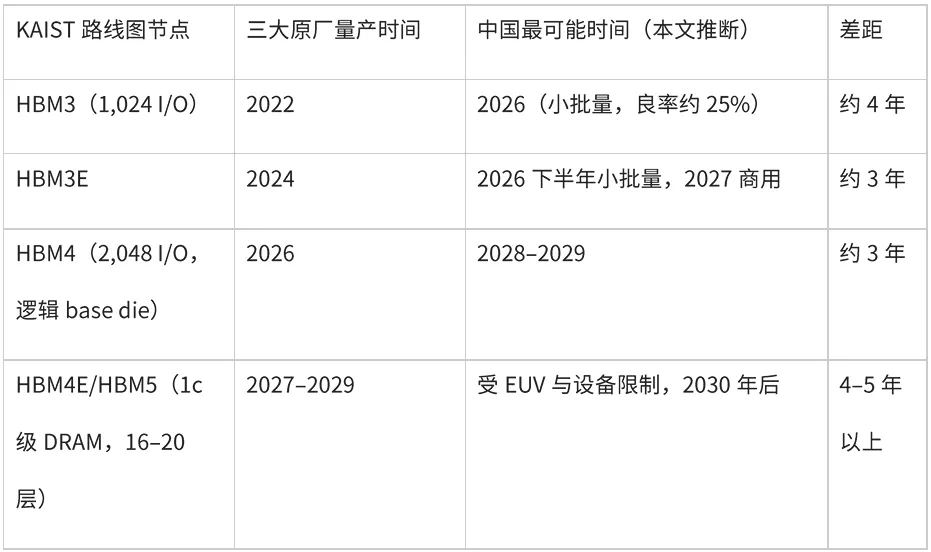
差距在那裡最硬:DRAM工藝節點(1c級需要EUV)、TSV堆疊良率、裝置可得性。但有幾張牌值得看:
- base die用成熟邏輯工藝。標準版HBM4的base die是12nm級邏輯,國內代工能力可覆蓋(定製HBM4E已轉向3nm/2nm);中介層橋接晶片同理。
- 封裝與裝置有基礎。據報導,通富微電、長電科技已參與長鑫HBM後段,北方華創、邁為等在提供HBM組裝裝置。
- HBF是一條新賽道,護城河在NAND陣列與晶圓鍵合。SanDisk把“BiCS+CBA”列為HBF的核心賣點,CBA就是把CMOS外圍電路晶圓與記憶體陣列晶圓鍵合在一起;長江記憶體的Xtacking於2018年發佈、2019年起隨64層產品量產。如果HBF成立,這是國產記憶體離前沿最近的一塊拼圖(受實體清單等因素制約,本文僅作技術判斷,不構成投資建議)。
- 推理側的LPDDR路線門檻更低。SOCAMM類方案對工藝和封裝的要求遠低於HBM。
把技術、錢和中國放在一起,2029年之後會走向那裡?我們給出三種情景,各配一個機率。
十八、2029–2038:三種結局,和你該盯住的八個訊號
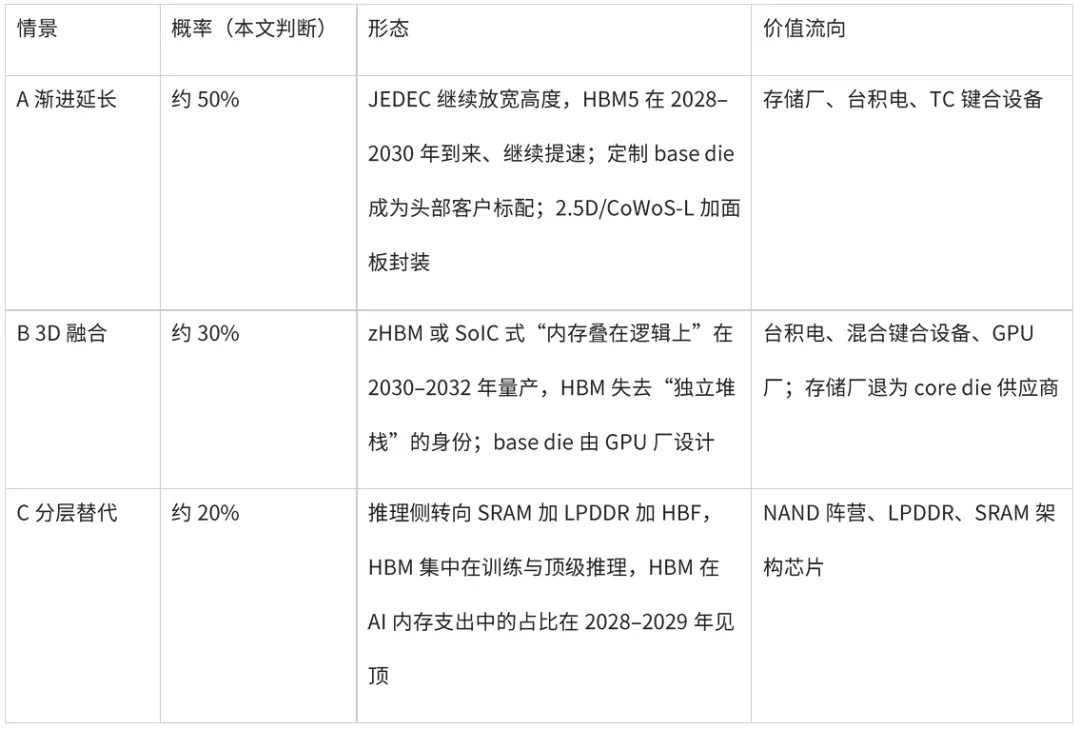
三種情景並不互斥,更可能是A打底、B在頭部客戶先發生、C在推理側蠶食。
如果你想自己跟蹤這場遊戲,盯住這八個訊號:
- JEDEC下一代高度規範是否定在900 µm以上——是,則A加強,混合鍵合再推遲;
- 第一款量產混合鍵合HBM,是16層HBM4E還是20層HBM5;
- 輝達之外,是否有第二家GPU或ASIC廠自研base die(Google、AWS、OpenAI);
- Rubin Ultra最終是1 TB HBM4E,還是縮配到192/256 GB;
- 2027年HBM合約價漲幅,以及長約裡的價格上下限條款;
- HBF首批樣品是SLC還是TLC,讀能耗是否公佈;
- 三星zHBM是否給出時間表,以及Feynman的3D堆疊細節;
- 長鑫HBM3E的良率,以及華為HiZQ 2.0的量產情況。
結語
一張地圖,而不是一張時刻表
回到開頭那個數字。15,360瓦,若按表中標註的HBM7計,可能多算了640瓦;而它背後那張表,要求每位元能耗在12年裡降到1/13,低於今天DRAM陣列訪問本身的能耗。
所以,這份路線圖不是一張時刻表。
它在速度上保守,在架構上激進,在數字上粗糙。但它把HBM未來十二年要撞的每一堵牆都列了出來:能耗、岸線、高度、熱、供電、容量。它是一張地圖。
產業的做法,是先拆最便宜的那堵牆:客戶推著速率往上走,JEDEC放寬高度給微凸點續命;把昂貴的範式變化——3D融合、近存計算、堆疊內流道——往後推。
最大的未知數,是每位元能耗。誰把pJ/bit打下來,誰就定義2030年代:可能是3D堆疊讓連線變短,可能是近存計算讓資料少走路,也可能是HBF用低佔空比的廉價容量,繞開這個問題。
HBM的故事,從來不只是記憶體的故事,而是“資料要走多遠”的故事。
下一次,當你看到一顆新的AI晶片發佈,別只看它算得多快。先問一句:它的資料,要走多遠?
來,一起對答案
這份預言還要12年才走完。我們留三道題,歡迎把你的答案寫在評論區:
- 二選一:HBM5會先上混合鍵合,還是JEDEC會繼續放寬高度?評論區回覆“鍵合”或“放寬”。
- HBF是“下一個HBM”,還是“想得太美”?
- base die的設計權,最後落在誰手裡:GPU廠、記憶體廠,還是台積電?
給行家的一個邀請:我們在講義裡逐頁核出了12處對不上的數字,文中只點了其中幾處。如果你發現了更多,或者認為我們那一處讀錯了,歡迎直接留言指正。 (半導體行業觀察)