
🔷不取代HBM,而是擴展HBM:高頻寬Flash將TB級容量進一步推向xPU身邊
🔷模型權重、KV Cache與MoE成為關鍵場景,AI記憶體層級迎來重新劃分
隨著大模型參數規模持續膨脹、Context Length不斷拉長,AI晶片面臨的挑戰已經不只是“算力夠不夠”,Memory Wall正在成為制約GPU/TPU/xPU繼續擴展的重要瓶頸。HBM雖然擁有極高頻寬,但容量擴展壓力越來越突出;傳統NAND容量足夠大,卻又很難滿足AI計算對近端高頻寬資料訪問的需求。正是在這樣的背景下,High Bandwidth Flash(HBF)開始走向台前——它試圖把Flash從傳統記憶體層直接搬到xPU身邊,在HBM與SSD之間建立一個全新的高頻寬、大容量Memory Tier。
這次,小編就帶大家詳細看看這份HBF High-Level Base Die Specification。從3D NAND Stack、Base Die、TSV,到16通道Wide-I/O、UCIe/AXI互連,再到512GiB+容量與最高3.072TB/s目標有效頻寬,HBF正在嘗試用“高平行NAND+先進封裝+Chiplet互連”重新定義Flash的性能邊界。
更值得關注的是,HBF從一開始就瞄準了LLM Serving、模型權重載入、KV Cache以及MoE等AI工作負載。當NAND開始以TB/s級頻寬緊貼GPU,HBM、HBF與SSD之間的邊界也正在被重新定義。
一、這份材料真正想說明什麼?
HBF(High Bandwidth Flash)試圖把傳統NAND Flash從“遠端記憶體”變成緊貼GPU/TPU/xPU的超大容量、高頻寬記憶體層:通過3D堆疊NAND + Base Die + TSV + UCIe/AXI寬介面,在接近HBM讀取頻寬的同時提供約8~16倍HBM容量,從而緩解AI時代越來越嚴重的Memory Wall,並重點服務LLM權重、KV Cache、MoE等超大模型資料。
二、HBF要解決的核心問題:AI的“Memory Wall”越來越嚴重
首先把HBF出現的原因講得非常明確:GPU計算速度和記憶體器響應能力之間的差距正在形成越來越嚴重的Memory Wall。
尤其進入LLM時代之後,模型參數量和Context Length持續增長,AI系統不僅需要更高Memory Bandwidth,也需要更大的Memory Capacity。HBM雖然頻寬極高,但容量擴展仍然受到限制,而傳統SSD/NAND雖然容量巨大,卻距離GPU較遠,無法提供HBM級的近計算高頻寬訪問。
因此HBF的定位不是簡單替代SSD,也不是簡單替代HBM,而是Augment HBM——作為HBM旁邊一個容量更大的高頻寬Flash層。規格書明確提出,HBF採用Wide-I/O NAND架構,希望提供HBM約8~16倍容量,同時達到相同等級的Read Bandwidth,最終讓xPU能夠直接連接TB級容量。
所以理解HBF最重要的一點就是 HBM解決“高頻寬”,NAND解決“大容量”,而HBF想把“大容量NAND”推進到HBM附近,讓Flash進入AI晶片的高頻寬記憶體體系。
三、HBF的基本架構,很像“HBM思路+NAND介質”
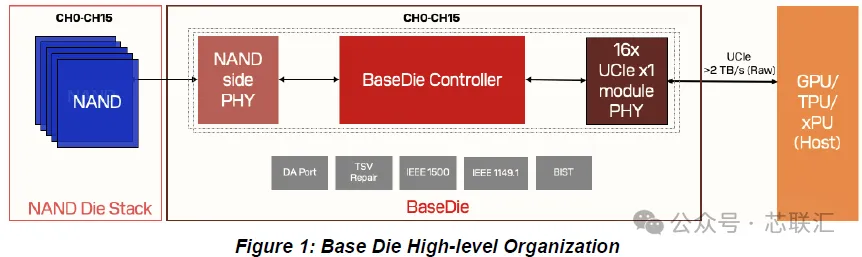
HBF在物理結構上採用非常典型的3D堆疊架構,主要由三部分組成:
Base Die + Core Die(NAND Stack)+ TSV Channels。
其中Core Die由多層NAND Die組成,Base Die位於最底部,負責連接上方NAND與旁邊的Host xPU。Base Die內部又整合UCIe Controller、UCIe PHY、Base Die Controller以及Admin/Debug Management等模組。
這裡的Base Die其實非常關鍵。
它並不是簡單的“底座”,而相當於整個HBF的智能I/O與管理中樞:負責Host Traffic管理、UCIe協議、NAND命令管理、資料搬運、ECC、錯誤處理、調度、初始化、TSV冗餘對應以及Page Read Counter等功能。
因此可以把HBF的資料路徑簡單理解成GPU/TPU/xPU → UCIe → Base Die → TSV → NAND Stack,這也是HBF能夠把NAND從傳統記憶體裝置拉到xPU附近的關鍵。
四、真正激進的地方:512GiB容量,同時瞄準3.072TB/s頻寬
這份規格書給出的性能目標非常值得關注。
單顆HBF Stack可以支援512GiB甚至更高容量;最多支援16個獨立Host Channel,每個Channel採用64-bit Full Duplex寬介面,並基於UCIe 3.0相關規範運行。
最高Speed Grade 3下 32GT/s UCIe × 64-bit × 16 Channels → 4,096GB/s Raw Bandwidth
按照規格書給出的75% AXI Link Layer效率計算,最終目標有效頻寬達到3,072GB/s,也就是3.072TB/s。與此同時,單顆Cube容量達到512GiB。
這實際上揭示了HBF最核心的產品邏輯:它不是追求傳統NAND那種“容量優先、頻寬其次”,而是試圖通過大量平行NAND + 超寬Die-to-Die介面,把Flash頻寬推到TB/s級。
也就是說,HBF的關鍵不是單顆NAND突然變快了,而是依靠16個獨立Channel + Wide I/O + UCIe + 高度平行化的NAND Stack,把大量NAND平行頻寬聚合起來。
五、UCIe成為HBF連接xPU的關鍵介面
HBF另外一個非常值得關注的地方,就是直接把UCIe引入記憶體體系。
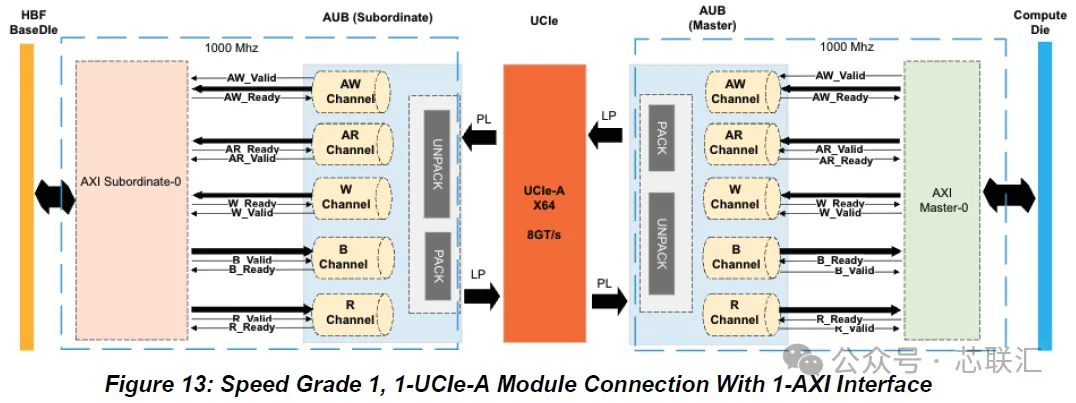
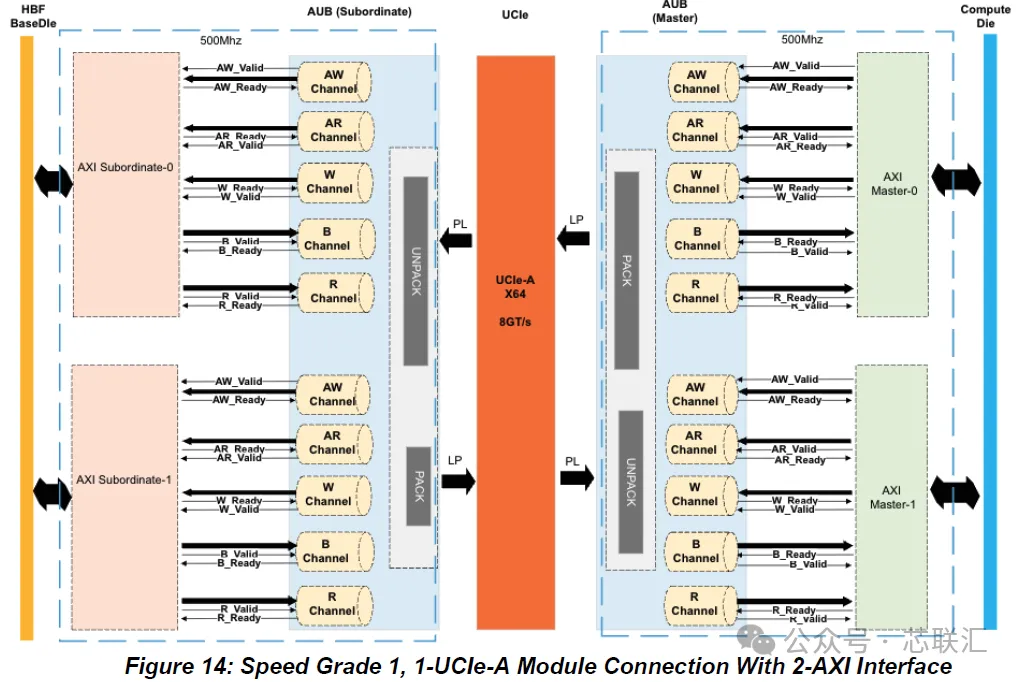
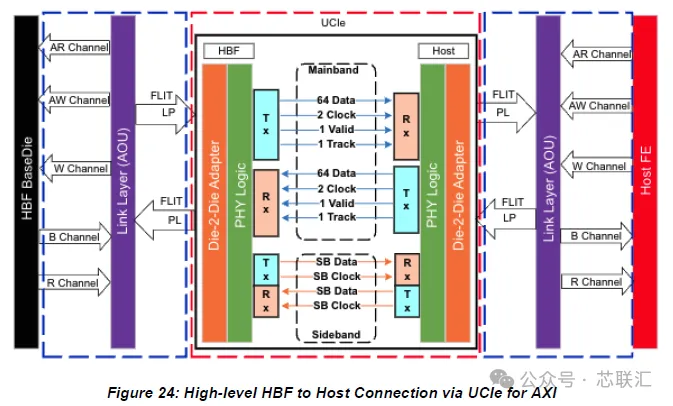
HBF與GPU/TPU/xPU之間不是傳統PCIe SSD那種遠距離連接,而是通過先進封裝,把HBF放在距離Compute Die非常近的位置。規格書給出的UCIe Channel Reach目標最大約2mm,單個x64 Host Module在32GT/s下可達到256GB/s。
上層則採用AXI → UCIe Streaming Protocol → UCIe D2D → PHY,從而讓Host能夠通過AXI體系訪問HBF。
這意味著HBF實際上把先進封裝、Chiplet互連和NAND記憶體結合到了一起。UCIe不再只是“Compute Chiplet連接Compute Chiplet”,還開始承擔xPU ↔ 高頻寬Flash Chiplet之間的資料通道。
六、16個獨立Channel,是HBF獲得高頻寬的核心HBF並不是讓所有NAND共享一條高速匯流排,而是採用高度平行的Distributed Interface。
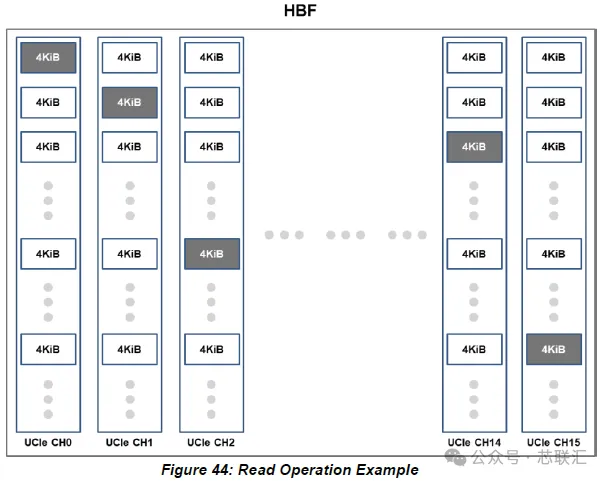
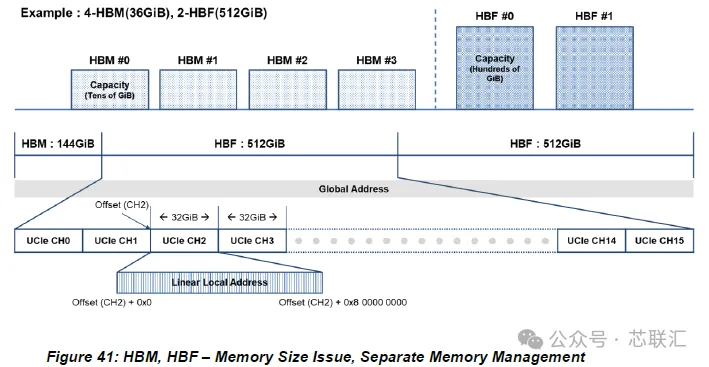
每個Host Channel都是獨立UCIe Link,每條Main Band擁有64-bit資料寬度;不同Channel訪問各自獨立的NAND Pool,一個Channel不能訪問另外一個Channel的資料,而且不同Channel可以獨立運行。
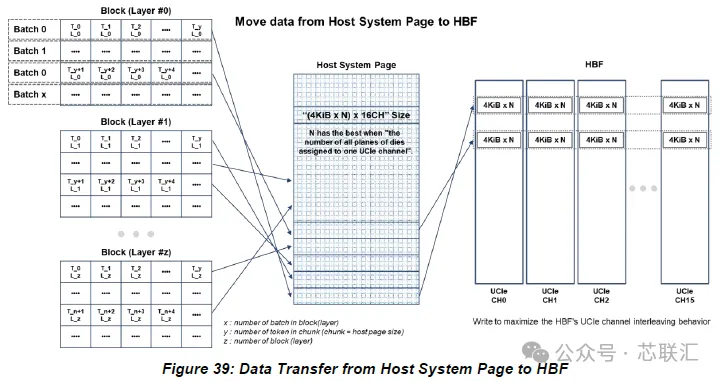
Host Software則可以通過Address Mapping和Interleaving把資料分散到不同Channel、不同AXI Port以及不同NAND Die。
尤其當多個AXI Port同時工作並採用4KiB Interleaving時,可以最大程度發揮HBF平行讀取頻寬。
所以HBF的性能邏輯其實可以濃縮為更多NAND Die → 更多獨立Channel → 更寬UCIe介面 → 更高平行度 → TB/s級Flash頻寬。
七、HBF並不是要把Flash完全變成DRAM
這一點非常重要。
規格書將HBF定義為Non-Coherent、Memory-Centric Flash Device。而且HBF明顯針對Read-intensive(讀密集型)應用進行了最佳化。寫入方面仍然保留NAND的很多特性,例如4KiB Page、Wear Leveling、Garbage Collection、Zone Remapping等。
甚至規格書還專門設計了一個可選的Scratchpad SRAM,用於處理高優先順序、超低延遲Read/Write,其延遲目標在L3 Cache Read/Write量級。
這說明HBF並不是聲稱“NAND已經和HBM完全一樣。”更準確地說,它是在AI Memory Hierarchy中創造一個新的層級 HBM → HBF → SSD/Storage
HBM繼續承擔最需要低延遲和高頻讀寫的資料,而HBF承接那些容量巨大、讀取頻寬要求極高,但不需要HBM級寫入特性的資料。
八、真正瞄準的是LLM:模型權重、KV Cache、MoE
這也是這份規格書最值得關注的地方。
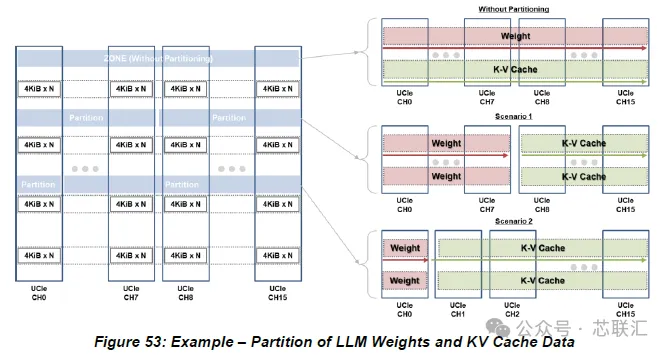
最後的HBF Applications章節直接討論了 Single LLM Serving、Multiple LLM Serving、MoE、AI Parameter Store & Loading、KV Cache Data Write/Read,以及Weights與KV Cache Channel Partitioning。也就是說,HBF的目標應用已經非常明確地指向生成式AI。
對於LLM推理來說,大量模型權重並不需要像HBM裡的中間計算資料一樣不斷修改,但需要以非常高的頻寬持續送入xPU,因此非常適合高容量+高讀取頻寬的記憶體體系。
同樣,隨著Context Length持續增長,KV Cache也會迅速吞噬記憶體容量。HBF試圖通過數百GiB乃至TB級近xPU Flash,為這些場景提供新的容量層。
這也是為什麼報告一開始強調:HBF不僅要解決Bandwidth問題,還要解決AI模型越來越大帶來的Memory Capacity問題。
🏁 小編總結
HBF(High Bandwidth Flash)正在嘗試重新定義AI系統中的NAND位置:不再把Flash僅僅作為PCIe SSD背後的遠端塊記憶體,而是通過3D NAND Stack、Base Die、TSV、16通道Wide-I/O以及UCIe/AXI介面,把數百GiB乃至TB級Flash直接放到GPU/TPU/xPU附近,在保持超大容量優勢的同時,將讀取頻寬推向TB/s級。其目標不是簡單取代HBM,而是作為HBM的容量擴展層,為LLM權重、KV Cache、MoE等AI工作負載提供“高頻寬+超大容量”的新型Memory Tier,從而緩解AI時代越來越嚴重的Memory Wall。 (芯聯匯)