
9月22日-24日,2026年雲棲大會在杭州國際博覽中心舉行。
在主論壇上,阿里集團CEO吳泳銘表示,未來將進入機器智能時代,機器成為思考的主力,智能正在成為一種規模化商品,但機器智能時代的代表性產品,還沒有出現。
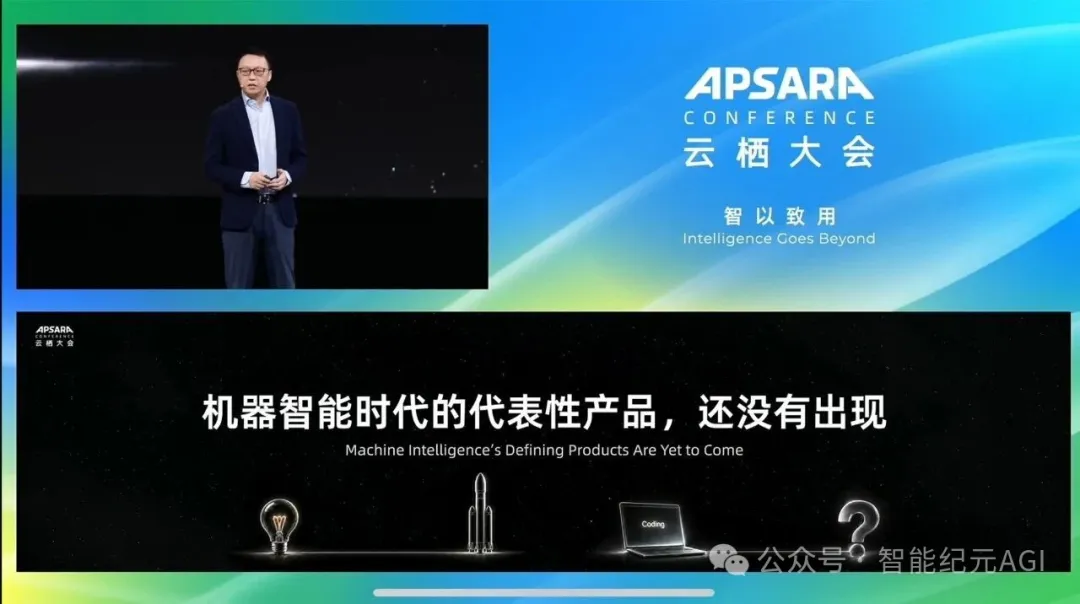
吳泳銘的判斷在於,未來機器供給的思考總量將是人類思考總量的1000倍以上,這件事我們在一個新的時代機器動力,我們所有的機器動力承擔的這個世界的物理工作,其實現在已經接近99.9%,未來人類的思考總量也許還會繼續增長,但機器思考的總量規模將以更快的速度擴張,未來機器思考的總量也會承擔整個世界思考總量的99.9%。
吳泳銘指出,AI模型、AI晶片和AI雲是機器智能時代基石,而AI模型通向ASI的路徑逐漸清晰;機器智能釋放人類的好奇心和創造力。
吳泳銘在雲棲大會表示,當前客戶 AI 需求非常強勁,將全力投入 AI 基礎設施建設,目標到2032年阿里雲營運的全球資料中心規模超過20GW。當天,平頭哥發佈最強國產AI晶片真武V900,算力提升至真武M890的3倍。據悉,平頭哥AI晶片的年出貨量將大幅提升。
“今天平頭哥對於超大規模AI叢集的核心晶片,我們已經進行全面覆蓋。同時我們正在對晶片伺服器超節點網路模型和推理系統進行聯合調優,不斷的提升整個AI叢集的圖肯產出效率。阿里自研的M890 AI超節點已經成功支撐過2萬億參數以上的大模型的推理,是全球極少數具備這樣能力的公司之一。”吳泳銘稱。
吳泳銘強調,當前AI資料中心相關供應的全球性緊缺,限制了阿里雲算力的增長速度,為此,阿里巴巴將與所有合作夥伴一起全力投入AI基礎設施建設,打造一朵面向機器智能時代的AI雲。
隨後,阿里巴巴ATH事業群Token Foundry Qwen LLM項目負責人,也就是阿里Qwen大模型項目負責人劉大一恆上場演講。
劉大一恆表示,Qwen的Roadmap路線圖主要有四個方向:一是深入真實生產加速RSI進化,二是革新模型架構突破效率邊界,三是邁向全模態拓寬Agent邊界,四是持續Scaling突破智能上限。
劉大一恆透露,Qwen4即將發佈包含Qwen4-Max、Qwen4-Flash&Qwen4-Plus和Qwen4-27B四個產品。同時,在Qwen 4.5和Qwen5系列模型當中,模型訓練參數量將增長為為5萬億至10萬億。
“就像如果我回到300年前,我是一個在田間工作的農夫,很難想像未來會有一個人說走進一個叫健身房的地方,付費去進行體力勞動。去年,我們說AI越強大,人類更強大,今天我們依舊這麼認為,這也是我們全力邁向機器智能時代的意義,把繁重任務留給機器,把時間、創造力以及對美好事物的感受留給人類。”吳泳銘稱。
以下是吳泳銘的演講資訊簡要整理(未經過阿里雲的稽核,僅供參考):
一年前我們判斷,AGI 只是起點,AI 將繼續走向能夠自我迭代的超級智能(ASI)。
過去一年,我們已經習慣了從 Vibe coding 到 vibe working。AI 在長程任務方面取得了非常大的突破,自主進化的技術路徑也逐漸清晰。
隨著 AI 解鎖更強的能力、加速滲透各類場景,我們看到了一個深刻的變化:機器正在成為思考的主力,而智能正在成為一種可以規模化的商品。
上一次這樣的變化,我們可以追溯到工業革命早期。
工業革命把動力變成了規模化的商品,人類先後發明了蒸汽機、內燃機和電,並圍繞它們建立了我們現在熟悉的現代產業。
這一次,我們覺得輪到了思考。過去,一個複雜問題能夠得到多少思考,完全受限於人類的智力總和和分配機制。今天機器打破了這些限制 —— 隨著 ASI 的逐步實現,AI 基礎設施不斷擴展,思考就像動力一樣,成為一種可以規模化供給的商品。
未來我們判斷將進入機器智能時代。今天我們要講的,其實就是我們對機器智能時代的思考,以及阿里巴巴的戰略選擇。
一、重新理解 AI:不是人造智能,而是新物種
首先我想理清一個概念。
大家習慣把 AI 叫做 "人工智慧",但是 "artificial" 這個詞在英文裡更像是 "人造的"—— 我們說人造鑽石、人造皮革,就是這個意思。但談到 AI,我們也習慣用這樣一種思維方式去思考它,希望造出像人一樣思考的 AI。過去我們都在問:AI 能不能像人一樣思考?圖靈測試也一度成為大家衡量 AI 的金標準。
但是我們來回顧一下工業革命。蒸汽機、內燃機在早期也許是替代人和馬能做的事情,比如礦井抽水、織布、搬運 ——"馬力" 這個詞當時就是這麼來的。但很快,機器動力能做的事情遠遠超過了人和動物的體力勞動:再多的人和馬也無法讓火車飛奔,更無法讓飛機和火箭上天。
機器動力不是簡單的 "人造體力",而是創造了一個完全不同的物種。機器動力的深度、廣度和密度,讓人類做到了以前從未想到過的事情。
同樣,今天的機器智能也不是人類智能的替代品,而是完全不同的物種。今天我們看到 AI 幫人程式設計、幫人寫報告寫 PPT,只是機器智能的初級階段。當機器智能的供給變得無限充沛,它對人類社會的意義將遠遠超出我們現在定義的 "對現有腦力勞動的替代",這種變化將比工業革命來得更加深刻。
二、兩個判斷:機器思考總量將是人類的 1000 倍以上
對於未來機器智能時代,我們有兩個判斷。
第一個判斷:未來機器供給的思考總量,將是人類思考總量的 1000 倍以上。
這件事我們可以換個角度看 —— 在機械動力時代,全世界所有機械動力承擔的物理工作,現在已經接近 99.9%。未來人類的思考總量也許還會繼續增長,但機器思考的總量規模將以更快的速度擴張,我們覺得未來機器思考的總量也會承擔整個世界思考總量的 99.9%。
我們可以從供給和需求兩個方面來推演。
首先是供給的變化。
人類頂級思考的供給其實十分有限 —— 全世界知名的科學家和資深專家,數量非常有限。培養一名頂級科學家或行業專家,需要數十年的學習和實踐,還需要天賦和運氣。這會讓很多領域的研究長期缺少足夠的智力投入。
例如新生兒早衰症這樣一種罕見病,每年全球新增病例可能僅幾十例,全球有記錄的患者可能只有幾百人。這樣的罕見病很難獲得充足的研究資源。從現有醫藥產業的商業邏輯上來看,很少有公司願意花幾十年時間、耗費巨資為幾百人研發一種新藥。但是當 AI 具備專業研究所需的智力水平後,只要算力足夠多、算力足夠便宜,每個細分領域都有可能組織上百萬個智能體持續研究、模擬和驗證,探索不同的方案。過去這些資源投入不足的研究方向,規模化的智力供給、頂級思考,將從奢侈品變成可規模化供給的商品。
想像一下:未來我們整個世界,每個細分領域都有上百萬量級的 AI 科學家和專家持續創新、攻克難題,這會給人類社會帶來多麼大的改變。
其次是需求的變化。
工業時代我們看到,人類消費的很多商品取決於人口的數量。咖啡需要有人喝,一天喝一杯、也許 3 杯 5 杯,但終歸有個上限;車要有人開,手機要有人用。
一個人一生能消費的物理商品總是有限的。但是當 AI 的能力越來越強,這個關係會發生根本性的變化。
設想一下未來的場景:當我們讓 AI 去造一艘飛船去火星 —— 這樣一個現在看起來天方夜譚的複雜任務 ——AI 未來也許可以將它分解成成千上萬個子任務,有上百萬個智能體不眠不休地持續工作,直至任務完成。人只需要給 AI 提供一個創意和目標,它就能調動龐大的智力資源。
每一個超級個體未來都可以擁有上萬倍的智力槓桿。思考的消耗量將不再與人口數量成正比,而是與機器智能的思考深度和供給規模成正比。機器思考的總量,未來將遠遠超過人類思考的總量。
今天機器思考的總量,我們做個簡單算術,大概不到人類的 3%。如果未來機器思考的總量是人類的 1000 倍,簡單推演一下,機器思考未來的規模需求還有幾萬倍以上的增長空間。
三、第二個判斷:代表性產品還沒有出現
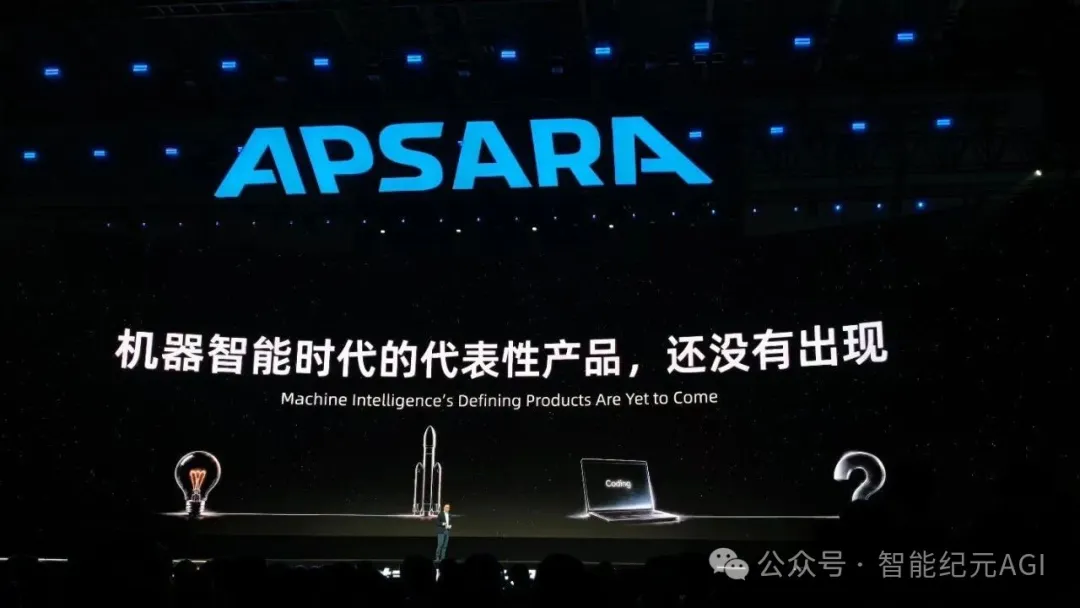
第二個判斷:機器智能時代的代表性產品,還沒有出現。
今天說這個話好像覺得比較奇怪 —— 我們的 AI 應用還在層出不窮,大家使用得也越來越多。但是我們回顧過去:電最早的用途其實是替代煤油燈和蠟燭,用來照明。
1882 年,愛迪生點亮了附近大概 400 盞燈。但是有意思的是,最早的時候愛迪生賣燈泡,它是送半年的電 —— 就像我們今天的 AI 軟體的行銷大戰,我們下載一個軟體,它就送一個月的 token。
很多改變世界的東西,其實是後來才出現的。1902 年空調才出現,後來大家習以為常的洗衣機、電冰箱等陸續進入家庭;而第一台電腦要到 1946 年,距離珍珠街那 400 盞燈已經過去 60 多年。
當然我們相信,今天 AI 時代的進展會比當年快得多,機器智能時代的代表性產品肯定不需要等 60 年。
今天的 AI coding,打個比喻的話,非常像機器智能時代早期的電燈 —— 它替代的是人類現在可以做的這些工作,替代的是人類社會現有的工作:輔助程式設計也好,寫報告也好。但是當下 AI 正在進入更廣泛的辦公領域,僅僅替代現有的工作,我們覺得不可能創造一個真正的新的時代。
今天我們很難預測,當機器智能爆發之後,會出現什麼樣的新產品、新發明。就像我們如果回到過去,站在 1882 年的電燈下,很難想像出電氣時代這麼多紛繁複雜、創新的、有意思的新產品。但是無論後來出現多少新發明,第一步都是要建足夠多的發電站,鋪足夠廣的電網。
1900 年前後,很多電器其實已經開始進入家庭,但當時全世界一整年的發電量放到今天,只能夠全世界用兩個小時。機器智能時代同樣需要更強大的基礎設施建設。
四、機器智能時代的三大基石
機器智能時代的三大基石,就現在來看,我們覺得是:AI 模型、AI 晶片和 AI 雲。
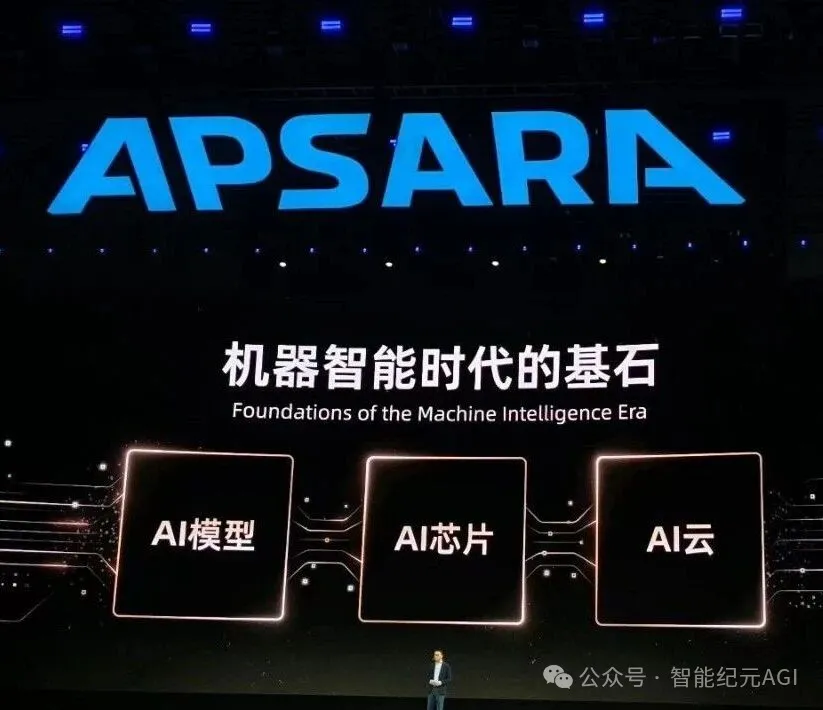
它們是機器思考能夠規模化供給的前提。只有 AI 基礎設施足夠完善、足夠發達,各種應用層面的 AI 新產品、新發明才能層出不窮。
如果從電的發展歷史來看,未來機器智能對 AI 基礎設施的需求,對比今天的規模幾乎是沒有上限的。阿里巴巴將堅定投入以 AI 模型、AI 晶片和 AI 雲為代表的基礎設施建設,這是我們長期的戰略選擇。
第一塊基石:AI 模型
去年我們談到 AI 從自主行動走向自我迭代,今年我們看到,在通往 ASI 的技術路徑變得更加清晰 —— 從 coding 辦公到科學研究,模型正在承擔越來越多的真實任務,這些真實任務和反饋會讓模型變得越來越強。AI 研究員們也逐漸探索出超級人工智慧的具體技術路徑:遞迴式自我改進,也就是行業所稱的 RSI。模型從真實反饋中能發現自己的短板,自己設計實驗、自己建構資料、評價結果,循環推動模型自身的進化。
目前我們的千問團隊也在進行 ASI 方面的探索,並取得了一定的進展。千問團隊正在持續推進模型架構和資料最佳化的研究,計畫訓練 5~10T 規模的全新模型,目標是能夠完成更複雜、更長程的任務,向 ASI 邁進。
如果說大語言模型(LLM)的前進方向是造頂級聰明、可自主進化的 "大腦",那麼多模態能力其實是機器智能發展的另一個重要方向。
我們認為,一個足夠聰明的大腦還不夠,AI 還需要掌握和人類互動、和人類感知的互動能力。人類通過聲音、圖像、表情和動作來交流,也通過這些方式表達意圖和情緒。
模型需要更強的多模態能力,像人一樣理解和表達這些資訊,理解人類的文化、審美和價值觀。
未來,人們可以像跟人一樣和 AI 交流,不必面對一個複雜的互動介面,這樣 AI 才能更好地服務人類。因此,理解與生成一體化的多模態模型,也是我們另一個重要的研究方向。
第二塊基石:AI 晶片
如果說 token 是 AI 時代的電,晶片就是發電機。未來機器智能時代對 token 的需求幾乎是沒有上限,所以晶片也需要不斷提高性能、擴大供給。
今天我們平頭哥在對資料中心晶片進行全面佈局:真武系列晶片是我們的 GPU 晶片,倚天是我們的 CPU 晶片,磐久是我們的智能網路卡,還有互聯晶片 —— 組建超大規模 AI 叢集的核心晶片,我們已經進行全面覆蓋。同時,我們正在對晶片、伺服器、超節點、網路、模型和推理系統進行聯合調優,不斷提升整個 AI 叢集的 token 產出效率。
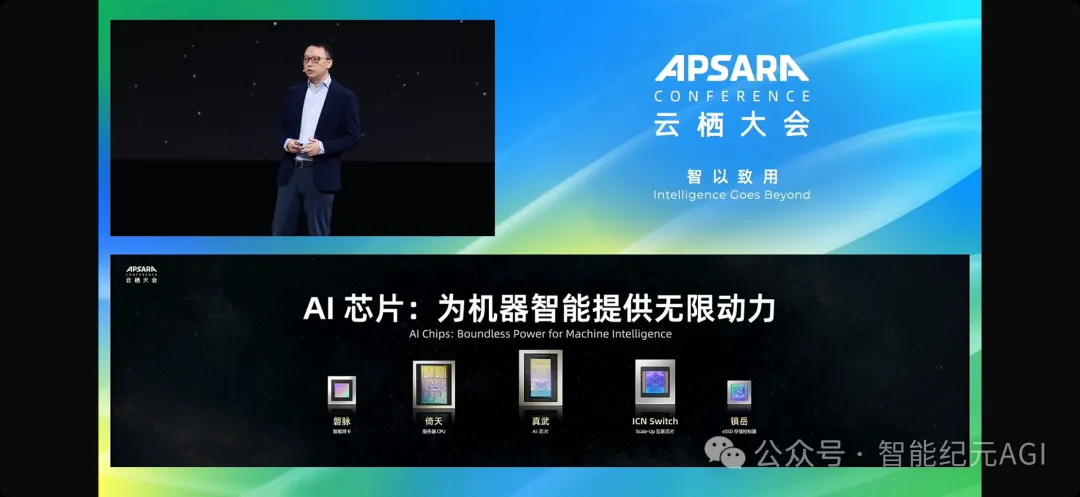
阿里自研的M890 AI 超節點已經成功支撐過 2 萬億參數以上大模型的推理,是全球極少數具備這樣能力的公司之一。本季度開始,基於 M890 的阿里雲超節點,阿里雲已經開始規模化上架整個資料中心。
今天我們將發佈新一代 AI 晶片 ——真武 V900,這是目前中國算力性能最強的 AI 晶片,性能達到 M890 的三倍。基於它建構的單一叢集可擴展至 50 萬卡,支撐前沿模型的訓練和推理。由於平頭哥晶片產品線的逐漸成熟和客戶的廣泛應用,我們預計未來幾年平頭哥的年出貨量將大幅提升。
未來智能應該是無處不在的。它不僅存活在資料中心的機房裡,AI 也會進一步融入我們習慣的桌面端和移動端。
在桌面端,我們開放原始碼的Qwen2.7B 模型是全球最受開發者歡迎的模型,未來我們還將持續最佳化這一類模型,支援開發者和企業的本地化部署。
在移動端,我們今天也會正式發佈千問 Intelligence,為合作夥伴提供移動端的 AI 解決方案,讓移動裝置能夠完成各類複雜任務。
第三塊基石:AI 雲
晶片負責生產 token,雲負責把 token 送到每一個需要它的地方。模型需要持續的訓練和推理,智能體需要長時間執行任務,AI 開發的軟體也會越來越多 —— 它們都會成為 AI 雲上的 "居民",持續呼叫算力和使用資源。我們需要圍繞這些新的工作負載,建設為模型和智能體持續運行而設計的 AI 雲。
今天我們很少注意到電網本身,但是在任何地方只要插上插座,電就來了。如果沒有電網和插座,這樣的生活恐怕我們一天都難以忍受。
未來使用機器智能也應該像這樣方便:所有裝置只要接入雲,就能夠隨時隨地使用機器智能。要做到這一點,我們需要建設一張覆蓋全球、高效運轉的超級網路,對 GPU、CPU、網路、儲存、資料庫和各種工具進行聯合最佳化。
這張網路越完善,就會有更多的使用者和智能體進來使用,形成規模效應和網路效應。
目前我們看到客戶的需求非常強勁,我們將全力以赴上架 AI 算力來滿足客戶的需求,阿里雲的收入也在持續加速增長。
但是我們看到,行業的中長期需求遠超我們可以提供的供給能力。
當前 AI 資料中心相關供應的全球性緊缺,限制了阿里雲算力的增長速度。為此,阿里巴巴將與所有合作夥伴一起,全力投入 AI 基礎設施建設,打造一朵面向機器智能時代的 AI 雲。
我們的目標是:到 2032 年,阿里雲營運的全球資料中心規模超過 20GW,以滿足行業快速增長的 AI 需求。
結語:把時間留給創造力
最後,當機器成為思考的主力,我們每個人都會問自己:未來會有什麼樣的變化?
我們可以回顧一下過往。
工業革命讓機器承擔了越來越多的體力勞動,人類從繁重的體力勞動中解放出來之後,發展出了更多有意思的運動,足球、籃球,現在的奧運會、世界盃、NBA,這些都是工業革命後的產物。
歷史上這樣的事情一再發生:印刷術的興起,讓人類的文化創作爆髮式增長。
當機器承載了更多不得不做的事情,人便有時間去做真正想做的事情。未來機器智能將為人類的好奇心和創造力,打開更大的空間。
今天我們很難具體描繪未來是什麼樣的。就像如果我回到 300 年前,我是一個在田間工作的農夫,很難想像未來會有一個人說 "走進一個叫健身房的地方,付費去進行體力勞動"。
去年我們說:AI 越強大,人類更強大。
今天我們依舊這麼認為。這也是我們全力邁向機器智能時代的意義 —— 把繁重的任務留給機器,把時間、創造力以及對美好事物的感受,留給人類。
祝大家度過一個充實愉快的雲棲大會,謝謝大家。
以下是劉大一恆的演講全文整理(有一定潤色):
各位雲棲大會的現場嘉賓與線上朋友們,大家上午好。
今天我帶給大家的演講主題是《Qwen:邁向真實世界智能體》。
過去幾年,AI 大模型經歷了兩次顯著的跨越:最開始我們處在問答時代,人類向 AI 提問,AI 給出答案;隨後進入推理時代(Reasoning),模型開始用更多的 token 去思考、推理、驗證,解決越來越複雜的問題。
而今年,大模型正式進入第三個階段 —— 智能體(Agent)時代。模型不再只是被動等候提問的助手,而是可以自主規劃、呼叫工具、持續迭代、閉環完成任務的智能體。
AI 的消費也從一次對話變成一項任務,這種變革直接拉動了全球使用者對 token 需求的指數級爆髮式增長。
面向 Agent 時代,千問的北極星目標是什麼?
簡單來說就是兩條腿走路 —— 既要仰望星空,又要腳踏實地。
仰望星空,是指我們要追求更高智能,並加速自我進化。Agent 時代,複雜長程任務對模型智能的要求越來越高,因此我們會持續打磨千問 Max。但只靠旗艦大模型,就無法規模化落地。
因此,我們也推出了Qwen4 Flash、Plus 系列,以及專為本地部署打造的千問 27B,不斷降低模型的使用門檻。
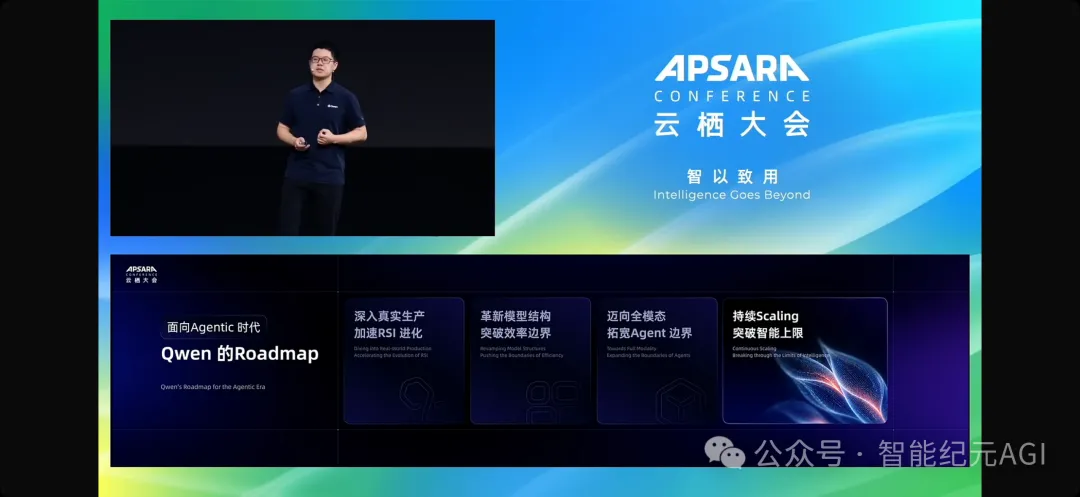
面向 Agent 時代,Qwen的 Roadmap 會聚焦四個關鍵方向。
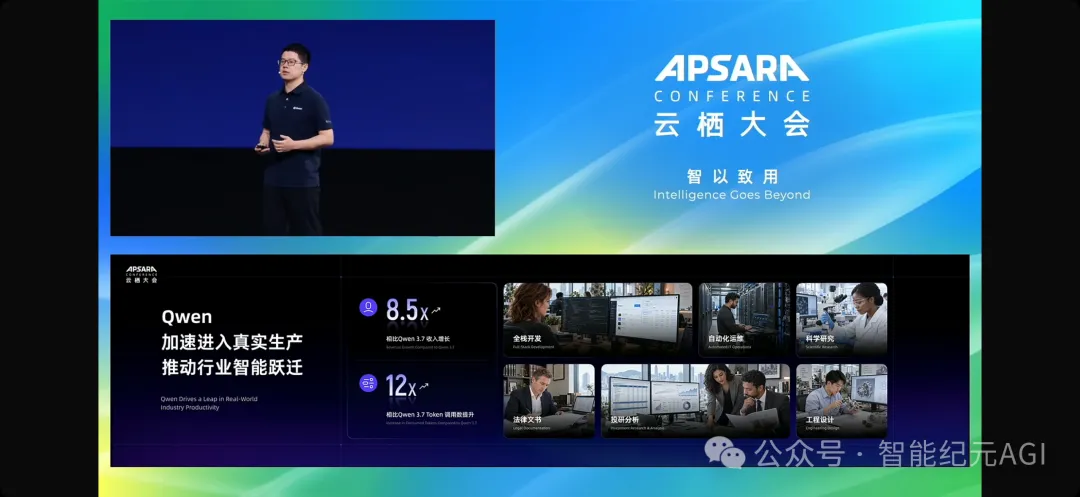
第一個關鍵方向,是讓模型深入真實行業生產,通過能力提升、場景滲透、反饋積累,形成自我進化循環。隨著千問能力的不斷提升,我們的模型開始加速進入越來越多的真實生產環節。
我們最近發佈的Qwen 3.8 Max,相比上一代 3.7,短短兩個月,真實使用者收入已經增長了 8.5 倍,而 token 消耗量更是暴漲了 12 倍。我們深刻感受到,千問正在幫助越來越多行業的使用者實現生產力躍遷。
在 Agent 時代,最先進入真實生產的一個重要領域就是程式設計(Coding)。過去模型做 Coding,更多是補全程式碼、回答技術問題。
但今天,千問正在進入更加複雜的程式設計工作,驅動複雜軟體工程,自主開發。千問模型在 Coding 能力上也實現了全面躍遷。
無論是海外知名的 Code Arena 榜單,還是各類複雜的 Coding Agent 任務,從程式碼生成到複雜系統建立,千問的能力都在自我進化、持續提升,達到業界領先水平。
除了 Coding 之外,當千問進入到更多真實行業之後,下一個關鍵問題是:它到底能不能勝任專業工作?我們圍繞數百個高價值的真實任務,對千問做了大量基準評測和行業專家眾測。
大家可以看到,在很多專業領域,千問的能力已經進入全球模型第一梯隊,甚至媲美部分行業專家。
需要注意的是,這些任務並不是簡單的問答,而是真正的專業工作任務:比如它可以作為 UI 設計師完成原型設計,可以作為量化交易員分析資料、建構策略,可以作為專業律師處理複雜的法律分析,也可以完成 3D 建模、公關行銷、科研分析等高度專業化的任務。
所以,我們越來越感受到一個非常重要的變化:千問的能力邊界正在從通用問答,快速擴展到專業生產。
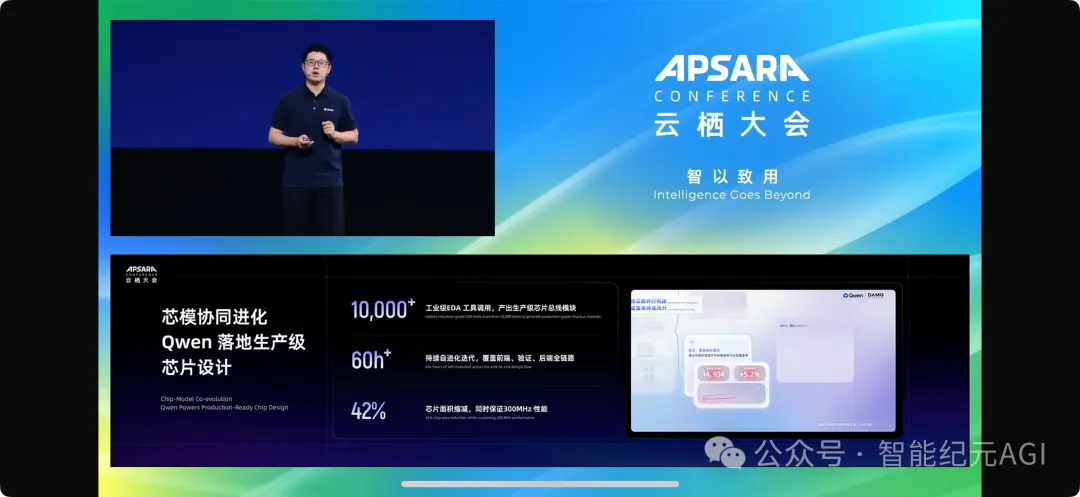
接下來再給大家展示一個更加專業也更加複雜的生產力場景 —— 晶片設計。
我們讓千問進入真實的工業級 EDA 環境,完整參與達摩院 3D 創新架構研究。
在這個過程中,輸入只提供一份真實的匯流排模組 Spec,千問同步迭代前端驗證和後端全鏈路,最佳化晶片的面積和功耗,不斷根據結果進行自我迭代。
整個過程連續運行了 60 多個小時,累計完成了數萬次工業級 EDA 工具呼叫,最終在保證性能的同時,面積縮減 42%。模型設計晶片,而更強的晶片又將反哺更強的模型。我們相信,這個飛輪將在未來形成真正的 "芯模協同進化"。
當模型深入越來越多的真實生產環境後,我們也開始探索一條新的路徑:讓模型訓練本身形成自我進化的閉環。
它首先從真實的內測日誌和使用者反饋中,自動定位模型當前的能力缺陷;然後針對這些缺陷,自動構造新的訓練資料和環境。模型自建的資料生成管線會先放到小模型上,進行多輪驗證和迭代,不斷篩選和最佳化資料質量,再進入最終 Max 模型的訓練。這套資料閉環系統已經持續運行了一個多月,累計完成了 33 輪有效資料迭代。
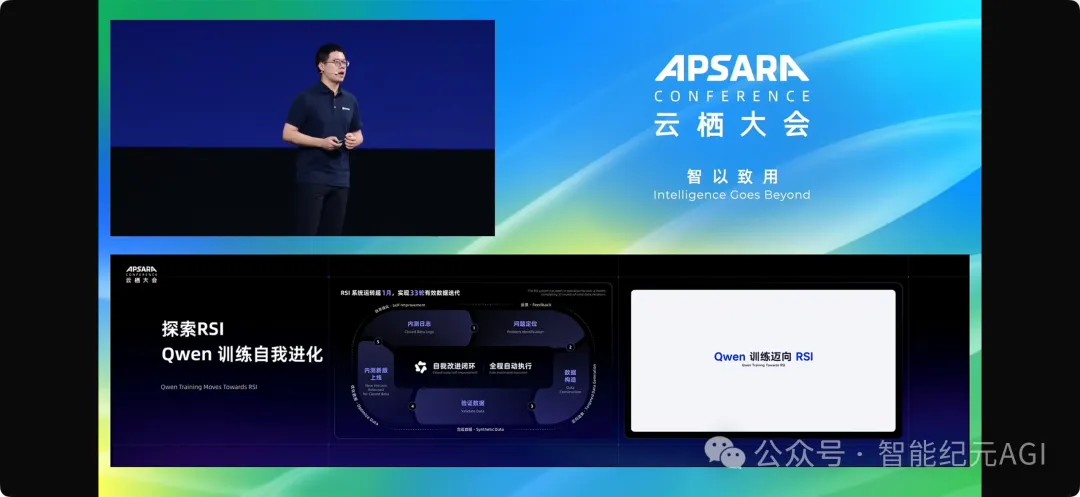
我們希望在未來建構一種更加自動化、持續化、資料驅動的自我進化機制,讓模型在真實世界中持續發現自己的不足,並推動下一代模型不斷變得更好。
隨著後訓練技術的不斷進步,以及基於真實生產反饋的自我進化,我們在 30 天內實現了千問 3.8 Max 性能的再突破。
在世界知名的 Artificial Analysis(AA)智能指數榜單上,我們模型的性能從 40 分,一個月提升到了 45 分,達到國內第一的水平。此外,在各類內外部的複雜 Agent 任務評測上,模型能力也得到了顯著提升。
接下來讓我們回到 Roadmap 的第二點。
在 Agent 時代,模型需要長時間運行、持續推理,同時還要能夠高效訓練、不斷擴展。因此,我們希望持續探索新的模型結構,突破效率的邊界。
前不久我們推出了千問 3.8 Flash-Next,採用了我們最新一代的模型架構,核心做了四個方面的突破。
第一,採用混合線性注意力機制,不再依賴對長上下文不友好的全注意力機制,更適合長程任務。
第二,我們引入自研的 GQA(分組查詢注意力),增加模型的資訊通路,同時提升訓練穩定性,讓模型更容易向更大規模擴展。
第三,引入 NGram Embedding,通過高效的外接記憶,以更低的成本擴展模型容量。
第四,我們採用架構與最佳化協同設計的 Scaling,帶來模型訓練效率與性能的雙重提升。
最終,千問 3.8 Flash 在只啟動 6B 參數的情況下,實現了智能與效率的帕累托新前沿。
全新架構帶來的變化,我們可以用幾個數字直觀感受:相比上一代千問 3.7 Plus,千問 3.8 Flash 的啟動參數降低到了 1/3,訓練成本更是降到了 1/9。這意味著我們可以用更少的計算,訓練出更高效的模型。在推理側,百萬 token 輸入價格降低到原來的 1/4;而面對百萬級超長上下文,預填充吞吐更是提升了 8.6 倍。
在效率大幅上升的同時,模型的智能也並沒有下降。結合後訓練技術的進步,在 AA 智能指數上,3.8 Flash 的性能相比 3.7 Plus 提升了 14% 之多。而這,就是我們通過全新架構所實現的 —— 突破效率的邊界。
接下來是我們 Roadmap 的第三個部分。我們認為,未來的 Agent 不應該只理解文字,而應該同時理解語言、程式碼、音訊、圖片、視訊、各類檔案和音視訊內容,真正成為能夠理解現實世界資訊的通用智能體。因此,我們需要邁向全模態,不斷拓寬 Agent 邊界。
在視覺多模態上,我們希望千問做到的不只是看懂一張圖,而是真正幫助 Agent 理解世界、探索世界和創造世界。
在理解世界上,千問 3.8 在知名的 Vision Arena 榜單上取得了優異成績,展現了強大的視覺理解能力,並輔助Qwen探索世界。
在數字世界裡,使用者提出製作賽車模擬器的需求,千問就可以協同使用設計軟體、建模工具和遊戲引擎,把一個複雜任務的多個環節串聯起來。
而這樣的 Agent 能力也在延伸到物理世界:結合現場看到的視覺資訊,執行真實世界的連續任務,幫助人類探索物理世界。
而連接到智能眼鏡,它也可以像人類一樣,通過對環境視覺資訊的即時感知,幫助 Agent 完成任務的執行。
最後,借助視覺多模態,我們可以更好地創造世界。給千問一張視覺參考,它就可以把畫面中的構想變成可以互動使用的應用。
在視覺之外,我們認為真正走向通用智能,還需要進一步理解音視訊 —— 因為人類感知世界 99% 以上的資訊都源自音視訊。千問 3.8 Omni,正是我們面向全模態通用智能邁出的重要一步。這一代 Omni 在音視訊推理和 Agent 任務上都實現了大幅提升,能力進一步逼近業界頂尖水平。同時,我們通過智能密度最佳化,整體成本相比上一代降低了 90% 以上。我們的目標非常明確:讓全模態不僅更智能,也能真正用得起。
接下來看一段視訊,感受全模態生產力帶來的升級。視訊中依次展示了:超長電影素材自動剪輯成片;一句話為音樂生成 MV,端到端交付最終 MV 產物;全模態多人會議智能體等新的應用場景。
與此同時,我們也將相關模型權重全部開源,鼓勵開發者和我們一起探索全模態的應用邊界。
最後回到 Roadmap 的第四個方向:持續 Scaling,突破智能上限。
我們始終相信,基礎模型的智能上限,離不開持續的算力、資料和模型規模投入。因此,未來我們還會沿著 Scaling Law 持續擴大預訓練計算量,不斷推動模型能力向更高上限突破。
事實上,回顧Qwen的發展,這條 Scaling 曲線一直在持續。在千問 2.5 時代,我們的旗艦模型規模還是 72B;而到近期的千問 3.8,參數規模已經擴展到 2.4T,兩年來參數量整整提升了 33 倍。
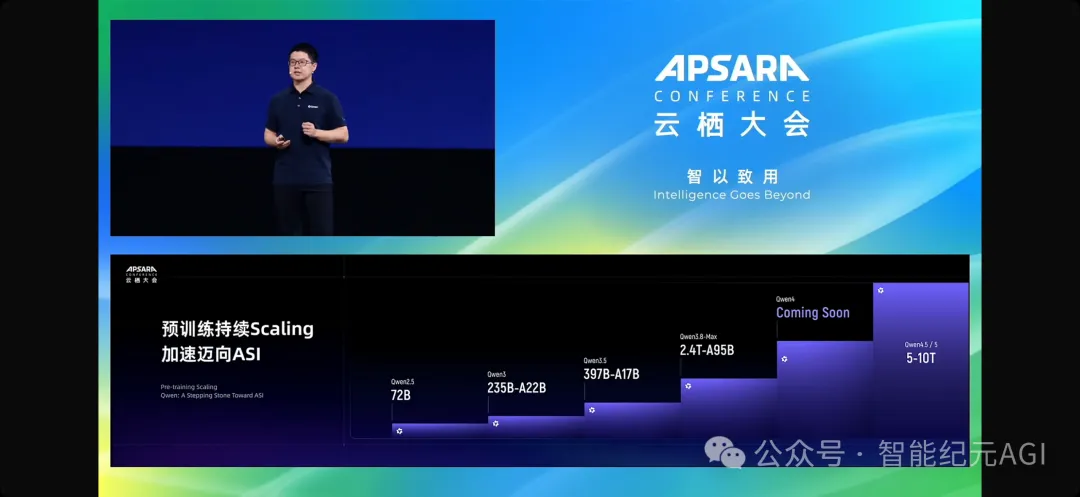
未來,我們還會繼續向更大規模發起衝擊:在千問 4 之後的千問 4.5 和千問 5 版本,我們計畫將模型參數規模進一步推向 5~10T。我們相信,持續 Scaling 是加速邁向 ASI 的關鍵路徑。
沿著我們的 Roadmap,下一代千問 4 系列也即將到來,它包括:繼續追求智能上限的千問 4 Max;追求極致效率和性價比的千問 4 Flash 和 Plus;以及廣受本地開發者期待的千問 4 27B。我們希望用一套完整的千問系列,覆蓋不同使用者的需求。
過去幾年,我們持續將全模態、全尺寸的先進模型開源給全球開發者。到今天,Qwen模型的全球下載量已經超過 30 億次,衍生模型超過 30 萬個,居全球第一;我們也累計開源了 460 多款官方模型。而就在前不久,千問 3.8 27B 在發佈僅僅兩個月的時間裡,就迅速超越了 DeepSeek V4 Flash、Llama 等知名模型,成為 Hugging Face 平檯曆史上點贊數最高的模型。
我們深刻感受到,Qwen正在形成一個真正的全球開發者生態。我們始終相信,AI 的價值不應該只屬於少數企業,而應該成為全世界使用者都可以獲得、使用和創造的基礎能力。未來,我們會堅持開源開放,讓更多人用得起 AI、用得上 AI、參與創造 AI,實現 AI 普惠。
謝謝大家! (智能紀元AGI)