
近期馬斯克在公開訪談中給出了自己的判斷,大概兩到三年時間內,中國就能依託自主可控的光刻技術與全鏈條晶片製造能力,補齊當前階段的算力供給缺口。
就在之前接受央視財經專訪的過程中,馬斯克也提到,目前中國本土的AI大模型技術,從整體表現來看完成度非常出色,靠單位算力輸出的實際性能,幾乎站在了全球頂尖梯隊。
他進一步解釋,自己認為中國解決算力供給問題的速度,會比絕大多數海外行業從業者預估得更快,給出了一個粗略的預判,大概兩到三年內,中國就能依靠自主突破的光刻技術與成熟晶片製造體系,把當前的算力缺口完全補齊。
早前舉辦的All-In科技峰會上,NVIDIA CEO黃仁勳也曾回應過主持人提出的相關問題,當時他被問到中國什麼時候能完全自主研發出先進光刻機,黃仁勳給出的判斷是,中國到2030年左右就能拿出完全自研的先進光刻系統。
黃仁勳還補充提到,一旦相關核心技術完成突破走向成熟,中國本土企業就會爆發出極強的大規模量產能力,這些國產半導體製造裝置進入本土晶圓廠完成規模化落地,只是時間早晚的問題。
兩位全球科技行業頭部企業的掌舵人先後給出的相似判斷,也側面印證了國內半導體全鏈條自主研發的推進速度遠超外界此前的預期,從光刻裝置到成熟製程晶片製造的各項技術突破,正在逐步形成合力,最終為AI產業的健康發展築牢穩固的算力底盤。
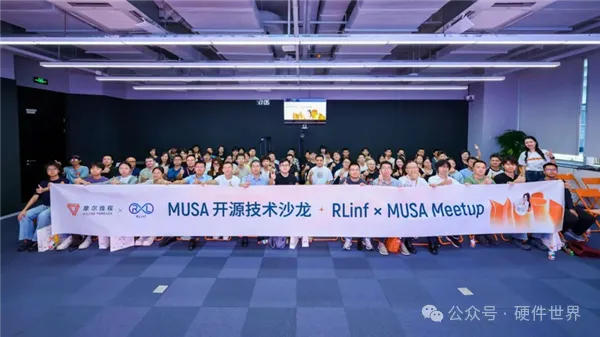
國產算力到什麼地步了呢,在近日由摩爾執行緒主辦的“MUSA開源技術沙龍:RLinf × MUSA Meetup”上,摩爾執行緒公佈了MTT S5000在具身智能強化學習訓練中的實測結果。
在248個平行環境、相同配方與隨機種子的控制變數條件下,S5000與國際主流GPU的訓練曲線高度吻合,逐步相關係數達r=0.976。這一結果來自RLinf框架上的WoVR負載全量適配與復現。
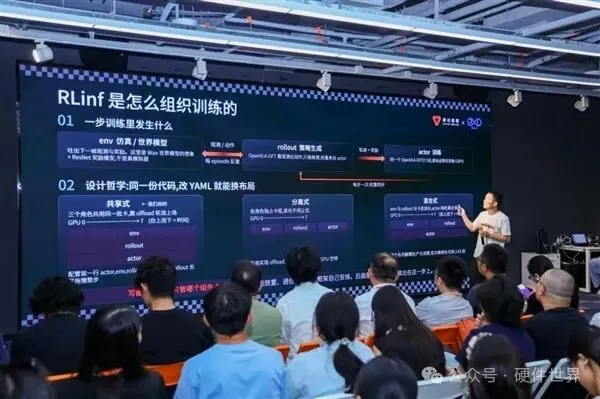
該團隊採用GRPO演算法rollout action,使用WAN世界模型根據action想像執行結果,最後用ResNet評估對錯並給出獎勵用於訓練,全程無需真實機器人參與即可完成RL後訓練。
在真機LIBERO-Spatial評估中,兩套硬體訓練出的策略成功率實現對齊。
RLinf開源框架負責人、清華大學深圳國際研究生院助理教授於超在會上透露,RLinf官方CI自0.3版本起正式接入MTT S5000,所有程式碼在合入主分支前均須基於國產算力完成自動化驗證。
這意味著國產算力與國產具身強化學習框架已從單向適配進入雙向共建階段。
RLinf是首個面向具身智能的“仿訓推一體化”大規模強化學習框架,由清華大學、無問芯穹聯合發佈。於超表示,渲染能力是選擇摩爾執行緒的關鍵考量,“摩爾執行緒是國內除國際主流GPU廠商之外,少數能在渲染環節提供成熟支援的算力夥伴”。
工程最佳化方面,摩爾執行緒對單步耗時實施了三項改造:圖像處理從主機端遷移至GPU端、去噪循環數值檢查合併、熱路徑Python標量取代為裝置張量。
整步耗時從2549秒降至1888秒,下降26%;GPU空轉率從18.5%壓縮至3.1%。算子級基準顯示,S5000的GEMM與注意力性能達到國際主流GPU的1.6至2倍。
在實際應用中,基於π0.5的“策略自進化資料飛輪”讓雙臂機器人裝配GPU的真機成功率從約兩成穩定至92%,精細操作耗時縮短39.5%。
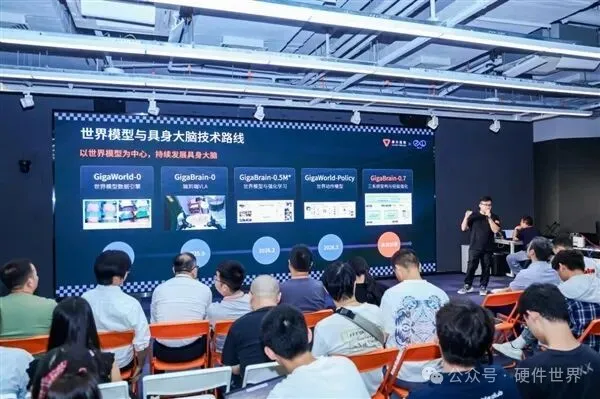
極佳視界GigaBrain-0.7則將四項精細操作平均成功率從30%經離線RL提升至57.5%,線上RL後進一步提升至100%。
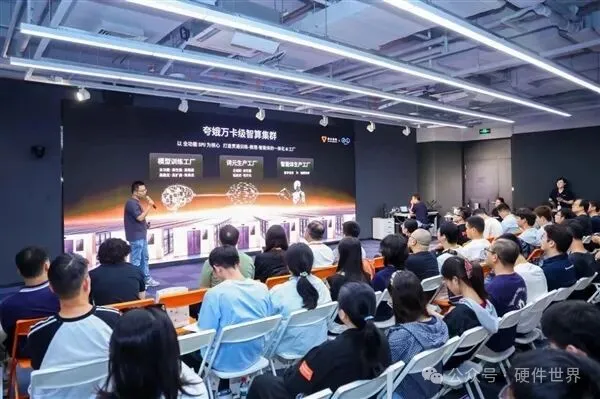
摩爾執行緒高級副總裁楊上山表示,具身智能對算力的需求是復合的,既需要訓練“大腦”的AI算力,也離不開建構虛擬世界的渲染與模擬算力,這正是全功能GPU的用武之地。
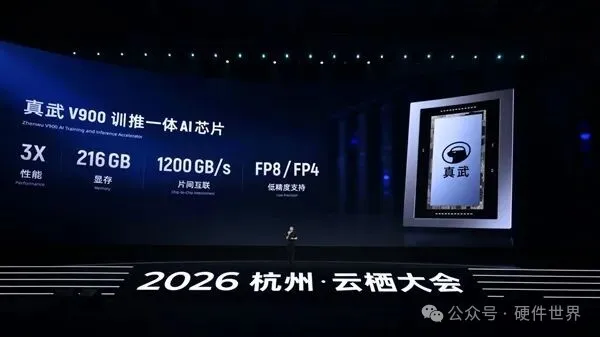
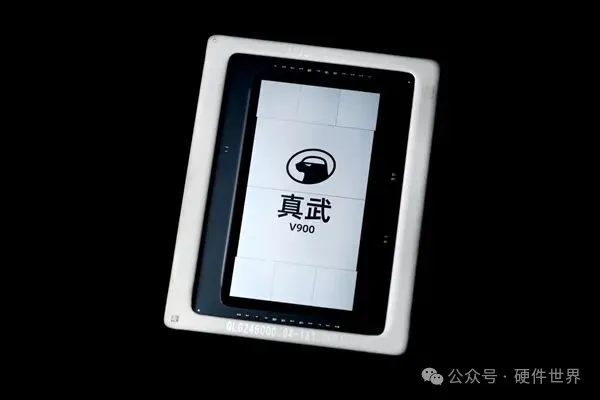
在2026杭州雲棲大會上,阿里平頭哥也發佈新一代訓推一體AI晶片真武V900,性能是真武M890的三倍,這是目前算力性能最強的中國自研AI晶片,可滿足萬億級參數大模型的訓練和推理需求。該晶片將於2027年第一季度量產售賣。
真武V900基於自研平行計算架構設計,搭載216GB大容量視訊記憶體,片間互聯頻寬達1200GB/s,單晶片性能是真武M890的3倍。
該晶片原生支援FP8、FP4低精度計算,在大幅提升算力密度的同時顯著降低推理成本,可應用於高精度訓練、低精度和超低精度推理的全場景。
針對萬億級參數大模型的訓練和推理場景,真武V900與平頭哥自研網路、記憶體晶片可實現系統級最佳化。
真武V900通過自研ICN Switch互聯晶片連接後的超節點,具備原生記憶體語義和記憶體統一編址能力,可實現千卡全頻寬高速互聯。
這意味著上千顆真武V900能像一顆“超級晶片"一樣協同工作,為超大參數模型的訓練和推理提供高吞吐、低延遲、高並行的算力。
大會現場,阿里發佈全新升級的超節點伺服器,內建真武V900、ICN Switch、磐脈智能網路卡及鎮岳SSD主控晶片,實現算、存、網全端系統級協同,通過阿里雲全新設計的智算中心網路架構,單一叢集可擴展至50萬卡規模。
據悉,基於真武M890的超節點已大規模應用,並跑通了Qwen3.8、Kimi K3等超2萬億參數規模模型。
據平頭哥透露,真武系列晶片已服務超650家企業客戶,覆蓋智駕、金融、大模型、具身智能、能源、製造等千行百業,是場景應用最廣的中國自研AI晶片之一。
阿里巴巴集團CEO吳泳銘表示:“由於平頭哥晶片產品線的成熟和客戶的廣泛應用,平頭哥AI晶片的年出貨量將大幅提升。”
大會現場,平頭哥首次公佈倚天伺服器CPU的規劃,2027年將推出倚天720和倚天730兩代伺服器CPU。
據介紹,倚天720將實現單核性能、核密度與能效的全面提升;倚天730將首次基於平頭哥全自研CPU微架構設計,單核SPECint2017/GHz性能將最高提升至倚天710的1.4倍。
平頭哥透露,未來幾年將持續升級自研CPU微架構,基於第二代自研核的倚天750,將支援平頭哥自研ICN片間互聯匯流排協議,倚天CPU與真武AI晶片之間可通過ICN匯流排直接互聯,進一步提升CPU與AI晶片的協同效率。
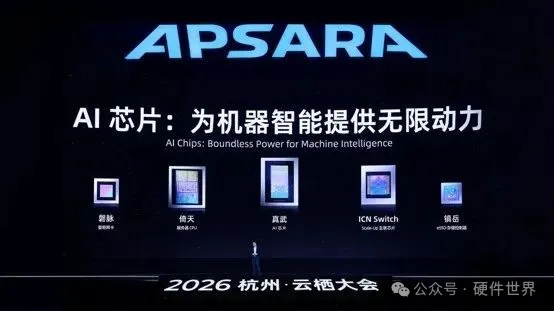
目前,平頭哥已推出真武系列AI晶片、倚天系列伺服器CPU、ICN Switch互聯晶片、磐脈系列智能網路卡、鎮岳系列記憶體主控晶片等資料中心核心晶片,實現算力、網力和存力的全端自研,並實現全端高效協同,為廣泛的AI場景提供強大算力。 (硬體世界)